
Quando um agente de voz falha em chamadas reais, o LLM ou a voz raramente são os culpados. O problema começa um passo antes, no áudio que o agente escuta — seja ele direcionado para um modelo de fala-para-texto (STT) ou direto para um modelo de fala-para-fala. Os STTs modernos lidam bem com trânsito e ar-condicionado. O que eles não conseguem lidar é com uma segunda pessoa falando: um colega, uma TV, o agente da mesa ao lado em um call center. Eles ouvem essa pessoa também, e o agente age com base em palavras que o interlocutor nunca disse.
O Krisp Voice Isolation fica na frente do STT e remove todas as vozes, exceto a do interlocutor principal. Para esta análise, li o benchmark e a documentação da Krisp, me inscrevi na API self-serve e passei oito gravações reais do dataset público da Krisp por ela. Em seguida, transcrevi o áudio de antes e depois com um modelo de STT open-source para ver o que realmente mudou.
O veredito resumido: se o seu agente recebe chamadas de escritórios, casas, call centers ou qualquer lugar onde há pessoas falando ao fundo, o Voice Isolation vale a pena no seu pipeline. No meu teste, a fala de fundo que tinha se transformado em 331 palavras de transcrição falsa caiu para zero. Os trade-offs existem, mas são pequenos: um leve custo em áudio telefônico limpo, uma API disponível apenas na região dos EUA e menos modelos na API do que no SDK.
O problema: vozes ao fundo, não ruído de fundo
Os modelos de STT são treinados para captar fala, não para decidir qual fala importa. O ruído pode ser filtrado porque não se parece com fala. Uma segunda voz se parece exatamente com fala — porque é fala.
O próprio exemplo da Krisp é bom. Um interlocutor pede para cancelar uma assinatura enquanto um colega por perto pergunta sobre o almoço. O STT retorna um único fluxo de palavras, sem nada que marque quais vieram do interlocutor, e o agente recebe as duas vozes como se fossem uma só solicitação.
Isso quebra um agente de voz de três maneiras:
- Transcrições erradas. As palavras da pessoa ao fundo entram na transcrição, e o LLM responde a coisas que o interlocutor nunca disse.
- Interrupções falsas. O agente ouve a pessoa ao fundo, acha que o interlocutor está interrompendo e para de falar no meio da frase.
- Gestão de turnos de fala quebrada. A fala ao fundo parece que o interlocutor ainda está falando, então o agente não consegue identificar quando o turno terminou.
Em cada caso, a lógica do agente funciona como projetada. Ele está reagindo a uma voz que nunca deveria ter ouvido.
Os números mostram o tamanho dessa lacuna. No teste de lançamento do Voice Isolation 2.5 da Krisp, 10 sistemas de STT tiveram, em média, uma taxa de erro de palavras (WER) de 2,10% em áudio limpo com um único interlocutor. Com uma segunda pessoa falando por cima do interlocutor, os mesmos sistemas tiveram média de 35,92%. A supressão de ruído não fecha essa lacuna, porque a interferência é fala.
O que é o Krisp Voice Isolation
A API e o SDK do Krisp Voice Isolation removem vozes e ruídos de fundo de um stream de áudio ao vivo e repassam apenas o interlocutor principal. Foi feito para agentes de IA de voz, e é a mesma tecnologia central que a Krisp oferece para chamadas humanas sob o nome Background Voice Cancellation (BVC).
Ele entra primeiro no pipeline do agente, para que todos os modelos depois dele ouçam apenas uma voz:
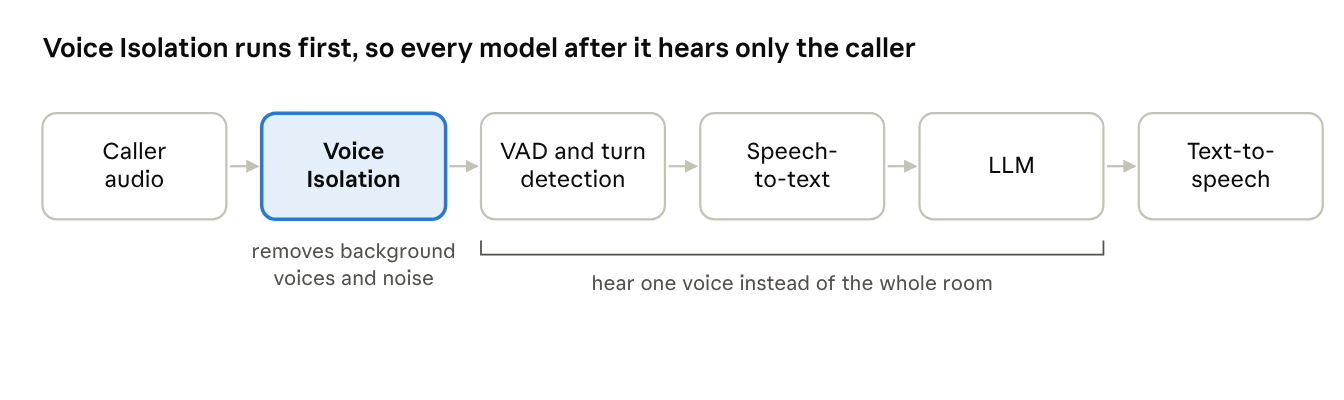
Onde o Voice Isolation fica no pipeline de um agente de voz
Essa posição importa. Sem ele, o VAD e a detecção de turnos também ouvem a pessoa ao fundo — e é daí que vêm as interrupções falsas.
A Krisp dedicou cerca de nove anos à IA de voz e afirma processar mais de 1 trilhão de minutos de voz por ano. O Voice Isolation é um dos produtos do seu conjunto de API de voz com IA e SDK. O Voice Isolation faz parte do VIVA, o conjunto de modelos em tempo real da Krisp para agentes de voz, ao lado de Turn-Taking, Interrupt Prediction e VAD. Ele funciona em conjunto com o turn-taking, não o substituindo.
Os quatro modelos dão controle sobre o quão agressivamente vozes e ruídos de fundo são removidos. Com agressividade máxima (a configuração padrão), o Default remove o máximo. O Balanced processa a voz principal de forma mais leve, com a mesma computação. O Lite usa cerca de um terço da computação do Default. O HD é para streams WebRTC de 32 kHz, não para áudio telefônico. A agressividade é uma configuração em tempo de execução que pode ser ajustada sem alterar a computação; na API, é o parâmetro suppression_level, de 0 a 100.
Uma limitação que vale conhecer desde o início: os modelos de remoção de voz assumem que o interlocutor está perto do microfone. Como referência geral, além de cerca de 30 cm, a própria voz do interlocutor principal pode ser suprimida. Não é uma regra rígida; é uma recomendação geral, e a distância real depende das condições acústicas. Para dispositivos far-field como smart speakers, a Krisp oferece um modelo separado que remove apenas ruído.
A versão 2.5 foi lançada em agosto de 2026, e a Krisp publicou um benchmark aberto e um dataset em setembro. O modelo agora está disponível tanto como API self-serve quanto como SDK.
O que os benchmarks da Krisp mostram
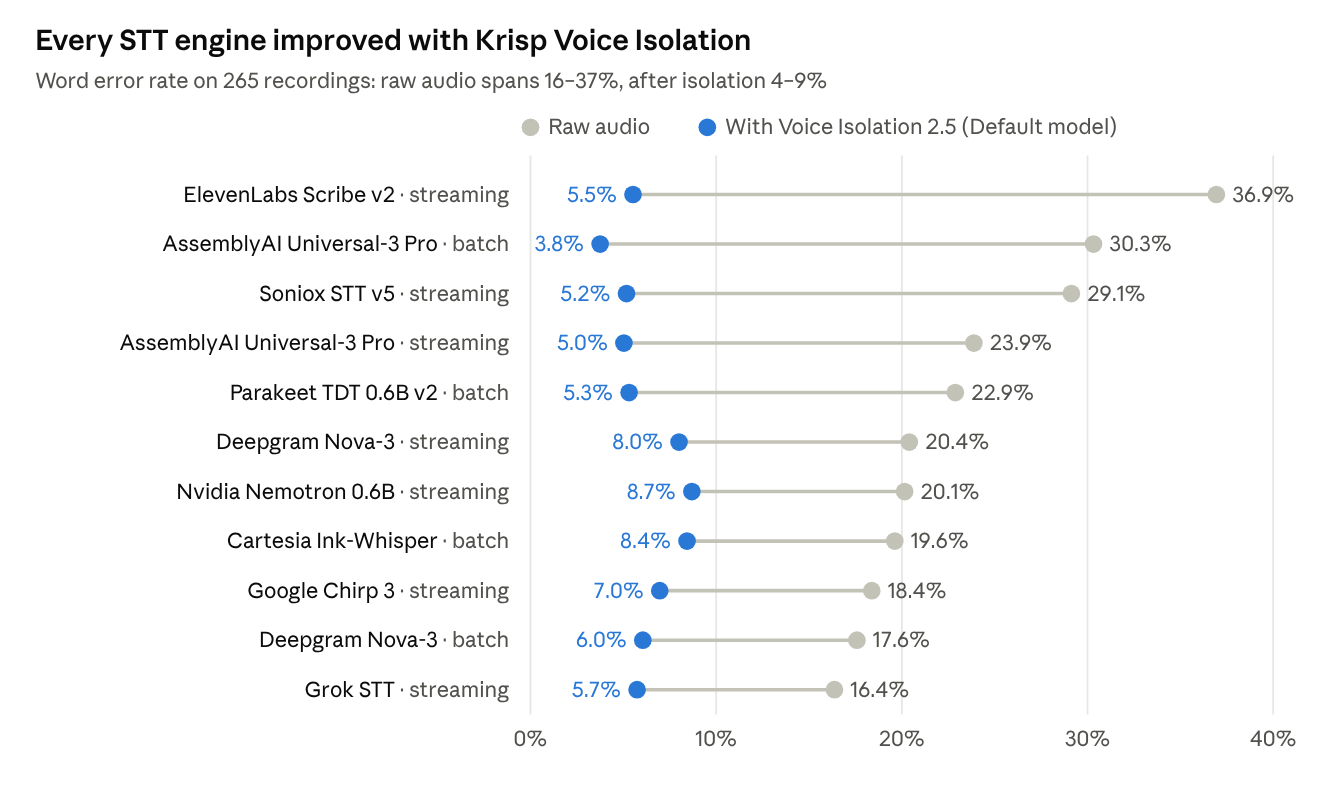
No benchmark aberto da Krisp, o Voice Isolation reduziu a taxa média de erro de palavras de 23,24% para 6,24% — uma queda de 73%.
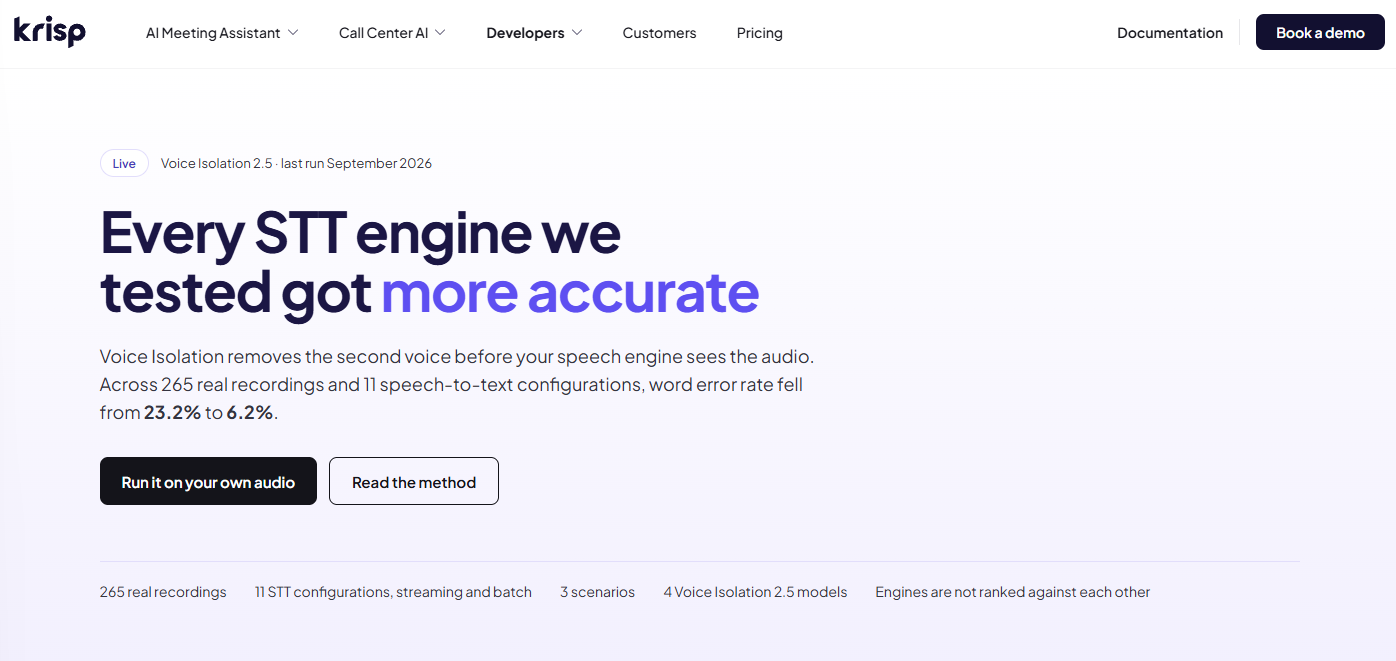
A página de benchmark da Krisp resume o resultado principal.
O benchmark usa 265 gravações reais de escritórios, casas, quatro andares operacionais de call centers e carros. Nada foi simulado ou misturado depois. A maioria das gravações segue o mesmo roteiro: o interlocutor principal fala, uma segunda pessoa entra, o interlocutor principal fica em silêncio enquanto a outra continua falando e, por fim, o interlocutor principal volta. Essa janela de silêncio é o verdadeiro teste, porque a transcrição correta para ela é vazia. Cada arquivo passou por 11 configurações de STT de nove motores, com e sem isolamento.
Fonte: benchmark de voice isolation da Krisp, out. 2026 · 11 configurações de STT, todos os cenários combinados
Todos os motores melhoraram e nenhum piorou. O resultado mais útil é o que acontece com a diferença entre os motores: no áudio bruto ela é de cerca de 20 pontos, e após o isolamento cai para cerca de 5. Se o seu agente ouve vozes ao fundo, limpar a entrada melhora o seu WER mais do que escolher um fornecedor de STT diferente.
Por cenário, o ganho depende de haver ou não uma segunda voz:
Onde ele não ajuda
A Krisp publica seus pontos fracos, e acho que essa é a parte mais convincente do documento.
- Áudio telefônico limpo fica ligeiramente pior. Sem uma segunda voz para remover, o isolamento só pode tocar a voz principal. O WER de chamadas telefônicas subiu de 3,48% para 3,91%, e um arquivo foi de 9,42% para 21,65%. O modelo Balanced é o melhor nesse caso, com 3,53%.
- Eco intenso ainda é um problema. No teste de lançamento do 2.5, separado, gravações de um único interlocutor com acústica difícil pontuaram 11,61% com isolamento, contra 8,02% sem. É muito melhor que a versão 2.1 (15,42%), mas ainda pior do que não fazer nada.
- Sobre-isolamento causa erros silenciosos. A Krisp explica que modelos anteriores às vezes removiam trechos da voz principal. Uma pessoa ainda entendia o áudio, mas o STT descartava frases inteiras e a transcrição parecia limpa, mas com buracos. A versão 2.5 foi ajustada para STT, não para ouvidos humanos, para corrigir isso.
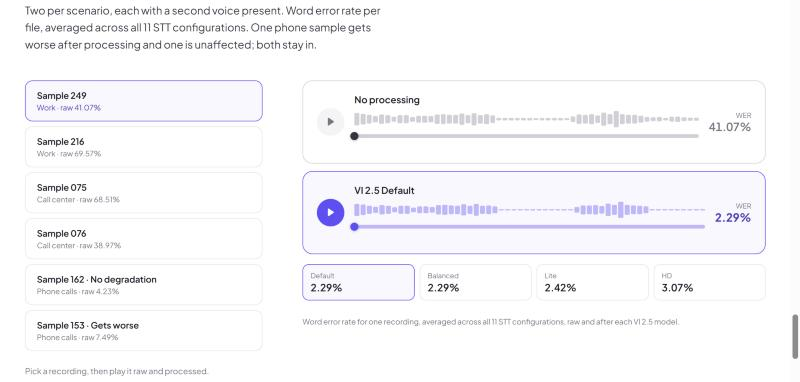
A página de benchmark permite reproduzir seis gravações brutas e processadas. A Amostra 153, uma chamada telefônica, está rotulada como "Piora".
Outros dois pontos a considerar. O número de 73% e o de 46,4% que você verá no site da Krisp vêm de testes diferentes: 265 gravações no benchmark aberto e 1.685 gravações no teste de lançamento do 2.5. E os resultados da Krisp comparam áudio com e sem o seu próprio isolamento, não contra produtos de isolamento de outros fornecedores.
As gravações, transcrições feitas à mão, rótulos de segmentos e a saída de cada modelo estão públicos no Hugging Face, então qualquer um pode refazer o teste. Foi o que fiz em seguida.
Teste prático: testando a API Voice Isolation
No meu teste, o Voice Isolation removeu todas as palavras da fala de fundo das transcrições, e o WER combinado caiu de 40,1% para 10,2%.
Configuração
Criar uma conta no Developers Portal é rápido, com login via Google, Microsoft ou e-mail. A avaliação me deu US$ 30 em créditos e um limite de duas sessões simultâneas. A partir daí é API Keys → Create key, e você recebe uma chave que só pode ser copiada uma vez.
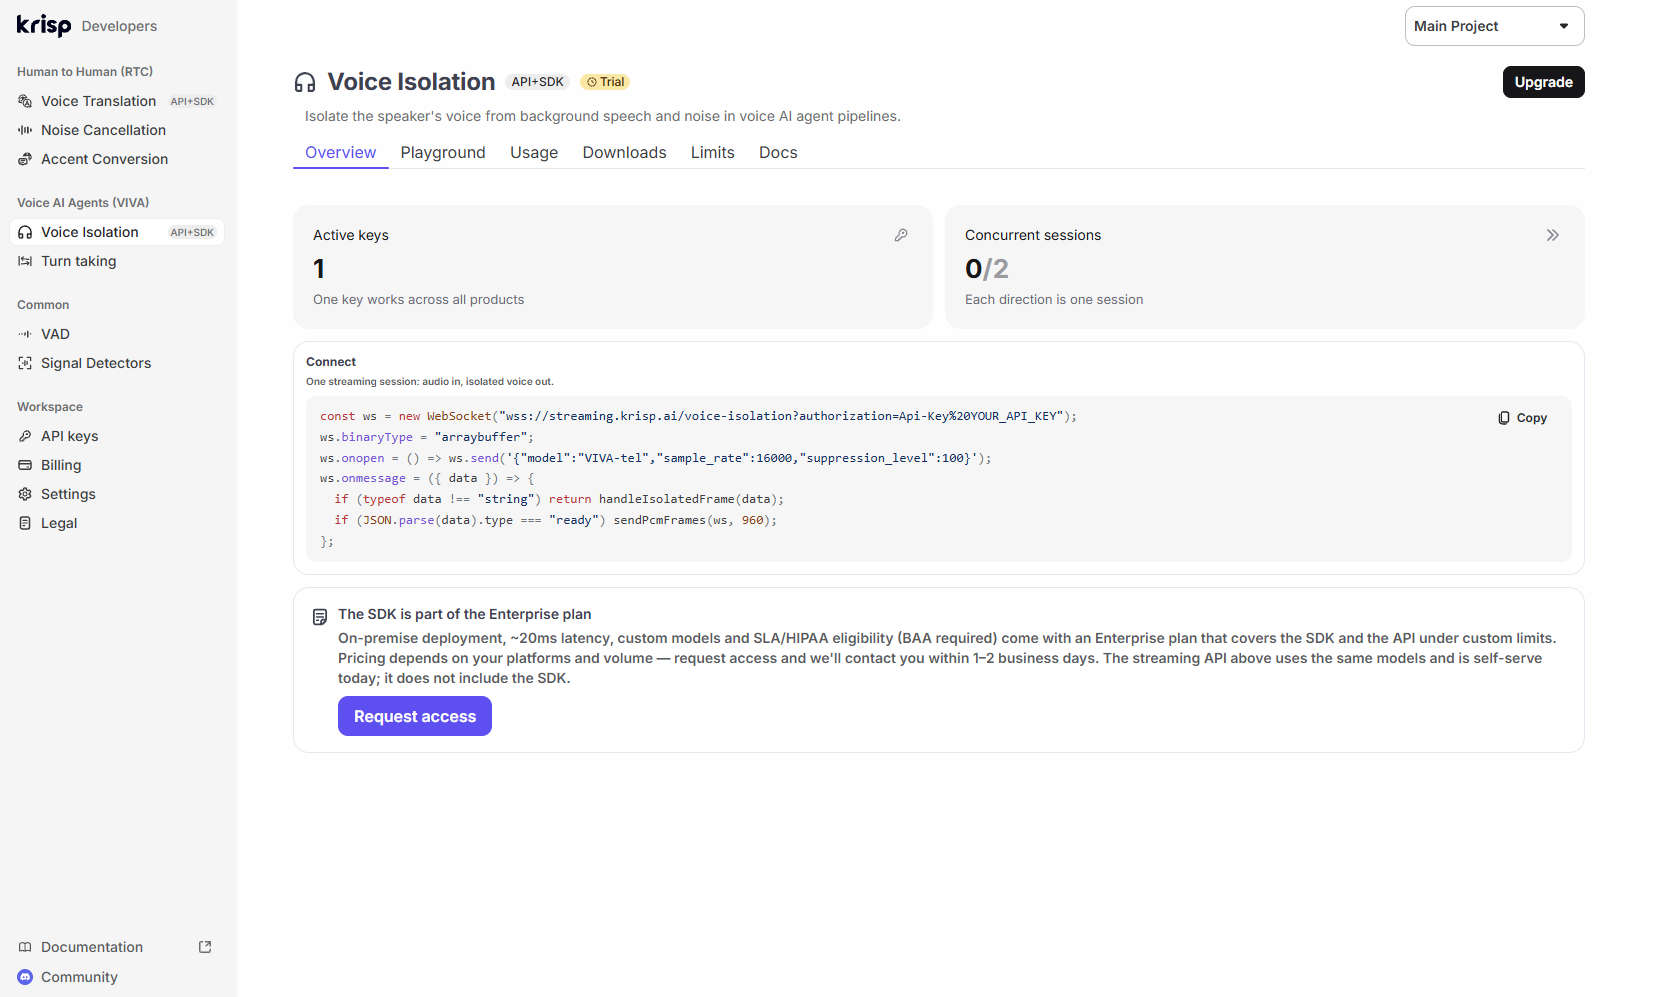
A página do Voice Isolation no Developers Portal, no plano de avaliação.
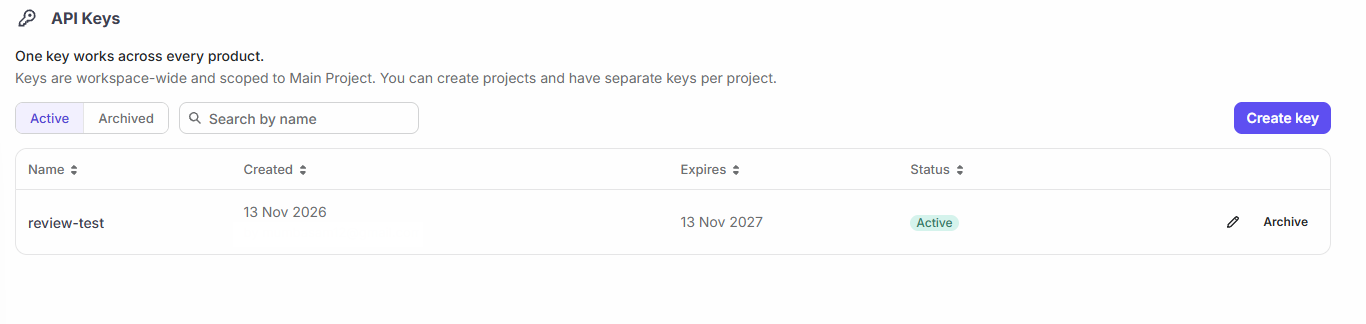
A chave de API que criei para esta análise. Uma única chave funciona em todos os produtos de API da Krisp, incluindo a Voice Translation API. .
A API é um WebSocket. Seu backend troca a chave de API por um token de sessão de vida curta, o cliente envia um pequeno hello em JSON, aguarda o ready e então transmite PCM mono de 16 bits e recebe o áudio limpo de volta quadro a quadro:
URL = "wss://streaming.krisp.ai/voice-isolation"async with websockets.connect(URL, additional_headers={"Authorization": f"api-key {session_token}"}) as ws: await ws.send(json.dumps({"model": "VIVA-tel", "sample_rate": 16000, "suppression_level": 100})) hello = json.loads(await ws.recv()) # {"type": "ready", ...} # then send exactly 30 ms of audio per message (960 bytes at 16 kHz) # and write each binary message you receive to your output
Isso é próximo ao quickstart da API da Krisp, um script Python curto que limpa um arquivo WAV. Uma regra pega muita gente: cada mensagem de áudio deve ter exatamente 30 ms. Qualquer coisa diferente encerra a sessão com um erro invalid_frame_duration, então preencha o último quadro com silêncio.
Para o teste, escolhi oito gravações do dataset público da Krisp: três gravações de escritório, três de andares de call center e duas chamadas telefônicas de dentro de um carro, cerca de 11 minutos no total. Transmiti cada uma pela API em velocidade em tempo real, a partir da Ásia. Depois, transcrevi o áudio bruto e o limpo com o Parakeet TDT 0.6B v2 open-source da NVIDIA, um dos motores do benchmark da Krisp, e pontuei cada segmento rotulado contra as transcrições humanas.
Resultados
Quase toda a melhoria veio de um único lugar: as janelas em que o interlocutor principal estava em silêncio e outra pessoa continuava falando. No áudio bruto, o Parakeet transformou essa fala de fundo em 331 palavras de transcrição. Após o Voice Isolation, ele não produziu nenhuma. A voz de fundo ficou de 13 a 34 dB mais baixa nessas janelas, enquanto o nível do interlocutor principal praticamente não mudou (dentro de 1 dB).
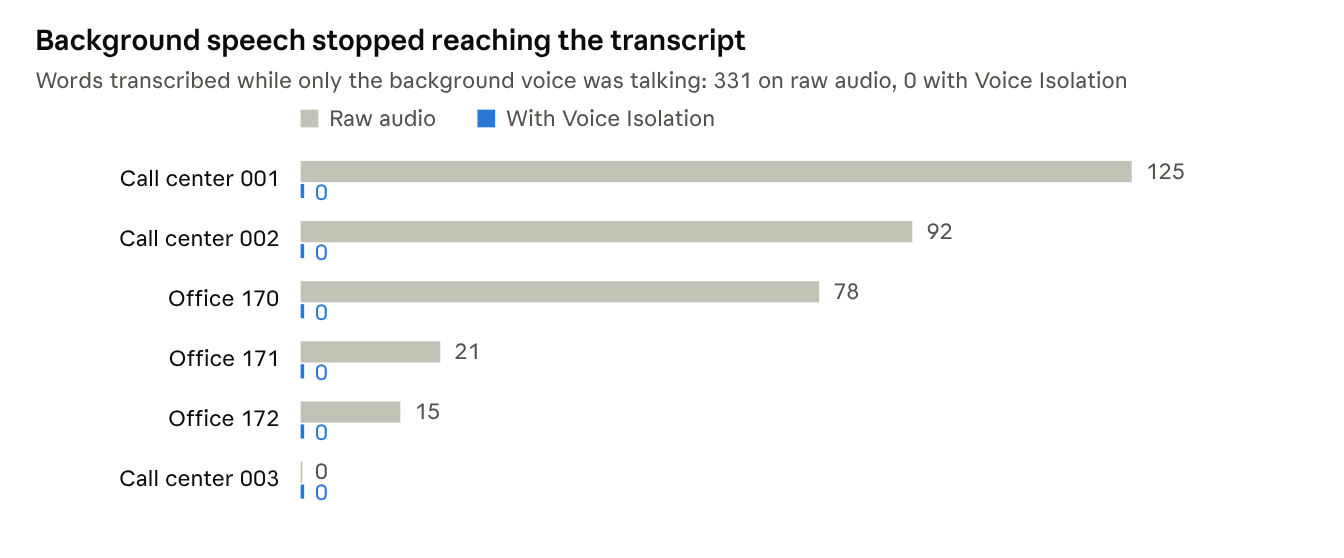
Meu teste · API da Krisp (VIVA-tel), transcrito com Parakeet TDT 0.6B v2 · as 6 gravações com janela apenas de fundo
O exemplo do call center mostra por que isso importa. Enquanto o agente que eu estava testando pausava, o agente da mesa ao lado estava em outra chamada. A transcrição bruta capturou aquela chamada palavra por palavra:
thank you for calling meridian bank before i begin i will need to confirm your identity for security could you give me your full name your date of birth...
Um agente de voz trataria isso como se fosse o interlocutor falando. Com o Voice Isolation, a mesma janela voltou vazia.
Quando as duas pessoas falavam ao mesmo tempo, a mudança foi pequena: 13,2% bruto contra 12,5% limpo. O Parakeet já favorecia a voz mais alta e mais próxima nesses trechos. A maioria dos erros restantes aí é de formatação de números na minha pontuação (telefones, preços, CEPs), o que afetou ambas as versões igualmente.
Nas duas chamadas telefônicas limpas, um arquivo ganhou um erro extra e o outro perdeu dois. Isso está alinhado com a própria constatação da Krisp de que o custo em áudio limpo é pequeno.
Latência e confiabilidade de fora dos EUA
A API atualmente roda apenas na região dos EUA, e a documentação da Krisp alerta que clientes em outros lugares verão latência adicional. Da Ásia, o tempo médio de ida e volta para um quadro (envio até o retorno do áudio limpo) foi de 260–520 ms, dependendo da sessão, e configurar uma sessão geralmente levava de 1,5 a 3 segundos. Isso é distância de rede, não o modelo: a Krisp declara 15 ms de latência algorítmica. Mas se o seu agente atende usuários longe dos EUA, você sentirá — e o SDK nos seus próprios servidores evita isso.
Uma das minhas nove sessões caiu cerca de 70 segundos depois, com um fechamento anormal. Rodar de novo funcionou. Atribuo isso à longa rota vinda da Ásia, e não ao serviço, mas é um lembrete para tratar reconexões em produção.
Sobre este teste: oito arquivos é uma amostra pequena, não um benchmark. Reamostrei as gravações de 32 kHz para 16 kHz para o modelo de telefonia (VIVA-tel), usei um único motor de STT e mantive a normalização de texto simples, então meus números absolutos não são comparáveis aos da Krisp. O que eu estava verificando era a direção e a magnitude da mudança — e ela correspondeu ao que a Krisp relata.
Experiência do desenvolvedor: API ou SDK
O Voice Isolation é oferecido de duas formas, e qual você pode usar depende do seu plano.
A API é o caminho mais fácil: nenhum arquivo de modelo para distribuir e nada para rodar na sua CPU. Os trade-offs são que o seu áudio vai para a nuvem da Krisp e você recebe dois modelos em vez de quatro: o VIVA-tel para áudio telefônico de 8 ou 16 kHz e o VIVA-pro para áudio wideband de 32 kHz. O VIVA-pro ainda não está na referência da API, mas está no Playground do portal, a API o aceitou no meu teste e a Krisp confirmou que está disponível.
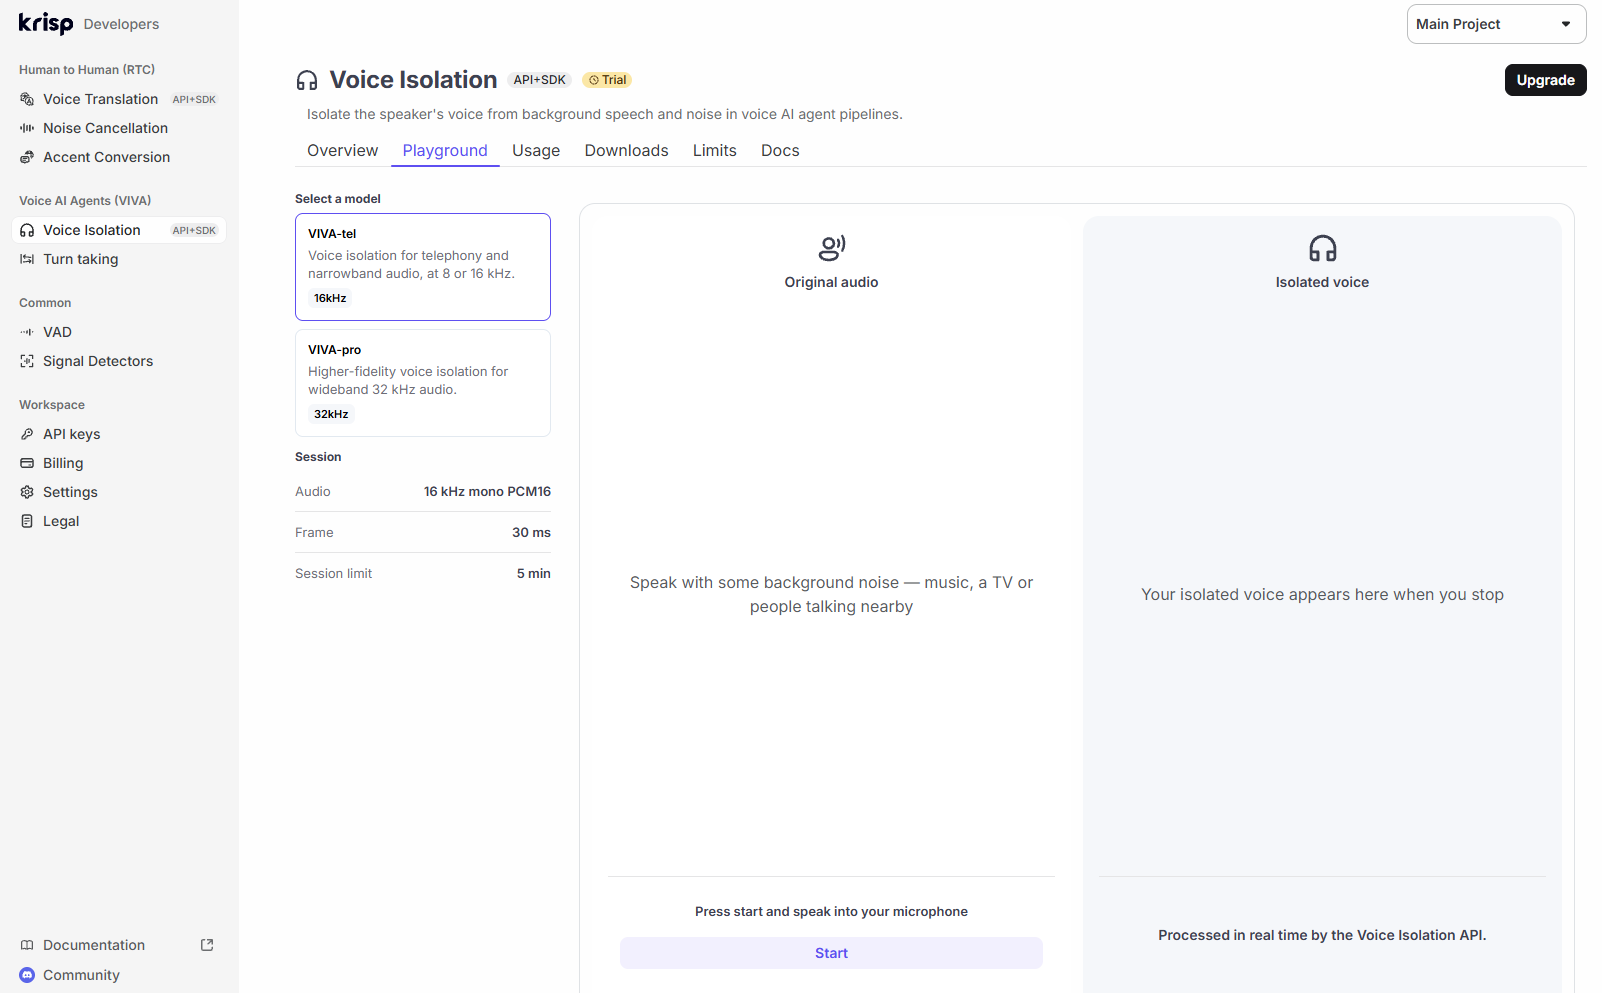
O Playground do portal permite testar qualquer um dos modelos da API com o seu próprio microfone antes de escrever qualquer código.
O SDK mantém o áudio nos seus próprios servidores e só vai online para verificar a licença. É também aqui que a história de custos fica interessante. O post sobre CPU da Krisp mostra que uma única flag do SDK, enableLowPrecisionExecution, praticamente dobra o número de chamadas que um servidor consegue limpar em CPUs com suporte a FP16. Uma instância AWS Graviton3 de 16 vCPUs passou de 76 chamadas ao vivo para 137, e o modelo Lite mantém cerca de três vezes mais streams que os modelos completos. Em chips Intel Ice Lake mais antigos, a flag não faz nada.
Integrações
- Pipecat tem um filtro pronto. Você adiciona o KrispVivaFilter() como filtro de entrada de áudio do seu transporte e pode combiná-lo com o KrispVivaTurn para detecção de turnos. Note que ele usa o SDK, então você precisa de acesso ao SDK e aos arquivos do modelo, não apenas de uma chave de API.
- LiveKit oferece os modelos da Krisp no LiveKit Cloud, incluindo o cancelamento de voz de fundo (noise_cancellation.BVC()) para agentes. O LiveKit cobra um valor extra pelos seus modelos de isolamento de voz.
- Pipelines WebRTC e de telefonia podem usar o SDK diretamente, e a API funciona com qualquer coisa que abra um WebSocket.
A documentação é clara e atualizada. O quickstart funcionou de primeira, e as mensagens de erro dizem exatamente o que deu errado, incluindo o tamanho de quadro esperado e o recebido. Minha única ressalva é a nomenclatura: o blog fala em Default, Balanced, Lite e HD, os downloads do SDK usam nomes de arquivo como krisp-viva-vi-tel-v2.5.1, e a API chama seus modelos de VIVA-tel e VIVA-pro, com apenas o primeiro na referência da API. Uma tabela de equivalência na documentação ajudaria.
Preços
A API é cobrada por hora de áudio, e é barata o suficiente para que o custo não deva decidir se você a usa.
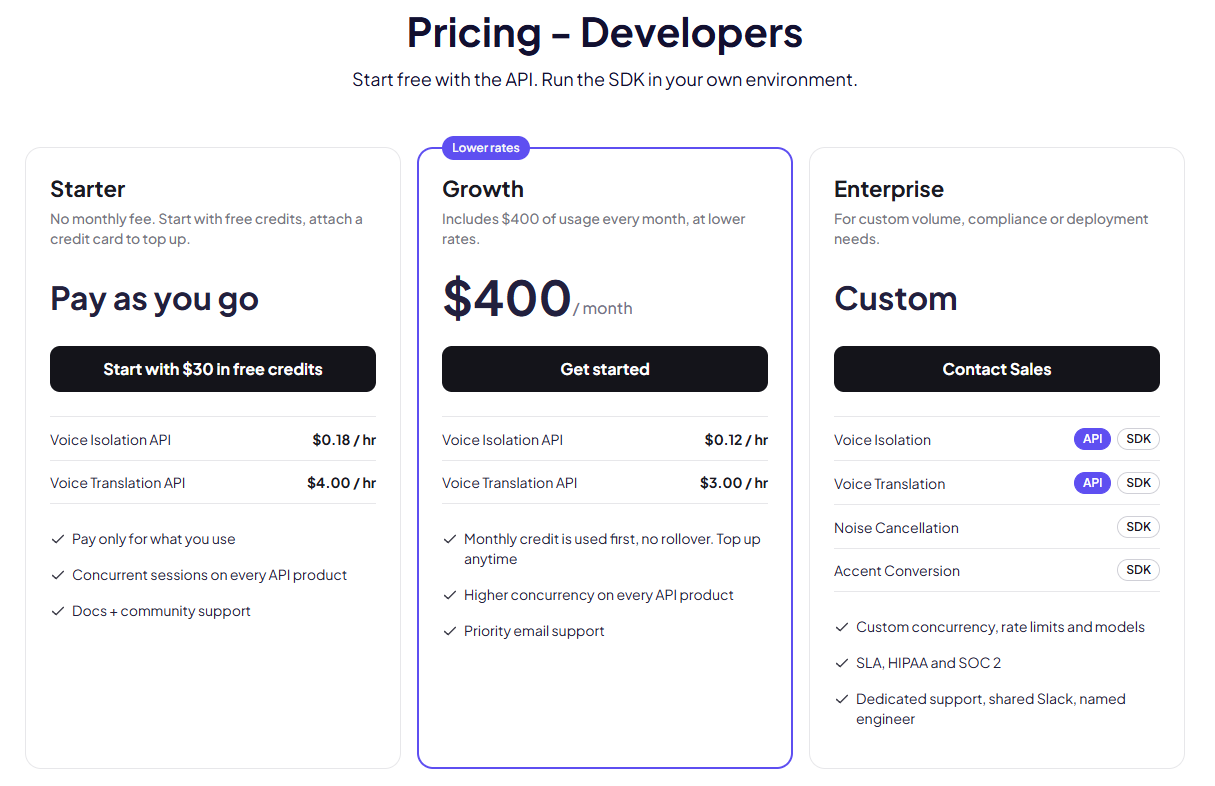
Preços para desenvolvedores da Krisp, novembro de 2026.
No plano Starter pay-as-you-go, a API Voice Isolation custa US$ 0,18 por hora de áudio, sem mensalidade. A tarifa é a mesma para os dois modelos da API, VIVA-tel e VIVA-pro. O Growth custa US$ 400 por mês, inclui US$ 400 de uso e reduz a tarifa para US$ 0,12 por hora, com maior concorrência e suporte prioritário. O Enterprise é sob medida e é o único plano que inclui o SDK, um SLA e HIPAA e SOC 2.
O crédito inicial de US$ 30 cobre cerca de 166 horas de áudio na tarifa Starter, o que é mais do que suficiente para testes. Os créditos duram 12 meses e o uso é cobrado por minuto. Para dar uma escala: uma chamada de 5 minutos custa cerca de 1,5 centavo para limpar no Starter.
O SDK está disponível apenas no plano Enterprise, a um preço acordado, então você precisará falar com o comercial se quiser rodar os modelos nos seus próprios servidores. As tarifas vêm da página de preços da Krisp, verificadas em novembro de 2026.
Alternativas
A Krisp não é a única opção para remover vozes de fundo, mas ainda não existe um teste independente comparando esses produtos diretamente. Cada fornecedor publica seus próprios números sobre seus próprios dados, então trate os números abaixo como afirmações.
Onde a Krisp se destaca é nas evidências. É o único fornecedor aqui com um benchmark aberto e reproduzível em 11 configurações de STT, e publica os casos em que perde. Também é a mais flexível para implantar: API em nuvem, SDK no servidor ou integrada ao LiveKit e ao Pipecat.
Veredito
O Krisp Voice Isolation é a solução a recorrer quando um agente de voz se comporta mal em chamadas reais e funciona bem em testes. Ele remove as vozes que o seu agente não deveria ouvir, funciona com o STT que você já usa, e tanto o benchmark da Krisp quanto o meu próprio teste mostram a mesma coisa: a fala de fundo deixa de chegar à transcrição.
Prós
- Remove vozes de fundo, não apenas ruído — que é o problema que o STT não resolve sozinho
- Funciona com qualquer motor de STT, sem configuração por idioma ou cadastro de voz
- Roda em CPU com 15 ms de latência algorítmica
- Benchmark aberto e reproduzível que inclui os casos em que perde
- API self-serve com US$ 30 de crédito gratuito, e barata: US$ 0,12–US$ 0,18 por hora
- Filtro pronto para Pipecat e suporte no LiveKit
Contras
- Pequeno custo de precisão em áudio telefônico limpo, e ainda pior que o áudio bruto em salas com eco intenso
- A API roda apenas na região dos EUA, o que adiciona latência perceptível em outros lugares
- A API oferece dois modelos contra os quatro do SDK; uso on-premise exige o SDK Enterprise
Quem deve usar: equipes cujos agentes recebem chamadas de call centers, escritórios, casas, carros ou qualquer lugar onde outras pessoas falam por perto. Comece pela API para medir o efeito nas suas próprias gravações e migre para o SDK se precisar dos outros modelos, de menor latência fora dos EUA ou de manter o áudio nos seus servidores.
Quem pode dispensar: agentes cujos interlocutores estão quase sempre sozinhos em salas silenciosas, ou dispositivos far-field como smart speakers, para os quais os modelos de remoção de voz não foram projetados.
Você pode experimentar a API do Krisp Voice Isolation com os créditos gratuitos e passar suas próprias gravações por ela em uma tarde.
FAQ
Isolamento de voz é a mesma coisa que cancelamento de ruído? Não. O cancelamento de ruído remove sons que não são fala, como trânsito e teclados. O isolamento de voz também remove as vozes de outras pessoas, que o cancelamento de ruído deixa passar.
O Krisp Voice Isolation funciona com o meu provedor de STT? Sim. Ele processa o próprio áudio, então funciona na frente de qualquer motor de STT. A Krisp o testou com 11 configurações, incluindo modelos da Deepgram, AssemblyAI, ElevenLabs, Soniox, Google, Cartesia e NVIDIA. Ele também pode ficar na frente de modelos de fala-para-fala. A Krisp ainda não publicou resultados para essa configuração, mas nada impede que você experimente.
Ele substitui a detecção de turnos? Não. Ele fica antes do VAD e da detecção de turnos e entrega a eles um áudio mais limpo. A Krisp oferece o Turn-Taking como um modelo separado no mesmo SDK VIVA.
Os usuários precisam cadastrar a voz? Não. Não exige cadastro nem treinamento na voz do usuário.
Quanta latência ele adiciona? A Krisp declara 15 ms de latência algorítmica, e a documentação do SDK indica uma latência adicional de cerca de 20 ms. Com a API em nuvem, o tempo de rede até a região dos EUA vem por cima disso.
Funciona em chamadas telefônicas? Sim. Ele lida com áudio de telefonia narrowband, codecs comuns como G.711, G.722, G.729 e Opus, e headsets Bluetooth.
E em chamadas entre humanos? A mesma tecnologia é oferecida como Background Voice Cancellation (BVC) no SDK RTC da Krisp, que roda no dispositivo do usuário em navegadores e aplicativos desktop e mobile. Contact centers com agentes humanos a recebem por meio do produto call center AI da Krisp, onde ela mantém as vozes dos agentes próximos fora das chamadas dos clientes.