
A Moonshot AI lançou o Kimi K3 em 16 de julho de 2026, e a cobertura do lançamento o enquadrou como um desafio direto à Anthropic. A TechCrunch relatou que o K3 era esperado para diminuir a diferença com modelos de código fechado, citando fontes que disseram que ele poderia igualar ou até superar o Claude Opus 4.8. Este artigo compara os dois dimensão por dimensão, com os números que podemos verificar e os que não podemos claramente marcados.
A versão curta: o K3 vence em preço, janela de contexto e abertura; o Opus 4.8 oferece as garantias de um fornecedor gerenciado maduro. Como ambos falam o formato OpenAI SDK, você pode executar a mesma solicitação através de cada um e comparar saídas, latência e custo em uma ferramenta como Apidog.
TL;DR e o veredito em um piscar de olhos
O Kimi K3 é um modelo de mistura de especialistas de 2,8 trilhões de parâmetros com uma janela de contexto de 1 milhão de tokens, preço de entrada baixo e pesos abertos que chegam por volta de 27 de julho de 2026. O Claude Opus 4.8 é um modelo proprietário fechado da linha Opus da Anthropic, com preço mais alto e uma forte reputação de raciocínio e capacidade de agente. A pontuação independente da Artificial Analysis coloca o K3 em um Índice de Inteligência de 57, classificado como #4 entre 189 modelos, o melhor da categoria entre os pesos abertos.
Aqui está a leitura rápida:
- Escolha o Kimi K3 para uma janela de contexto muito grande, baixo custo em alto volume ou a capacidade de auto-hospedar e ajustar pesos abertos.
- Escolha o Claude Opus 4.8 para um relacionamento maduro com o fornecedor, suporte gerenciado e SLAs, e um longo histórico de produção em trabalhos de agente difíceis, se você estiver disposto a pagar o prêmio.
- Está perto, não resolvido. Nenhuma tabela de benchmark independente e comparativa K3 versus Opus 4.8 existe ainda, então trate qualquer manchete de "um supera o outro no geral" com cautela.
Uma nota de enquadramento. O modelo de topo atualmente disponível da Anthropic é o Claude Fable 5; o Opus 4.8 é um nível forte abaixo dessa fronteira, não o carro-chefe. O blog de lançamento da Moonshot diz que o K3 "ainda fica atrás dos modelos proprietários mais poderosos, Claude Fable 5 e GPT 5.6 Sol", nomeando Fable 5 e Sol, não Opus. Portanto, a história honesta não é "modelo aberto destrona a Anthropic". É "modelo aberto diminui a lacuna, vence em preço, contexto e abertura, e fica atrás apenas no nível mais alto de qualidade."
O lançamento e por que esta comparação existe
O K3 é o maior passo da Moonshot na escada dos pesos abertos, e com 2,8 trilhões de parâmetros totais, é o maior modelo de peso aberto da China até o momento. A arquitetura se baseia em Kimi Delta Attention, Attention Residuals e um design que a Moonshot chama de Stable LatentMoE, que ativa 16 de 896 especialistas por token. A Moonshot não publicou a contagem de parâmetros ativos, então não vamos estimá-la. O explicador principal sobre o que é o Kimi K3 cobre a arquitetura e o acesso na íntegra.
A comparação existe porque as empresas continuam perguntando se modelos fechados caros valem a pena quando um modelo de peso aberto se aproxima em qualidade e roda em seu próprio hardware. O enquadramento se tornou “K3 vs Opus 4.8” em vez de “K3 vs Fable 5” porque o Opus 4.8 é o nível onde um desafiante aberto tem uma chance plausível. O relatório da TechCrunch tem o contexto de mercado.
Kimi K3 e Claude Opus 4.8 em resumo
Aqui está a comparação lado a lado das dimensões que alteram uma decisão de compra. Onde um dado não é publicamente confirmado, a célula indica.
| Dimensão | Kimi K3 | Claude Opus 4.8 |
|---|---|---|
| Fornecedor | Moonshot AI | Anthropic |
| Lançado | 16 de julho de 2026 | Parte da linha Claude Opus 4 |
| Tipo de modelo | MoE de 2.8T-parâm (Stable LatentMoE, 16 de 896 especialistas ativos) | Proprietário, arquitetura não revelada |
| ID/acesso do modelo | kimi-k3, compatível com OpenAI SDK |
Claude API (família claude-opus-4-8) |
| Janela de contexto | 1.048.576 tokens (1M) | Grande, mas abaixo da janela de 1M do K3 |
| Preço de entrada | $0.30 / M acerto de cache, $3.00 / M erro de cache | $5.00 / M |
| Preço de saída | $15.00 / M | $25.00 / M |
| Velocidade de saída | ~62 tokens/seg (Artificial Analysis) | Não citado aqui; veja Artificial Analysis |
| Pontuação independente | Índice de Inteligência 57, #4 de 189 (Artificial Analysis) | Nível proprietário superior (veja Artificial Analysis) |
| Pesos | Pesos abertos, por volta de 27 de julho de 2026 | Fechado |
| Posição de qualidade | Melhor entre os abertos; atrás de Fable 5 e GPT 5.6 Sol (Moonshot) | Nível proprietário forte abaixo da fronteira Fable 5 da Anthropic |
A maioria das células favorece o K3 em economia e acesso. A qualidade é a linha contestada, e vamos aprofundar nela a seguir.
Inteligência e qualidade: onde o nível superior ainda se mantém
A qualidade é a dimensão mais difícil de definir, porque nenhum benchmark independente compartilhado compara K3 e Opus 4.8 diretamente ainda. O sinal independente mais claro é da Artificial Analysis, cujo Índice de Inteligência coloca o K3 na ou perto da fronteira em uma mistura de raciocínio, codificação e avaliações de conhecimento, e o principal modelo de peso aberto nessa classificação. Também observa que o K3 é mais lento que a média e é verboso.
O contrapeso vem da própria Moonshot. Seu blog de lançamento é franco: o desempenho geral do K3 "ainda fica atrás dos modelos proprietários mais poderosos, Claude Fable 5 e GPT 5.6 Sol." Essa frase nomeia Fable 5 e Sol, não Opus 4.8. Portanto, a própria admissão da Moonshot coloca o K3 atrás de Fable 5 e Sol, e não diz nada sobre o K3 perder para o Opus 4.8.
A tabela de benchmark do fornecedor corrobora isso. Nos números de lançamento da Moonshot, na configuração máxima de raciocínio, o K3 supera o Opus 4.8 em todos os benchmarks listados:
| Benchmark | Kimi K3 | Claude Opus 4.8 |
|---|---|---|
| Terminal-Bench 2.1 | 88.3 | 84.6 |
| DeepSWE | 67.5 | 59.0 |
| BrowseComp | 91.2 | 84.3 |
| Automation Bench | 30.8 | 27.2 |
| SpreadsheetBench 2 | 34.8 | 31.6 |
Estes são números executados pelo fornecedor, não uma comparação independente direta: um laboratório publica as suítes onde ele se sai bem. Mas são os números reais publicados da Moonshot, e eles mostram o K3 à frente do Opus 4.8 em toda a linha, incluindo no DeepSWE, a métrica de codificação de agente mais difícil do conjunto. Para uma visão com tags de fonte, consulte o detalhamento dos benchmarks do Kimi K3, e para o concorrente de fronteira que realmente lidera o K3, Kimi K3 vs GPT-5.6 Sol. O resultado honesto: nos números que temos, o K3 está pelo menos empatado com o Opus 4.8 e à frente na própria suíte da Moonshot. As vantagens reais do Opus 4.8 não são as pontuações de benchmark; são a maturidade das ferramentas da Anthropic, o histórico de confiabilidade e as garantias de fornecedor gerenciado.
Preço: a maior lacuna
O custo é onde os dois mais divergem, e os números são publicados. O Kimi K3 cobra $0.30 por milhão de tokens para entrada com acerto de cache, $3.00 para entrada com erro de cache e $15.00 para saída. O Claude Opus 4.8 cobra $5.00 de entrada e $25.00 de saída. Portanto, o K3 é drasticamente mais barato na entrada em cache ($0.30 vs $5.00), ainda menos da metade do preço em um erro de cache ($3.00 vs $5.00), e 40% mais barato na saída ($15.00 vs $25.00).
Para uma carga de trabalho pesada em contexto repetido, como um chatbot reenviando o mesmo prompt de sistema e documentos, o preço de acerto de cache do K3 se transforma em uma grande economia, e para a geração de alto volume, a lacuna de saída sozinha pode remodelar uma fatura mensal. Para modelar seu próprio tráfego, o guia de preços do Kimi K3 detalha os níveis, e a postagem de preços do Claude Opus 4.8 faz o mesmo no lado da Anthropic.
Uma ressalva: mais barato por token nem sempre significa mais barato por tarefa. Um modelo verboso pode anular parte de sua vantagem por token ao gerar mais tokens, e a Artificial Analysis sinaliza o K3 como verboso, então meça o custo total em prompts reais, não na tabela de preços.
Janela de contexto: espaço para trabalhar
O contexto é uma vitória clara do K3 no papel. O Kimi K3 expõe uma janela de 1.048.576 tokens, suficiente para armazenar grandes bases de código, longos conjuntos de documentos ou históricos de várias conversas estendidas em uma única solicitação sem fragmentação agressiva. O Claude Opus 4.8 também oferece uma grande janela, mas abaixo do limite de 1M do K3.
Se sua carga de trabalho for genuinamente de contexto longo (um repositório inteiro, um conjunto de contratos do tamanho de um livro, um longo corpus de pesquisa em um único prompt), o K3 oferece mais espaço antes que você construa mecanismos de recuperação. Mas uma janela maior é uma capacidade, não uma garantia de qualidade em toda a extensão, então valide se as respostas permanecem precisas em um prompt de um milhão de tokens antes de confiar nele.
Abertura: pesos abertos versus fechados
A abertura muda o que você pode fazer com o modelo, e nenhuma quantidade de preço ou benchmark o substitui. Os pesos do Kimi K3 serão lançados por volta de 27 de julho de 2026, abrindo opções que um modelo fechado não pode: auto-hospedagem para residência de dados ou ambientes isolados, ajuste fino em seus próprios dados e liberdade de limites de taxa ou roteiro de um único fornecedor. Para indústrias regulamentadas, "os pesos rodam em nosso hardware" pode ser o fator decisivo, independentemente das pontuações de benchmark.
O Claude Opus 4.8 é fechado. Você o acessa através da API da Anthropic e obtém um serviço gerenciado: hospedagem consistente, relacionamento de suporte, políticas publicadas e nenhuma infraestrutura para executar. A documentação da API da Anthropic cobre a família de modelos. O K3 lhe dá controle e responsabilidade; o Opus lhe dá conveniência e um fornecedor para se apoiar.
Velocidade e latência
A velocidade é mais nuançada do que um único número. A Artificial Analysis mede o K3 em aproximadamente 62 tokens de saída por segundo, abaixo da mediana de ~73 para sua faixa de preço, embora seu tempo para o primeiro token seja rápido, de ~1.99 segundos. Assim, o K3 parece responsivo no início de uma resposta, mas gera o corpo lentamente, e a saída verbosa faz com que as conclusões longas pareçam ainda mais lentas. Não temos um número independente correspondente para o Opus 4.8, então compare ambos em seus próprios prompts se o throughput em saídas longas for importante.
Matriz de decisão por carga de trabalho
Em vez de coroar um único vencedor, combine o modelo com o trabalho.
| Carga de trabalho | Melhor adequação | Porquê |
|---|---|---|
| Tarefas com contexto muito longo (repositórios inteiros, grandes conjuntos de documentos) | Kimi K3 | A janela de 1M de tokens reduz o trabalho de fragmentação e recuperação |
| Geração de alto volume e sensível ao custo | Kimi K3 | Taxas de entrada e saída mais baixas, forte precificação de acerto de cache |
| Auto-hospedagem, residência de dados ou ajuste fino | Kimi K3 | Pesos abertos por volta de 27 de julho de 2026 |
| Raciocínio mais difícil e limite de qualidade de agente | Testar ambos | Contestado: os próprios benchmarks de lançamento da Moonshot colocam o K3 à frente do Opus 4.8, mas são executados pelo fornecedor e o Opus tem um histórico de produção mais longo em agentes complexos |
| Confiabilidade e suporte de missão crítica | Claude Opus 4.8 | Serviço comercial gerenciado com SLAs, suporte e políticas publicadas |
| Aplicativos interativos sensíveis à latência | Testar ambos | O K3 tem tempo rápido para o primeiro token, mas geração mais lenta e verbosa |
| Protótipos e projetos paralelos com orçamento limitado | Kimi K3 | Caminho mais barato para qualidade próxima da fronteira |
O K3 domina economia, contexto e controle, e pelos próprios benchmarks da Moonshot, ele iguala ou supera o Opus 4.8 em qualidade também. O que o Opus 4.8 detém é o conforto de um fornecedor gerenciado. A maioria das equipes descobrirá que algumas cargas de trabalho apontam para um lado e outras para o outro, então mantenha ambos ao alcance em vez de padronizar em um.
Casos de uso no mundo real
Uma startup construindo um produto de análise de documentos. Contratos longos, alto volume de consultas, margens apertadas. O contexto de 1M do K3 e o baixo preço se encaixam quase perfeitamente, e os pesos abertos oferecem um caminho de auto-hospedagem se a residência de dados se tornar um requisito posteriormente.
Uma empresa automatizando fluxos de trabalho de agente com várias etapas. A confiabilidade é importante e os erros são caros. Os benchmarks da Moonshot colocam o K3 à frente, mas o histórico de produção mais longo do Opus 4.8 é o que algumas equipes pagam um prêmio até que esses números sejam reproduzidos.
Um banco regulamentado que não pode enviar dados para APIs de terceiros. O debate sobre benchmark é irrelevante: os pesos abertos do K3 rodam dentro do próprio ambiente do banco, enquanto o Opus 4.8 como um serviço de API fechada pode estar completamente fora de cogitação.
Testando ambos com a mesma solicitação no Apidog
Comparações em papel só te levam até certo ponto. Como o Kimi K3 é compatível com o OpenAI SDK e o Claude Opus 4.8 é acessível através de sua própria API, você pode configurar ambos como solicitações no Apidog e enviar a mesma carga útil para cada um.
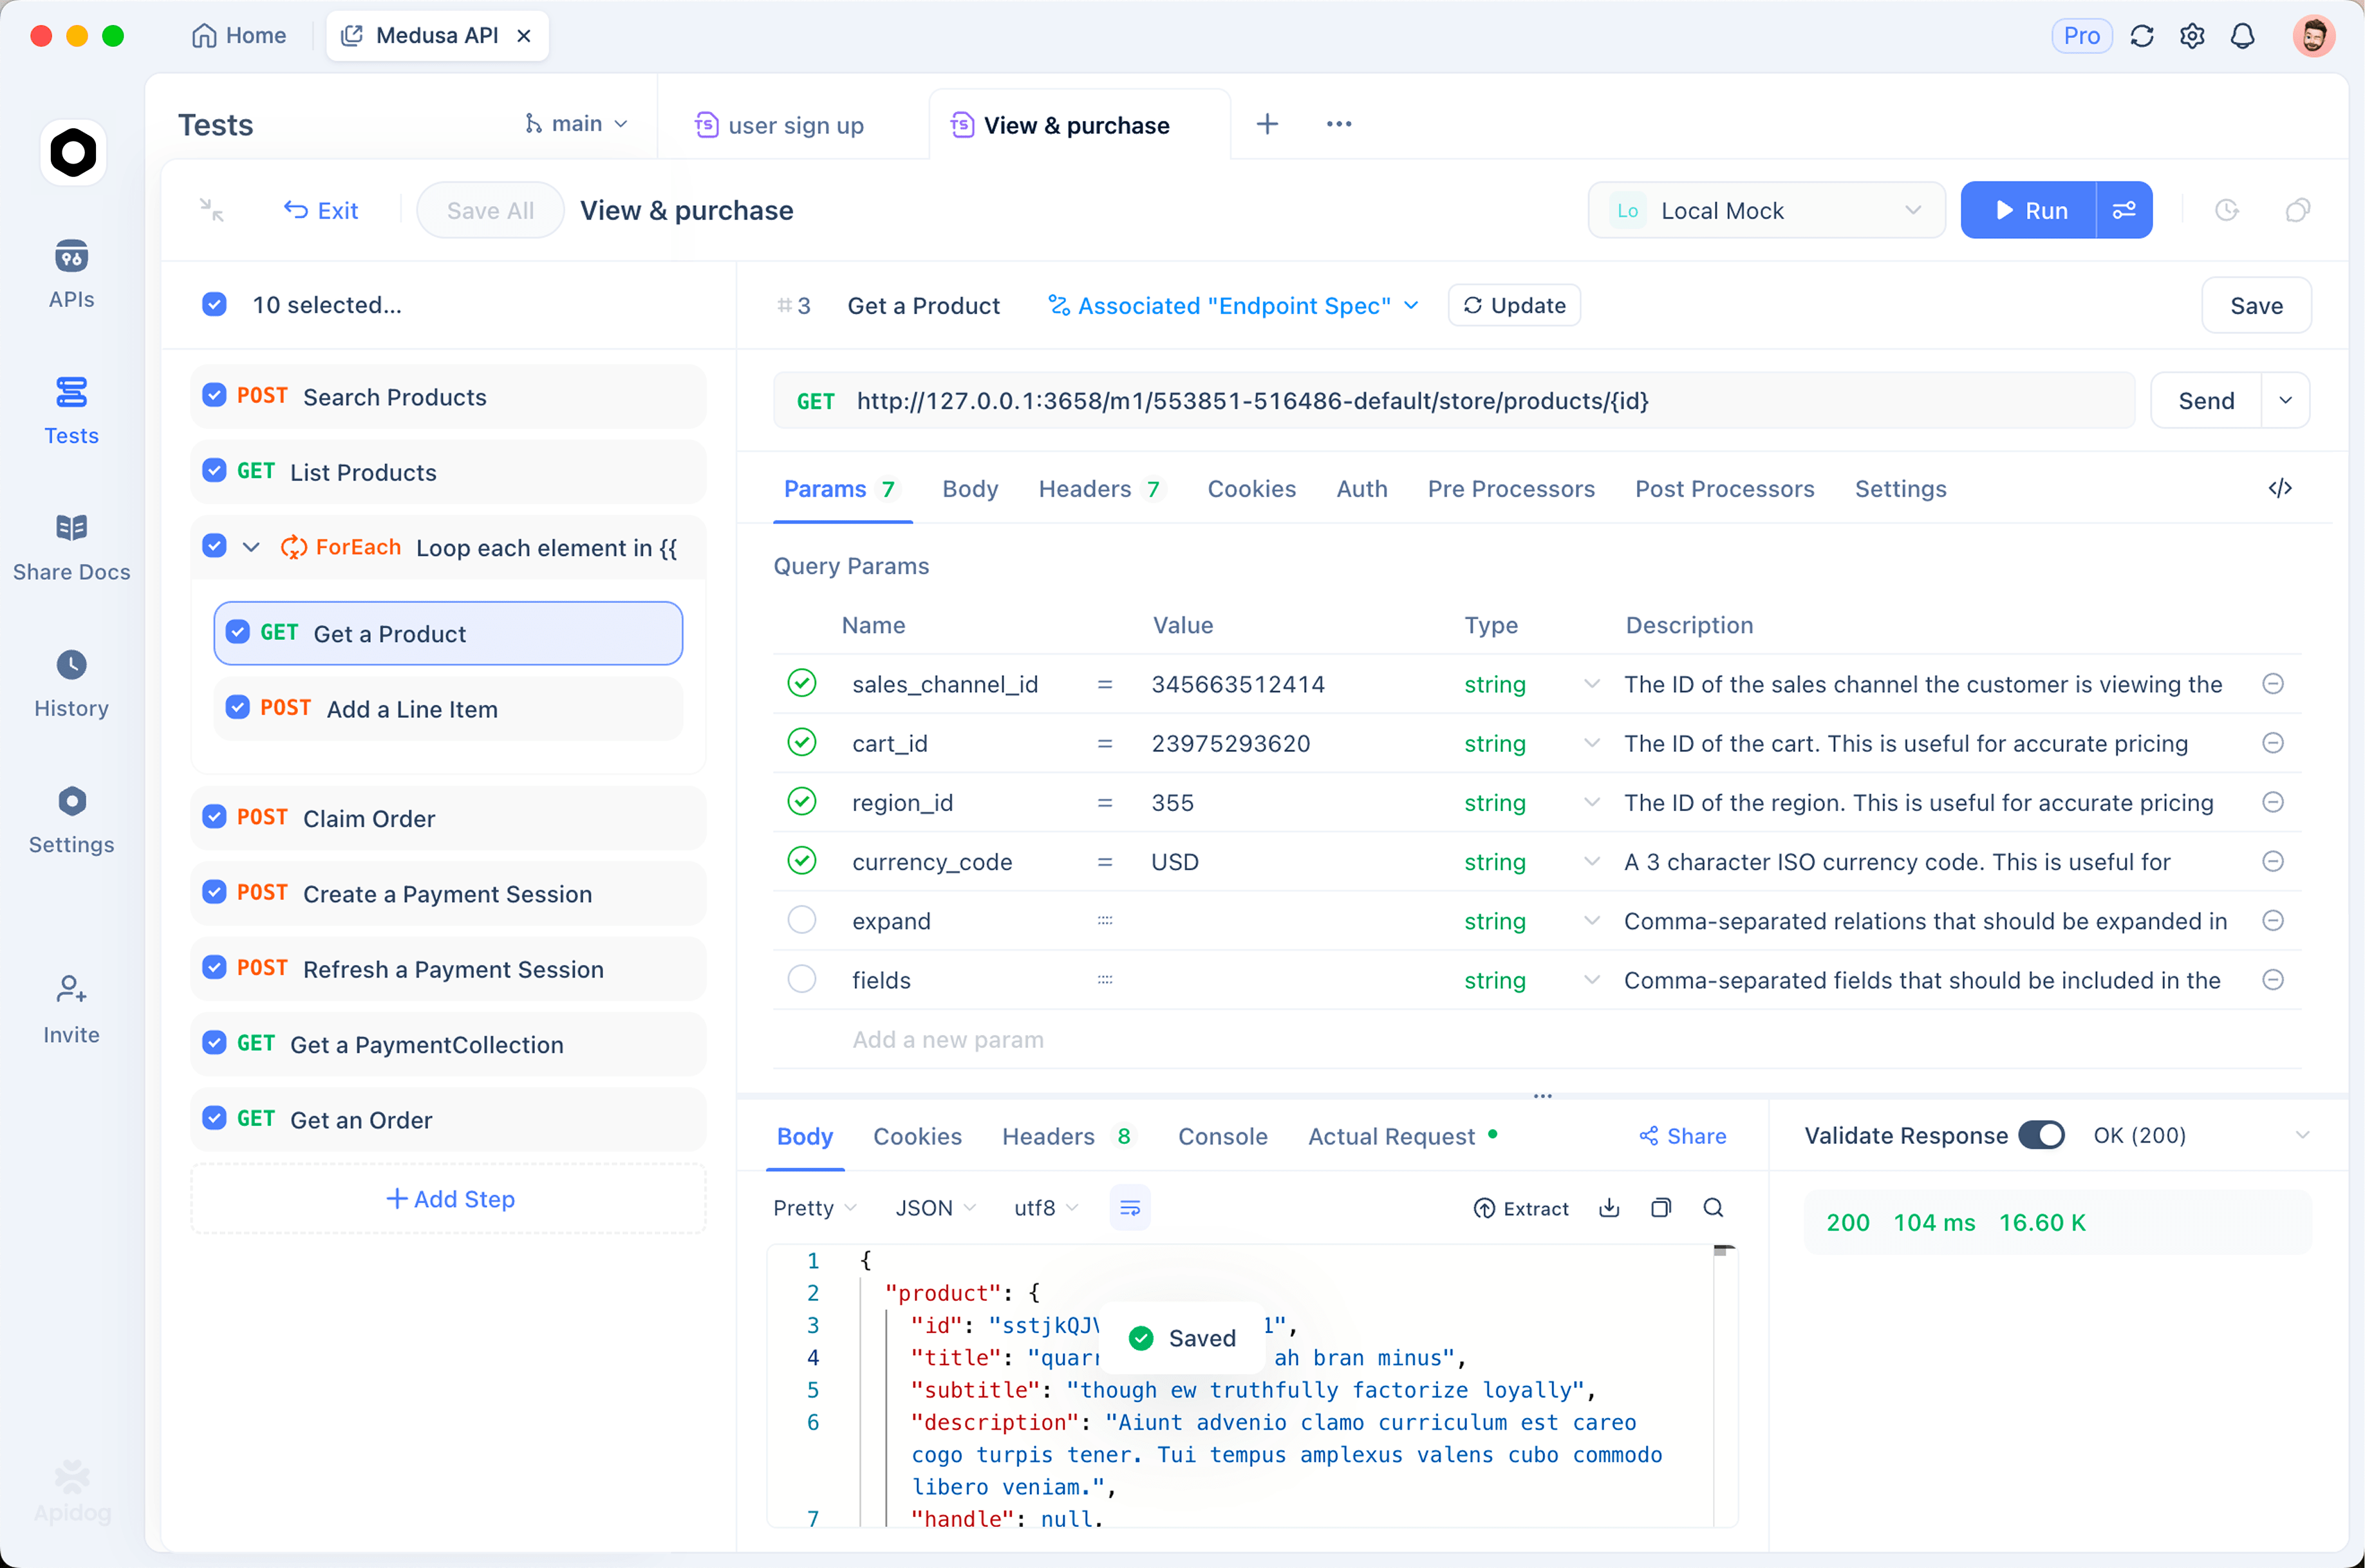
Crie uma solicitação para o endpoint K3 e outra para o Opus, armazene suas chaves e URLs base como variáveis de ambiente, e então envie o mesmo prompt para ambos. O Apidog mostra o corpo da resposta, status e tempo para cada chamada, para que você possa comparar a qualidade da resposta, latência e custo do token em entradas idênticas, e salvá-los como uma coleção oferece um arnés repetível para reexecutar sempre que qualquer um dos modelos for atualizado. Você pode realizar essas verificações com o Apidog dentro do VS Code, e a abordagem serve também como teste de API sem Postman. Baixe o Apidog para configurá-lo você mesmo. O objetivo: substituir "qual modelo é melhor em geral" por "qual é melhor para este prompt, a este custo, com esta latência."
Conclusão
O Kimi K3 supera o Claude Opus 4.8 decisivamente em preço, janela de contexto e abertura, e nos próprios benchmarks de lançamento da Moonshot, ele também supera o Opus 4.8 em qualidade, embora esses números sejam executados pelo fornecedor e ainda não reproduzidos independentemente. O que o Opus 4.8 mantém é o lado da garantia: um fornecedor gerenciado, políticas publicadas e um histórico comprovado de confiabilidade em trabalhos de agente difíceis. Se sua carga de trabalho for de contexto longo, sensível ao custo ou precisar de auto-hospedagem, o K3 é a escolha pragmática; se você deseja um relacionamento comercial e um histórico comprovado, o Opus 4.8 vale o seu prêmio. Como ainda não existe uma comparação independente direta, teste ambos com seus próprios prompts antes de se comprometer.
Perguntas frequentes
O Kimi K3 é melhor que o Claude Opus 4.8? Está perto, e pelos números que temos, o K3 parece pelo menos equivalente. Ele vence em preço, contexto e abertura, e nos próprios benchmarks de lançamento da Moonshot, ele supera o Opus 4.8 em todas as tarefas listadas, embora esses números sejam executados pelo fornecedor e ainda não reproduzidos independentemente. A Moonshot diz que o K3 fica atrás dos principais modelos proprietários, mas nomeia Fable 5 e GPT-5.6 Sol, não Opus 4.8, então a verdadeira vantagem do Opus 4.8 é seu histórico e suporte gerenciado, não uma liderança em benchmark.
Quão mais barato é o Kimi K3? O K3 lista $0.30 por milhão de tokens para entrada com acerto de cache, $3.00 para entrada com erro de cache e $15.00 para saída. O Opus 4.8 lista $5.00 de entrada e $25.00 de saída. Assim, o K3 é muito mais barato na entrada em cache, menos da metade do preço em um erro de cache e cerca de 40% mais barato na saída. As economias reais dependem de quanto da sua entrada pode ser armazenada em cache.
Existe um benchmark independente comparando Kimi K3 e Opus 4.8 diretamente? Ainda não. A Artificial Analysis fornece pontuações independentes do Índice de Inteligência para modelos individuais, e a Moonshot publica seus próprios números de benchmark, mas não há uma tabela compartilhada e comparativa K3 versus Opus 4.8. Trate as vitórias relatadas pelo fornecedor, incluindo o dado "primeiro em quatro de oito benchmarks de automação", como auto-relatadas até serem reproduzidas independentemente.
O Kimi K3 é um concorrente do Opus 4.8 ou do Claude Fable 5? O K3 compete em todo o campo. A cobertura de lançamento o enquadrou contra o Opus 4.8 porque esse é o nível que um desafiante aberto pode plausivelmente alcançar. A fronteira atual da Anthropic é o Claude Fable 5, que a Moonshot reconhece que o K3 ainda fica atrás, então o K3 é melhor compreendido como se aproximando do campo proprietário, em vez de superá-lo.