
O preço do Kimi K3.1 Pro na API é de US$ 2,00 por 1M de tokens de entrada e US$ 10,00 por 1M de tokens de saída, com acertos de cache a US$ 0,20 por 1M. O Kimi K3.1 Pro Highspeed custa exatamente o dobro: US$ 4,00 de entrada e US$ 20,00 de saída. Não há assinatura nem sobretaxa de contexto longo ao longo da janela de 1.048.576 tokens, mas o modelo só é desbloqueado após uma recarga de US$ 1.
A seguir: cálculos de cache, exemplos práticos, faixas de tarifas, planos para consumidores e comparação de preços de tabela. Os números vêm da página de preços da API da Moonshot AI, do guia de cache de contexto, da página de limites de taxa e do preço da assinatura, consultados em 24 de outubro de 2026. Novo no modelo? Comece por o que é o Kimi K3.1 Pro.
Tabela de preços da API do Kimi K3.1 Pro
O preço da API do Kimi K3.1 Pro é pay as you go, por 1M de tokens, sem impostos. Cada modelo tem cinco tarifas: entrada, saída, acerto de cache e uma tarifa de gravação de cache para cada um dos dois tempos de vida do cache (5 minutos e 1 hora).
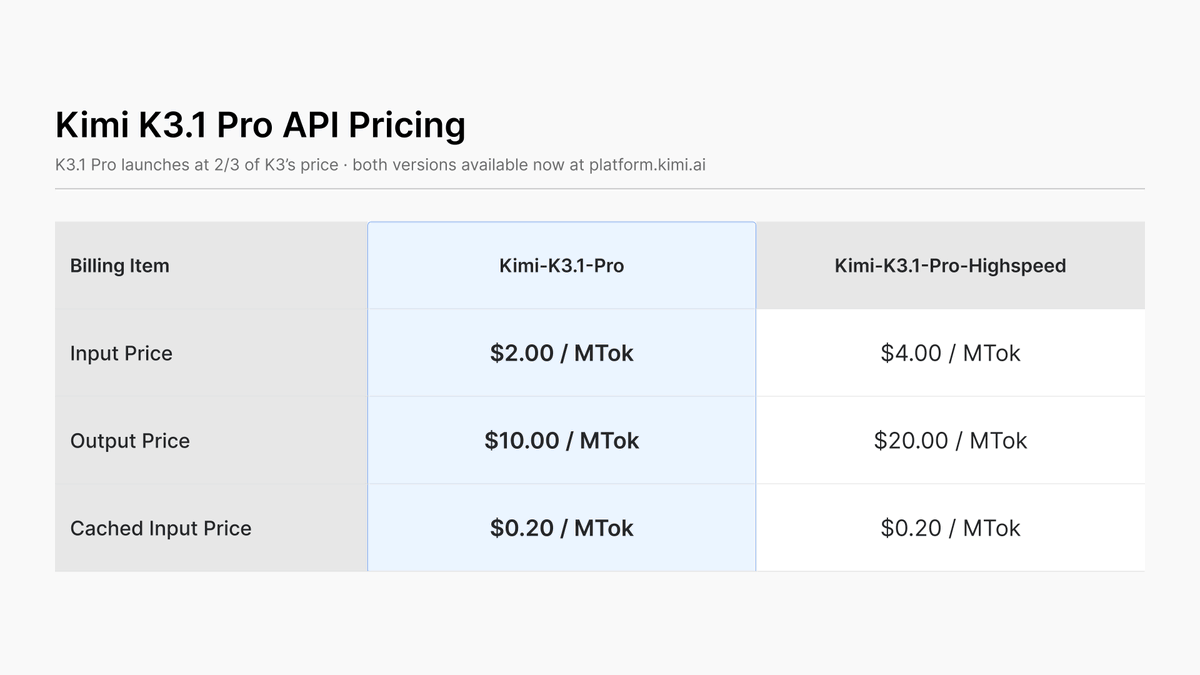
O K3.1 Pro custa um terço a menos que o K3 (veja nosso guia da API do Kimi K3).
Como funciona o preço de cache do Kimi K3.1 Pro
O preço de cache do Kimi K3.1 Pro tem duas partes. Na primeira vez que um prefixo é processado, ele é cobrado como gravação de cache. Requisições posteriores que reutilizam exatamente esse mesmo prefixo dentro do tempo de vida do cache são cobradas como acerto de cache a US$ 0,20 por 1M, um décimo do preço de entrada.
O que determina sua conta:
- O cache é automático, com TTL padrão de 5 minutos.
- Uma gravação de 5 minutos custa o mesmo que a entrada (US$ 2,00). A Moonshot diz que “o custo de gravação já estava incluído no preço de entrada”.
- Uma gravação de 1 hora custa o dobro: US$ 4,00 por 1M.
- Cada acerto renova o TTL, que fica travado no valor da primeira gravação. O cache é compartilhado apenas dentro da sua organização.
Defina o TTL de 1 hora no Chat Completions ou na Responses API:
"prompt_cache_options": {"mode": "implicit", "ttl": "1h"}
Na Messages API compatível com a Anthropic, use um "cache_control": {"type": "ephemeral", "ttl": "1h"} de nível superior.
5m vs 1h: o ponto de equilíbrio
Considere um prefixo de 1M de tokens. A gravação de 1 hora custa US$ 2,00 a mais (US$ 4,00 vs US$ 2,00). Cada acerto então economiza US$ 1,80 em relação à entrada cheia (US$ 2,00 menos US$ 0,20). Dois acertos economizam US$ 3,60, o que cobre os US$ 2,00 extras.
A regra: se as requisições podem ficar mais de 5 minutos separadas umas das outras e você vai reutilizar o prefixo pelo menos duas vezes na hora, escolha 1h. Se as requisições chegam a cada poucos minutos, o cache gratuito de 5 minutos continua se renovando.
Exemplos práticos de preços do Kimi K3.1 Pro
Ambos usam preços de tabela; substitua pelas suas próprias contagens de tokens.
Exemplo 1: um prompt de base de código de 200K tokens reutilizado 20 vezes em uma hora
Você carrega um snapshot de repositório de 200K tokens (0,2M de tokens) e faz 20 perguntas ao longo de uma hora, algumas com mais de 5 minutos de intervalo. Apenas o lado da entrada:
| Configuração | Cálculo | Custo de entrada |
|---|---|---|
| Sem acertos (o cache de 5m fica expirando) | 20 × 0,2M × US$ 2,00 | US$ 8,00 |
| Cache de 1h | gravação 0,2M × US$ 4,00 = US$ 0,80, mais 19 acertos × 0,2M × US$ 0,20 = US$ 0,76 | US$ 1,56 |
| Cache de 5m, uma pergunta a cada 3 minutos | gravação 0,2M × US$ 2,00 = US$ 0,40, mais US$ 0,76 | US$ 1,16 |
O cache de 1 hora reduz o custo de entrada de US$ 8,00 para US$ 1,56, economizando US$ 6,44 (cerca de 80%). Com 2.000 tokens de saída por resposta, adicione 40.000 × US$ 10,00 por 1M = US$ 0,40 a cada linha.
Exemplo 2: um aplicativo de chat com 1.000 requisições por dia
Cada requisição envia 2.000 tokens de entrada e recebe 500 tokens de saída, com reasoning_effort em "low":
- Entrada: 1.000 × 2.000 = 2M × US$ 2,00 = US$ 4,00 por dia
- Saída: 1.000 × 500 = 0,5M × US$ 10,00 = US$ 5,00 por dia
- Total: US$ 9,00 por dia, cerca de US$ 270 por mês, ou US$ 0,009 por requisição
Agora transforme 1.500 desses tokens de entrada em um prompt de sistema fixo. Uma requisição a cada 86 segundos em média fica bem dentro do TTL de 5 minutos, então quase toda requisição acerta o cache:
- Em cache: 1,5M × US$ 0,20 = US$ 0,30; fora do cache: 0,5M × US$ 2,00 = US$ 1,00
- Novo total: US$ 1,30 + US$ 5,00 = US$ 6,30 por dia, cerca de US$ 189 por mês
Um detalhe: 1.000 × 2.500 = 2,5M de tokens por dia excede o limite diário de 1,5M do Tier0, então você precisaria do Tier1.
Preço do Kimi K3.1 Pro Highspeed
O preço do Kimi K3.1 Pro Highspeed é um prêmio fixo de 2x sobre entrada, saída e gravações de cache, pelo que a Moonshot chama de “2-3x a velocidade do K3.1 Pro”. Os acertos de cache permanecem em US$ 0,20.
| Exemplo 2, sem cache | Entrada | Saída | Total diário |
|---|---|---|---|
| K3.1 Pro | 2M × US$ 2 = US$ 4,00 | 0,5M × US$ 10 = US$ 5,00 | US$ 9,00 |
| K3.1 Pro Highspeed | 2M × US$ 4 = US$ 8,00 | 0,5M × US$ 20 = US$ 10,00 | US$ 18,00 |
Custos de esforço de raciocínio, batch e busca na web
Três detalhes que a tabela não mostra:
- Tokens de raciocínio contam para o seu uso. O K3.1 Pro sempre pensa;
reasoning_effortaceita"low","high"ou"max"(padrão"max"), e reduzi-lo diminui o uso de tokens. A Moonshot não afirma textualmente que o raciocínio é cobrado à tarifa de saída [VERIFY]; se for, 500 tokens de raciocínio extras por requisição adicionam US$ 5,00 por dia ao Exemplo 2. - Sem desconto de batch para o K3.1 Pro. A Batch API cobra 60% do padrão, mas suporta apenas
kimi-k2.7-codeekimi-k2.6. - A busca na web é cobrada por chamada.
/v1/tools/searche/v1/tools/fetchcustam US$ 0,002 cada,/v1/tools/search_proUS$ 0,003, cobrados somente em HTTP 200 com resultados não vazios: US$ 2,00 por 1.000 buscas básicas. O legado$web_searchcusta US$ 0,005 mais os tokens dos resultados e não é recomendado no momento (preço da busca na web).
Requisições interrompidas por um 429 não são cobradas.
O desbloqueio de US$ 1 e as faixas de taxa da API
O K3.1 Pro “é desbloqueado após uma recarga bem-sucedida (mínimo de US$ 1)”. Esse US$ 1 compra cerca de 500K tokens de entrada ou 100K tokens de saída, ou cerca de 111 requisições do Exemplo 2 (US$ 1 ÷ US$ 0,009). A recarga acumulada define sua faixa:
| Faixa | Recarga acumulada | Concorrência | RPM | TPM | TPD |
|---|---|---|---|---|---|
| Tier0 | US$ 1 | 1 | 3 | 500.000 | 1.500.000 |
| Tier1 | US$ 10 | 15 | 100 | 2.000.000 | Ilimitado |
| Tier2 | US$ 20 | 40 | 100 | 3.000.000 | Ilimitado |
| Tier3 | US$ 100 | 50 | 200 | 3.000.000 | Ilimitado |
| Tier4 | US$ 1.000 | 60 | 200 | 4.000.000 | Ilimitado |
| Tier5 | US$ 3.000 | 100 | 300 | 5.000.000 | Ilimitado |
Com US$ 5 acumulados você ganha um voucher de US$ 5, que não conta para a sua faixa; não está declarado se os vouchers pagam pelo K3.1 Pro [VERIFY]. Para opções de US$ 0, veja como usar o Kimi K3.1 Pro gratuitamente.
Planos de assinatura Kimi
Os planos de assinatura Kimi cobrem os aplicativos Kimi e o Kimi Code, não a API. Preços mensais:
| Plano | Cobrança anual | Cobrança mensal | Economia anual | Observações |
|---|---|---|---|---|
| Adagio | US$ 0 | US$ 0 | n/a | Chat do K3.1 Pro, sem Kimi Code |
| Plus | US$ 15 | US$ 19 | US$ 48 | Kimi Code com k3.1-pro |
| Pro | US$ 31 | US$ 39 | US$ 96 | Adiciona Highspeed, contexto de 1M no Kimi Code |
| Max | US$ 79 | US$ 99 | US$ 240 | Até 1M de contexto no chat |
| Ultra | US$ 159 | US$ 199 | US$ 480 | Até 1M de contexto no chat |
Economia = (mensal menos anual) × 12; para o Ultra, US$ 40 × 12 = US$ 480. Saldos e chaves da API, do Kimi Code e da assinatura não são intercambiáveis: uma assinatura não se converte em saldo de API, e o saldo de API não pode comprar uma assinatura.
Preço do Kimi K3.1 Pro vs Claude Opus 5.5
O Kimi K3.1 Pro tem preço de tabela pela metade do Claude Opus 5.5 em entrada e saída, e iguala o Claude Sonnet 5.5 e o GPT-6.1 Sol até 272K tokens de entrada. Preços de tabela por 1M de tokens, de preços do Claude e preços da OpenAI:
| Modelo | Entrada | Saída | Leitura de cache | Exemplo 2 por dia |
|---|---|---|---|---|
| Kimi K3.1 Pro | US$ 2,00 | US$ 10,00 | US$ 0,20 | US$ 9,00 |
| Claude Opus 5.5 | US$ 4,00 | US$ 20,00 | US$ 0,20 | US$ 18,00 |
| Claude Sonnet 5.5 | US$ 2,00 | US$ 10,00 | US$ 0,10 | US$ 9,00 |
| GPT-6.1 Sol (até 272K) | US$ 2,00 | US$ 10,00 | US$ 0,10 | US$ 9,00 |
| GPT-6 Astra (até 272K) | US$ 10,00 | US$ 50,00 | US$ 1,00 | US$ 45,00 |
Acima de 272K tokens de entrada, a OpenAI lista o GPT-6.1 Sol a US$ 4 / US$ 15 e o GPT-6 Astra a US$ 20 / US$ 75; o K3.1 Pro permanece fixo. Para um prompt de 500K tokens com 5.000 tokens de saída:
- K3.1 Pro: 0,5M × US$ 2 + 0,005M × US$ 10 = US$ 1,00 + US$ 0,05 = US$ 1,05
- GPT-6.1 Sol: 0,5M × US$ 4 + 0,005M × US$ 15 = US$ 2,00 + US$ 0,075 = US$ 2,075 (se a faixa mais alta cobrir a requisição inteira [VERIFY])
Preço de tabela não é custo por tarefa: tokenizadores e comprimentos de raciocínio diferem. Os próprios benchmarks da Moonshot comparam o K3.1 Pro com o Opus 5.5 e o GPT-6 Astra. Veja nossa visão geral do Claude Opus 5.5.
Confirme que o cache funciona com o Apidog CLI
O cache só economiza dinheiro se acertar. Antes de escalar, faça seu agente de programação testá-lo. O Apidog CLI fornece os comandos ao Claude Code, Codex, Cursor ou OpenCode, e o plano gratuito do Apidog cobre até 4 usuários.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
apidog skill install
Depois, dê um único prompt ao seu agente:
In Apidog project <projectId>, create an environment for https://api.moonshot.ai/v1.
Build a test case for POST /chat/completions with model "kimi-k3.1-pro",
reasoning_effort "low", a long fixed system prompt and a short user message.
Send MOONSHOT_API_KEY as a Bearer token. Assert status 200 and log
usage.prompt_tokens_details.cached_tokens. Validate the payload, run it
3 times and tell me whether cached_tokens rises after the first run.
O agente executa:
apidog environment create kimi-prod --project <projectId> --base-url https://api.moonshot.ai/v1
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -n 3 -r cli,json
A primeira iteração grava o cache; as duas seguintes devem reportar cached_tokens acima de zero. A Moonshot não declara um comprimento mínimo de prefixo cacheável nas páginas que lemos [VERIFY], então mantenha o prompt de sistema longo. Casos de teste precisam de um ID de categoria válido (apidog test-case category --project <projectId> os lista). Mais em referência do comando run e Apidog CLI no Claude Code.
5 regras de economia de custos para o Kimi K3.1 Pro
- Coloque o conteúdo estável primeiro: prompt de sistema, definições de ferramentas e documentos de referência. Nada de timestamps ou IDs aleatórios no prefixo.
- Escolha o TTL pelo intervalo. Intervalos acima de 5 minutos e dois ou mais reúsos por hora: use 1h.
- Defina
reasoning_effortpor tarefa. Use"low"para chamadas simples. - Use o Highspeed apenas onde a velocidade compensa. Ele dobra todas as tarifas, exceto os acertos de cache.
- Registre os campos de cache:
cached_tokensecache_write_tokens, comstream_options.include_usage=trueao usar streaming.
Para configurar requisições, leia nosso guia da API do Kimi K3.1 Pro e como usar o Kimi K3.1 Pro.
Perguntas frequentes
Quanto custa o Kimi K3.1 Pro por 1M de tokens?
US$ 2,00 de entrada, US$ 10,00 de saída e US$ 0,20 para acertos de cache. As gravações de cache custam US$ 2,00 (5 minutos) ou US$ 4,00 (1 hora).
O Kimi K3.1 Pro recebe o desconto da Batch API?
Não. O preço de batch cobre apenas kimi-k2.7-code e kimi-k2.6.
Posso usar minha assinatura Kimi para chamadas de API?
Não. A API do Kimi, o Kimi Code e a assinatura são produtos separados, com saldos e chaves separados.
Qual é o mínimo para começar?
Uma recarga de US$ 1. Ela desbloqueia o modelo e coloca você no Tier0: 3 requisições por minuto e 1,5M de tokens por dia.