
O Kimi K2.7 Code da Moonshot foi lançado com benchmarks contra os dois modelos pelos quais a maioria dos desenvolvedores realmente paga: Claude Opus e GPT-5.5. A versão resumida é que a fronteira fechada ainda pontua mais alto na maioria das tarefas de codificação, mas não pela margem que seu preço sugere. Kimi é um modelo de pesos abertos que você pode baixar e hospedar por conta própria, e ele fica a poucos pontos de modelos que você só pode alugar.
Esta comparação coloca os números lado a lado, os pesa contra o custo e a abertura, e lhe diz qual escolher para cada trabalho.
TL;DR
- Qualidade bruta de codificação: GPT-5.5 e Claude Opus lideram na maioria dos conjuntos de testes. O Kimi K2.7 Code fica alguns pontos atrás.
- Custo: Kimi é muito mais barato (US$ 0,95/US$ 4,00 por milhão de tokens) e gratuito para hospedar por conta própria. Os modelos fechados custam mais e não podem ser hospedados em seu próprio hardware.
- Abertura: Kimi distribui pesos abertos sob uma licença MIT modificada. Opus e GPT-5.5 são fechados.
- Veredito: escolha o modelo de ponta para a mais alta qualidade de uma única execução; escolha Kimi quando custo, volume ou controle de dados importarem mais do que os últimos pontos.
Os concorrentes em um relance
| Kimi K2.7 Code | Claude Opus | GPT-5.5 | |
|---|---|---|---|
| Tipo | Pesos abertos (MIT modificado) | Fechado | Fechado |
| Arquitetura | MoE, 1T total / 32B ativos | Não divulgado | Não divulgado |
| Janela de contexto | 256K tokens | Grande | Grande |
| Hospedagem própria | Sim | Não | Não |
| Preço (por M tokens) | US$ 0,95 entrada / US$ 4,00 saída | Mais alto, apenas alugado | Mais alto, apenas alugado |
A diferença estrutural é o destaque. Kimi lhe diz exatamente o que é e permite que você o execute por conta própria. Os outros dois são serviços que você contrata.
Benchmarks de Codificação
Estas são as pontuações relatadas pela Moonshot. Trate-as como a perspectiva do fornecedor, já que vários conjuntos de testes são da própria Moonshot, mas o padrão é consistente e vale a pena ler.
| Benchmark | Kimi K2.7 Code | GPT-5.5 | Claude Opus |
|---|---|---|---|
| Kimi Code Bench v2 | 62.0 | 69.0 | 67.4 |
| Program Bench | 53.6 | 69.1 | 63.8 |
| MLS Bench Lite | 35.1 | 35.5 | 42.8 |
GPT-5.5 ocupa o primeiro lugar nos dois primeiros; Claude Opus lidera no MLS Bench Lite e permanece próximo em todos os outros. Kimi fica um pouco abaixo em cada um. A diferença é real, mas pequena no Kimi Code Bench v2, e maior no Program Bench. Se o seu trabalho se assemelha ao segundo benchmark, o modelo de ponta justifica seu valor.
Benchmarks de Agentes e Uso de Ferramentas
Agentes de codificação dependem crucialmente de chamadas de ferramentas, não apenas da geração de código. Aqui a situação se torna mais apertada.
| Benchmark | Kimi K2.7 Code | GPT-5.5 | Claude Opus |
|---|---|---|---|
| Kimi Claw 24/7 | 46.9 | 52.8 | 50.4 |
| MCP Atlas | 76.0 | 79.4 | 81.3 |
| MCP Mark Verified | 81.1 | 92.9 | 76.4 |
No MCP Mark Verified, Kimi na verdade supera Claude Opus, embora GPT-5.5 esteja bem à frente. No MCP Atlas, os três ficam dentro de cerca de cinco pontos. Para cargas de trabalho baseadas em agentes, Kimi está mais próximo do grupo do que suas pontuações brutas de codificação sugerem, o que é importante porque é exatamente onde os custos de tokens se acumulam.
O custo é onde Kimi vence
Benchmarks medem qualidade. Eles não medem a conta. O Kimi K2.7 Code custa US$ 0,95 por milhão de tokens de entrada e US$ 4,00 por milhão de saída, com acessos ao cache a US$ 0,19 por milhão. Os modelos de fronteira fechados custam significativamente mais por token, e você não pode escapar disso hospedando-os; não há download.
Dois fatores amplificam as economias:
- Pesos abertos significam uma opção de custo zero por token. Hospede-o em seu próprio hardware e o custo por token desaparece completamente. Você o troca por tempo de GPU.
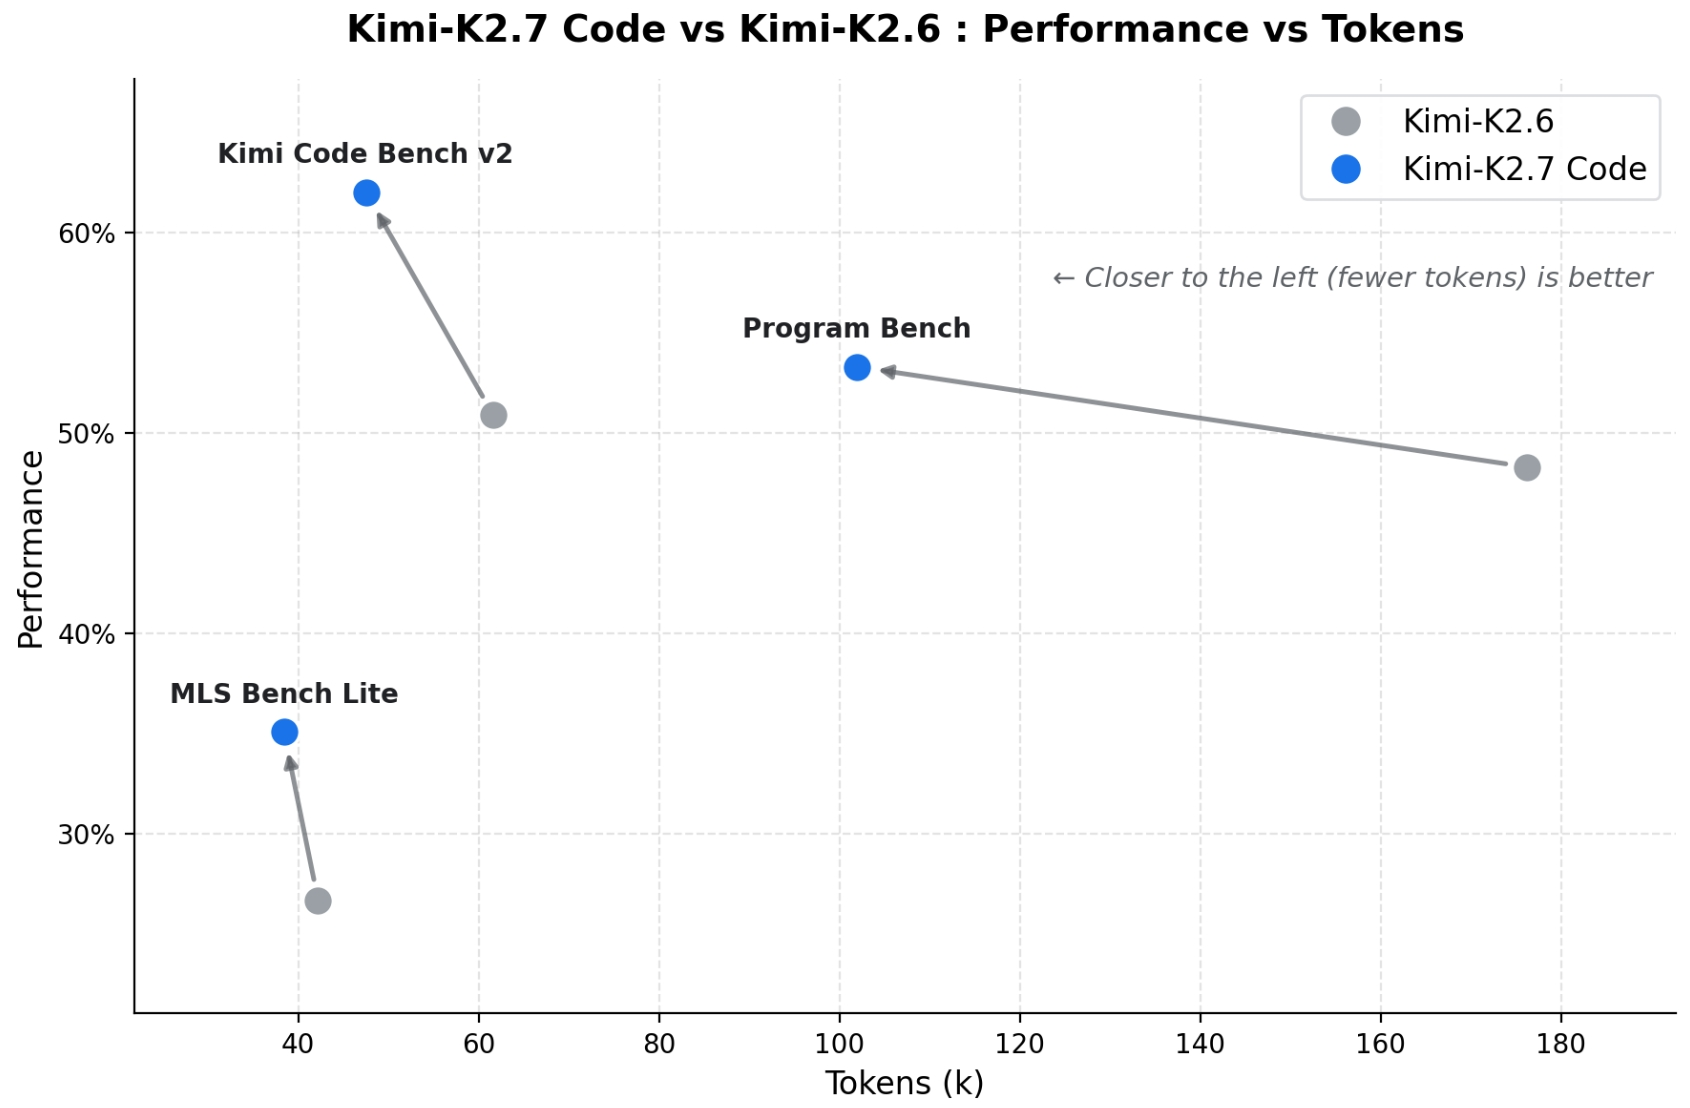
- Raciocínio mais enxuto. O K2.7 Code usa cerca de 30% menos tokens de "pensamento" que o K2.6 para o mesmo trabalho, então cada passo do agente custa menos. Nosso guia sobre como reduzir os custos de tokens de agentes aprofunda o porquê disso ser vantajoso.
Para um agente que faz centenas de chamadas de ferramentas por tarefa, um modelo que é 90% tão bom por uma fração do preço geralmente vence em valor total.
Contexto e abertura
Todos os três lidam bem com contextos longos; a janela de Kimi é de 256K tokens, suficiente para um serviço completo mais seus testes em um único prompt. O maior diferencial é a licença. Os pesos MIT modificados de Kimi permitem que você faça o fine-tuning, audite e execute o modelo em ambiente isolado (air-gapped). Para equipes com regras de conformidade ou residência de dados, isso não é um "bom ter"; é o fator decisivo, e os modelos fechados estão simplesmente fora de questão.
Quando escolher cada um
Escolha GPT-5.5 ou Claude Opus se:
- Você precisa da mais alta qualidade de codificação de uma única execução e alguns pontos de benchmark justificam o custo.
- Você não se importa em alugar um serviço fechado com um SLA gerenciado.
- Suas tarefas mais difíceis se assemelham ao Program Bench, onde a diferença é maior.
Escolha Kimi K2.7 Code se:
- Você executa cargas de trabalho de agentes de alto volume onde o custo do token decide a viabilidade.
- Os dados precisam permanecer em sua própria infraestrutura.
- Você deseja fazer fine-tuning ou auditar o modelo.
- Você está otimizando o valor total, não o topo do ranking.
Para um campo mais amplo, nossa comparação entre MiniMax M3, DeepSeek V4 e Qwen 3.7 abrange os outros desafiantes de pesos abertos, e DeepSeek V4 vs Claude Opus para codificação aprofunda outro confronto entre modelos abertos e fechados. Se você estiver comparando os agentes em vez dos modelos, consulte Claude Code vs OpenAI Codex.
Experimente a comparação você mesmo
Benchmarks são um ponto de partida, não um veredito para sua base de código. O teste honesto é executar todos os três em suas próprias tarefas e ler os resultados. O CLI do Kimi Code lhe dá o agente gratuitamente para começar, e você pode chamar a API de cada modelo diretamente para comparar as saídas brutas.
Quando o fizer, teste os endpoints no Apidog: envie o mesmo prompt para cada modelo, salve as chamadas lado a lado e compare a qualidade da resposta, a latência e o uso de tokens em um só lugar. Baixe o Apidog para fazer o teste comparativo.
FAQ
O Kimi K2.7 Code é melhor que o Claude Opus ou o GPT-5.5? Nos benchmarks de codificação relatados pela Moonshot, não; os modelos fechados pontuam mais alto na maioria dos conjuntos de testes. A vantagem do Kimi são os pesos abertos e um custo muito menor, mantendo-se a poucos pontos de diferença.
Quão mais barato é o Kimi? Custa US$ 0,95 por milhão de tokens de entrada e US$ 4,00 por milhão de saída, e é gratuito para hospedar por conta própria. Os modelos de fronteira fechados custam mais por token e não podem ser auto-hospedados.
Posso executar o Kimi K2.7 Code por conta própria? Sim. Os pesos são abertos sob uma licença MIT modificada; sirva-os com vLLM, SGLang ou KTransformers.
Qual é o melhor para agentes de codificação? Para qualidade bruta, GPT-5.5 lidera. Para agentes de alto volume e custo-eficientes, Kimi é o melhor valor, e está próximo nos benchmarks de agentes.
Estes benchmarks são neutros? Vários conjuntos de testes são da própria Moonshot, então leia-os como a perspectiva do fornecedor. A diferença consistente em relação à fronteira é o sinal útil, não os números exatos.
Resumo
O Kimi K2.7 Code não supera Claude Opus ou GPT-5.5 na maioria dos benchmarks de codificação, e a Moonshot não finge que o faz. Ele pontua alguns pontos abaixo, custando muito menos e fornecendo pesos abertos que você pode executar por conta própria. Para a mais alta qualidade possível, a fronteira fechada ainda vence. Para agentes de alto volume, implantações privadas, ou qualquer pessoa que pese o valor total acima do topo da tabela, Kimi é a escolha mais inteligente. Execute todos os três em seu próprio código, compare as saídas no Apidog e deixe sua carga de trabalho decidir.