
A Alibaba lançou o Qwen 3.8-Max no início de agosto de 2026, e os resultados de busca já estão cheios de alegações de “use-o grátis para sempre” que não resistem ao contato com os termos reais. Aqui está a versão honesta, verificada nas próprias páginas da Alibaba em 3 de agosto de 2026.
Existem exatamente quatro rotas que valem o seu tempo. Duas funcionam hoje. Uma é uma promessa com data marcada. Uma é uma alternativa. Se você quiser ter a visão completa do modelo primeiro (2,4 trilhões de parâmetros totais, 95B ativos, contexto de 1M de tokens), comece com nossa visão geral do Qwen 3.8 e depois retorne.
Mapa rápido antes dos detalhes:
| Rota | Grátis? | Funciona hoje? | Observação |
|---|---|---|---|
| Qwen Chat | Sim | Sim | Aplicativo para consumidor, sem API |
| Cota da API do Model Studio | 1M tokens | Sim | Somente região de Singapura, 90 dias |
| Pesos abertos (auto-hospedagem) | Pesos grátis | Ainda não | Prometido para “próxima semana”, e o hardware não é grátis |
| Modelos Qwen mais antigos | Sim | Sim | Não é o Qwen 3.8 |
Rota 1: Qwen Chat, a opção de configuração zero
O caminho gratuito mais rápido é aquele que a Alibaba deseja para os consumidores: Qwen Chat. Faça login, selecione o modelo e você estará conversando com o Qwen 3.8-Max sem cartão de crédito e sem console na nuvem. A publicação oficial de lançamento aponta para cá como a maneira padrão de experimentar o modelo.
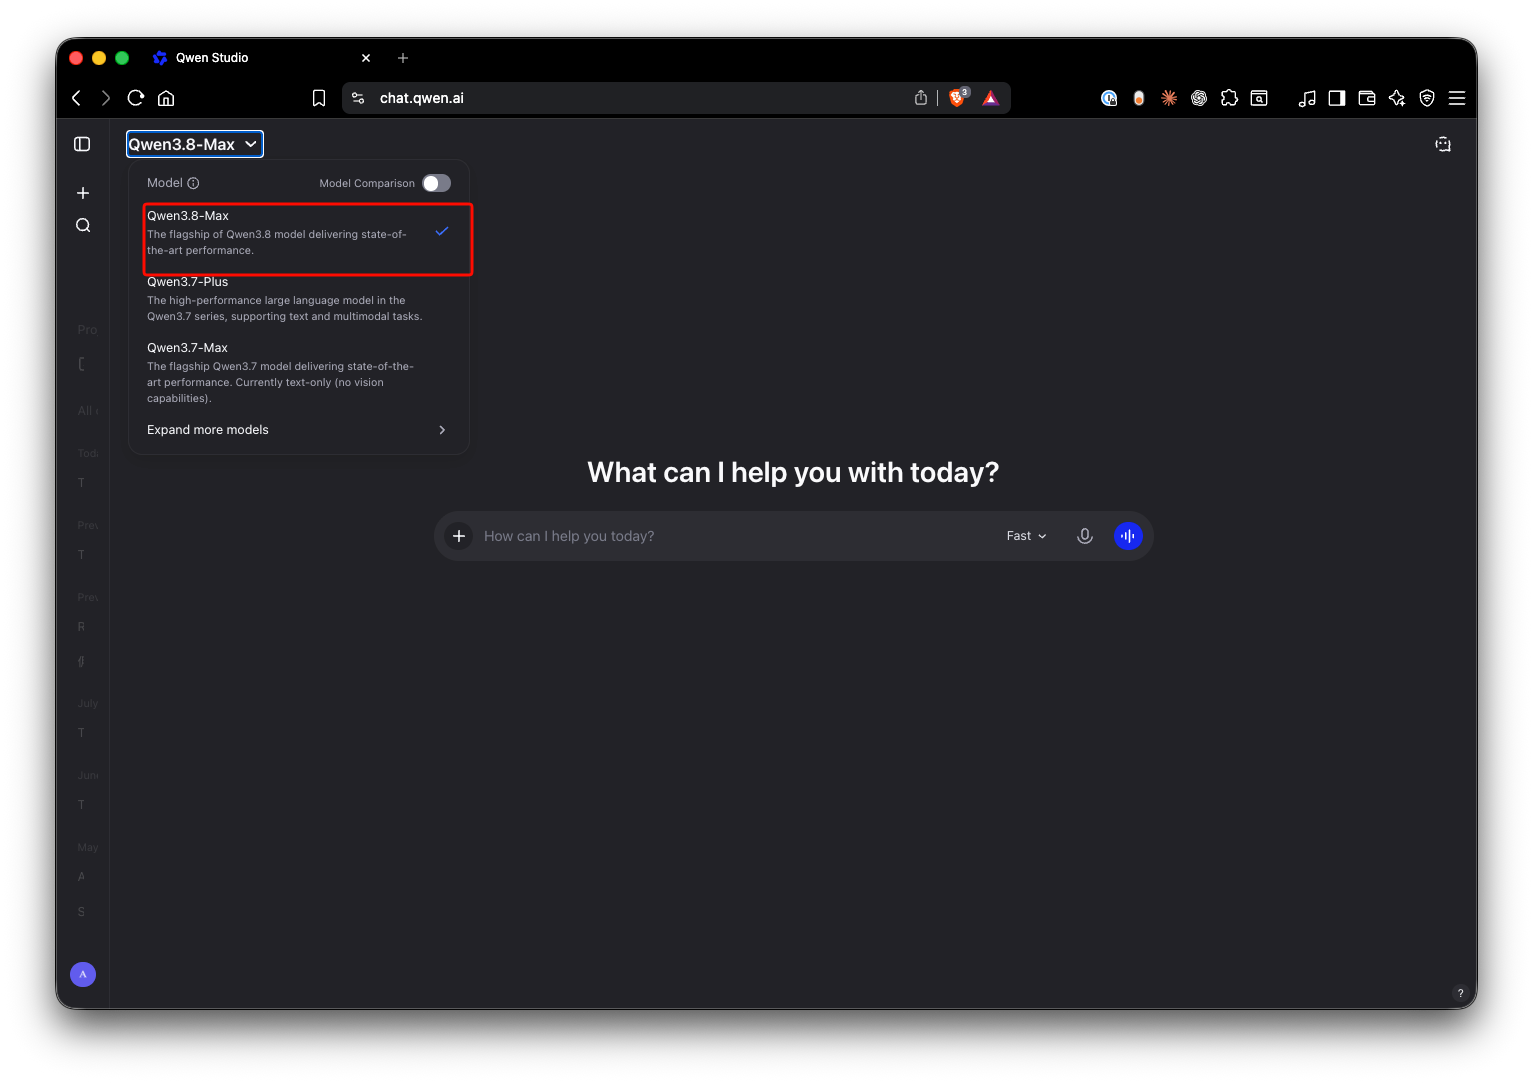
O que você obtém: uso gratuito do modelo principal através de uma interface de chat, incluindo a compreensão de imagens e documentos que as demonstrações de lançamento utilizam.
O que você não obtém: uma API. Sem chaves, sem automação, sem como integrá-lo ao seu aplicativo ou conjunto de testes. Aplicativos de chat também aplicam seus próprios prompts e configurações de sistema, então o comportamento que você vê lá não corresponderá exatamente ao que a API bruta retorna. Se você está avaliando o Qwen 3.8 para um produto, trate o Qwen Chat como uma demonstração, não como um benchmark.
Veredito: real, gratuito e bom para uma primeira avaliação. Não é uma rota para desenvolvedores.
Rota 2: a cota gratuita do Model Studio (leia as letras miúdas)
Esta é a rota que importa se você escreve código. O Alibaba Cloud Model Studio oferece às novas ativações uma cota gratuita para qwen3.8-max: 1 milhão de tokens. É uma quantidade genuinamente útil e também vem acompanhada de letras miúdas que a maioria das publicações de resumo omite.
Aqui está o que a página de preços realmente diz, traduzido em decisões:
1. Somente região de Singapura. A cota gratuita se aplica à região de Singapura (internacional). Isso significa que sua URL base é:
https://dashscope-intl.aliyuncs.com/compatible-mode/v1
Aponte para os endpoints de Pequim ou EUA-Virgínia e você pagará a partir do primeiro token. Se o seu orçamento de latência exigir um endpoint nos EUA, a cota gratuita não o ajudará.
2. 90 dias, depois acabou. A cota é válida por 90 dias a partir da ativação. Tokens não utilizados não são acumulativos; eles expiram. O relógio já está correndo contra o lançamento do modelo no início de agosto, então não ative agora e planeje avaliar em novembro.
3. Após a cota: $2 de entrada / $6 de saída por milhão de tokens. Essa é a taxa fixa para todo o contexto de 1M, sem níveis. É barato para um modelo principal, mas não é grátis, e a transição é automática assim que sua cota se esgota ou expira. Defina um alerta de cobrança antes de começar. Detalhamos quanto custam as cargas de trabalho reais em nosso guia de preços do Qwen 3.8.
Para reivindicar a cota: crie uma conta no Model Studio, ative o serviço e gere uma chave de API (a convenção da variável de ambiente é DASHSCOPE_API_KEY). O catálogo de modelos lista qwen3.8-max no topo dos modelos recomendados. O endpoint utiliza o protocolo compatível com OpenAI, e também há um endpoint compatível com Anthropic. Nosso guia da API do Qwen 3.8 cobre ambos, incluindo streaming e saída de raciocínio.
Uma armadilha que consome cota: o raciocínio está ativado por padrão
O Qwen 3.8-Max vem com reasoning_effort definido como xhigh, e os tokens de "pensamento" são cobrados como saída. Um único prompt complexo pode silenciosamente produzir milhares de tokens de raciocínio antes mesmo que a resposta comece. Em uma conta paga, isso é uma linha de custo; em uma cota gratuita de 1M, é a diferença entre duas semanas de testes e dois dias. Mude reasoning_effort para low ou medium para qualquer coisa que não seja uma tarefa de raciocínio genuína.
Faça o milhão de tokens durar
Um milhão de tokens desaparece rapidamente quando cada iteração de depuração reenvia toda a sua cadeia de prompts. Alguns hábitos o estendem:
- Acerte a requisição antes de fazer um loop. Construa a chamada no Apidog, ajuste os parâmetros e inspecione a resposta em streaming, incluindo as deltas de raciocínio, uma requisição por vez. A depuração interativa em um cliente é melhor do que queimar cota em um loop de retry no seu código de aplicativo.
- Simule o que você já viu. Uma vez que você conhece o formato da resposta, salve um exemplo e deixe o servidor mock do Apidog servi-lo ao seu frontend ou agente enquanto você desenvolve. Iterações de desenvolvimento contra um mock custam zero tokens; você só acessa o endpoint real para verificação final.
- Monitore seu uso real. As contagens de tokens retornam em cada corpo de resposta. Fique de olho nelas por requisição, e você saberá sua taxa de consumo real em vez de descobrir quando a cota acabar no meio do sprint.
Baixe o Apidog gratuitamente se quiser seguir esse fluxo de trabalho; ele também facilita a troca de região, já que você pode armazenar as URLs base de Singapura, Pequim e EUA como ambientes e alternar entre elas.
Veredito: real, genuinamente gratuito por 90 dias, e a melhor rota para desenvolvedores no momento. Apenas respeite o bloqueio de região e a data de expiração.
Rota 3: pesos abertos, prometidos mas ainda não disponíveis para download
A maior manchete do lançamento para o público que busca gratuidade: o Qwen 3.8-Max é o primeiro modelo da classe Qwen-Max com pesos abertos. A Alibaba afirma que os pesos serão disponibilizados no Hugging Face e ModelScope “na próxima semana”, o que os coloca por volta de 10 de agosto.
Em 3 de agosto de 2026, eles não estão disponíveis para download. Não há nada para baixar, nada para quantizar, nada para executar. Se você vir um tutorial “execute o Qwen 3.8 localmente hoje” datado de antes da existência real dos pesos, feche a aba. Para referência, o Kimi K3 fez a mesma promessa de pesos abertos no lançamento e entregou 11 dias depois, então o cronograma é plausível. Apenas ainda não aconteceu.
A verificação da realidade da auto-hospedagem
Mesmo quando os pesos forem liberados, “grátis” precisa de um asterisco do tamanho de um rack de servidor. O Qwen 3.8-Max tem 2,4 trilhões de parâmetros totais. O precedente mais próximo é o Kimi K3: um modelo de 2,8T parâmetros que foi lançado com 594 GB de pesos, mesmo com quantização agressiva MXFP4. Reduza isso ligeiramente para os 2,4T do Qwen e você ainda estará olhando para centenas de gigabytes de pesos e uma configuração de serviço multi-GPU, realisticamente multi-nó. Nenhuma GPU de consumidor comporta isso. Nenhuma estação de trabalho única comporta isso. Detalhamos exatamente como é essa classe de hardware para executar o Kimi K3 localmente, e a economia se aplica aqui inalterada.
Então, o que os pesos abertos realmente lhe oferecem? Principalmente isto: uma vez que os pesos são públicos, hosts de terceiros podem servir o modelo, e a concorrência tende a empurrar os preços de hospedagem abaixo das taxas do próprio provedor. Para a maioria dos leitores, “pesos abertos gratuitos” se traduzirá em acesso à API mais barato através de provedores de hospedagem, e não em um modelo rodando no seu laptop. Isso ainda é uma vitória. É apenas uma vitória diferente do que a frase sugere.
Veredito: ainda não é real. Verifique novamente em meados de agosto e orce hospedagem, não hardware.
Rota 4: a alternativa, modelos Qwen mais antigos genuinamente gratuitos
Se o que você precisa é “um modelo Qwen capaz a custo zero” em vez de “Qwen 3.8-Max especificamente”, a geração anterior possui rotas gratuitas que não expiram em 90 dias. Modelos Qwen menores com pesos abertos já rodam em hardware que as pessoas realmente possuem, e a linha mais antiga tem seus próprios caminhos de acesso sem custo. Mantemos um guia separado sobre como usar o Qwen 3.7 gratuitamente que se mantém atualizado sobre essas opções.
A troca honesta: você desiste dos ganhos de benchmark que fizeram do 3.8-Max uma notícia. Para um projeto paralelo, um classificador ou para aprender a estrutura da API Qwen antes de gastar dinheiro, os modelos mais antigos são muitas vezes suficientes.
O que não é real
Para poupar sua busca, aqui está o que não existe em 3 de agosto de 2026:
- Sem camada de API gratuita ilimitada. A cota de 1M de tokens é o que há, e ela expira.
- Sem camada gratuita fora de Singapura. Os endpoints de Pequim e EUA-Virgínia cobram a partir do primeiro token.
- Sem pesos para download ainda. “Próxima semana” é uma promessa, não um link.
- Sem Qwen 3.8 gratuito oficial em agregadores de terceiros. O acesso hospedado por terceiros provavelmente aparecerá depois que os pesos forem lançados; qualquer coisa antes disso que alegue ser o 3.8-Max gratuito merece ceticismo sobre qual modelo está realmente por trás dela.
FAQ
A API do Qwen 3.8 é realmente gratuita?
Parcialmente. Você recebe 1 milhão de tokens gratuitos através do Alibaba Cloud Model Studio, válidos por 90 dias e apenas na região de Singapura. Depois disso, a taxa é de $2 por milhão de tokens de entrada e $6 por milhão de tokens de saída, então planeje sua avaliação dentro da janela de 90 dias.
Posso baixar e executar o Qwen 3.8 localmente agora?
Não. Os pesos são prometidos para o Hugging Face e ModelScope por volta de 10 de agosto de 2026, e ainda não foram lançados até a data desta redação. Quando forem, planeje centenas de gigabytes e um serviço multi-GPU; este é um modelo de 2,4T parâmetros, não algo que um laptop executa.
Como isso é diferente das opções gratuitas do Kimi K3?
Os pesos do Kimi K3 já estão ativos e disponíveis para download, então sua rota de auto-hospedagem é real hoje, enquanto a do Qwen 3.8 ainda está pendente. Ambos são muito grandes para hardware de consumidor, no entanto. Nosso guia sobre como usar o Kimi K3 gratuitamente cobre as rotas desse modelo se você quiser comparar.
A cota gratuita cobre tokens de "pensamento"?
Sim, mas eles a esgotam. A saída de raciocínio é cobrada como uma saída normal, e o reasoning_effort padrão é xhigh. Diminua-o para chamadas rotineiras ou sua cota desaparecerá em cadeias de pensamento que você nunca leu.
Conclusão
O acesso gratuito ao Qwen 3.8 é real, mas é específico: Qwen Chat para uso casual, e 1M de tokens na região de Singapura com prazo de 90 dias para desenvolvedores. A rota de pesos abertos está a dias de ser lançada no papel e, na prática, significará principalmente acesso hospedado mais barato. Tudo além disso é um modelo mais antigo ou puro desejo em blogs.
Se você optar pela rota da API, gaste sua cota em respostas, não em depuração. Crie protótipos das requisições no Apidog, simule as respostas enquanto você desenvolve e guarde os tokens reais para as execuções de avaliação que realmente dirão se o Qwen 3.8-Max merece um lugar na sua pilha de tecnologia.