
A maioria das pessoas conhece um novo modelo abrindo uma caixa de chat e digitando. Jev pune esse reflexo. É o modelo System One da TypeSafe AI, e ele não produz prosa alguma: você o alimenta com o estado do programa mais um conjunto de perguntas tipadas, e ele retorna decisões com probabilidades anexadas. Essa mudança de papel é a técnica inteira. Seu modelo de linguagem continua escrevendo; Jev decide o que acontece em seguida, e seu código decide o que fazer com a decisão.
Este guia cobre a arquitetura em torno da chamada, não a chamada em si. Se você precisa de um ponto de partida primeiro, comece com o que é Jev, depois leia o post de lançamento da própria TypeSafe para entender a perspectiva da empresa.
No que Jev é excepcional
Três primitivos cobrem tudo o que Jev faz. noul retorna a probabilidade de que uma afirmação sobre o estado seja verdadeira. choice escolhe uma opção de um mapa de critérios (até 255 opções) e retorna a escolha, a distribuição completa de probabilidades e um valor de confiança. score classifica o estado em uma rubrica ordenada de 2 a 10 níveis e retorna o nível, uma legenda, probabilidades e confiança. O histórico da empresa e da família de modelos está em nossa peça sobre TypeSafe AI.
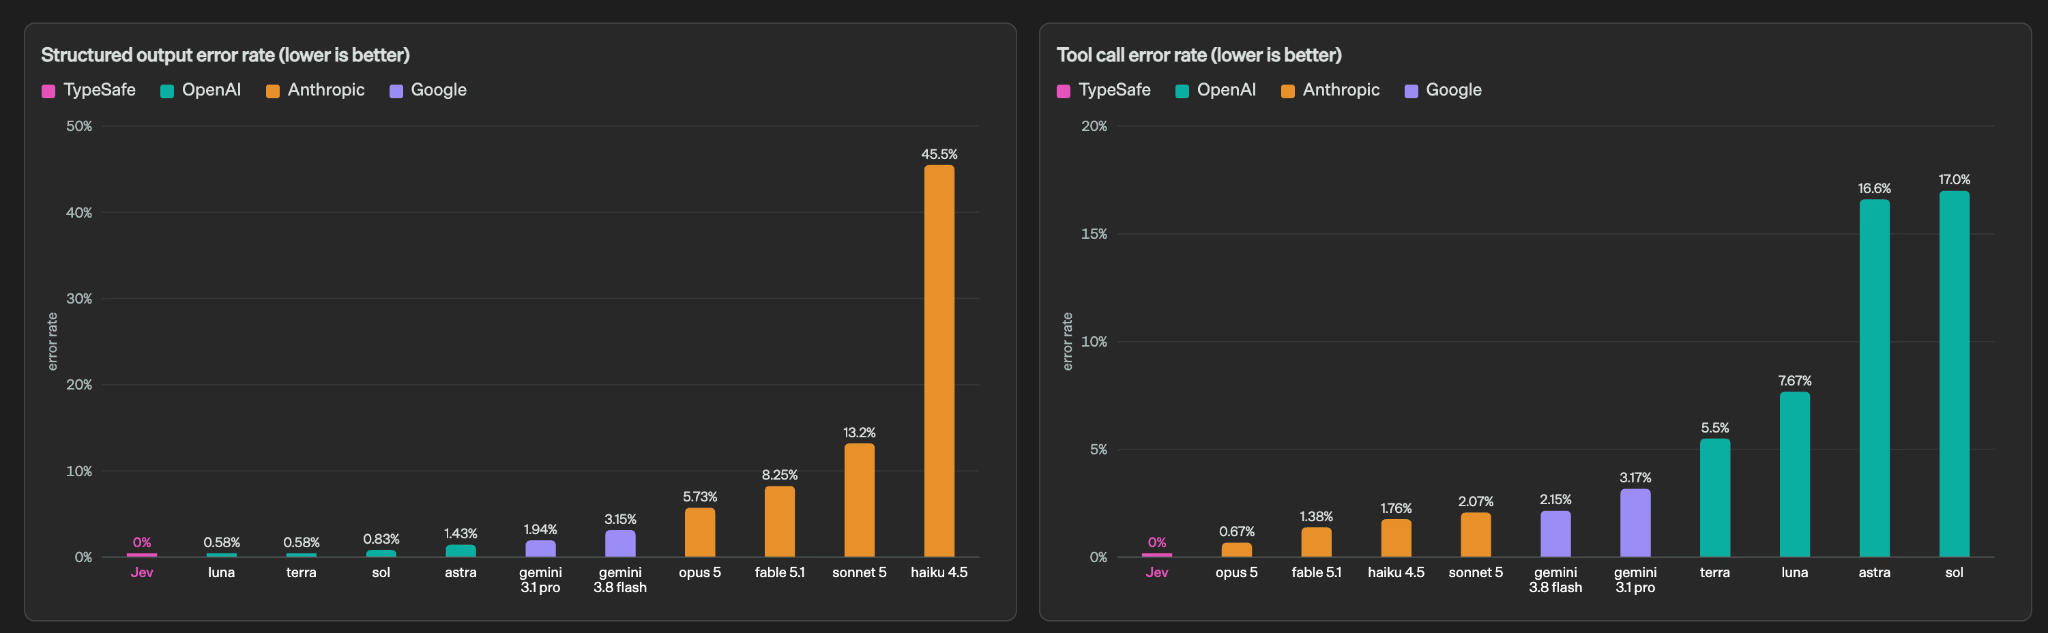
Quatro propriedades importam para a arquitetura. Cada resposta chega em um tipo que seu programa já entende. Cada resposta carrega sua própria incerteza, então “não tenho certeza” se torna uma ramificação em vez de uma surpresa. Muitas perguntas sobre um estado são resolvidas em uma única passagem. E a US$ 0,042 por milhão de tokens de entrada com tokens de saída não cobrados, você pode se dar ao luxo de perguntar em cada evento, em vez de em uma amostra.
Execute Jev como o juiz, não o escritor
Quatro papéis, claramente separados:
- O LLM gera. Código, um rascunho de e-mail, um resumo, um plano.
- Jev decide. Ele classifica a solicitação, pontua o risco, escolhe a rota e verifica a saída em relação aos critérios que você definiu antecipadamente.
- Seu código controla. Limiares e regras decidem se devem agir, tentar novamente, escalar ou parar.
- Um humano pega as pontas soltas. Baixa confiança mais altas apostas vai para uma pessoa.
Veja por que a divisão funciona. Um modelo de linguagem é flexível porque pode emitir qualquer coisa, e essa mesma liberdade é o que o torna difícil de embutir em um fluxo de trabalho do qual você depende. A estrutura da TypeSafe é que Jev “abandona a geração de strings” e ganha um contrato restrito em troca: o conjunto de respostas possíveis é fixado antes que a solicitação saia do seu servidor, cada resultado se encaixa na forma declarada e a incerteza é um número que você pode comparar com um limiar.
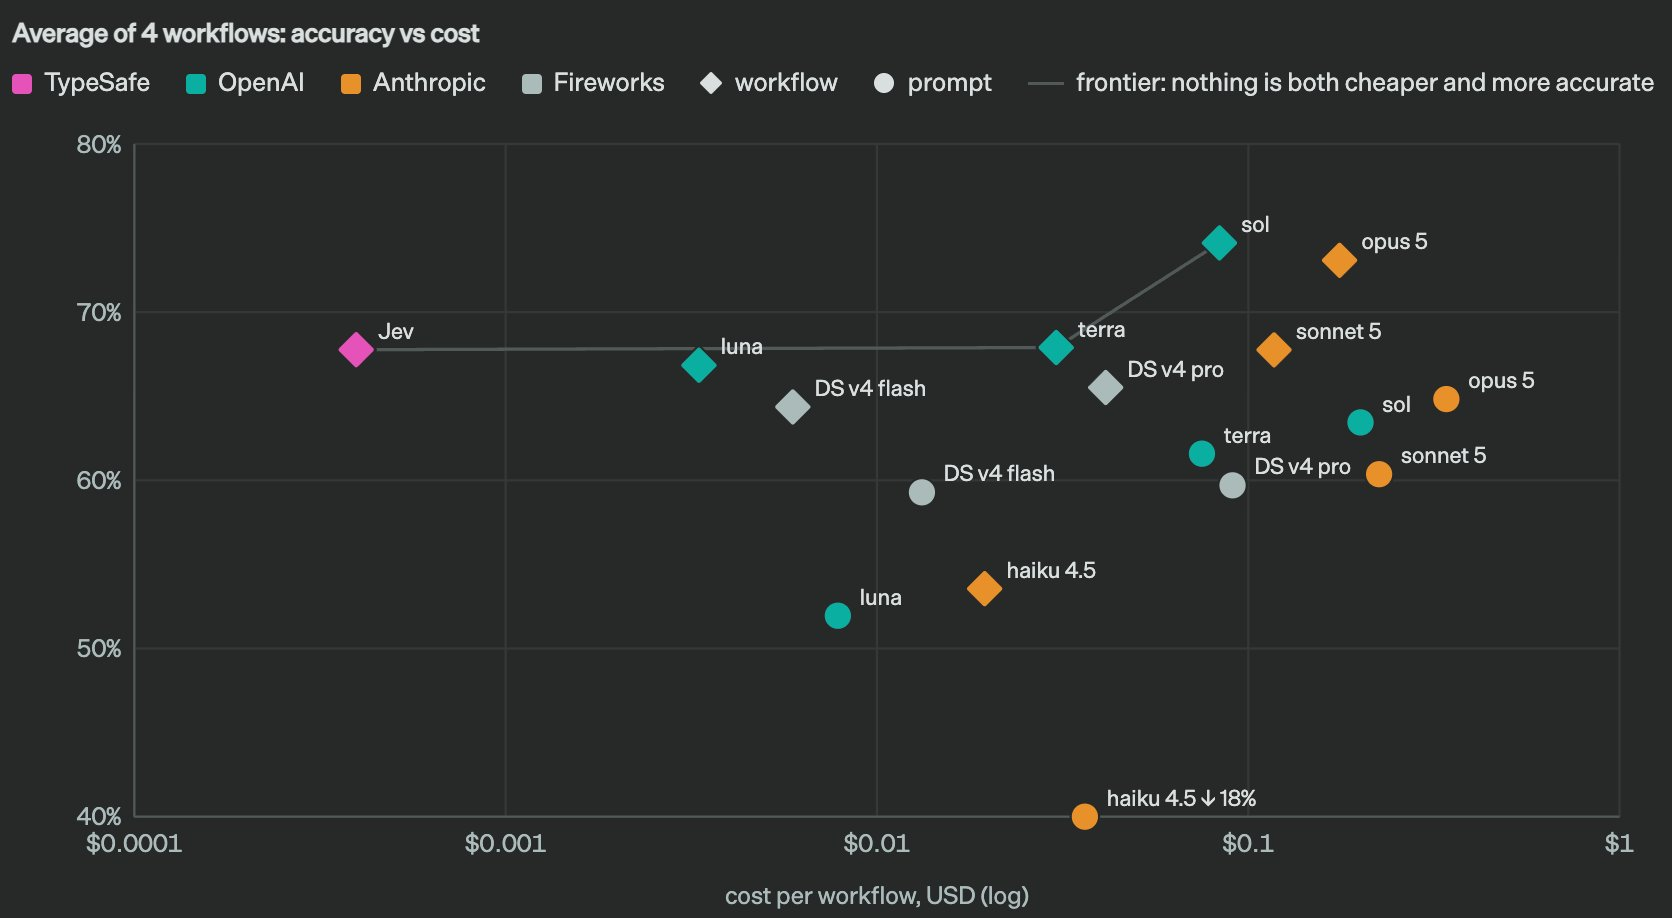
O lado do custo decorre da mesma troca. A TypeSafe relata tempos de resposta de ponta a ponta de 70ms a 500ms, e reivindica números de 193,6x mais rápido e 444,6x mais barato nos fluxos de trabalho que testou. Trate-os como números do fornecedor, não como benchmarks independentes. O ponto estrutural sobrevive de qualquer forma: o modelo caro só é executado quando algo realmente precisa ser escrito, e os julgamentos repetidos em torno dele são executados em algum lugar barato.
Projetando perguntas que Jev pode responder
Cada solicitação carrega um state compartilhado e um conjunto de perguntas independentes. Jev lê o estado uma vez e responde a todas elas. Uma chamada de triagem de suporte se parece com isto:
{
  "model": "jev-latest",
  "state": {
    "message": "I've been trying to connect Stripe for three days. I'm losing sales and I need this fixed today.",
    "plan": "Pro",
    "account_age_months": 14,
    "recent_technical_tickets": 3
  },
  "questions": {
    "department": {
      "type": "choice",
      "instruction": "Which team should own this ticket?",
      "criteria": {
        "billing": "Payments, charges, invoices, subscription changes",
        "technical": "Bugs, broken behavior, failing integrations",
        "sales": "Pricing, plans, questions asked before purchase"
      }
    },
    "frustration": {
      "type": "score",
      "instruction": "How frustrated is this customer?",
      "criteria": [
        "Calm and matter of fact",
        "Frustrated but civil",
        "Extremely frustrated or threatening to leave"
      ]
    },
    "urgent": {
      "type": "noul",
      "instruction": "The customer needs a resolution today."
    }
  }
}
Três hábitos separam perguntas que funcionam de perguntas que falham.
Pare de escrever prompts. Personas, exemplos práticos e longos preâmbulos guiam um gerador de texto. Jev não está gerando texto. Ele precisa do estado, de uma pergunta atômica e de uma descrição exata do que cada resposta significa. Critérios descritivos superam rótulos simples: "Pagamentos, cobranças, faturas, alterações de assinatura" direciona melhor do que a palavra "faturamento" por si só. Não peça para ele se explicar também, porque a resposta contém uma decisão, probabilidades e confiança, e nada mais.
Uma pergunta, um julgamento. “Este lead é valioso, urgente e propenso a comprar?” são três perguntas disfarçadas. Divida-as e combine os resultados no código, onde você pode ver os pesos e alterá-los.
Mantenha a aritmética fora do modelo. Jev julga o significado. Seu programa faz a matemática, aplica a tabela de descontos e verifica os termos do contrato. Essa divisão é o que torna tudo auditável.
A TypeSafe também fornece uma skill plug-and-play que ensina essas convenções a agentes de codificação, instalável no Claude Code com claude plugin marketplace add typesafe-ai/skills ou em outro lugar com npx skills add typesafe-ai/skills. A página da skill do agente tem os detalhes.
Mantenha o estado limpo
Estado relevante supera estado máximo. Três seções geralmente o cobrem: o objeto sendo julgado, o contexto necessário para ler esse objeto e os fatos que mudariam a decisão se mudassem. Todo o resto é ruído que você está pagando para enviar.
Remova linhas de log duplicadas, histórico anterior ao problema atual e qualquer frase que declare a conclusão que você espera que o modelo alcance. O limite máximo é de 64k tokens por solicitação, com 32k disponíveis para o estado mais a pergunta mais longa, mas a precisão pode mudar bem antes de você atingir esse limite. Quando o roteamento fica impreciso, diminuir o estado geralmente é uma correção mais rápida do que reescrever os critérios.
Perguntas paralelas e portões de confiança
Como Jev lê o estado uma vez, a décima terceira pergunta custa muito menos do que uma segunda viagem de ida e volta. Envie cada julgamento independente que possa alterar uma ação: intenção, risco, urgência, sentimento, relevância, próximo passo necessário. Em seguida, corte qualquer pergunta cuja resposta nunca mude o que seu código faz. Um sinal não utilizado é um custo de manutenção sem retorno.
Correlacione o primitivo com a forma do julgamento. Gradientes como severidade, qualidade e adequação pertencem a score, e não a um sim/não forçado. Uma única afirmação factual pertence a noul. Um conjunto fixo de destinos pertence a choice.
O portão é onde a arquitetura realmente reside. Uma resposta tipada ainda pode ser uma resposta errada, então a confiança decide o que acontece em seguida. Um padrão de partida viável: agir automaticamente acima de 0,85, passar de 0,55 a 0,85 para um modelo mais forte ou uma segunda passagem, e colocar na fila qualquer coisa abaixo de 0,55 para uma pessoa. Esses números exatos são ilustrativos. O padrão de roteamento por confiança da TypeSafe define um limiar separado por ação com base no custo de estar errado, e sua página de confiança diz para você “testar com seus próprios dados e ajustar à medida que observa os resultados”. Uma vez que seus limiares estejam ajustados, fixe o modelo: jev-latest segue a versão estável mais recente, enquanto jev-1.13.0 congela o comportamento que você mediu.
Teste a camada de decisão no Apidog
Uma camada de decisão só é digna de confiança se você puder provar como ela se comporta. Isso significa solicitações salvas e asserções, não um histórico de terminal de curls únicos. O Apidog oferece ambos, e as asserções parecem diferentes dos testes de API normais porque você está verificando números e valores enumerados em vez de strings.
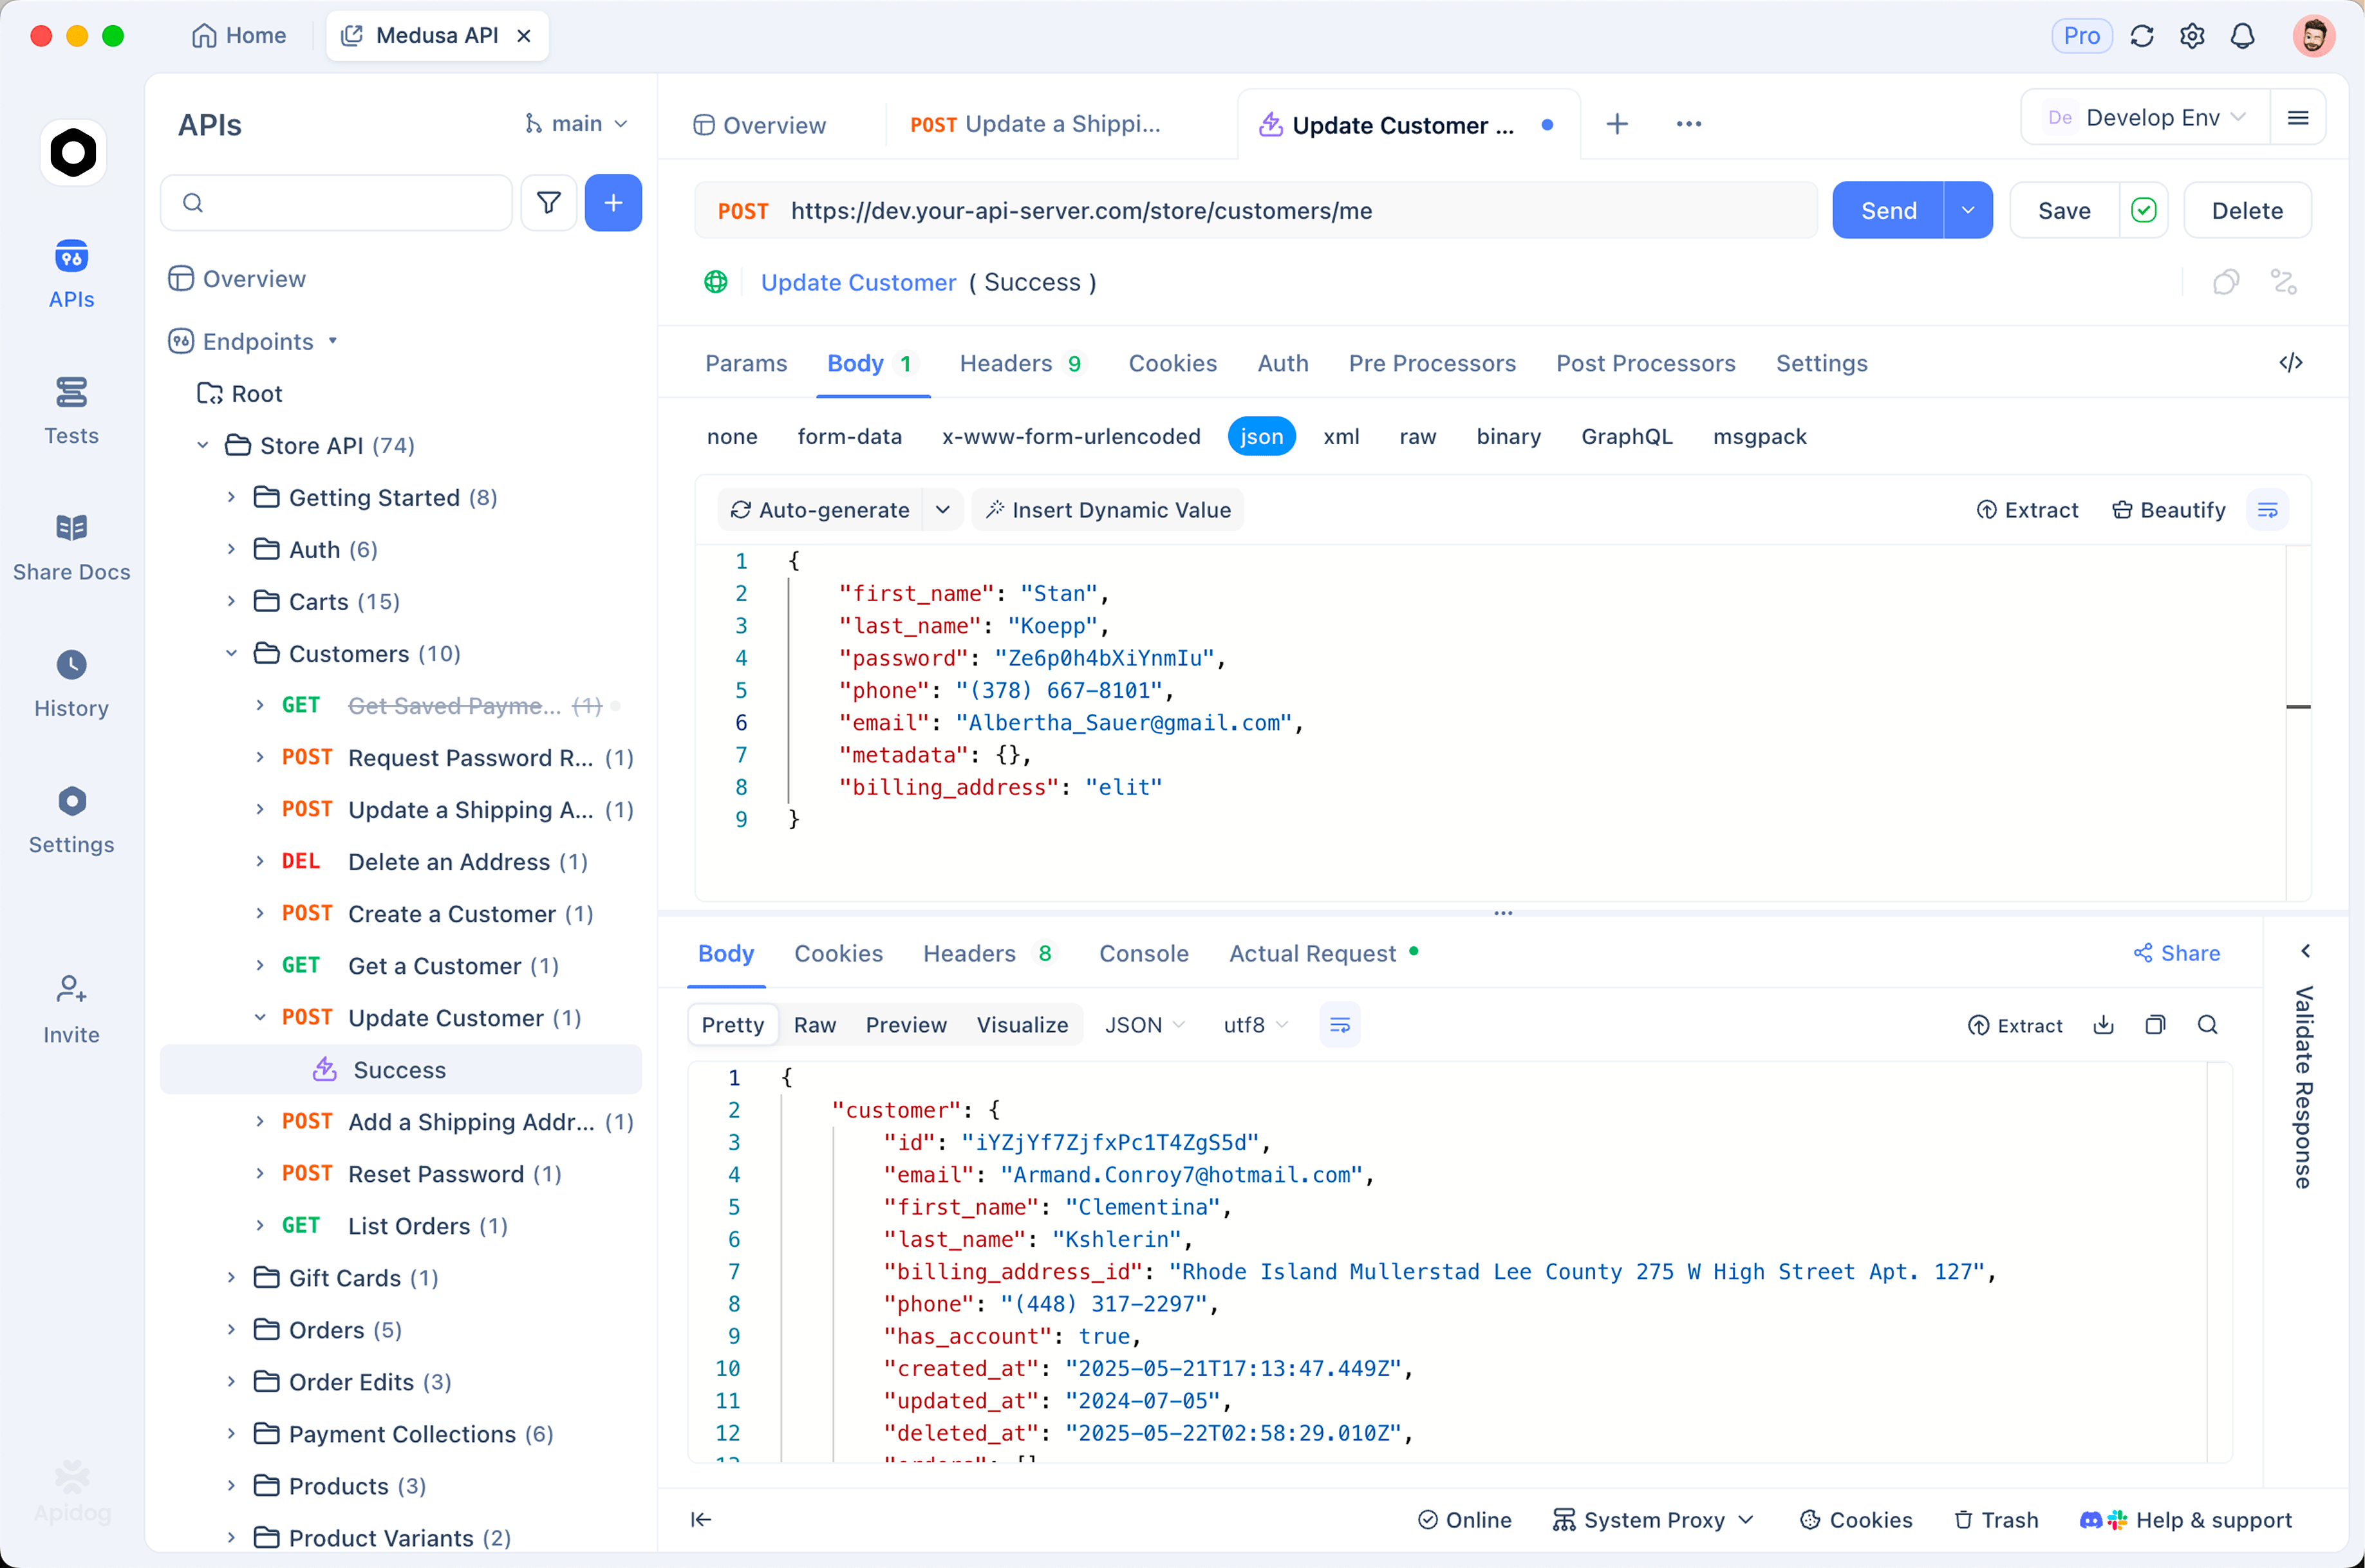
Armazene a chave como uma variável de ambiente. Crie um ambiente chamado TypeSafe, adicione TYPESAFE_API_KEY como um valor local para que permaneça em sua máquina e referencie-o como {{TYPESAFE_API_KEY}} em um token Bearer. Nosso guia sobre variáveis de ambiente e secretas cobre as regras de escopo.
Envie a chamada real. POST https://api.typesafe.ai/v1/systemone com o corpo de estado mais perguntas acima.
Faça asserções sobre a decisão. Adicione asserções de pós-processamento como answers.department.choice igual a billing, answers.urgent.noul maior que 0.9 e answers.frustration.score maior que 1.5. Agora, uma mudança de comportamento falha em um teste em vez de redirecionar incorretamente os tickets silenciosamente.
Então construa o cenário que importa. Salve um pequeno conjunto de estados rotulados como um cenário de teste: uma pergunta calma, uma ameaça de cancelamento furiosa e uma mensagem deliberadamente ambígua sobre a qual um bom roteador deveria hesitar. Afirme alta confiança nos dois primeiros e afirme que a confiança cai abaixo do seu portão no terceiro. Esse cenário único transforma o ajuste de limiares em evidência em vez de suposições, e captura a falha mais difícil de notar manualmente: alguém reformula uma descrição de critério, toda resposta ainda é validada, e o roteamento muda silenciosamente. Execute-o na CI e a reescrita falhará na compilação.
Simule a forma da resposta para que o trabalho de frontend não gaste tokens. Como o objeto answers é declarado antes da solicitação, o mock e a resposta ao vivo não podem se desviar. Baixe o Apidog para configurar isso; o plano gratuito cobre uma equipe de quatro.
Cinco fluxos de trabalho onde uma camada de decisão se paga
- O verificador universal. Envolva cada chamada de LLM cara. Verifique o prompt de entrada para injeção, a ferramenta selecionada para incompatibilidades óbvias, a saída para requisitos ausentes e a resposta final para afirmações que o material de origem não suporta. Verificações baratas em torno de um cérebro caro.
- A torre de controle de suporte. Classifique o ticket, detecte urgência, frustração, intenção de reembolso e risco de cancelamento em uma única chamada, depois roteie. O ganho é menos tickets na fila errada e menos contas valiosas paradas.
- Qualificação de leads. Pontue a adequação da empresa, maturidade técnica, dor declarada, intenção de compra e urgência como sinais separados, depois combine-os com pesos que você possui e pode defender em uma revisão de pipeline.
- O roteador de modelos. Decida por solicitação se um código determinístico, um modelo pequeno, um modelo de fronteira ou um humano deve lidar com isso. É aqui que as economias de custo geralmente aparecem primeiro.
- Trabalhos com grandes conjuntos de dados. Execute os mesmos julgamentos semânticos em logs de suporte, avaliações, listagens, transcrições ou rastros de agentes para extrair recursos estruturados e classificar os registros que valem a pena uma análise humana. Análise que só se torna prática quando cada decisão é rápida e quase gratuita.
Perguntas Frequentes
Ainda preciso de um modelo de linguagem? Sim. Jev não pode escrever a resposta, o resumo ou o código. Ele decide qual sistema deve, e pode avaliar o rascunho depois contra critérios explícitos, como conformidade com a política ou se a resposta contém uma promessa que você não faz.
Em que isso difere do modo JSON ou saídas estruturadas? Saídas estruturadas restringem a formatação de um modelo de texto; o modelo ainda está gerando tokens e ainda pode afirmar algo falso em uma forma válida. Jev retorna uma distribuição de probabilidade sobre um conjunto de respostas que você definiu, então a incerteza é um campo de primeira classe. Nosso explicador sobre saídas estruturadas da OpenAI cobre o outro lado dessa comparação.
Como consigo acesso? Jev está em acesso antecipado com uma lista de espera, então ainda não é self-service. A TypeSafe libera desenvolvedores da lista em lotes, e você faz login em console.typesafe.ai assim que for aprovado. Também está disponível através do Vercel AI Gateway como typesafe-ai/jev via experimental_evaluate no AI SDK 7, que é apenas SDK e não está exposto nos endpoints compatíveis com OpenAI. Nosso passo a passo sobre como obter uma chave API Jev contém os detalhes da solicitação e do SDK.
Posso rodar algo parecido localmente? Vários projetos reproduzem partes da ideia com decodificação restrita sobre pesos abertos. Comparamo-los em OpenJev e as alternativas open-source a Jev, incluindo o quão fiel cada um é à confiança calibrada.
Onde isso te deixa
Jev não é o modelo que substitui seus outros modelos. É a camada que decide quando, onde e se eles serão executados. Construa-o dessa forma: um estado limpo, perguntas atômicas com critérios explícitos, avaliação paralela e um portão de confiança na frente de cada ação. Depois, prove que o portão funciona com um cenário salvo no Apidog antes que ele roteie um único ticket real.