
Antigamente, agentes de voz precisavam de três componentes: reconhecimento de fala (speech-to-text), um modelo de linguagem e, em seguida, síntese de fala (text-to-speech). Cada etapa adicionava latência e perdia o tom. A API Realtime da OpenAI condensa isso em um único modelo de fala-para-fala (speech-to-speech), e gpt-realtime-2.1-mini é a camada mais barata e rápida dessa família. Ele ouve o áudio, pensa e responde por meio de uma única conexão de streaming.
Este guia mostra como chamá-lo de ponta a ponta: qual ID de modelo usar, como conectar via WebSocket e WebRTC, como moldar uma sessão e como testar tudo com o Apidog antes de integrá-lo a um aplicativo. Tudo aqui corresponde ao guia oficial do OpenAI Realtime.
Primeiro, acerte o nome do modelo
A nomenclatura confunde as pessoas, então vamos esclarecer antes de qualquer código. Existem dois identificadores para o mesmo modelo mini:
gpt-realtime-2.1-mini: o ID versionado. É o que aparece na página de preços da OpenAI e te fixa na geração 2.1.gpt-realtime-mini: o apelido da família. Ele sempre aponta para o snapshot mais recente, atualmentegpt-realtime-mini-2025-12-15.
Snapshots permitem que você bloqueie o comportamento em produção:
| Identificador | Para o que aponta |
|---|---|
gpt-realtime-mini |
Snapshot mini mais recente (atualizações automáticas) |
gpt-realtime-2.1-mini |
O mini da geração 2.1 |
gpt-realtime-mini-2025-12-15 |
Snapshot fixado (atual) |
gpt-realtime-mini-2025-10-06 |
Snapshot fixado (anterior) |
Use o apelido enquanto você desenvolve, então fixe um snapshot datado antes de lançar para que uma atualização de modelo nunca mude o comportamento do seu agente da noite para o dia.
O que o gpt-realtime-2.1-mini faz
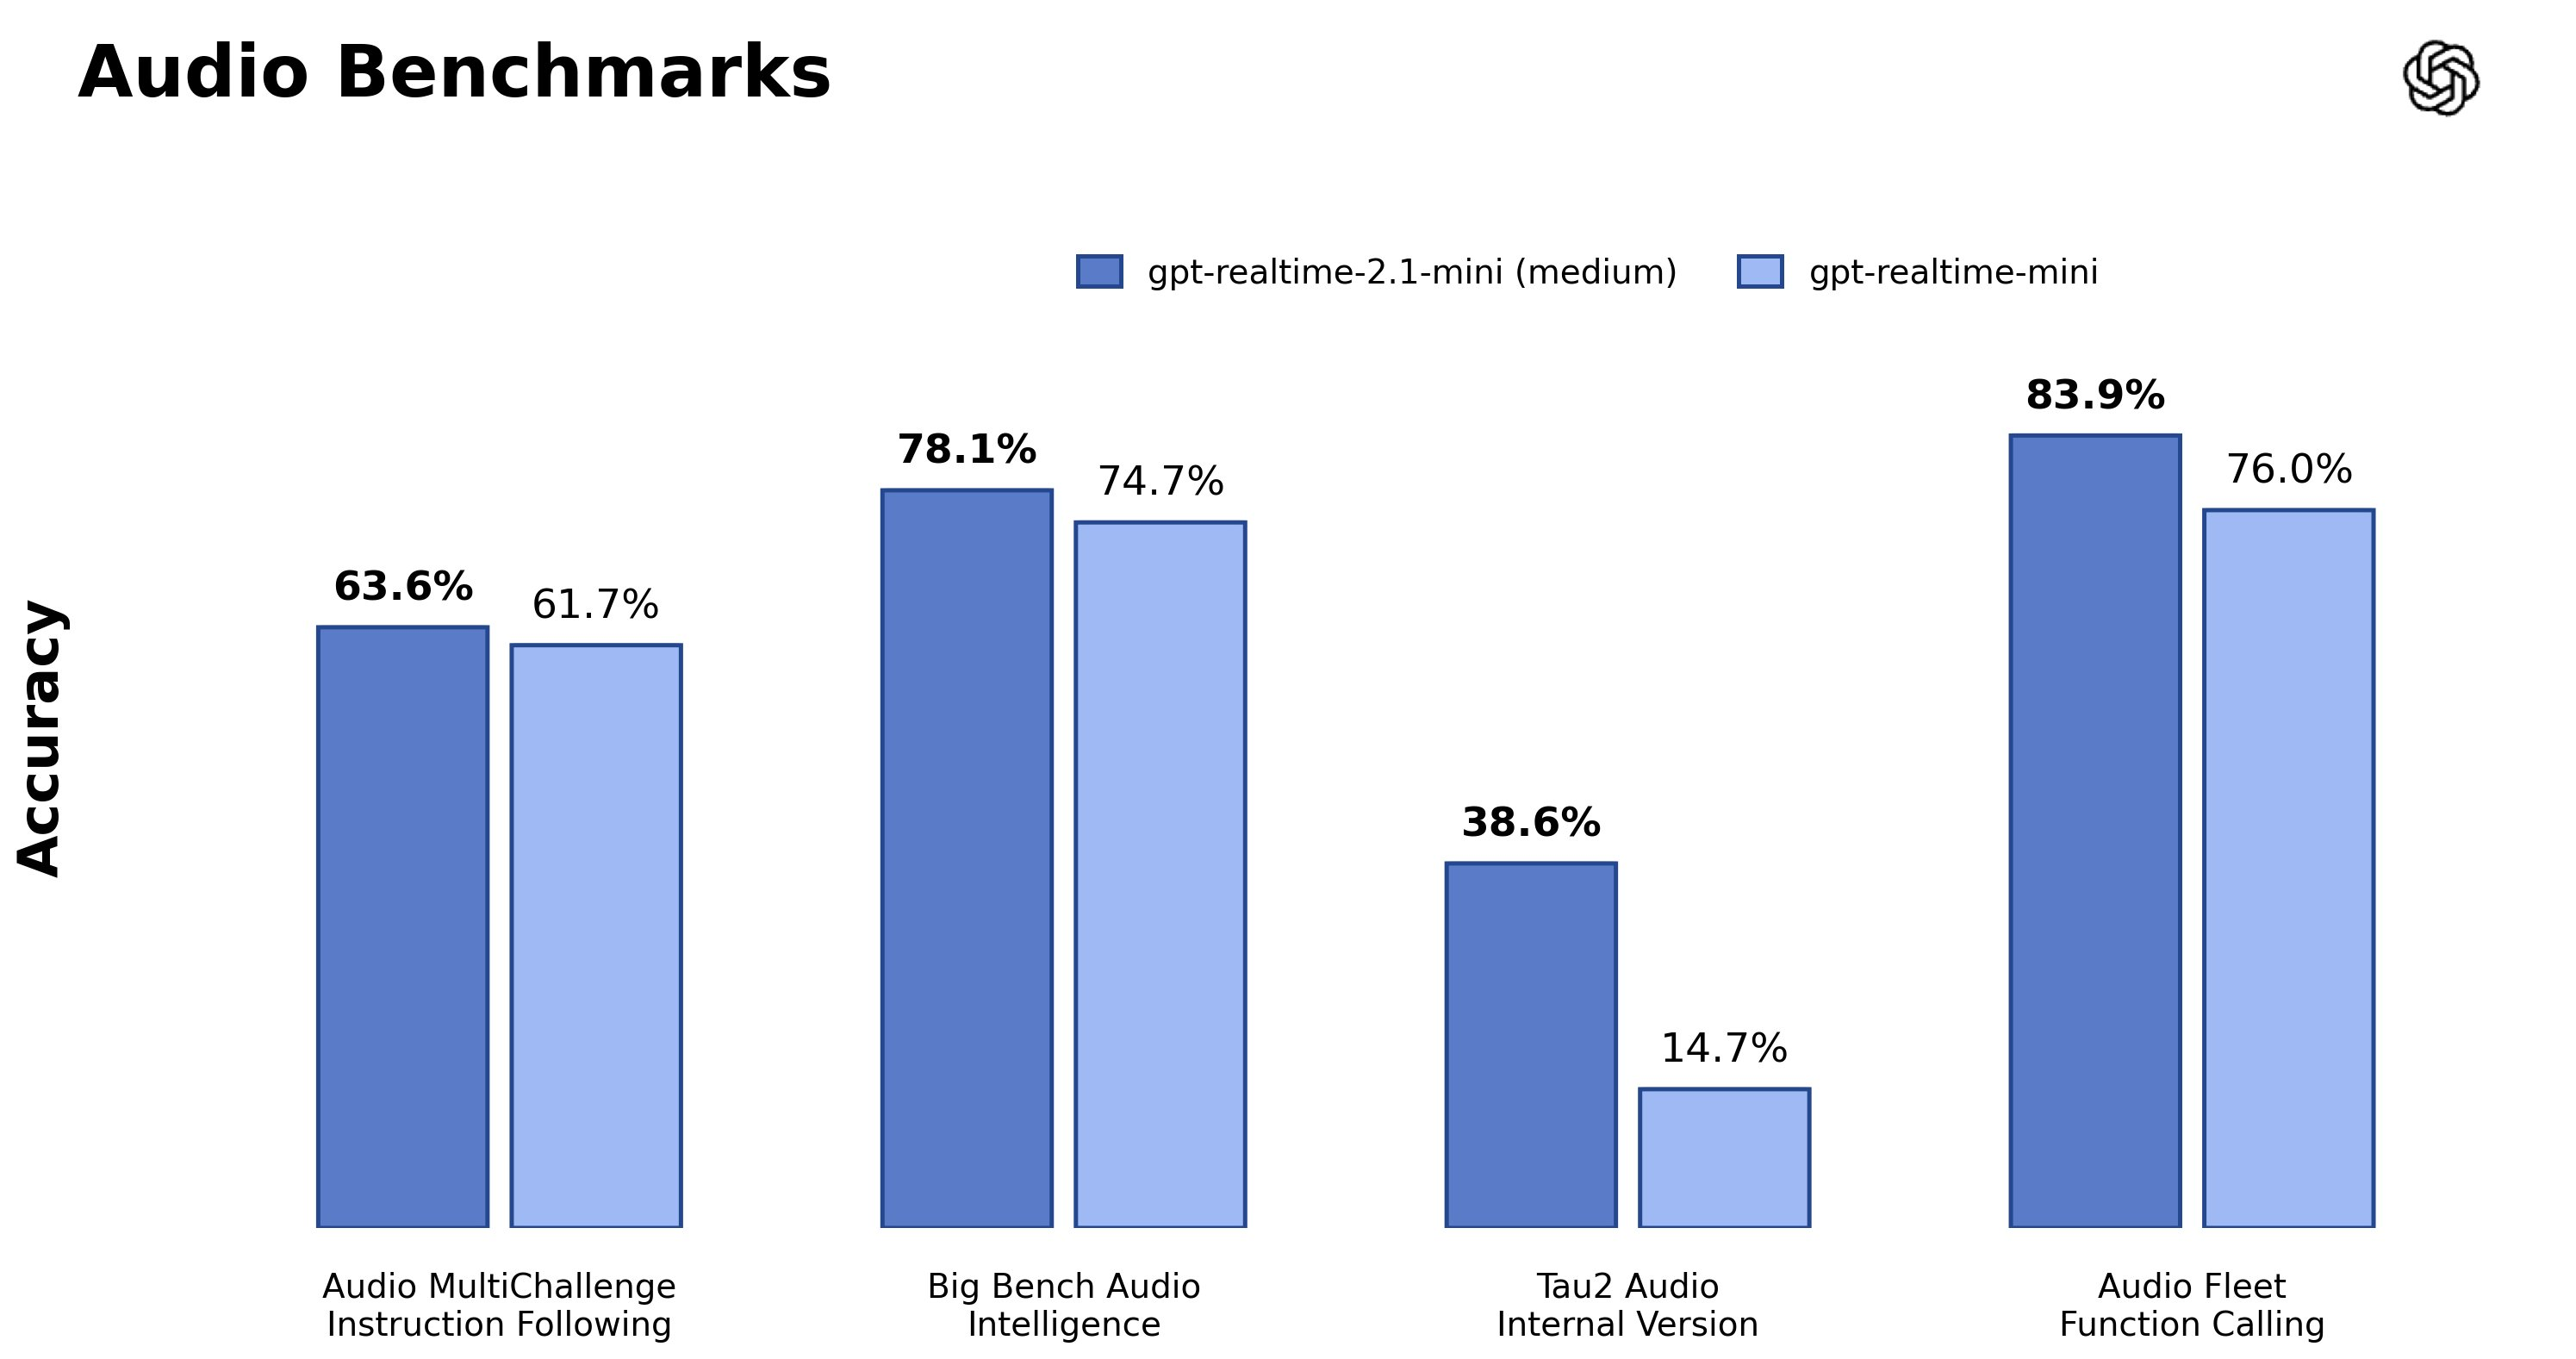
É um modelo de fala-para-fala (speech-to-speech). Você transmite áudio de entrada e ele transmite áudio de volta com entonação natural, sem uma etapa separada de transcrição ou TTS. Ele também lida com texto, então você pode misturar entrada digitada e saída falada na mesma sessão.
Aqui está a folha de especificações da página do modelo:
| Propriedade | Valor |
|---|---|
| Modalidades de entrada | Texto, imagem, áudio |
| Modalidades de saída | Texto, áudio |
| Janela de contexto | 32.000 tokens |
| Saída máxima | 4.096 tokens |
| Conexões | WebRTC, WebSocket, SIP |
| Vozes | alloy, ash, ballad, coral, echo, sage, shimmer, verse, marin, cedar |
marin e cedar são as vozes mais recentes e exclusivas da API Realtime; a OpenAI as recomenda para a saída mais natural. As vozes mais antigas ainda funcionam se você quiser um timbre específico.
A camada "mini" troca um pouco de profundidade de raciocínio por menor latência e uma conta muito mais baixa. Para a maioria dos bots de suporte, fluxos de recebimento de pedidos e front-ends de voz, é o padrão certo. Opte pelo gpt-realtime-2.1 completo apenas quando a conversa exigir um raciocínio mais pesado.
Quanto custa
O mini custa aproximadamente um terço do preço do modelo completo. Taxas de token da página de preços:
| Modelo | Entrada de texto | Entrada em cache | Entrada de áudio | Saída de áudio |
|---|---|---|---|---|
gpt-realtime-2.1-mini |
$0,60 / 1M | $0,30 / 1M | $10 / 1M | $20 / 1M |
gpt-realtime-2.1 (completo) |
$4,00 / 1M | $0,40 / 1M | $32 / 1M | $64 / 1M |
O áudio domina a conta, e o maior fator de custo é o quanto seu agente fala. Um agente que fala 35 segundos por minuto custa aproximadamente o dobro de um que fala 15 segundos por minuto. Os custos reais por minuto para o mini ficam em torno de $0,06 a $0,15, dependendo da verbosidade, então instrua seu modelo a ser conciso e você cortará a conta diretamente. As taxas mudam, então confirme na página de preços ao vivo antes de fazer previsões.
Pré-requisitos
- Uma chave de API da OpenAI com acesso Realtime, definida como
OPENAI_API_KEY. - Node.js 18+ para os exemplos de servidor (o pacote
wspara WebSocket puro, ou o SDK oficialopenai). - Para áudio no navegador, uma página servida via HTTPS ou
localhostpara quegetUserMediafuncione.
Uma regra antes de tocar no navegador: nunca envie sua chave de API real para o cliente. Aplicativos de navegador e móveis usam tokens efêmeros de curta duração. Mais sobre isso abaixo.
Escolha um método de conexão
O modelo mini utiliza três transportes. Escolha com base em onde seu áudio reside.
| Transporte | Use quando | Autenticação |
|---|---|---|
| WebRTC | Áudio é capturado ou reproduzido em um navegador ou aplicativo móvel | Segredo de cliente efêmero |
| WebSocket | Seu servidor já lida com áudio bruto de um pipeline de mídia | Chave de API (lado do servidor) |
| SIP | Você está conectando um telefone ou sistema de telefonia | Chave de API |
A maioria das pessoas começa com WebSocket para prototipar no lado do servidor, depois migra para WebRTC para o cliente real. Vamos fazer os dois.
Início Rápido 1: WebSocket do seu servidor
WebSocket é a maneira mais rápida de ver o modelo responder. O endpoint é uma única URL com o modelo na string de consulta:
wss://api.openai.com/v1/realtime?model=gpt-realtime-2.1-mini
Como esta é a interface GA (General Availability), você autentica com um cabeçalho simples Authorization: Bearer e não precisa mais do antigo cabeçalho OpenAI-Beta. Aqui está um "hello world" de texto de entrada e texto de saída para que você possa testar sem um microfone:
import WebSocket from "ws";

const url = "wss://api.openai.com/v1/realtime?model=gpt-realtime-2.1-mini";
const ws = new WebSocket(url, {
  headers: { Authorization: `Bearer ${process.env.OPENAI_API_KEY}` },
});

ws.on("open", () => {
  // 1. Configurar a sessão
  ws.send(JSON.stringify({
    type: "session.update",
    session: {
      type: "realtime",
      model: "gpt-realtime-2.1-mini",
      output_modalities: ["text"],
      instructions: "Você é um agente de suporte de API conciso. Mantenha as respostas curtas.",
    },
  }));

  // 2. Adicionar uma mensagem do usuário
  ws.send(JSON.stringify({
    type: "conversation.item.create",
    item: {
      type: "message",
      role: "user",
      content: [{ type: "input_text", text: "O que é uma requisição idempotente?" }],
    },
  }));

  // 3. Pedir uma resposta
  ws.send(JSON.stringify({ type: "response.create" }));
});

ws.on("message", (raw) => {
  const event = JSON.parse(raw.toString());
  if (event.type === "response.output_text.delta") process.stdout.write(event.delta);
  if (event.type === "response.done") ws.close();
});
O fluxo é sempre o mesmo: configurar, adicionar entrada, solicitar uma resposta, ouvir por deltas. Os eventos do servidor são transmitidos como JSON. Os que mais te interessam:
session.created/session.updated: sua configuração foi aceitaresponse.output_text.delta: um pedaço de textoresponse.output_audio.delta: um pedaço de áudio base64response.output_audio_transcript.delta: a transcrição do que o modelo está dizendoresponse.done: o turno terminou
Para ir do texto para a voz, mude output_modalities para ["audio"] e adicione uma configuração de áudio (próxima seção). O áudio chega em eventos response.output_audio.delta como blocos PCM base64 que você decodifica e reproduz.
Início Rápido 2: WebRTC no navegador
Para um aplicativo de voz real, o navegador captura o microfone e reproduz a resposta diretamente, o que mantém a latência baixa. O problema é a autenticação: você não pode expor sua chave de API, então seu servidor primeiro gera um token de curta duração.
Passo 1: gere um token efêmero no seu servidor. Chame o endpoint de segredos do cliente com sua chave real:
// lado do servidor
const r = await fetch("https://api.openai.com/v1/realtime/client_secrets", {
  method: "POST",
  headers: {
    Authorization: `Bearer ${process.env.OPENAI_API_KEY}`,
    "Content-Type": "application/json",
  },
  body: JSON.stringify({
    session: { type: "realtime", model: "gpt-realtime-2.1-mini" },
  }),
});
const { value } = await r.json(); // chave efêmera, começa com "ek_"
Envie value para o navegador. Ele expira rapidamente, então um vazamento tem baixo risco.
Passo 2: conecte-se do navegador com WebRTC. Você captura o microfone, abre um canal de dados para eventos e troca SDP com o endpoint /v1/realtime/calls:
// lado do navegador: `EPHEMERAL_KEY` veio do seu servidor
const pc = new RTCPeerConnection();

// reproduzir o áudio do modelo
pc.ontrack = (e) => (document.getElementById("audio").srcObject = e.streams[0]);

// enviar o microfone
const mic = await navigator.mediaDevices.getUserMedia({ audio: true });
pc.addTrack(mic.getTracks()[0]);

// eventos fluem por um canal de dados
const channel = pc.createDataChannel("oai-events");
channel.onmessage = (e) => console.log(JSON.parse(e.data));

// handshake SDP
const offer = await pc.createOffer();
await pc.setLocalDescription(offer);

const sdpResp = await fetch(
  "https://api.openai.com/v1/realtime/calls?model=gpt-realtime-2.1-mini",
  {
    method: "POST",
    body: offer.sdp,
    headers: {
      Authorization: `Bearer ${EPHEMERAL_KEY}`,
      "Content-Type": "application/sdp",
    },
  }
);
await pc.setRemoteDescription({ type: "answer", sdp: await sdpResp.text() });
Uma vez que a conexão está ativa, o modelo ouve na trilha do microfone e fala através de pc.ontrack. Você envia configurações e texto pelo mesmo canal de dados oai-events usando os mesmos eventos JSON do exemplo de WebSocket.
Moldando a sessão
O objeto session é onde você controla o comportamento. Esta é a versão de áudio completo do que você viu acima:
{
  type: "session.update",
  session: {
    type: "realtime",
    model: "gpt-realtime-2.1-mini",
    output_modalities: ["audio"],
    instructions: "Você é um assistente de reservas amigável. Confirme os detalhes antes de agir.",
    audio: {
      input: {
        format: { type: "audio/pcm", rate: 24000 },
        turn_detection: { type: "semantic_vad" },
      },
      output: {
        format: { type: "audio/pcm", rate: 24000 },
        voice: "marin",
      },
    },
  },
}
Os campos que importam:
instructions: seu prompt de sistema. Defina a persona, os limites e "seja breve" se você se preocupa com o custo.output_modalities:["audio"]para um agente falante,["text"]para um bot apenas de transcrição.audio.output.voice: escolha entre as dez vozes;marinoucedarsoam as mais naturais.audio.input.turn_detection: como o modelo decide que você parou de falar.semantic_vadespera por uma pausa natural no significado;server_vadé acionado pelo silêncio. A detecção semântica interrompe menos e parece mais suave na conversação.
Mude qualquer campo durante a chamada enviando outro session.update. Você não precisa reconectar.
Adicionando ferramentas para que o agente possa agir
Um agente de voz que só consegue conversar é uma demonstração. Para reservar uma mesa ou verificar um pedido, o modelo precisa de ferramentas. O Realtime usa o mesmo contrato de chamada de função do restante da plataforma: você declara funções na sessão, o modelo emite uma chamada, você a executa e alimenta o resultado de volta. Se você já integrou ferramentas à API de chat antes, este é o mesmo modelo mental; nosso guia sobre chamadas de função da OpenAI cobre o esquema em profundidade, e saídas estruturadas ajudam quando você precisa que os argumentos correspondam a uma forma estrita.
Declare as ferramentas dentro da sessão, então trate o evento response.function_call_arguments.done, execute seu código e poste um conversation.item.create com o resultado antes do próximo response.create. Para qualquer coisa mais elaborada do que algumas funções, o AgentKit da OpenAI oferece uma maneira de alto nível para orquestrar agentes de voz multi-etapas.
Teste os endpoints com Apidog antes de construir
Você não vai querer depurar uma chamada REST e um handshake WebSocket lendo logs do console em um aplicativo meio construído. Teste as peças isoladamente primeiro. É aqui que o Apidog ganha seu lugar em um fluxo de trabalho em tempo real.
- O endpoint de token.
POST https://api.openai.com/v1/realtime/client_secretsé uma chamada REST comum. Crie uma requisição no Apidog, adicione seu cabeçalhoAuthorization: Bearer, insira o corpo JSON com o ID do seu modelo e envie. Você verá o tokenek_e sua expiração imediatamente, sabendo que sua chave e acesso à conta estão corretos antes mesmo de o WebRTC entrar em cena. É a mesma abordagem que você usaria para testar rapidamente qualquer uma das superfícies REST da OpenAI, como a API de Respostas. - O fluxo de mensagens WebSocket. O Apidog possui um cliente WebSocket, então você pode abrir uma conexão para
wss://api.openai.com/v1/realtime?model=gpt-realtime-2.1-mini, adicionar o cabeçalho de autenticação e enviar manualmente as mensagenssession.update,conversation.item.createeresponse.createuma por uma. Observar os eventos do servidor retornarem em um painel legível torna a sequência de eventos óbvia, e você pode salvar as mensagens como exemplos para sua equipe. Se você já utiliza estratégias sólidas de teste de API, isso se encaixa perfeitamente.
Testar a camada de transporte por si só significa que, quando algo quebrar no aplicativo, você já saberá que não é o contrato da API. Baixe o Apidog se quiser acompanhar.
Mantenha a conta sob controle
A saída de áudio é a parte mais cara, então alguns hábitos valem a pena:
- Diga ao modelo para ser breve. "Mantenha as respostas em uma ou duas frases" nas instruções reduz diretamente os tokens de saída de áudio.
- Fixe um snapshot em produção.
gpt-realtime-mini-2025-12-15não irá mudar; o apelidogpt-realtime-minipode. - Use
semantic_vad. Menos interrupções falsas significam menos meias-respostas desperdiçadas pelas quais você paga. - Armazene em cache seu prompt de sistema. A entrada em cache custa $0,30 por 1M versus $0,60 para entrada de texto nova, então um bloco de instruções estável é mais barato a cada turno.
- Feche sessões ociosas. Uma conexão aberta com um usuário inativo ainda é uma sessão pela qual você pode ser cobrado.
Erros comuns e soluções
- 401 Não Autorizado: a chave está errada, ou você enviou um token efêmero expirado. Chaves efêmeras são de curta duração por design; gere uma nova a cada sessão.
- Modelo não encontrado: verifique o ID exato. É
gpt-realtime-2.1-mini, nãogpt-realtime-mini-2.1. - Sem áudio no navegador: você provavelmente não anexou o stream remoto em
pc.ontrack, ou a página não está em HTTPS/localhost, então o microfone nunca abriu. - O modelo não para de falar sobre o usuário: mude
turn_detectionparasemantic_vade confirme se a trilha do microfone está chegando à conexão. - Enviando o cabeçalho beta: o endpoint GA não precisa de
OpenAI-Beta: realtime=v1. Remova-o.
Perguntas Frequentes
gpt-realtime-2.1-minié o mesmo quegpt-realtime-mini? Efetivamente sim.gpt-realtime-2.1-minié o ID versionado,gpt-realtime-minié o apelido que aponta para o snapshot mais recente (gpt-realtime-mini-2025-12-15). Use o apelido para desenvolver, fixe o snapshot para lançar.- Posso usá-lo para transcrição simples em vez de um agente de voz? A API Realtime é construída para fala-para-fala interativa. Para transcrição única, os modelos de transcrição dedicados da OpenAI são mais adequados. Use o modelo mini realtime quando precisar de uma conversa bidirecional com baixa latência.
- Preciso de WebRTC, ou WebSocket é suficiente? WebSocket é suficiente para pipelines server-side e protótipos rápidos. Use WebRTC quando um navegador ou aplicativo móvel captura e reproduz áudio diretamente, pois ele lida com o fluxo de mídia e o jitter para você.
- Qual voz devo escolher?
marinecedarsão as mais novas e naturais, e são exclusivas da API Realtime. As outras oito (alloy, ash, ballad, coral, echo, sage, shimmer, verse) ainda funcionam se você quiser um som específico. - Como isso é cobrado? Por token, dividido por modalidade. Para o mini: $0,60 por 1M de entrada de texto, $10 por 1M de entrada de áudio e $20 por 1M de saída de áudio. A saída de áudio é o custo dominante, então a verbosidade é seu principal controle.
- Ele pode chamar funções como os modelos de chat? Sim. O Realtime usa o mesmo contrato de chamada de função, então um agente de voz pode consultar pedidos, verificar estoque ou acionar ações durante a conversa.
Próximos passos
Agora você tem o ciclo completo: o ID de modelo correto, um protótipo WebSocket, um cliente de navegador WebRTC, configuração de sessão, ferramentas e uma maneira de testar cada peça no Apidog antes de ir para produção. Comece com o exemplo de WebSocket somente texto para confirmar o acesso, mude output_modalities para áudio e então passe para WebRTC quando estiver pronto para um microfone real. Fixe um snapshot, diga ao modelo para ser conciso, e você terá um agente de voz de baixa latência que não te surpreenderá na fatura.