
Para usar o Firecrawl Local, instale-o com cargo install firecrawl-local, execute firecrawl-local init para registrá-lo como um servidor MCP no Claude Code e no Cursor e, em seguida, reinicie as duas ferramentas. Seu agente agora pode fazer scrape, crawl e map de sites na sua própria máquina. Para código, execute firecrawl-local serve e aponte qualquer SDK do Firecrawl para http://localhost:3002.
Este guia mostra como usar o Firecrawl Local passo a passo, com a saída real da nossa execução de teste em 19 de novembro de 2026 (Firecrawl Local 0.1.0 em um Mac arm64), além dos prompts para dar ao seu agente e uma forma de deixar esse agente testar a API local com o Apidog CLI.
O que você precisa antes de começar
O Firecrawl Local é um único binário Rust do repositório do Firecrawl. Antes de instalá-lo, verifique se você tem:
- Rust e um compilador C. Obtenha o Rust em rustup.rs. No macOS, execute
xcode-select --install; no Debian ou Ubuntu, instalebuild-essential. - Node.js 22 ou mais recente se você quiser o servidor MCP. Ele executa o pacote npm
firecrawl-mcpatravés donpx. - Chrome ou Chromium (opcional). O Firecrawl Local usa o navegador que você já tem para páginas que precisam de JavaScript. Páginas estáticas funcionam sem ele.
- Claude Code, Cursor ou outro cliente MCP. O
inittambém reconhece Claude Desktop, Windsurf, Gemini CLI e Codex.
Se você é novo no próprio Firecrawl, comece com nosso guia de web scraping do Firecrawl e depois volte.
Passo 1: Instale o Firecrawl Local
Instale o crate do crates.io e confirme a versão:
cargo install firecrawl-local
firecrawl-local --version
# firecrawl-local 0.1.0
O Cargo o compila a partir do código-fonte. No nosso Mac, o build de release terminou em 6 minutos e 54 segundos, e o binário ficou em ~/.cargo/bin/firecrawl-local. Certifique-se de que essa pasta está no seu PATH, ou anote o caminho completo: você precisará dele para a configuração manual do MCP.
Passo 2: Execute seu primeiro scrape pelo terminal
Antes de conectar qualquer coisa a um agente, verifique se a busca funciona:
FIRECRAWL_CLOUD=off firecrawl-local scrape https://example.com --markdown
Ele imprimiu o texto principal da página em markdown em 1,2 segundo. Remova --markdown e você recebe o mesmo JSON que a API do Firecrawl retorna. --format markdown,links escolhe os formatos; as opções locais são markdown, html, rawHtml e links.
Em seguida, um crawl que grava um arquivo markdown por página:
FIRECRAWL_CLOUD=off firecrawl-local crawl https://docs.firecrawl.dev --limit 20 --out ./pages
Isso buscou 20 páginas da documentação do Firecrawl em 4,4 segundos e salvou arquivos com nomes como 0005-docs.firecrawl.dev_advanced-scraping-guide.md. Flags úteis do crawl, obtidas com firecrawl-local crawl --help:
| Flag | O que faz |
|---|---|
-l, --limit |
Máximo de páginas (padrão 100) |
--max-depth |
Quantos links de profundidade seguir |
--include, --exclude |
Regex de caminho para manter ou ignorar, repetível |
--entire-domain |
Segue links fora do caminho inicial |
-c, --concurrency |
Páginas buscadas ao mesmo tempo |
--ignore-robots |
Ignora robots.txt (que é lido por padrão) |
firecrawl-local map https://firecrawl.dev retorna todas as URLs que encontra nos sitemaps e na página inicial, em uma única linha JSON.
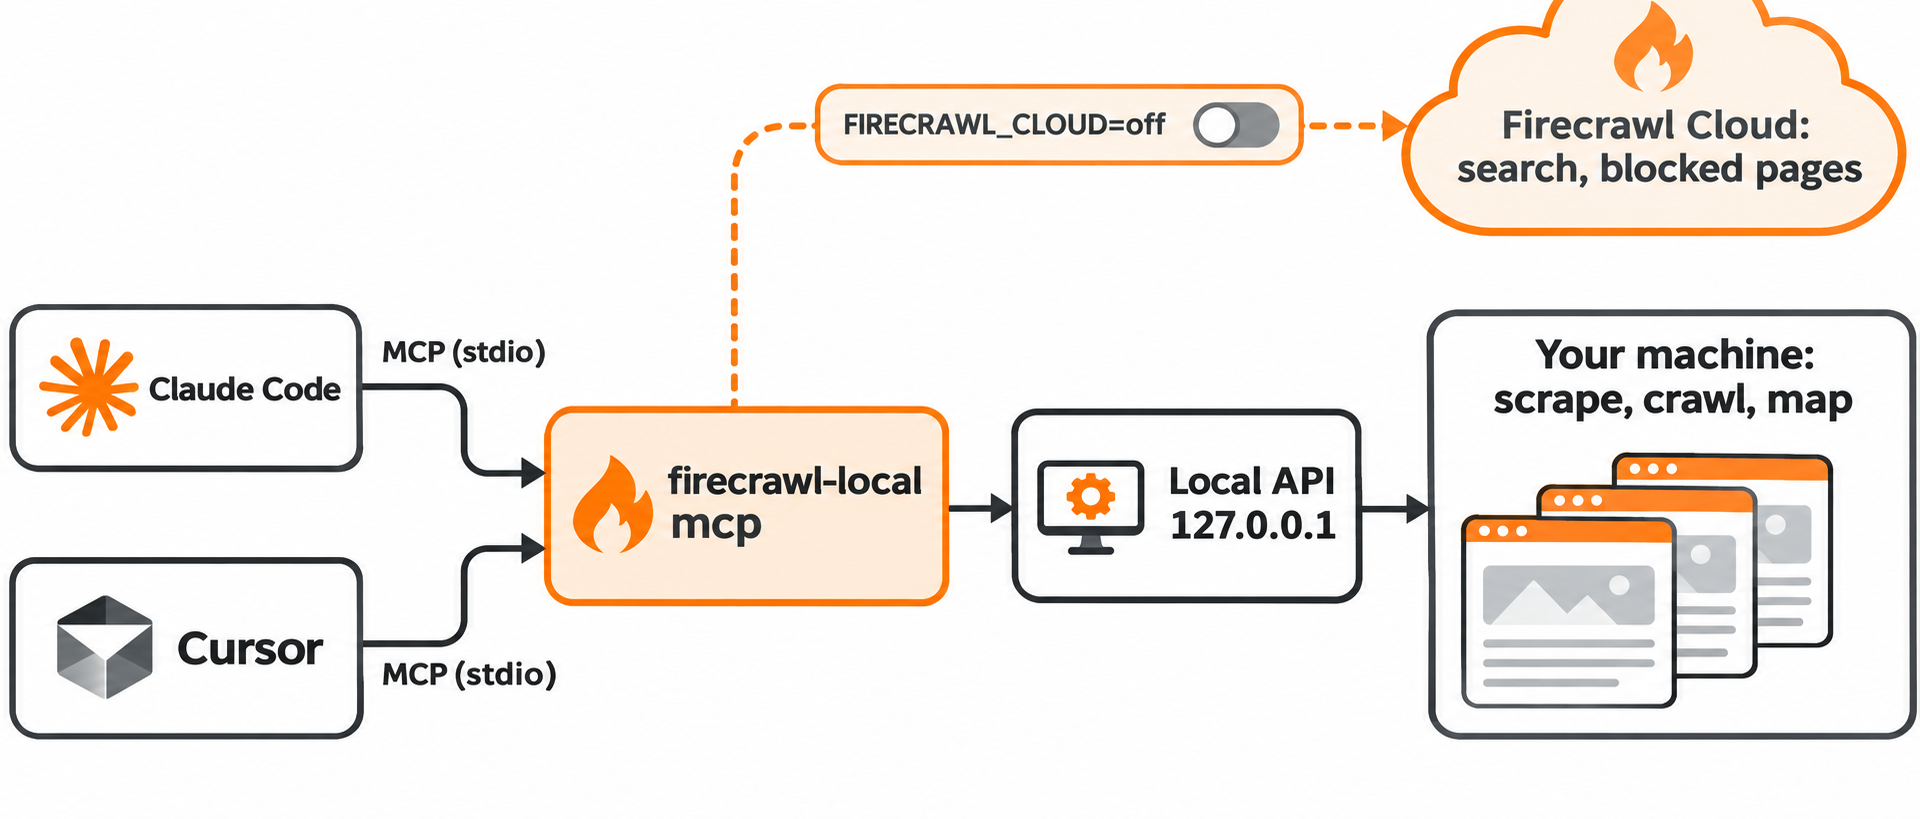
Passo 3: Adicione o Firecrawl Local ao Claude Code e ao Cursor com o init
O init encontra as ferramentas de IA na sua máquina e adiciona o Firecrawl Local à configuração MCP de cada uma. Visualize primeiro:
firecrawl-local init --dry-run
No nosso Mac, ele listou todas as ferramentas que modificaria:
Firecrawl MCP server:
  Claude Code: would be added in ~/.claude.json
  Claude desktop: would be added in ~/Library/Application Support/Claude/claude_desktop_config.json
  Cursor: would be added in ~/.cursor/mcp.json
  Gemini CLI: would be added in ~/.gemini/settings.json
  Codex: would be added in ~/.codex/config.toml
O dry run também imprime o que vai para o Firecrawl Cloud: consultas de busca, a URL de uma página que bloqueou sua máquina, chamadas ao Alexandria depois que você faz login, e um ID de instalação aleatório mais o nome da sua ferramenta de IA. Páginas que carregam bem localmente nunca são enviadas.
Para configurar apenas as duas ferramentas que este guia cobre, repita --agent:
firecrawl-local init --agent claude-code --agent cursor
Os nomes válidos são claude-code, claude-desktop, cursor, windsurf, gemini e codex. O init faz backup de cada arquivo de configuração antes de escrever. Reinicie o Claude Code e o Cursor depois, para que carreguem o novo servidor.
Firecrawl Local no Claude Code manualmente
Se você preferir não deixar uma ferramenta editar suas configurações, adicione o servidor stdio você mesmo com o comando MCP do Claude Code:
claude mcp add firecrawl -e FIRECRAWL_CLOUD=off -- ~/.cargo/bin/firecrawl-local mcp --public-only
Execute /mcp dentro do Claude Code para confirmar que o servidor está conectado.
Firecrawl Local no Cursor manualmente
O Cursor lê os servidores MCP de ~/.cursor/mcp.json (global) ou .cursor/mcp.json (um projeto). Use o caminho completo para o binário:
{
  "mcpServers": {
    "firecrawl": {
      "command": "/Users/you/.cargo/bin/firecrawl-local",
      "args": ["mcp", "--public-only"],
      "env": { "FIRECRAWL_CLOUD": "off" }
    }
  }
}
--public-only faz o servidor recusar localhost e endereços de rede privada. Mantenha isso ativado quando seu agente lê páginas em que você não confia: instruções ocultas em uma página poderiam, de outra forma, direcionar o agente para uma URL interna.
Passo 4: Prompts para dar ao seu agente
firecrawl-local mcp inicia a API local em uma porta loopback e executa o pacote firecrawl-mcp contra ela. Seu agente vê as ferramentas MCP padrão do Firecrawl; scrape, crawl, map e batch scrape rodam na sua máquina. Se você já usou o servidor MCP hospedado do Firecrawl, os nomes das ferramentas são os mesmos.
Prompts que se encaixam bem nas ferramentas locais:
Map https://docs.example.com, then crawl only the /api/ pages (limit 40)
and write a summary of every endpoint into docs/vendor-api.md.
Scrape the changelog at https://example.com/changelog as markdown and list
every breaking change from the last three releases.
Batch scrape these five pricing pages and build a comparison table of
plan names and limits. Quote only what the pages say.
Evite prompts que precisam de busca: com FIRECRAWL_CLOUD=off, essa ferramenta não faz nada. Para uma configuração de busca totalmente local, veja nosso guia de busca na web open-source para o Claude.
Passo 5: Execute a API do Firecrawl Local e aponte seu SDK para ela
Para scripts e pipelines, execute o servidor de API:
FIRECRAWL_CLOUD=off firecrawl-local serve
Ele escuta em 127.0.0.1:3002. O health check responde imediatamente:
curl -s localhost:3002/health
# {"status":"ok","engine":"firecrawl-local","version":"0.1.0"}
Um scrape retorna o formato v2 familiar, com dois marcadores locais: "engine": "local-fetch" e "source": "local", além de creditsUsed: 0.
curl -s localhost:3002/v2/scrape -H 'content-type: application/json' \
  -d '{"url":"https://example.com","formats":["markdown","links"]}'
Aponte os SDKs do Firecrawl para ela sem chave de API. Python:
from firecrawl import Firecrawl

app = Firecrawl(api_url="http://localhost:3002")
print(app.scrape("https://example.com").markdown)
Node:
import { Firecrawl } from "firecrawl";

const app = new Firecrawl({ apiUrl: "http://localhost:3002" });
const doc = await app.scrape("https://example.com");
console.log(doc.markdown);
O init também sugere um atalho: defina FIRECRAWL_API_URL=http://127.0.0.1:3002 e seu código Firecrawl existente roda localmente. O Firecrawl CLI compartilha o login salvo com o Firecrawl Local, então o login de qualquer uma das ferramentas funciona para ambas.
Os crawls são assíncronos. POST /v2/crawl retornou um ID de job imediatamente, e GET /v2/crawl/{id} reportou status: completed, total: 10, creditsUsed: 0 e expiresInSeconds: 3587 alguns segundos depois. Os jobs ficam em memória, expiram uma hora após o início e desaparecem quando serve para, então salve os resultados assim que um crawl terminar.
O processo do servidor ficou em cerca de 10 MB de memória residente ocioso e 43 MB logo após aquele crawl de 10 páginas, medido com ps. O post de lançamento do Firecrawl afirma ser 37x mais rápido e usar 230x menos memória do que o Firecrawl auto-hospedado; o README não publica a metodologia, então trate esses números como sendo do Firecrawl.
Mantenha o Firecrawl Local totalmente local com FIRECRAWL_CLOUD
Por padrão (auto), três coisas vão para o Firecrawl Cloud: busca, páginas que bloqueiam sua máquina e provedores de dados do Alexandria (que exigem uma conta gratuita via firecrawl-local login). FIRECRAWL_CLOUD controla essa transferência:
| Valor | Efeito |
|---|---|
auto (padrão) |
Busca, fallback de páginas bloqueadas e Alexandria funcionam |
search |
Apenas a busca vai para o Firecrawl Cloud |
off |
Nada vai para o Firecrawl Cloud |
Um valor não reconhecido conta como off. Com a nuvem desligada, POST /v2/search responde "code":"CLOUD_ONLY" com uma mensagem dizendo para você definir FIRECRAWL_API_KEY ou FIRECRAWL_CLOUD=auto. Uma página que a nuvem buscou para você traz "source": "firecrawl-cloud", então você sempre pode saber de onde um resultado veio.
serve recusa localhost e alvos privados a menos que você passe --allow-private, e vincular um --host não-loopback requer --token. Metadados de nuvem e endereços link-local são bloqueados em todos os modos.
Deixe seu agente de código testar a API do Firecrawl Local com o Apidog CLI
O endpoint de crawl é o mais provável de quebrar um pipeline: é assíncrono, o job expira e um servidor parado o perde. Em vez de fazer polling manualmente, deixe seu agente de código criar e executar um teste com o Apidog CLI.
Configure uma vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Depois, dê ao Claude Code ou ao Cursor um prompt:
firecrawl-local serve is running on http://localhost:3002. In Apidog project <id>,
import an OpenAPI file for POST /v2/scrape, POST /v2/crawl and GET /v2/crawl/{id},
create an environment for that base URL, and build a test scenario that starts a
crawl of https://docs.firecrawl.dev with limit 10, saves the returned id, polls
GET /v2/crawl/{id} until status is "completed", and asserts total equals completed
and every page has non-empty markdown. Run it and summarize any failures.
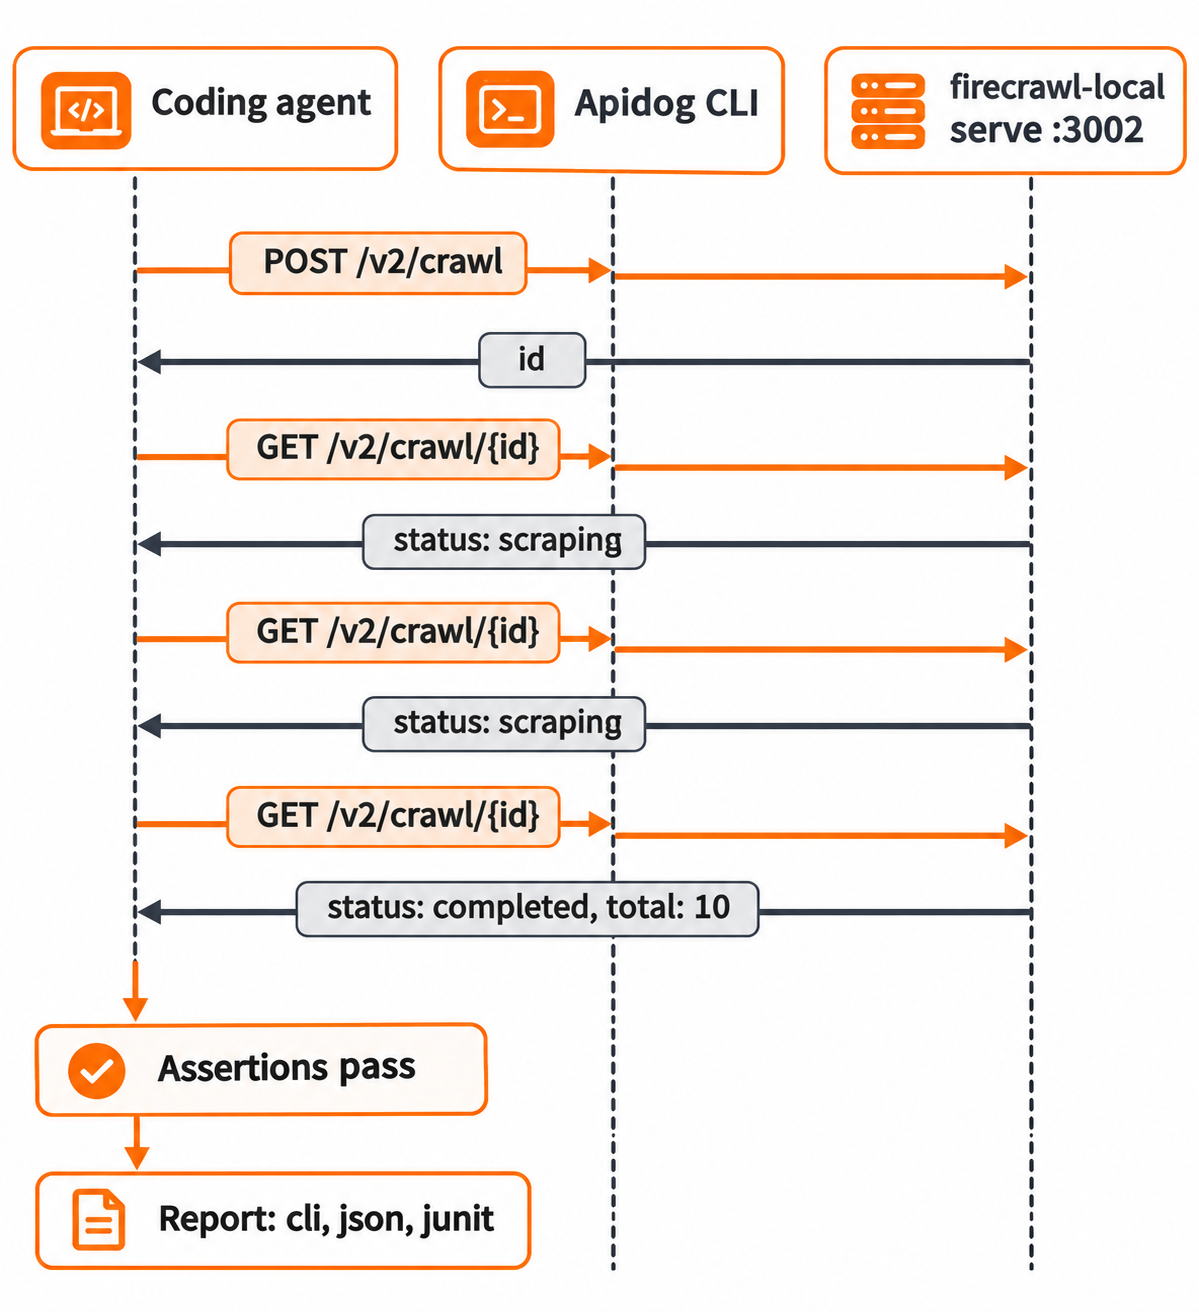
O agente lê cada schema de payload, valida e executa comandos como estes, todos obtidos de apidog <cmd> --help no CLI 2.2.12:
apidog import --project <id> --format openapi --file ./firecrawl-local-v2.yaml
apidog environment create firecrawl-local --project <id> --base-url http://localhost:3002
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <id> --file ./scenario.json
apidog run -t <scenarioId> --project <id> -e <envId> -r cli,json
O Apidog CLI envia requisições da sua máquina, então localhost:3002 é acessível. Troque para -r junit para colocar a mesma execução no CI; nossos guias Apidog CLI no Claude Code e Apidog CLI no Cursor cobrem o lado do agente. O plano Free do Apidog cobre equipes de até 4 usuários.
Solução de problemas do Firecrawl Local
| Sintoma | Correção |
|---|---|
404 com NOT_FOUND em /v1/scrape |
Apenas v2 é servido; mude seu cliente para /v2/... |
CLOUD_ONLY em /v2/search |
Esperado com FIRECRAWL_CLOUD=off; use auto ou search |
| O agente não lista as ferramentas do Firecrawl | Reinicie a ferramenta após o init; verifique o Node.js 22+ |
| Página JavaScript retorna com pouco conteúdo | Instale o Chrome ou defina --browser always |
Formato json ou summary ausente |
Não é suportado localmente; você recebe um aviso em vez disso |
| ID de crawl não encontrado | O job expirou após uma hora ou o serve reiniciou |
FAQ
O Firecrawl Local é gratuito? Scrape, crawl e map locais não enviam nada ao Firecrawl e usaram 0 créditos nos nossos testes. O código é AGPL-3.0; os SDKs são MIT. Busca e Alexandria passam pelo Firecrawl Cloud.
Preciso de uma chave de API para usar o Firecrawl Local? Não, não para as rotas locais. Você só precisa de uma chave, via firecrawl-local login ou FIRECRAWL_API_KEY, para os provedores de dados do Alexandria.
O Firecrawl Local funciona com o Windsurf, o Codex e o Gemini CLI? Sim. O init reconhece windsurf, codex e gemini, além de Claude Code, Claude Desktop e Cursor.
Meu código Firecrawl existente pode rodar nele sem alterações? Para scrape, map, crawl e batch scrape v2, sim: altere a URL da API para http://localhost:3002. Rotas v0 e v1 não são servidas, e actions do navegador são ignoradas.
O Firecrawl Local respeita o robots.txt? Sim. Ele lê o robots.txt ao fazer crawl e se identifica no seu User-Agent, então os donos de sites podem tratá-lo como FirecrawlLocal. --ignore-robots desativa isso; use apenas em sites que você possui.