
DeepSeek V4 Pro saiu da versão prévia em 12 de agosto de 2026. A versão GA (disponibilidade geral), com carimbo 0813, agora serve o endpoint da API deepseek-v4-pro e vem com números que parecem erros de digitação: uma janela de contexto de 1 milhão de tokens, 384 mil tokens de saída máxima e preços de entrada que caem para $0,003625 por milhão de tokens em acertos de cache. Conforme relatado pela Unite.AI, o modelo que passou quatro meses em prévia é agora o carro-chefe da DeepSeek.
A cobertura de lançamento informa o que foi lançado, não como chamá-lo. Este guia abrange a parte prática: a primeira solicitação com o SDK do OpenAI, modos de pensamento e o campo reasoning_content, streaming, chamadas de ferramentas e os cálculos de cache de prompt que decidem se o contexto de 1 milhão de tokens é acessível ou prejudicial. Se você quiser a história da arquitetura primeiro, leia O que é DeepSeek V4 e volte.
TL;DR
- DeepSeek-V4-Pro-0813 é o snapshot GA por trás do endpoint
deepseek-v4-proa partir de 12 de agosto de 2026, a versão a ser utilizada em produção. - A API é compatível com OpenAI: aponte o SDK
openaiparahttps://api.deepseek.com, definamodel="deepseek-v4-pro", pronto. O formato Anthropic Messages e a própria API Responses da DeepSeek também funcionam. - Contexto de 1 milhão de tokens, saída máxima de 384 mil tokens, três modos de pensamento (
non-think,think high,think max) que retornam um camporeasoning_contentjunto com a resposta. - Preços: Entrada de $0.435/M (cache miss), Entrada de $0.003625/M (cache hit, 120x mais barato), Saída de $0.87/M. O cache é automático para prefixos de prompt repetidos.
- A DeepSeek alertou em 6 de agosto que um aumento "significativo" no preço da API está a caminho. Ainda sem valores ou data, então orce com margem.
- Teste o endpoint, inspecione o stream SSE e mantenha ambientes pro/flash lado a lado no Apidog antes de integrá-lo a algo real.
O que a versão GA 0813 muda para desenvolvedores
A prévia foi lançada em abril de 2026, o irmão menor V4 Flash foi lançado em julho, e em 12 de agosto o modelo Pro passou para a disponibilidade geral como versão 0813, seguindo a convenção usual de carimbo de data da DeepSeek (da mesma forma que v3-0324 marcou um snapshot V3).
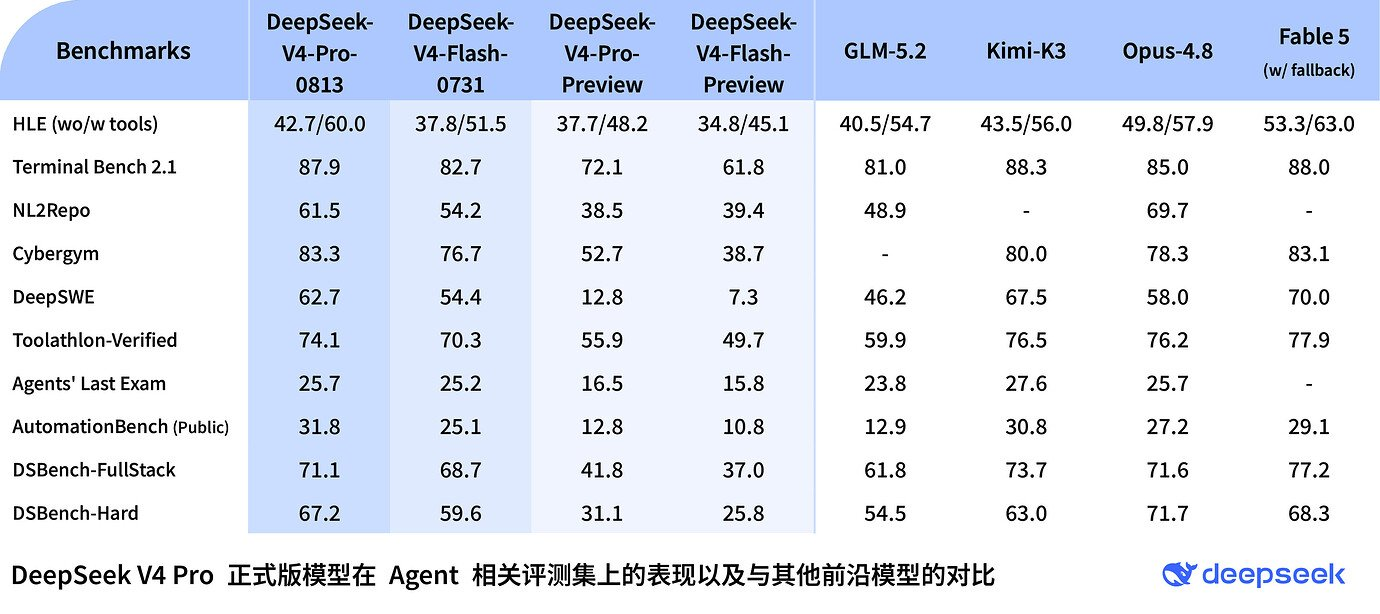
Três coisas mudam com o GA:
- O snapshot é estável. Modelos em prévia podem mudar sem aviso, o que invalida silenciosamente avaliações e ajustes de prompt. A versão 0813 é um alvo fixo até que a DeepSeek anuncie um novo snapshot.
- O endpoint é o alias de produção. Na API oficial você chama
deepseek-v4-proe obtém a versão 0813; para fixar o snapshot explicitamente, o OpenRouter o lista comodeepseek/deepseek-v4-pro-0813. - A superfície completa de recursos está ativa. Modos de pensamento, chamada de função, saídas estruturadas, cache de prompt e a API de múltiplos formatos (OpenAI, Anthropic, Responses) estão todos ativos no endpoint GA.
Por baixo do capô, o V4 Pro é um modelo de mistura de especialistas com 1.6T de parâmetros totais e 49 bilhões ativos por token. A principal história de engenharia é a eficiência: dois esquemas de atenção, Compressed Sparse Attention e Heavily Compressed Attention, reduzem o cálculo de inferência de token único para 27% do V3.2 e o cache KV para 10%. Essa redução do cache KV é o que torna um contexto de 1 milhão de tokens utilizável a esses preços, em vez de um recurso de demonstração.
DeepSeek V4 Pro 0813: especificações em resumo
| Especificação | DeepSeek V4 Pro 0813 |
|---|---|
| Lançamento | GA em 12 de agosto de 2026 (snapshot 0813) |
| Arquitetura | Mistura de especialistas, 1.6T parâmetros totais, 49B ativos por token |
| Atenção | Compressed Sparse Attention + Heavily Compressed Attention |
| Custo de inferência vs V3.2 | 27% do computo de token único, 10% do cache KV |
| Janela de contexto | 1.000.000 tokens |
| Saída máxima | 384 mil tokens |
| Modos de pensamento | non-think, think high, think max |
| Preço de entrada | $0.435/M tokens (cache miss), $0.003625/M (cache hit) |
| Preço de saída | $0.87/M tokens |
| Formatos de API | OpenAI Chat Completions, Anthropic Messages, DeepSeek Responses |
| ID do Modelo | deepseek-v4-pro |
| Irmão menor | deepseek-v4-flash (284B total / 13B ativo), $0.14/M entrada, $0.28/M saída |
Em termos de capacidade, o próprio cartão de modelo da DeepSeek lista SWE-bench Verified em 80.6%, Terminal Bench 2.0 em 67.9%, GPQA Diamond em 90.1% e LiveCodeBench em 93.5% para V4-Pro-Max, a configuração de pensamento máximo. Esses são números auto-relatados pelo fornecedor que nenhuma terceira parte verificou ainda, então execute suas próprias avaliações específicas da tarefa antes de migrar qualquer coisa importante.
Obtenha uma chave de API e faça sua primeira solicitação
A configuração leva cerca de cinco minutos:
- Crie uma conta na plataforma DeepSeek (platform.deepseek.com) e adicione crédito, a API é pré-paga.
- Abra Chaves de API, gere uma chave e copie-a imediatamente (é exibida apenas uma vez).
- Exporte-a como uma variável de ambiente em vez de colá-la no código:
export DEEPSEEK_API_KEY="sk-..."
A API segue o protocolo OpenAI Chat Completions, então o pacote padrão openai é o cliente. Tanto https://api.deepseek.com quanto https://api.deepseek.com/v1 funcionam como URLs base; o /v1 é para compatibilidade de protocolo, não uma versão do modelo.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-v4-pro",
    messages=[
        {"role": "system", "content": "You are a concise technical assistant."},
        {"role": "user", "content": "Explain idempotency in REST APIs in two sentences."},
    ],
)

print(response.choices[0].message.content)
print(response.usage)
Imprima response.usage desde o primeiro dia. Com um modelo tão barato em acertos de cache e tão caro em falhas de cache de 1 milhão de tokens, a contagem de tokens é a diferença entre um erro de arredondamento e uma conta real.
A mesma solicitação via HTTP bruto, útil para testes de fumaça e para importação em ferramentas de API:
curl https://api.deepseek.com/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $DEEPSEEK_API_KEY" \
  -d '{
    "model": "deepseek-v4-pro",
    "messages": [
      {"role": "user", "content": "List three ways to version a REST API."}
    ]
  }'
A referência completa de parâmetros está disponível nos documentos oficiais da DeepSeek, incluindo o endpoint compatível com Anthropic (utilizável a partir do SDK Anthropic e Claude Code sem reescrever nada) e a própria API Responses da DeepSeek.
Trabalhando com os três modos de pensamento
O V4 Pro expõe o raciocínio como um seletor, em vez de um modelo separado. Um endpoint, três modos:
- non-think: o modelo responde diretamente. Mais rápido e barato, ideal para extração, classificação, formatação e resumos.
- think high: o modelo raciocina antes de responder e retorna esse raciocínio em um campo
reasoning_content. O padrão para codificação, depuração e análise multi-etapas. - think max: orçamento máximo de raciocínio, a configuração por trás dos números de benchmark V4-Pro-Max. Guarde-o para problemas realmente difíceis.
Os modos são mapeados para o parâmetro padrão reasoning_effort, então nenhuma configuração específica do fornecedor é necessária:
response = client.chat.completions.create(
    model="deepseek-v4-pro",
    reasoning_effort="high", # "none" | "high" | "max"
    messages=[
        {"role": "user", "content": "Our API returns 502s under load but only behind the CDN. Walk through likely causes in order of probability."},
    ],
)

message = response.choices[0].message
print("--- Reasoning ---")
print(message.reasoning_content)
print("--- Answer ---")
print(message.content)
Duas notas práticas. Primeiro, nunca alimente reasoning_content de volta no histórico da conversa; envie apenas o content das voltas anteriores. Segundo, os tokens de raciocínio são cobrados como tokens de saída a $0.87/M, então o "think max" custa dinheiro real e latência real. Correlacione o modo à tarefa em vez de usar o máximo por padrão.
Respostas em streaming
Com saída máxima de 384 mil tokens e modos de pensamento que podem raciocinar longamente, solicitações não-streaming proporcionam uma má experiência de usuário. Defina stream=True e manipule ambos os tipos de delta; nos modos de pensamento, os blocos de reasoning_content chegam primeiro, depois a resposta:
stream = client.chat.completions.create(
    model="deepseek-v4-pro",
    reasoning_effort="high",
    stream=True,
    messages=[
        {"role": "user", "content": "Design a rate limiter for a public API. Compare token bucket and sliding window."},
    ],
)

for chunk in stream:
    if not chunk.choices:
        continue # final chunk may carry usage data only
    delta = chunk.choices[0].delta
    if getattr(delta, "reasoning_content", None):
        print(delta.reasoning_content, end="", flush=True) # thinking phase
    elif delta.content:
        print(delta.content, end="", flush=True) # answer phase
Um padrão de UI sensato: renderize a fase de raciocínio colapsada como um indicador de "pensando", então mude para a renderização normal quando os deltas de content começarem. Por baixo dos panos, isso são eventos enviados pelo servidor padrão; nosso guia sobre streaming de respostas de API com SSE cobre a mecânica.
Chamada de ferramentas e saídas estruturadas
O V4 Pro suporta chamadas de função no estilo OpenAI, o que significa que loops de agente existentes podem ser portados sem modificação. Defina ferramentas, leia tool_calls, execute, anexe resultados, repita:
tools = [{
    "type": "function",
    "function": {
        "name": "get_endpoint_status",
        "description": "Check the health of an internal API endpoint",
        "parameters": {
            "type": "object",
            "properties": {
                "endpoint": {"type": "string", "description": "Path, e.g. /v1/orders"}
            },
            "required": ["endpoint"],
        },
    },
}]

response = client.chat.completions.create(
    model="deepseek-v4-pro",
    messages=[{"role": "user", "content": "Is /v1/orders healthy right now?"}],
    tools=tools,
)

print(response.choices[0].message.tool_calls)
Saídas estruturadas funcionam através do parâmetro padrão response_format quando você precisa de JSON garantidamente analisável. Um guia completo sobre loops de ferramentas multi-etapas merece seu próprio artigo; os documentos oficiais cobrem os detalhes do formato das mensagens.
Economia de cache de prompt: o número que muda sua arquitetura
Aqui está a especificação que merece mais atenção do que os benchmarks. A DeepSeek armazena em cache prefixos de prompt automaticamente, sem cabeçalhos de controle de cache, sem configuração de TTL, e prefixos repetidos são cobrados a $0.003625/M em vez de $0.435/M. Isso é um desconto de 120x para entrada que a API já viu.
Calcule os números para uma carga de trabalho realista. Digamos que você esteja construindo um agente de codificação que mantém um contexto de repositório de 200 mil tokens e faz 50 chamadas em uma sessão:
- Sem cache: 50 chamadas × 200 mil tokens × $0.435/M ≈ $4.35 em custos de entrada.
- Com cache automático: um cache miss ($0.087) + 49 cache hits (≈ $0.0007 cada) ≈ $0.12.
Mesma sessão, aproximadamente 35x mais barato, e tudo o que é preciso é a estrutura do prompt: conteúdo estável primeiro (prompt do sistema, documentação, contexto do repositório), conteúdo volátil por último (a última mensagem do usuário, timestamps, IDs de solicitação). Qualquer mudança no início do prompt invalida o prefixo em cache a partir desse ponto, então um timestamp no seu prompt do sistema converte silenciosamente cada chamada em um cache miss de preço total.
Isso também reformula a janela de contexto de 1 milhão de tokens: preenchê-la custa $0.435 em uma falha de cache, mas como um prefixo de sessão estável, custa cerca de um terço de um centavo por chamada. Para a teoria geral, veja O que é cache de prompt.
Testando deepseek-v4-pro no Apidog
Antes que o V4 Pro chegue perto de um código de produção, coloque o endpoint sob um depurador adequado. Como a API da DeepSeek é compatível com OpenAI, o Apidog a detecta sem nenhuma manipulação especial:
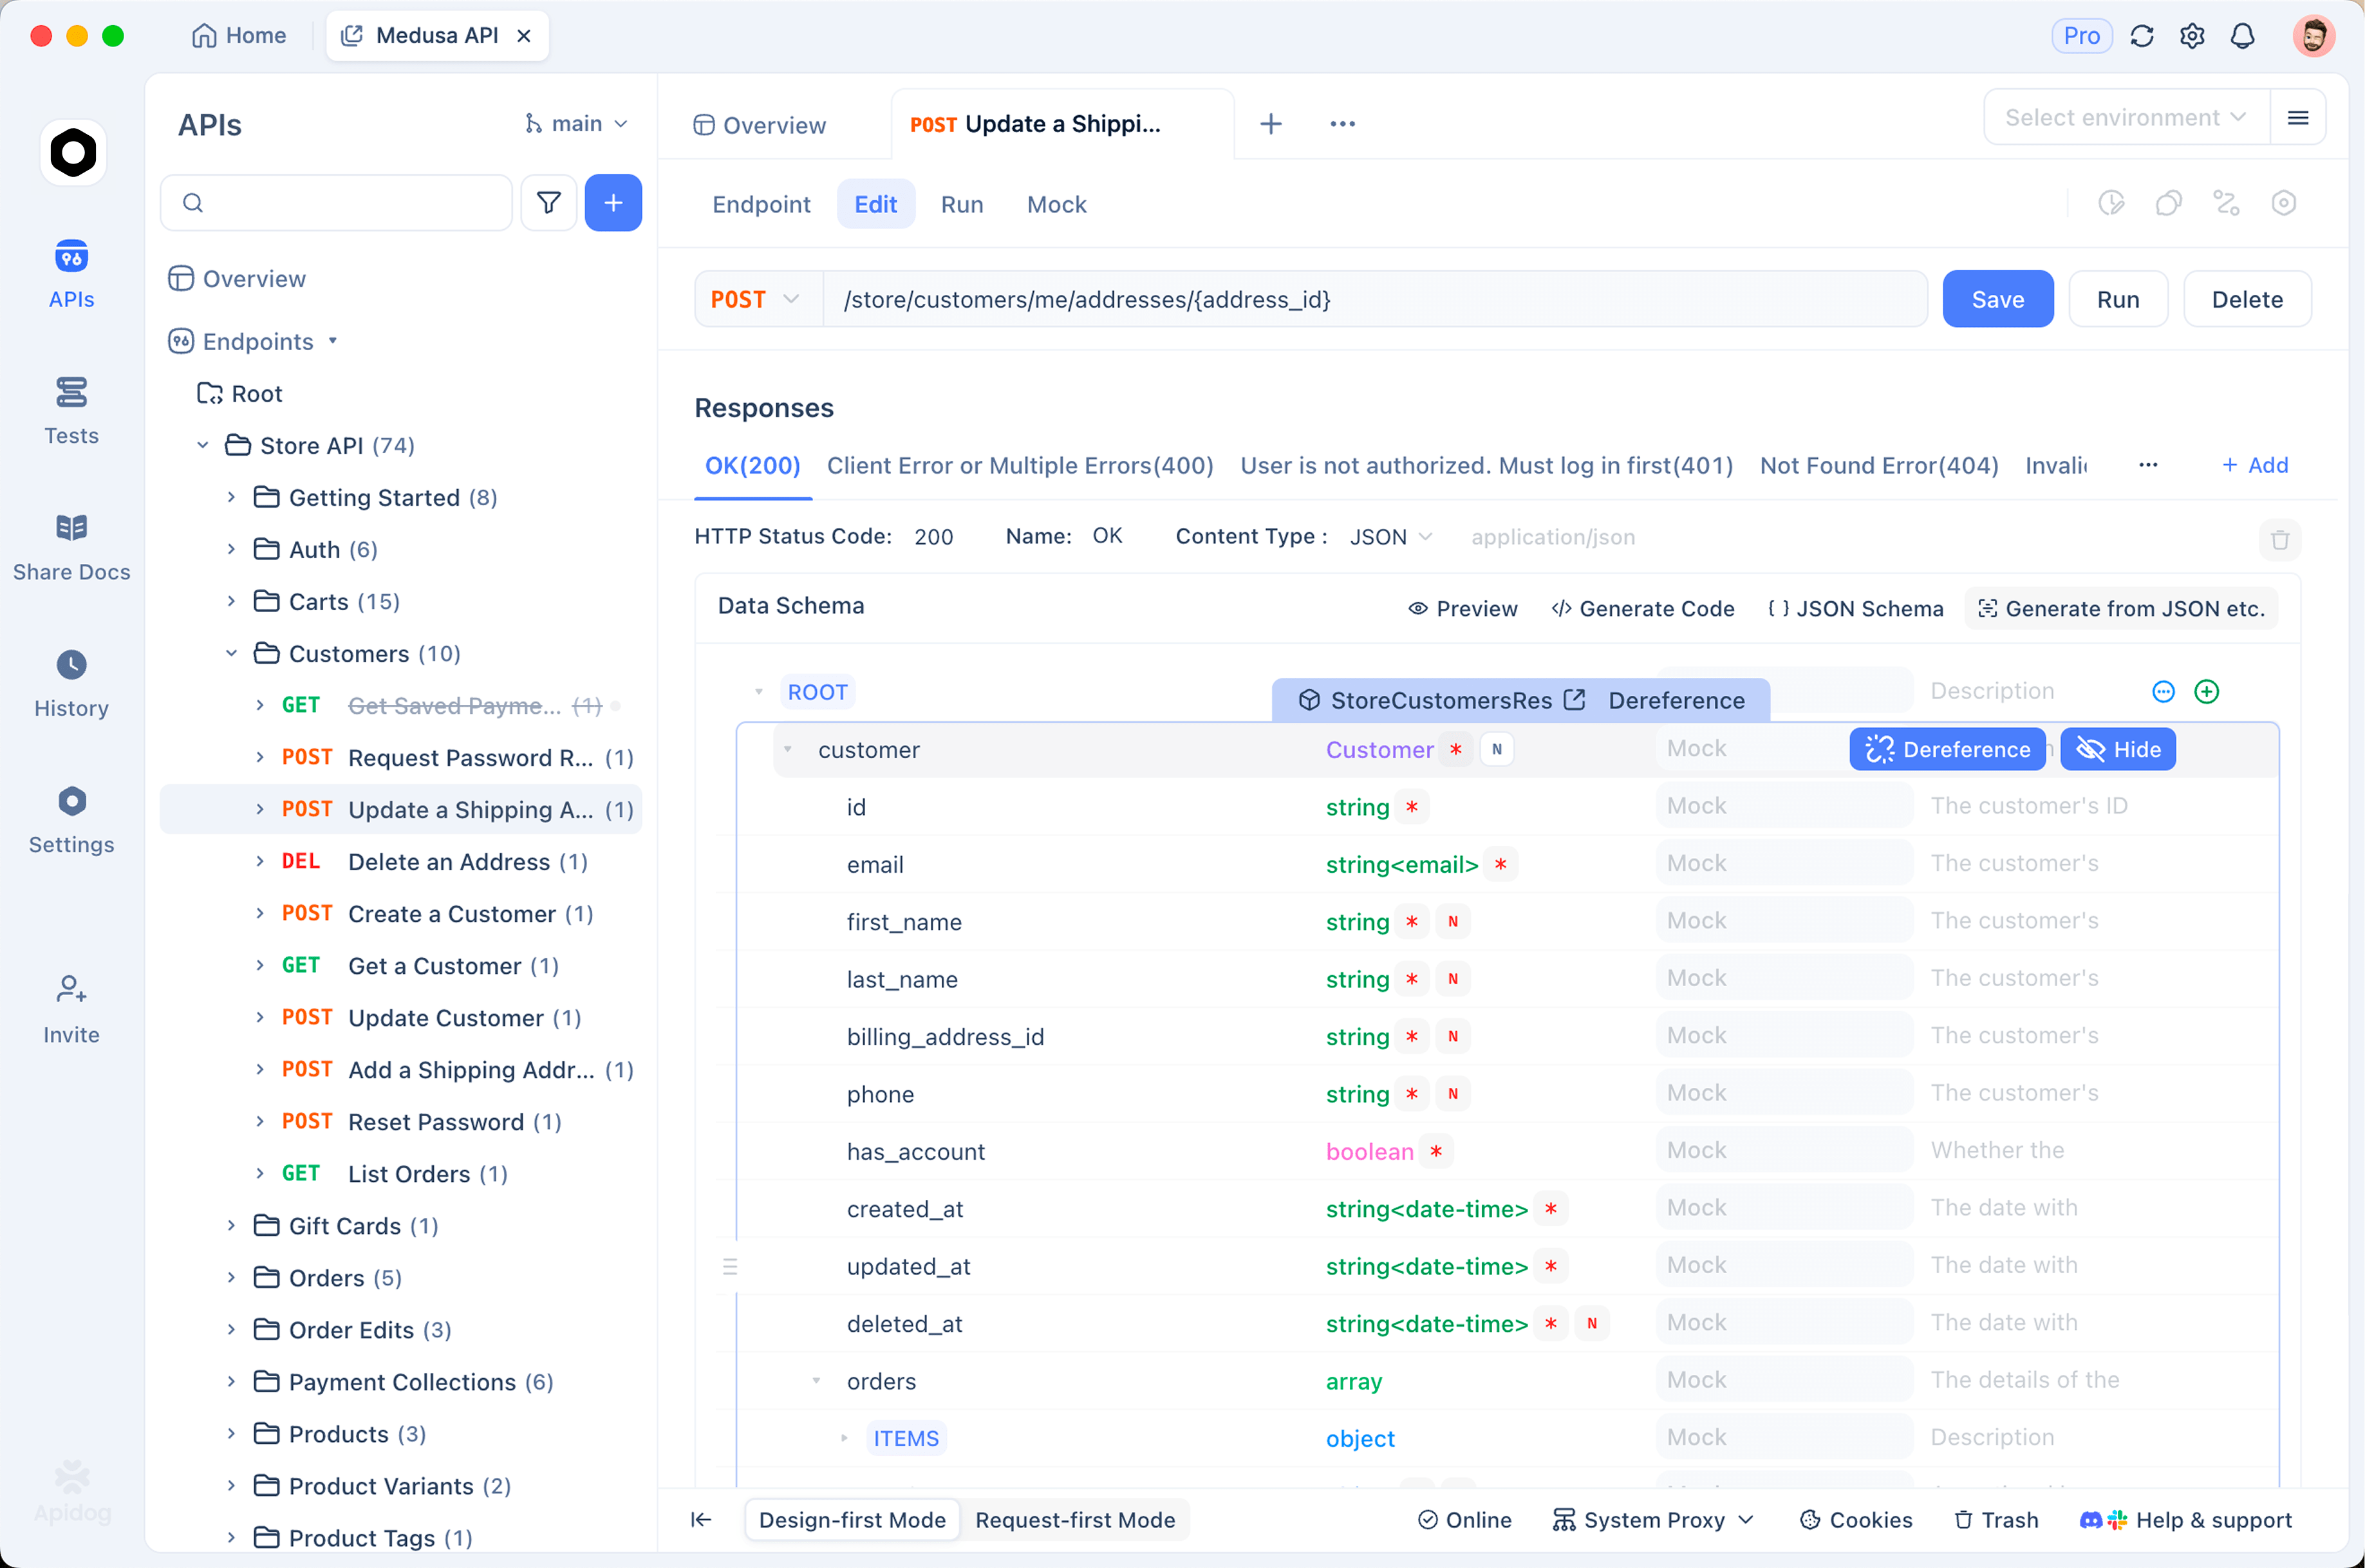
- Importe o endpoint. Cole o comando curl de antes no Apidog e ele se tornará uma solicitação editável, com cabeçalhos, autenticação e corpo analisados automaticamente.
- Configure ambientes para Pro e Flash. Armazene
base_urle sua chave de API como variáveis de ambiente, e torne o nome do modelo uma variável também. Alternar entredeepseek-v4-proedeepseek-v4-flashse torna uma mudança de ambiente com um clique, o que transforma "o Pro vale 3x o preço do Flash neste prompt?" em uma questão empírica em vez de um debate. - Inspecione o stream SSE. Envie uma solicitação com
"stream": truee o Apidog renderizará o stream de eventos como uma linha do tempo ao vivo, em vez de uma parede de linhasdata:brutas, mesclando deltas para que você possa verreasoning_contentchegar antes da resposta. Quando uma chamada "think-max" parecer lenta, esta visualização mostra exatamente para onde o tempo foi. - Salve a sessão como uma coleção. Quando a DeepSeek lançar o próximo snapshot, execute novamente as mesmas solicitações e compare o comportamento antes de atualizar, o mesmo fluxo de trabalho que as equipes usam para endpoints compatíveis com OpenAI em geral.
O visualizador de respostas também exibe o bloco usage em cada solicitação, que é a maneira mais rápida de verificar sua taxa de acertos de cache enquanto você ajusta a estrutura do prompt.
Preços hoje e o aumento que está por vir
| Modelo | Entrada (miss) | Entrada (cache hit) | Saída |
|---|---|---|---|
deepseek-v4-pro |
$0.435/M | $0.003625/M | $0.87/M |
deepseek-v4-flash |
$0.14/M | $0.28/M |
Mesmo com os preços do Pro, isso supera os modelos ocidentais de ponta por uma ampla margem. Mas planeje em torno de uma ressalva: em 6 de agosto de 2026, seis dias antes do GA, a DeepSeek alertou que um aumento "significativo" no preço da API está a caminho, sem valores, sem data efetiva.
Estratégias práticas enquanto o número é desconhecido:
- Meça seu custo real por tarefa agora, com dados de
usagede cargas de trabalho reais, para que você possa modelar qualquer aumento anunciado em minutos, em vez de adivinhar. - Maximize os acertos de cache. Se o aumento se aplicar proporcionalmente, arquiteturas com muitos prefixos manterão a maior parte de sua vantagem.
- Mantenha o V4 Flash como um fallback de roteamento. A $0.14/$0.28 com 13B de parâmetros ativos, ele lida com tarefas simples de alto volume, então o Pro é reservado para solicitações que realmente precisam dele.
Para uma análise mais aprofundada da estrutura de preços do V4 e como ela se compara entre os provedores, consulte nosso guia de preços da API DeepSeek V4.
FAQ
Meu código SDK OpenAI existente funcionará sem alterações?
Quase. Altere base_url para https://api.deepseek.com, troque a chave da API e defina model="deepseek-v4-pro". Chat Completions, streaming, ferramentas e saídas estruturadas seguem os formatos OpenAI. Equipes que usam o SDK Anthropic podem usar o endpoint Anthropic Messages da DeepSeek.
Quando devo usar o V4 Flash em vez do V4 Pro?
O Flash (284B total, 13B ativos) é o modelo de volume: classificação, extração, chat simples, qualquer coisa sensível à latência que não precise de raciocínio profundo. O Pro justifica seu preço de saída 3x maior em codificação agêntica, análise de contexto longo e cargas de trabalho em modo de pensamento. Roteie por tarefa, não por lealdade.
Posso usar o V4 Pro 0813 no Cursor?
Sim, o Cursor aceita endpoints personalizados compatíveis com OpenAI, então a versão GA pode ser usada como um modelo personalizado. Detalhamos a configuração exata em Como usar DeepSeek V4 Pro com Cursor.
Conclusão
O primeiro dia com um modelo GA é o momento certo para construir a memória muscular: chave, primeira solicitação, modos de pensamento, streaming e um layout de prompt ciente do cache. O V4 Pro recompensa esse último hábito mais do que qualquer modelo anterior, o desconto de 120x no cache torna a estrutura do prompt uma decisão de arquitetura. Conecte os exemplos acima, observe os números de usage e mantenha uma coleção Apidog salva para que você possa verificar novamente o comportamento quando o próximo snapshot ou a mudança de preço anunciada for lançada.