
DeepSeek-V4.1-Flash foi lançado para o público (GA) na API em 10 de setembro de 2026, e chegou com dois fatos que fazem de “gratuito” uma verdadeira questão em vez de um chamariz de marketing. Os pesos são licenciados sob MIT no Hugging Face, então o próprio modelo não custa nada. E a API oficial cobra a entrada de cache-hit a $0.003 por 1M de tokens fora do horário de pico, perto o suficiente de zero para que a linha entre gratuito e quase gratuito deixe de importar para a maioria dos projetos paralelos.
Ainda não existe um nível gratuito permanente na API do DeepSeek. Qualquer um que diga o contrário está descrevendo uma promoção de roteador ou o aplicativo de chat do consumidor. Este guia classifica todas as maneiras honestas de usar o V4.1-Flash sem pagar, e então mostra o cálculo do caminho pago para que você possa decidir se o "quase gratuito" é suficientemente próximo. Se você quiser a história da arquitetura primeiro, leia o que é DeepSeek-V4.1-Flash e volte.
Uma observação primeiro. Várias rotas gratuitas passam por endpoints de terceiros que aplicam limites de taxa e, às vezes, trocam modelos silenciosamente. Testá-los com o Apidog, gravando respostas e verificando o campo do modelo, evita que sua cota gratuita seja consumida na sua própria depuração. Esse fluxo de trabalho está perto do fim.
TL;DR
Classificado de “gratuito sem compromisso” a “quase gratuito com um cartão arquivado”:
- O aplicativo de chat do DeepSeek em chat.deepseek.com. Gratuito, sem cartão. Melhor para avaliar manualmente a qualidade da saída.
- Os pesos abertos no Hugging Face. Gratuitos sob licença MIT, mas 552B de parâmetros significam que o hardware é o custo.
- Roteadores de terceiros como OpenRouter. Níveis gratuitos existem para alguns modelos em alguns momentos, com limites de taxa e trade-offs de política de dados.
- Créditos de teste incluídos em ferramentas de codificação. Útil apenas quando a ferramenta já oferece o DeepSeek como backend.
- A API oficial. Não é gratuita, mas um projeto de hobby funciona por cerca de $1.35 por mês fora do horário de pico.
Opção 1: o aplicativo de chat DeepSeek
O aplicativo de consumidor em chat.deepseek.com é a rota de fricção zero. Inscreva-se com um e-mail ou número de telefone, sem cartão, e comece a fazer prompts.
Duas ressalvas. Primeiro, qual modelo o aplicativo serve após o lançamento de hoje é [VERIFICAR]. A nota de lançamento cobre a API, e o aplicativo já havia ficado para trás da API ou rodado uma compilação separadamente ajustada. Segundo, o aplicativo é uma interface de chat, não uma API. Você não pode scriptá-lo, agrupar prompts ou conectá-lo a um produto.
Então, o aplicativo responde a uma pergunta: o V4.1-Flash lida bem com seu domínio o suficiente para justificar uma integração? Cole a entrada que seus usuários enviam, incluindo imagens, já que o modelo é nativamente multimodal. Se as respostas forem satisfatórias, passe para uma das rotas abaixo.
Opção 2: os pesos abertos
DeepSeek publicou os pesos e o relatório técnico do V4.1-Flash sob a licença MIT. Você pode baixá-los, executá-los, ajustá-los e lançar produtos com eles sem pagar ao DeepSeek ou pedir permissão.
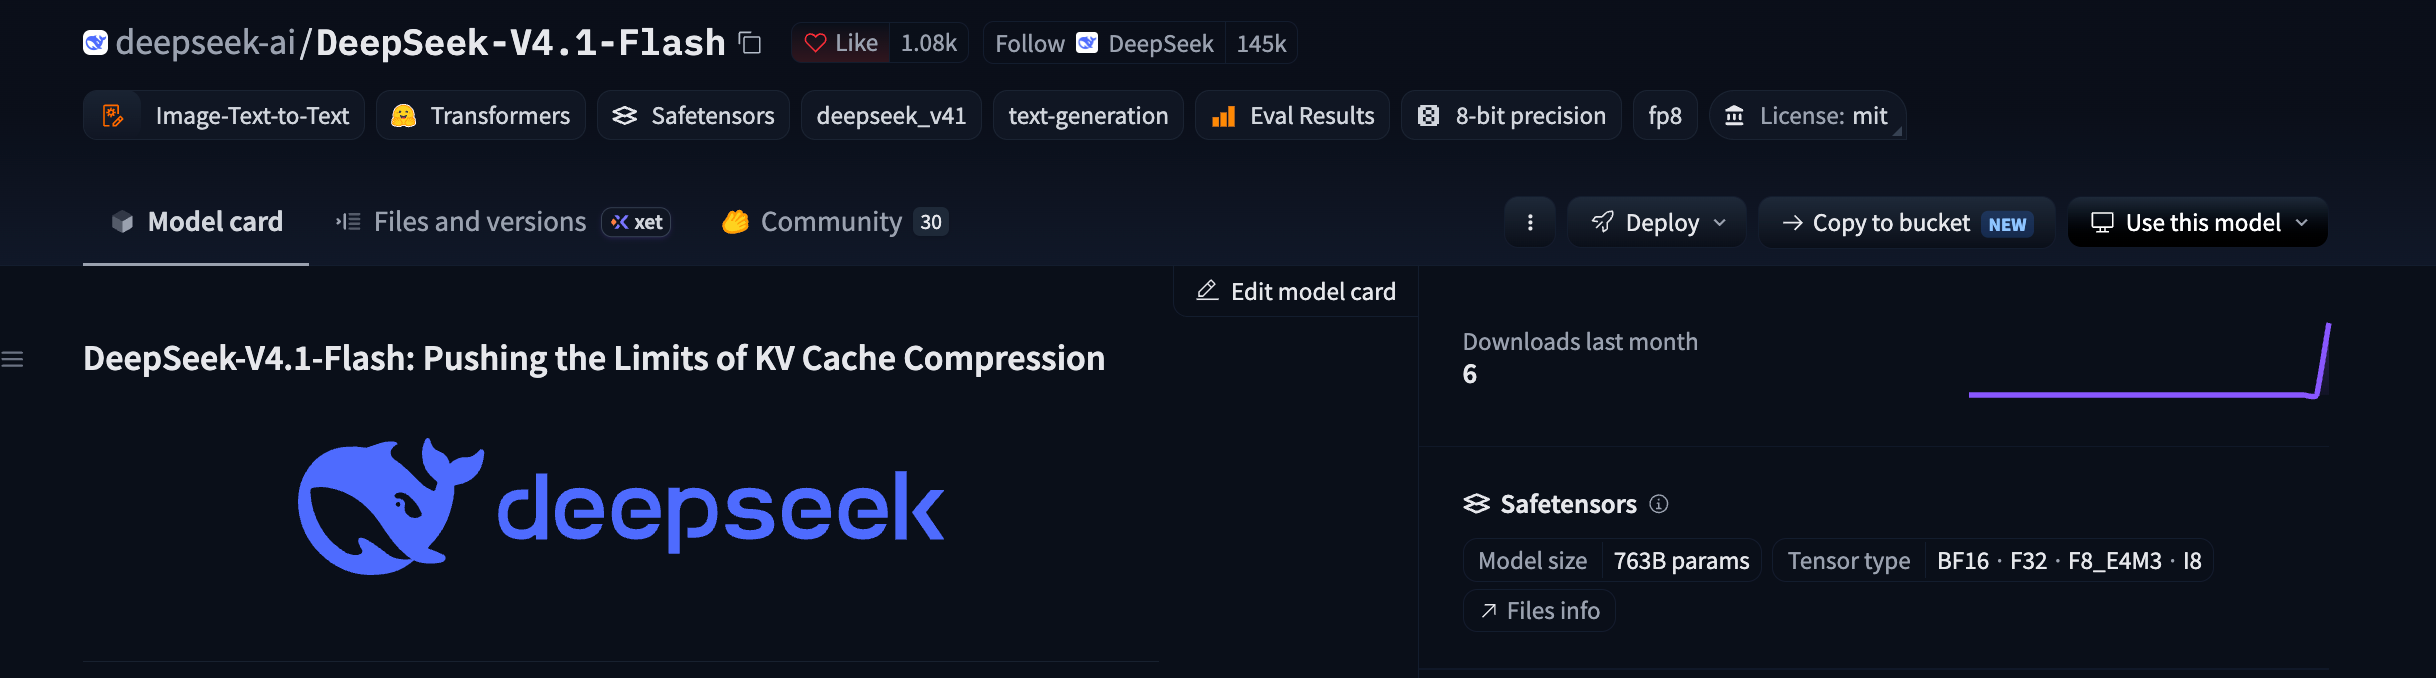
O problema é o tamanho. O V4.1-Flash é uma arquitetura de mixture-of-experts com 552B de parâmetros (763B com o codificador de visão). Apenas 8B de parâmetros estão ativos durante o pré-preenchimento e 16B durante a decodificação, mas o conjunto completo de parâmetros ainda precisa estar armazenado em algum lugar. Em 8 bits, isso é aproximadamente 552 GB apenas para a arquitetura principal; em 4 bits, cerca de 280 GB. Uma única GPU de consumidor não chega perto disso. O cache KV é a boa notícia: a 890 bytes por token sob cache FP4, um contexto completo de 1M de tokens precisa de cerca de 0.9 GB.
“Gratuito” aqui significa gratuito para licenciar, não gratuito para executar. Leia como rodar DeepSeek-V4.1-Flash localmente para conhecer as categorias de hardware e os motores de inferência a verificar antes de baixar 280 GB. Se você já possui o hardware, esta é a opção gratuita mais duradoura na página: sem limites de taxa, sem política de dados, sem trocas silenciosas de modelo.
Opção 3: a API oficial não é gratuita, mas é quase
A plataforma DeepSeek é pay-as-you-go (pague pelo uso). Você recarrega um saldo, cria uma chave e é cobrado por token. Não há nível gratuito permanente.
O que lhe confere um lugar em uma página de “grátis” é o preço. Aqui está a tabela completa em USD da página oficial de preços, efetiva a partir de 10 de setembro de 2026 às 04:00 UTC, por 1M de tokens:
| Tipo de token | deepseek-flash fora do pico | deepseek-flash pico |
|---|---|---|
| Entrada, cache hit | $0.003 | $0.006 |
| Entrada, cache miss | $0.15 | $0.30 |
| Saída | $0.60 | $1.20 |
Os horários de pico são de segunda a sexta-feira, das 01:00 às 04:00 e das 06:00 às 10:00 UTC (09:00 às 12:00 e das 14:00 às 18:00 em Pequim). Todo o resto, incluindo fins de semana, é fora do pico pela metade do preço. O cache de contexto é automático, então prompts de sistema repetidos utilizam o cache sem código extra.
Agora a matemática. Suponha que um projeto paralelo envie 5M de tokens de entrada nova (cache-miss) e gere 1M de tokens de saída em um mês, tudo fora do horário de pico:
- 5M de entrada cache-miss a $0.15 por 1M = $0.75
- 1M de saída a $0.60 por 1M = $0.60
- Total: $1.35 por mês
Se parte dessa entrada for um prompt de sistema repetido, o custo cai ainda mais. 1M de tokens de cache-hit fora do pico custam $0.003, então um prompt de sistema de 2.000 tokens reutilizado em 10.000 requisições (20M de tokens em cache) adiciona seis centavos. A conta se resume a troco de bolso, e você obtém o modelo exato que pediu com um limite de concorrência de 2.500 requisições. O explicador de preços do V4.1-Flash aborda como a matemática muda com a estrutura do prompt.
Uma chamada mínima, com o bloco de uso impresso para que você possa ver a divisão do cache:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[
        {"role": "system", "content": "You classify support tickets as billing, bug, or feature request."},
        {"role": "user", "content": "Customer says their August invoice shows two charges for one seat."},
    ],
)

print(response.choices[0].message.content)
print(response.usage)
Opções 4 e 5: roteadores, níveis gratuitos e créditos incluídos
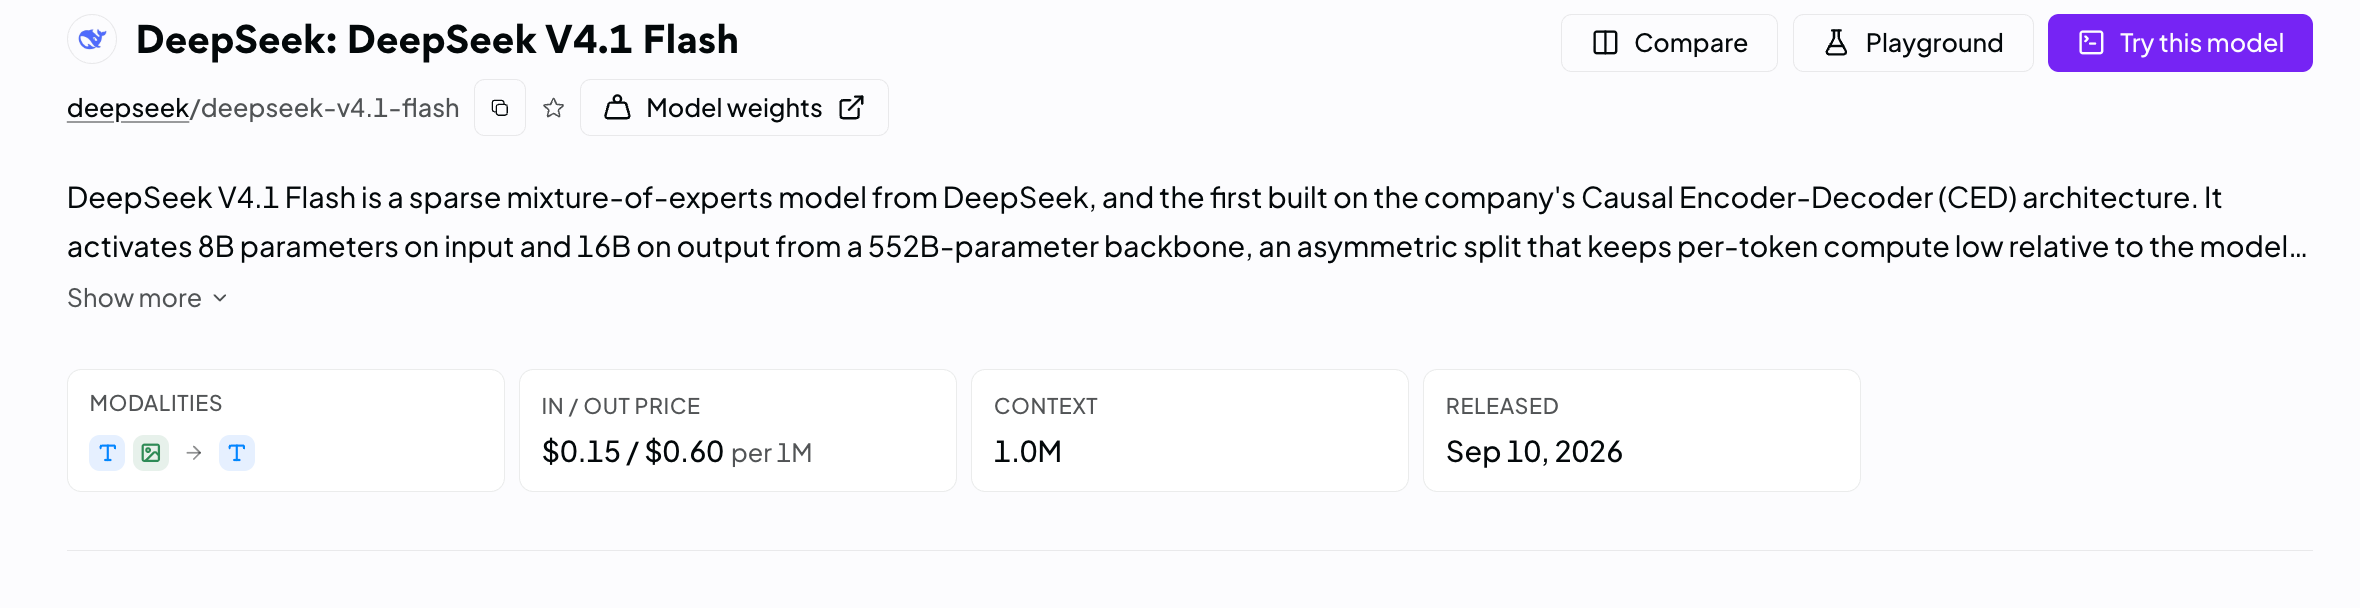
OpenRouter é o lugar comum para procurar um endpoint gratuito para um novo modelo de pesos abertos. Roteadores agregam vários hosts por trás de uma API compatível com OpenAI, e os hosts às vezes executam um nível gratuito em um modelo para atrair tráfego. Se o V4.1-Flash está listado lá hoje, e se algum host oferece um nível gratuito para ele, é [VERIFICAR]; o modelo tem poucas horas e as listagens mudam rapidamente.
Três avisos se aplicam a todo nível gratuito de roteador:
- Os limites de taxa são rigorosos. Limites por minuto e por dia significam que um loop de teste pode esgotar a cota de um dia em uma hora.
- As políticas de dados diferem por host. O tráfego gratuito é frequentemente o que um host tem permissão para registrar ou treinar. Leia a política antes de enviar qualquer coisa privada.
- Os níveis gratuitos mudam semanalmente. Gratuito na segunda pode ser pago até sexta-feira, ou roteado para um host diferente. Não crie uma dependência de produção em um deles.
A falha a ser observada é a substituição silenciosa de modelo: você solicita V4.1-Flash e um modelo mais antigo responde porque o host gratuito caiu. O campo `model` da resposta é sua primeira linha de defesa, e o fluxo de trabalho abaixo o verifica.
Algumas ferramentas de codificação, entre elas Cursor e agentes estilo Codex, incluem créditos de teste que você pode usar nos backends que a ferramenta suporta. Se uma ferramenta que você já usa lista o DeepSeek como um modelo selecionável, esses créditos são uma rota gratuita legítima pela duração do teste. Não se inscreva em uma ferramenta apenas para acessar o DeepSeek dessa forma; os valores dos créditos e os modelos elegíveis mudam com muita frequência para serem documentados.
Qual opção se encaixa na sua situação
| Opção | Custo | Modelo garantido? | Limites de taxa | Melhor para |
|---|---|---|---|---|
| Aplicativo de chat DeepSeek | Gratuito | Depende da compilação do app | Limites de uso do app | Avaliação manual, verificações rápidas |
| Pesos abertos (MIT) | Licença gratuita, seu hardware | Sim, você o executa | Nenhum | Privacidade, fine-tuning, GPUs próprias |
| API oficial | Cerca de $1.35/mês em escala de hobby | Sim | 2.500 requisições simultâneas | Qualquer coisa que você lançar |
| Nível gratuito do roteador | Gratuito enquanto durar | Não, hosts trocam | Limites por minuto e por dia | Protótipos, comparações |
| Créditos de ferramentas | Gratuito durante o teste | Depende da ferramenta | Definidos pela ferramenta | Codificação dentro dessa ferramenta |
Se você planeja lançar algo, gaste o dólar na API oficial. Se você está avaliando, comece com o aplicativo de chat. Se você tem GPUs, os pesos superam todas as outras opções.
Teste endpoints gratuitos no Apidog sem queimar cota
As rotas gratuitas têm dois modos de falha: você atinge o limite de taxa enquanto depura seu próprio código, e o roteador lhe entrega um modelo diferente sem avisar. Ambos são baratos de prevenir com o Apidog, que testa a camada da API na frente de qualquer endpoint que você escolher.
- Adicione o endpoint uma vez. Crie `POST {{BASE_URL}}/chat/completions` com `Bearer {{API_KEY}}` no cabeçalho de Autorização. Todas as opções, exceto o aplicativo de chat, seguem o mesmo formato compatível com OpenAI, então uma requisição salva abrange todas elas.
- Crie um ambiente por provedor. Um ambiente `official` define `BASE_URL` como `https://api.deepseek.com` com sua chave DeepSeek; um ambiente `router` aponta para o host gratuito. A troca é feita por um menu suspenso.
- Grave respostas reais e depois simule-as. Envie alguns prompts representativos através do endpoint gratuito, salve as respostas e sirva-as a partir do servidor de mock do Apidog. Enquanto você constrói a análise, as retentativas e a interface do usuário, seu aplicativo acessa o mock e a cota gratuita permanece intocada.
- Verifique o campo do modelo. Salve a requisição como um caso de teste afirmando que `model` na resposta contém a string que o host retorna para V4.1-Flash. Execute-o no início de cada sessão, e um modelo trocado falhará no teste antes que você gaste uma hora perseguindo uma “regressão” em seus prompts.
- Verifique o bloco de uso. Verifique se `usage.prompt_tokens` e `usage.completion_tokens` são maiores que zero, e leia a contagem de cache-hit na API oficial a partir do mesmo bloco. Após uma semana, você saberá o que um nível gratuito lhe economizou e se seus prompts são armazenados em cache tão bem quanto você supôs.
Baixe o Apidog e o processo leva menos de dez minutos. Uma vez que as verificações existam, o `apidog-cli` as executa em CI para que uma troca de roteador interrompa uma build em vez de uma demonstração.
FAQ
O DeepSeek-V4.1-Flash é gratuito para usar? O modelo é gratuito para licenciar sob MIT e gratuito para usar dentro do aplicativo de chat DeepSeek. A API oficial é pay-as-you-go (pague pelo uso) sem um nível gratuito permanente. O DeepSeek é gratuito rastreia como essa divisão se manteve em toda a linha de modelos.
A API do DeepSeek tem um teste gratuito? Não há um permanente. O caminho de menor custo é a API oficial fora do pico: 5M de tokens de entrada cache-miss mais 1M de tokens de saída custam $1.35.
Qual é a maneira mais barata de chamar o V4.1-Flash pela API? Envie fora do horário de pico e estruture os prompts para que prefixos compartilhados atinjam o cache, já que um acerto custa 50 vezes menos do que uma falha. O que é cache de prompt explica como ordenar um prompt para isso.
Posso rodar o V4.1-Flash em um laptop? Não o modelo completo. 552B de parâmetros são cerca de 280 GB em 4 bits apenas para a arquitetura principal. O guia local linkado acima cobre o que é realista para cada nível de hardware.
Uma versão gratuita de roteador é o mesmo modelo que a API oficial? Apenas se o host disser e seus testes confirmarem. Verifique o campo `model` e compare as saídas em um conjunto fixo de prompts contra o endpoint oficial. Os guias para DeepSeek V4 gratuito e a API V4 gratuita executam a mesma verificação para a geração anterior.
Onde isso te deixa
O V4.1-Flash é gratuito das duas maneiras que mais importam: os pesos são MIT e o aplicativo de chat não custa nada. Tudo entre esses polos é um nível gratuito que mudará ou uma API oficial com preço baixo o suficiente para que "gratuito" deixe de valer a pena otimizar. A $1.35 por mês, a rota mais barata geralmente é pagar.
Qualquer que seja o endpoint que você escolher, coloque o Apidog na frente dele: simule respostas enquanto você constrói, verifique o campo do modelo, registre o uso. Cota gratuita é um recurso. Gaste-o no modelo, não em seus próprios bugs.