A DeepSeek disponibilizou os pesos do DeepSeek-V4.1-Flash no Hugging Face sob uma licença MIT em 10 de setembro de 2026, no mesmo dia em que o modelo foi lançado globalmente (GA) na API. Esse é um cronograma incomum. A maioria dos laboratórios lança primeiro o endpoint hospedado e libera os pesos semanas depois, se é que o fazem.
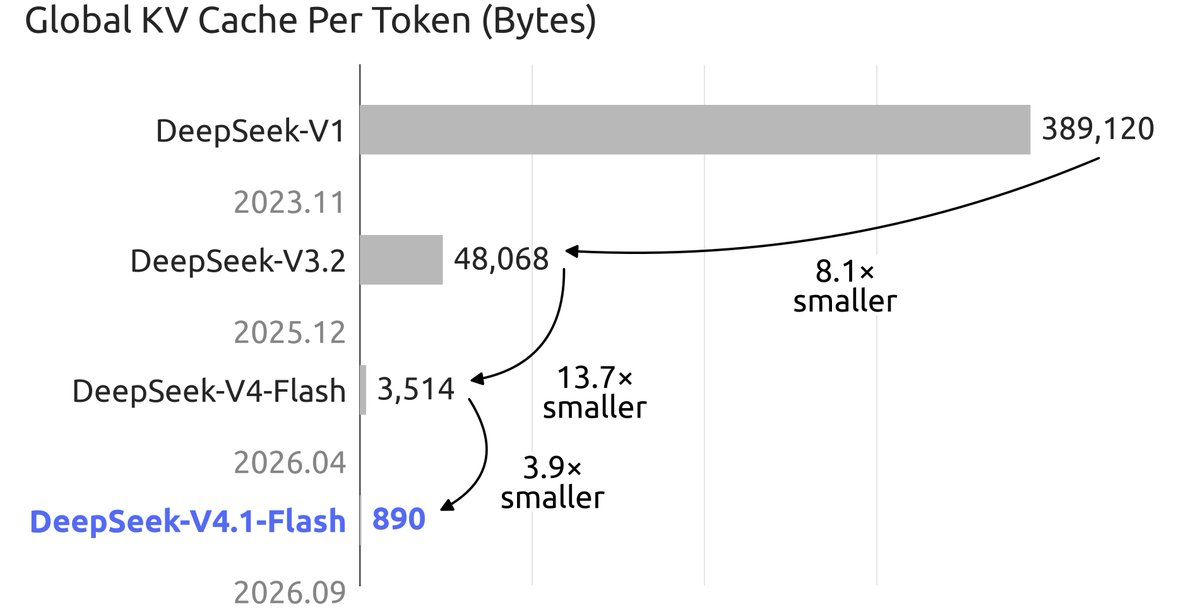
O número principal assustará a maioria dos leitores: 552 bilhões de parâmetros na arquitetura principal, 763 bilhões com o codificador de visão. Mas o design subjacente é mais amigável ao auto-hospedagem do que o tamanho sugere. Apenas 8B de parâmetros estão ativos durante o preenchimento (prefill) e 16B durante a decodificação, e o novo cache KV FP4 custa 890 bytes por token, aproximadamente um quarto do que o V4-Flash precisava. O cálculo é barato. A memória é a barreira.
As pessoas tentarão de qualquer forma. Este guia fornece o cálculo da memória, os caminhos realistas para cada nível de hardware, os comandos genéricos de configuração e uma maneira de testar um endpoint local compatível com OpenAI em relação à API hospedada no Apidog. Se você quiser primeiro uma visão geral do modelo, leia O que é DeepSeek-V4.1-Flash? e depois retorne.
TL;DR
- Pesos: arquitetura principal MoE de 552B, licença MIT. Cerca de 552 GB em 8 bits, cerca de 280 GB em 4 bits, apenas a arquitetura principal.
- Cache KV: 890 bytes por token. Um contexto completo de 1M de tokens precisa de cerca de 0,9 GB. Essa parte está resolvida.
- A hospedagem realista de 4 bits precisa de 4 a 8 GPUs da classe de 80 GB. Tudo abaixo disso é descarregamento para CPU ou SSD, e lento.
- A API hospedada cobra $0,15 por 1M de tokens de entrada com cache-miss fora do pico. Para a maioria das equipes, isso já supera apenas a conta de eletricidade.
O que você está baixando
O cartão do modelo descreve uma arquitetura principal Mixture-of-Experts de 552B parâmetros com um novo layout Causal Encoder-Decoder: 40 camadas, divididas em 20 codificadores e 20 decodificadores. Cada camada roteia através de 384 especialistas mais 1 especialista compartilhado. O codificador de visão DeepSeek-ViT eleva o checkpoint completo para 763B parâmetros, e você baixa tudo mesmo que precise apenas de texto.
Três detalhes são importantes para a inferência local:
- Parâmetros ativos são pequenos. 8B ativos durante o preenchimento (prefill), 16B durante a decodificação. Os FLOPs por token parecem de um modelo denso de tamanho médio. O problema é que cada um dos 552B parâmetros precisa residir em algum lugar que a passagem direta possa alcançar.
- O cache KV é FP4. A nota de lançamento diz que o cache usa 1/4 da HBM e 1/8 do armazenamento SSD da geração anterior. Com 890 bytes por token, o contexto longo não é mais o problema de memória que costumava ser.
- A atenção é esparsa por design. A Compressed Sparse Attention 2 com três modos estáticos foi treinada com contexto de 64K e estendida para 1M no final da execução de 45T tokens. É por isso que os números KV permanecem pequenos em 1M.
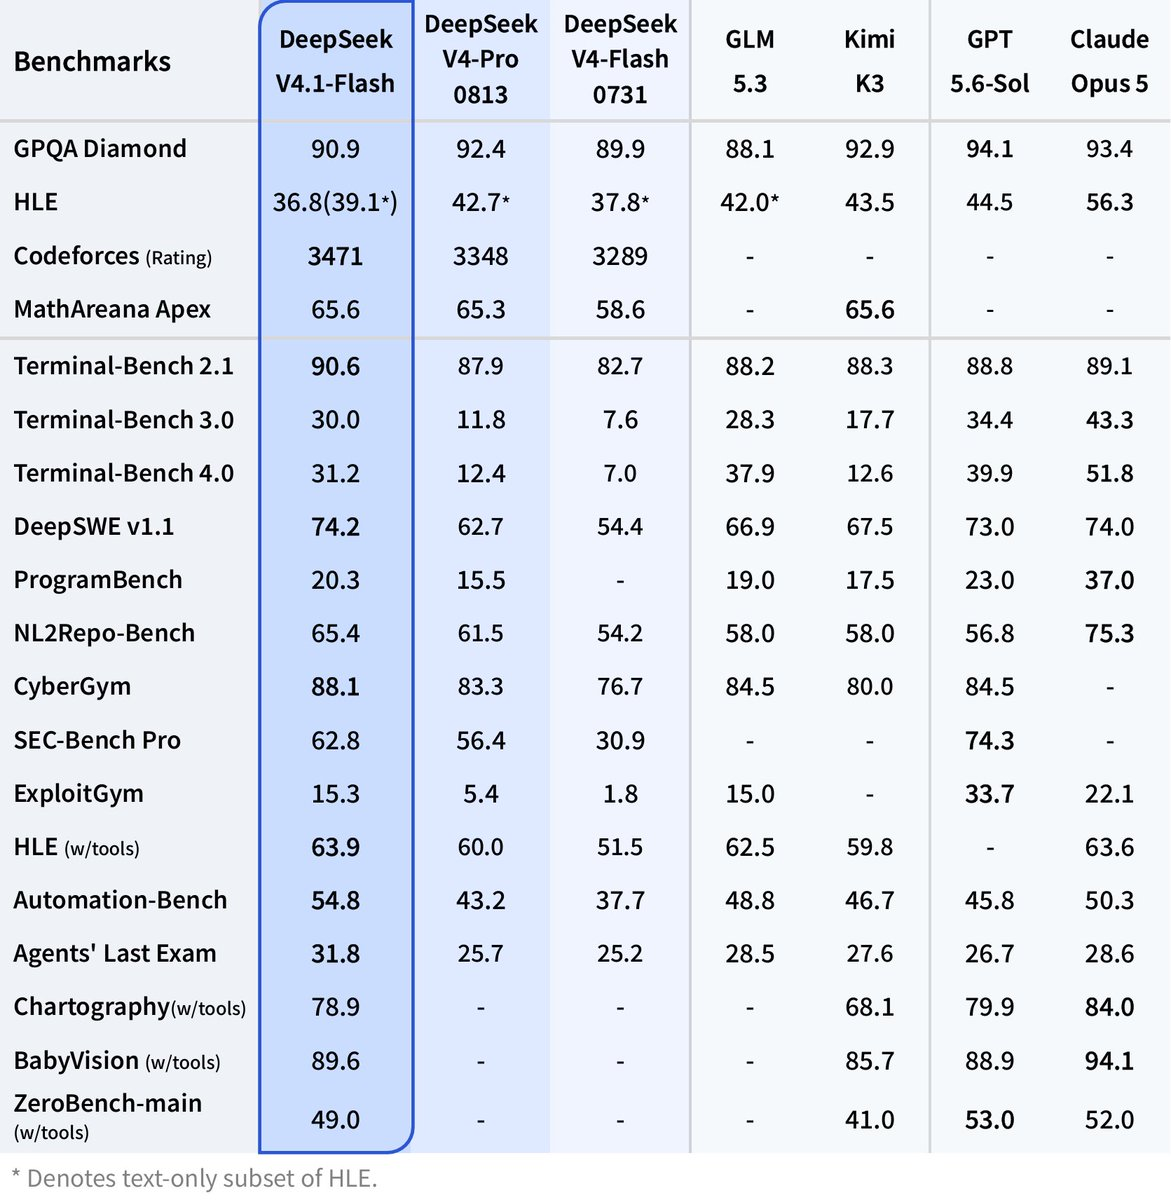
O relatório técnico cobre a arquitetura em sua totalidade. Cada figura de benchmark no cartão é reportada pela DeepSeek; trate-as como afirmações.
O cálculo da memória
Os números abaixo são multiplicações diretas, não medições, e excluem a sobrecarga do motor, ativações e o codificador de visão.
| Componente | Tamanho | Como é calculado |
|---|---|---|
| Pesos da arquitetura principal, 8 bits | ~552 GB | 552B parâmetros x 1 byte |
| Pesos da arquitetura principal, 4 bits | ~280 GB | 552B parâmetros x 0.5 byte |
| Cache KV, por token | 890 bytes | Do cartão do modelo |
| Cache KV com contexto de 128K | ~0.11 GB | 890 x 128.000 |
| Cache KV com contexto de 1M | ~0.89 GB | 890 x 1.000.000 |
Duas coisas se destacam. Primeiro, o cache KV é um erro de arredondamento. Uma sessão de 1M de tokens cabe em menos de um gigabyte, então você pode manter dezenas de sessões longas residentes sem afetar o orçamento de pesos. Segundo, os pesos são o problema principal. Nenhum truque de quantização faz com que 552B parâmetros caibam em uma única GPU de consumidor, e o design de 8B ativos não ajuda, porque o roteamento MoE ainda precisa de cada especialista carregado e endereçável.
É também por isso que as configurações descarregadas parecem desequilibradas. O preenchimento (prefill) agrupa todo o prompt e permanece limitado pelo cálculo. A decodificação carrega 16B parâmetros ativos da RAM ou SSD para cada token. A largura de banda, não os FLOPs, define seus tokens por segundo.
Níveis de hardware realistas
Não há números de throughput aqui. Ninguém fora da DeepSeek teve os pesos por tempo suficiente para publicar benchmarks confiáveis.
Nível 1: servidor multi-GPU, 4 a 8 placas da classe de 80 GB. Quatro placas de 80 GB fornecem 320 GB, o suficiente para pesos de 4 bits com uma pequena margem para cache KV e sobrecarga do motor. Oito placas fornecem 640 GB, o suficiente para o checkpoint de 8 bits ou uma implantação confortável de 4 bits com grandes lotes. Este é o único nível em que “executá-lo localmente” significa um serviço de nível de produção com paralelismo de tensor, e é uma compra de cinco ou seis dígitos ou um aluguel de nuvem de vários dólares por hora.
Nível 2: workstation de alta memória com descarregamento para CPU. Uma máquina com 512 GB ou mais de RAM do sistema e uma ou duas GPUs pode manter os pesos de 4 bits na RAM e transmitir camadas de especialistas para a GPU sob demanda. Funciona, e é lento, porque a largura de banda de decodificação é o seu barramento DDR5 em vez de HBM. Use-o para trabalhos em lote e avaliações noturnas, não para bate-papo interativo.
Nível 3: Apple Silicon com streaming de SSD. O caminho do entusiasta. Um Mac Studio de 512 GB armazena os pesos de 4 bits na memória unificada, o que é uma opção real se você já possui um. Abaixo disso, você está no território do tópico Kimi K3 HN: pesos divididos entre SSDs externos, mmap fazendo o trabalho pesado, aproximadamente 1 token por segundo. Isso prova que o modelo funciona, não que seja útil nessa máquina. Nosso guia para rodar Kimi K3 localmente aborda as mesmas compensações em um modelo maior, e como rodar DeepSeek V4 localmente cobre a geração anterior.
O caminho de configuração
Com o hardware no lugar, o fluxo é: baixar, servir por trás de um endpoint compatível com OpenAI, testar.
pip3 install -U "huggingface_hub[cli]"
huggingface-cli download deepseek-ai/DeepSeek-V4.1-Flash \
  --local-dir ./models/deepseek-v4.1-flash \
  --max-workers 8
Em uma linha de 1 Gbps, cada 100 GB leva aproximadamente 15 minutos em velocidade máxima. Reserve uma hora ou mais.
A hospedagem é onde mora a ressalva. O suporte Day-0 em vLLM, SGLang, llama.cpp e Ollama para a arquitetura CED e atenção CSA2 está [VERIFICAR]; um novo tipo de camada geralmente precisa de um patch do motor antes que os pesos carreguem, e a nota de lançamento não menciona motores específicos. Pesquise o changelog de cada projeto por “DeepSeek-V4.1” antes de se comprometer com um download. Assim que o suporte existir, a hospedagem com vLLM em 8 GPUs se parecerá com isto:
vllm serve ./models/deepseek-v4.1-flash \
  --tensor-parallel-size 8 \
  --max-model-len 131072 \
  --served-model-name deepseek-flash \
  --port 8000
Um `llama-server` do llama.cpp ou um modelo Ollama expõe o mesmo endpoint no estilo `http://localhost:8000/v1` assim que uma conversão GGUF existe, então qualquer cliente SDK do OpenAI funciona alterando uma linha:
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="local")

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "Summarize this incident report and list the three root causes."}],
    temperature=1.0,
    top_p=0.95,
)
print(response.choices[0].message.content)
Os valores `temperature=1.0` e `top_p=0.95` correspondem às configurações recomendadas no cartão do modelo. Para Ollama, nosso guia Ollama cobre o fluxo do Modelfile, e o guia vLLM cobre as flags multi-GPU em profundidade.
A alternativa pragmática: a API hospedada
Fora do pico, a página de preços lista o `deepseek-flash` a $0,15 por 1M de tokens de entrada com cache-miss, $0,003 por 1M de tokens de entrada com cache-hit e $0,60 por 1M de tokens de saída. Os horários de pico dobram esses valores. Assim, 1 bilhão de tokens de entrada mais 200 milhões de tokens de saída por mês custa cerca de $270 fora do pico e $540 no pico, antes que os acertos de cache reduzam ainda mais o lado da entrada. Um servidor com 8 GPUs da classe de 80 GB custa mais do que isso por mês apenas em eletricidade e refrigeração sob carga sustentada, antes de amortizar o hardware ou pagar alguém para cuidar dele. A menos que você tenha uma regra de residência de dados ou hardware já parado, a API ganha em custo. A mudança é uma alteração na `base_url`; nosso guia da API DeepSeek-V4.1-Flash detalha isso.
A solução local vence quando a restrição não é dinheiro: ambientes isolados (air-gapped), dados de prompt que você não pode enviar para nenhum lugar, ou pesquisas que precisam modificar os pesos.
Teste um endpoint local em relação à API hospedada no Apidog
Qualquer que seja o caminho escolhido, prove que o servidor local se comporta como a referência antes de direcionar tráfego para ele. Desvio de quantização, um template de chat incorreto ou um token de parada ausente aparecem como diferenças sutis na saída. Aqui está o fluxo de trabalho no Apidog:
- Crie dois ambientes. Um chamado `local` com `base_url` definido como `http://localhost:8000/v1`, e outro chamado `hosted` com `base_url` definido como `https://api.deepseek.com` e sua chave real. Cada requisição usa `{{base_url}}/chat/completions` e `Bearer {{api_key}}`.
- Salve um pequeno conjunto de prompts como requisições. De cinco a dez prompts que representem sua carga de trabalho: uma extração JSON, uma correção de código, um resumo de contexto longo. Defina `model` como `deepseek-flash` em todos eles; funciona em ambos os servidores.
- Adicione asserções. Para a tarefa JSON, afirme que a resposta é analisável (parsed) e que uma chave necessária existe. Para cada requisição, afirme que `finish_reason` é igual a `stop`, o que detecta truncamento de uma configuração de contexto ruim.
- Execute o conjunto contra ambos os ambientes. Troque o seletor de ambiente de `hosted` para `local` e execute novamente o mesmo cenário de teste. Uma falha que aparece apenas em `local` é o seu problema de quantização ou template, isolado em um clique.
- Observe o streaming. Defina `stream: true` e use a visualização SSE para ver os eventos chegarem um por um. Um servidor local que armazena em buffer toda a resposta antes de enviar parece bom em uma chamada não-streaming e errado aqui.
- Coloque-o no CI. Execute o cenário com `apidog-cli` em cada atualização do motor, para que um template de chat quebrado falhe um pipeline em vez de um usuário.
Baixe o Apidog e todo o fluxo funciona a partir de um único projeto.
FAQ
Posso rodar o DeepSeek-V4.1-Flash em um laptop? Não de forma útil. A arquitetura principal de 4 bits tem cerca de 280 GB. Um laptop pode transmiti-lo de um SSD, da mesma forma que o experimento Kimi K3, a cerca de 1 token por segundo, o que é uma demonstração, não um fluxo de trabalho. Use a API ou uma das opções em como usar o DeepSeek-V4.1-Flash gratuitamente.
8B parâmetros ativos significam que preciso apenas de 8 GB de VRAM? Não. Parâmetros ativos definem o cálculo por token, não a memória. O roteamento MoE pode escolher qualquer um dos 384 especialistas por camada para qualquer token, então todos os 552B parâmetros devem ser carregados e acessíveis.
De quanta memória o contexto de 1M precisa? Cerca de 0,89 GB de cache KV a 890 bytes por token. Essa é a parte barata deste modelo. Os pesos são a parte cara.
A licença é segura para uso comercial? Sim. Os pesos são MIT, conforme o cartão do modelo no Hugging Face.
Onde isso te deixa
O DeepSeek-V4.1-Flash é aberto da maneira que importa legal e tecnicamente: pesos MIT, um relatório técnico público e um design de cache KV que torna as sessões de 1M de tokens praticamente gratuitas em memória. Não é aberto da maneira que permite executá-lo na máquina debaixo da sua mesa. Para a maioria das equipes, a jogada certa é a API hospedada a $0,15 por 1M de tokens de entrada fora do pico, com a implantação local reservada para dados que não podem sair do edifício.
De qualquer forma, teste antes de confiar. Aponte o Apidog para ambos os endpoints, execute as mesmas requisições salvas e deixe que as asserções informem se sua construção local corresponde à referência.