
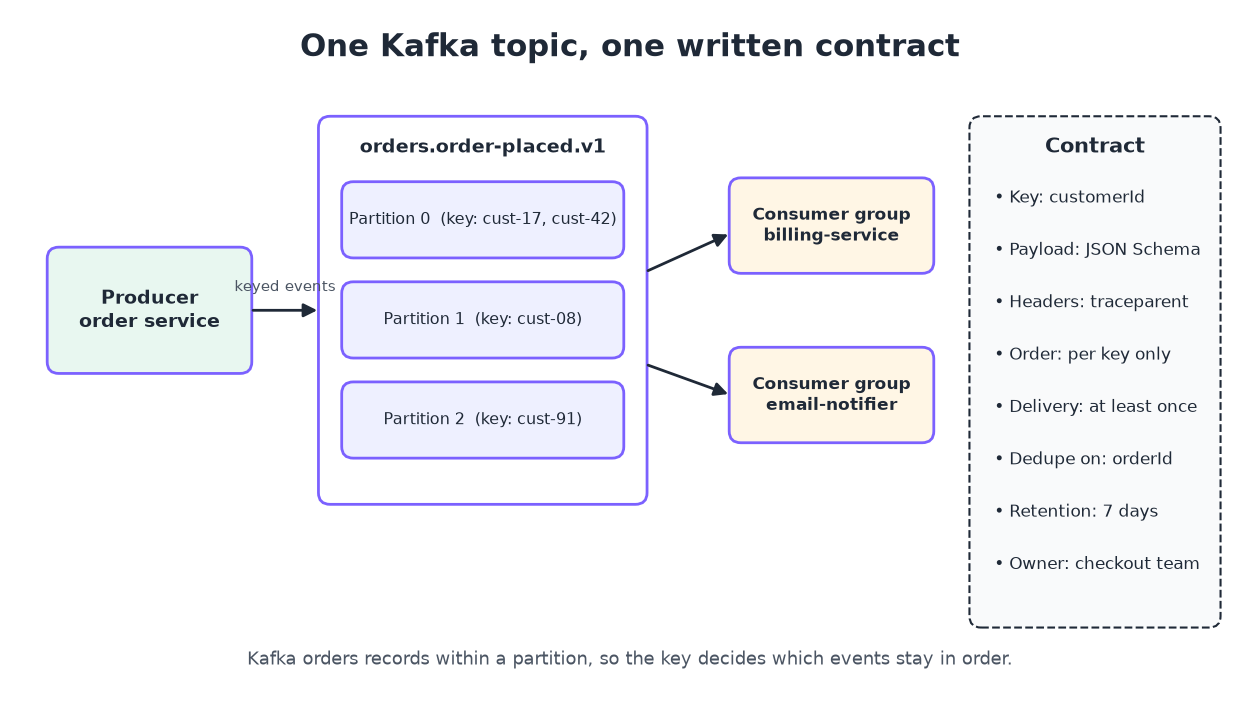
Para documentar APIs Kafka, escreva um contrato para cada tópico. Ele deve indicar o nome do tópico, a chave do evento, o schema do payload, os headers, as garantias de ordenação e entrega, os grupos de consumidores, o período de retenção e o responsável. Depois, guarde esse contrato junto com a documentação das suas APIs HTTP, para que produtores e consumidores leiam uma única fonte da verdade em vez de fazer engenharia reversa das mensagens em um cluster ativo.
Este guia aborda cada parte desse contrato, como escrevê-lo em AsyncAPI, como evoluir schemas com segurança e como deixar seu agente de codificação fazer o trabalho com o Apidog CLI.
Se você é novo em design orientado a eventos, comece com como construir APIs orientadas a eventos e o guia de webhooks e arquitetura orientada a eventos.
O que é uma API Kafka?
Uma API Kafka é o conjunto de tópicos, formatos de mensagem e regras de entrega que os serviços usam para trocar eventos por meio de um cluster Apache Kafka. Diferentemente de uma API REST, ninguém chama um endpoint e espera uma resposta. Os produtores gravam registros em tópicos, os consumidores os leem no seu próprio ritmo, e o contrato vive na estrutura e no significado desses registros.
A documentação do Kafka diz com clareza: “um evento tem uma chave, um valor, um timestamp e headers de metadados opcionais”. O próprio Kafka não verifica o que está dentro do valor. Um produtor pode gravar JSON em um dia e um formato JSON diferente no dia seguinte, e o broker aceitará ambos. É por isso que APIs Kafka precisam de contratos escritos mais do que APIs HTTP: nada na camada de transporte impede uma mudança que quebra a compatibilidade.
Tópicos sem documentação falham de formas previsíveis: um consumidor infere o tipo de um campo a partir de uma amostra e quebra com null, ou um novo serviço não sabe que recebe cada mensagem pelo menos uma vez e cobra duas vezes em caso de retentativas.
O que documentar para cada tópico Kafka
Todo tópico precisa das mesmas informações essenciais. Use esta tabela como checklist:
| Campo do contrato | O que registrar | Exemplo |
|---|---|---|
| Nome do tópico | Nome completo e convenção de nomenclatura | orders.order-placed.v1 |
| Finalidade | Uma frase sobre o que o evento significa | “Um pedido passou pelo pagamento e está pronto para envio” |
| Chave do evento | Qual campo é a chave e por quê | customerId, para que os pedidos de um cliente mantenham a ordem |
| Schema do payload | Todos os campos, tipos, obrigatoriedade e formato | JSON Schema, Avro ou Protobuf |
| Headers | Nome, tipo e significado de cada header | traceparent, schema-version |
| Partições e ordenação | Número de partições e a garantia de ordenação | 12 partições, ordenado por customerId |
| Semântica de entrega | Pelo menos uma vez, produtor idempotente, transações | Pelo menos uma vez; consumidores devem deduplicar por orderId |
| Grupos de consumidores | Grupos conhecidos e o que cada um faz | billing-service, email-notifier |
| Retenção | Por quanto tempo os registros permanecem legíveis | 7 dias |
| Propriedade | Time responsável, contato e política de versões | Time de Checkout, #checkout-events |
As linhas de ordenação e entrega são as mais importantes: os leitores não conseguem inferi-las a partir de uma mensagem de exemplo.
Como documentar APIs Kafka em 6 passos
- Liste todos os tópicos e seus responsáveis. Obtenha a lista de tópicos do seu cluster e registre quem produz para cada um.
- Defina a chave. Escreva qual campo é a chave e o que isso significa para a ordenação.
- Escreva o schema do payload. Descreva cada campo com JSON Schema, Avro ou Protobuf.
- Descreva os headers e metadados. Inclua os headers de tracing, versão do schema e tipo de conteúdo.
- Declare as garantias. Documente a semântica de entrega, o escopo de ordenação, a retenção e os grupos de consumidores.
- Publique onde as pessoas procuram. Coloque o contrato junto com a documentação das suas APIs HTTP e versione-o como código.
Passos 1 e 2: tópicos e chaves
Um padrão de nomenclatura como <domain>.<event>.<version> indica aos leitores quem é o responsável pelo tópico e qual versão estão lendo. Em seguida, documente a chave, porque ela define a partição. A documentação do Kafka afirma que “eventos com a mesma chave de evento (por exemplo, um ID de cliente ou veículo) são gravados na mesma partição”, e que os consumidores leem os eventos de uma partição “exatamente na mesma ordem em que foram gravados”.
Portanto, seu contrato deve dizer “ordenado por customerId”, e não apenas “ordenado”. O Kafka só promete ordem dentro de uma partição, nunca em um tópico inteiro.
Passo 3: o schema do payload
O payload é a parte com a qual os consumidores programam, então descreva-o campo por campo. Aqui está um JSON Schema para um evento order-placed:
{
  "type": "object",
  "required": ["orderId", "customerId", "totalCents", "currency", "placedAt"],
  "properties": {
    "orderId": { "type": "string", "description": "Unique order ID; use it to deduplicate" },
    "customerId": { "type": "string", "description": "Also the record key" },
    "totalCents": { "type": "integer", "minimum": 0 },
    "currency": { "type": "string", "enum": ["USD", "EUR", "GBP"] },
    "placedAt": { "type": "string", "format": "date-time" },
    "couponCode": { "type": ["string", "null"] }
  }
}
A descrição “use it to deduplicate” (use-o para deduplicar) diz ao consumidor o que fazer com o campo, não apenas seu tipo. Novato no formato? Leia o que é JSON Schema.
Passos 4 e 5: headers e garantias
Liste cada header (contexto de tracing, versão do schema, tipo de conteúdo) e diga se os consumidores podem contar com ele. Em seguida, registre a garantia de entrega, nos termos do próprio Kafka. A documentação de design do Kafka afirma que “o Kafka garante entrega at-least-once por padrão”, o que significa que as mensagens “nunca são perdidas, mas podem ser reentregues”. Se o seu produtor usa a opção idempotente ou transações, diga isso. Se não usa, instrua os consumidores a deduplicar e indique o campo a ser usado na deduplicação.
Documente também os grupos de consumidores. Dentro de cada grupo inscrito, uma partição “é consumida por exatamente um consumidor” por vez. Isso indica aos leitores até onde um grupo pode escalar: um consumidor ativo por partição.
Escreva o contrato em AsyncAPI
Ferramentas precisam de um formato legível por máquina, e para Kafka isso geralmente é o AsyncAPI, uma especificação “usada para descrever APIs orientadas a mensagens em um formato legível por máquina”. Ela desempenha o papel que o OpenAPI desempenha para REST.
Um documento AsyncAPI 3.0 tem info, servers, channels, operations e components. Um canal mapeia para um tópico por meio do seu address, e cada operação tem uma action do tipo send ou receive:
asyncapi: 3.0.0
info:
  title: Orders events
  version: 1.0.0
channels:
  orderPlaced:
    address: orders.order-placed.v1
    messages:
      orderPlaced:
        $ref: '#/components/messages/orderPlaced'
operations:
  publishOrderPlaced:
    action: send
    channel:
      $ref: '#/channels/orderPlaced'
components:
  messages:
    orderPlaced:
      payload:
        $ref: './schemas/order-placed.json'
O AsyncAPI também tem bindings específicos do Kafka nos níveis de servidor, canal, operação e mensagem. É onde ficam os detalhes específicos do Kafka, aqueles que os campos genéricos não conseguem expressar. Mantenha a especificação no repositório do produtor, para que o pull request que altera um evento também altere seu contrato.
Evolução de schemas no Kafka: documente a regra de compatibilidade
Seu schema vai mudar. O contrato deve indicar quais mudanças são seguras. Se você usa um schema registry, documente o modo de compatibilidade dele. A documentação de evolução de schemas da Confluent lista esses modos e observa que “o tipo de compatibilidade padrão do Confluent Schema Registry é BACKWARD”:
| Modo | Quem pode ler o quê |
|---|---|
| BACKWARD | Consumidores com o novo schema podem ler dados gravados com o schema anterior |
| BACKWARD_TRANSITIVE | Consumidores com o novo schema podem ler dados de todos os schemas anteriores |
| FORWARD | Consumidores com o schema anterior podem ler dados gravados com o novo schema |
| FORWARD_TRANSITIVE | Consumidores com qualquer schema anterior podem ler dados gravados com o novo schema |
| FULL | Compatível com o schema anterior nas direções backward e forward |
| FULL_TRANSITIVE | Compatível com todos os schemas anteriores nas direções backward e forward |
| NONE | As verificações de compatibilidade estão desativadas |
Na prática, com BACKWARD você pode adicionar campos opcionais e remover campos que tinham valores padrão. Renomear um campo obrigatório ou alterar seu tipo quebra os consumidores. Quando precisar de uma mudança incompatível, publique uma nova versão do tópico (orders.order-placed.v2), documente ambas e defina uma data de desativação para a antiga.
Deixe seu agente de codificação documentar APIs Kafka com o Apidog CLI
Contratos escritos à mão ficam desatualizados assim que alguém altera um produtor. Seu agente de codificação pode ler o código do produtor, escrever os schemas e manter a documentação sincronizada enquanto você revisa. O Apidog CLI dá ao Claude Code, Codex, Cursor ou qualquer agente de terminal os comandos para fazer isso em um projeto Apidog.
Instale o CLI, faça login e adicione a skill do Apidog para que seu agente conheça os comandos:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Você também pode delegar a configuração ao agente: peça para ele ler o guia de instalação do Apidog CLI e se configurar sozinho.
Depois, dê ao seu agente um único prompt:
Read the Kafka producers in ./services/orders. For every topic they write to,
create an Apidog data schema in project <projectId> for the message payload,
then create one Markdown doc per topic with the key, headers, ordering,
delivery guarantee, consumer groups, retention and owner. Validate every
payload before you write it.
O agente verifica a estrutura do payload, valida o arquivo e, em seguida, escreve o schema e a página do contrato:
apidog cli-schema get schema-create
apidog cli-schema validate schema-create --file order-placed.schema.json
apidog schema create --project <projectId> --file order-placed.schema.json
apidog cli-schema get doc-create
apidog doc create --project <projectId> --file order-placed.doc.json
apidog schema list --project <projectId>
O apidog schema create armazena o payload como um data schema reutilizável. Seus endpoints HTTP podem referenciar o mesmo modelo, de modo que um Order definido uma vez cubra tanto a resposta REST quanto o evento Kafka. O apidog doc create grava um documento Markdown na árvore do projeto, que contém o contrato do tópico da tabela acima. Quando um produtor mudar, execute o prompt novamente e o agente usará o apidog schema update. Para um passo a passo mais detalhado sobre documentação orientada por agentes, veja como documentar APIs pelo CLI e Apidog CLI no Claude Code.
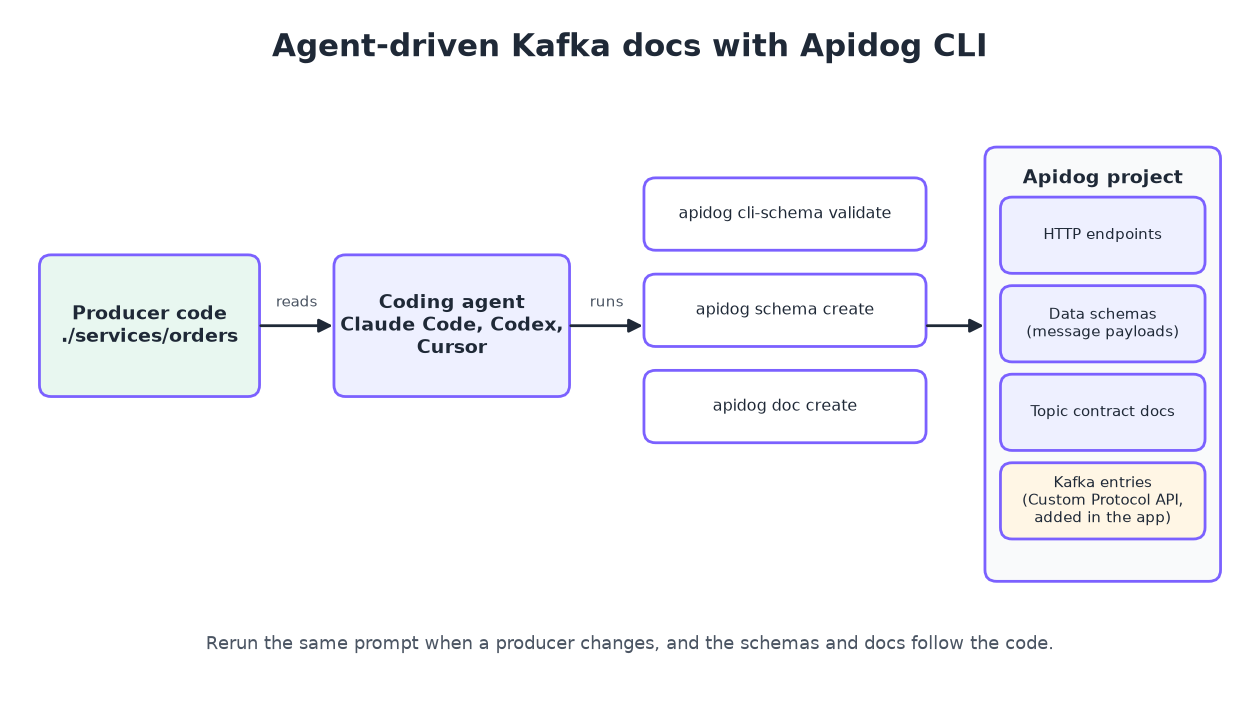
Uma etapa permanece no app. A Custom Protocol API do Apidog documenta endpoints Kafka junto com os HTTP: escolha New Other Protocol APIs, depois Other Custom Protocol API, selecione Kafka como protocolo e preencha o URI (o tópico), nome, status, responsáveis, tags e descrição. Essas entradas compartilham a árvore de pastas, a busca e o Quick Share com a sua documentação HTTP. O CLI ainda não tem um comando para endpoints de protocolo personalizado hoje, então esta é a única parte que você cria manualmente.
O Apidog Free cobre até 4 usuários, então uma equipe pequena pode manter sua documentação REST e Kafka em um único projeto sem custo.
FAQ
Existe um OpenAPI para Kafka?
O AsyncAPI preenche esse papel. Ele descreve servidores, canais (tópicos), operações e payloads de mensagens em YAML ou JSON, com bindings específicos para Kafka.
Preciso de um schema registry para documentar APIs Kafka?
Não, mas ajuda. A documentação estabelece as regras; um registry as aplica no momento da escrita. Se você usa um, documente o modo de compatibilidade dele.
Qual é a diferença entre documentar um tópico Kafka e um endpoint REST?
Uma documentação REST descreve uma requisição e uma resposta. Uma documentação Kafka descreve uma mensagem que muitos consumidores lerão depois, por isso também precisa da chave, do escopo de ordenação, da garantia de entrega, da retenção e dos grupos de consumidores. Nada disso aparece em uma documentação REST típica.
O Apidog pode testar mensagens Kafka?
O Apidog documenta endpoints Kafka por meio da Custom Protocol API, mas não envia nem consome mensagens Kafka. Use-o para manter o contrato e os schemas de payload, e teste o código do produtor e do consumidor com a sua biblioteca cliente Kafka.
Com que frequência devo atualizar a documentação Kafka?
Toda vez que um produtor alterar uma mensagem. Vincule isso à revisão de código: o pull request que altera o evento atualiza o contrato, ou seu agente o regenera com o Apidog CLI.