
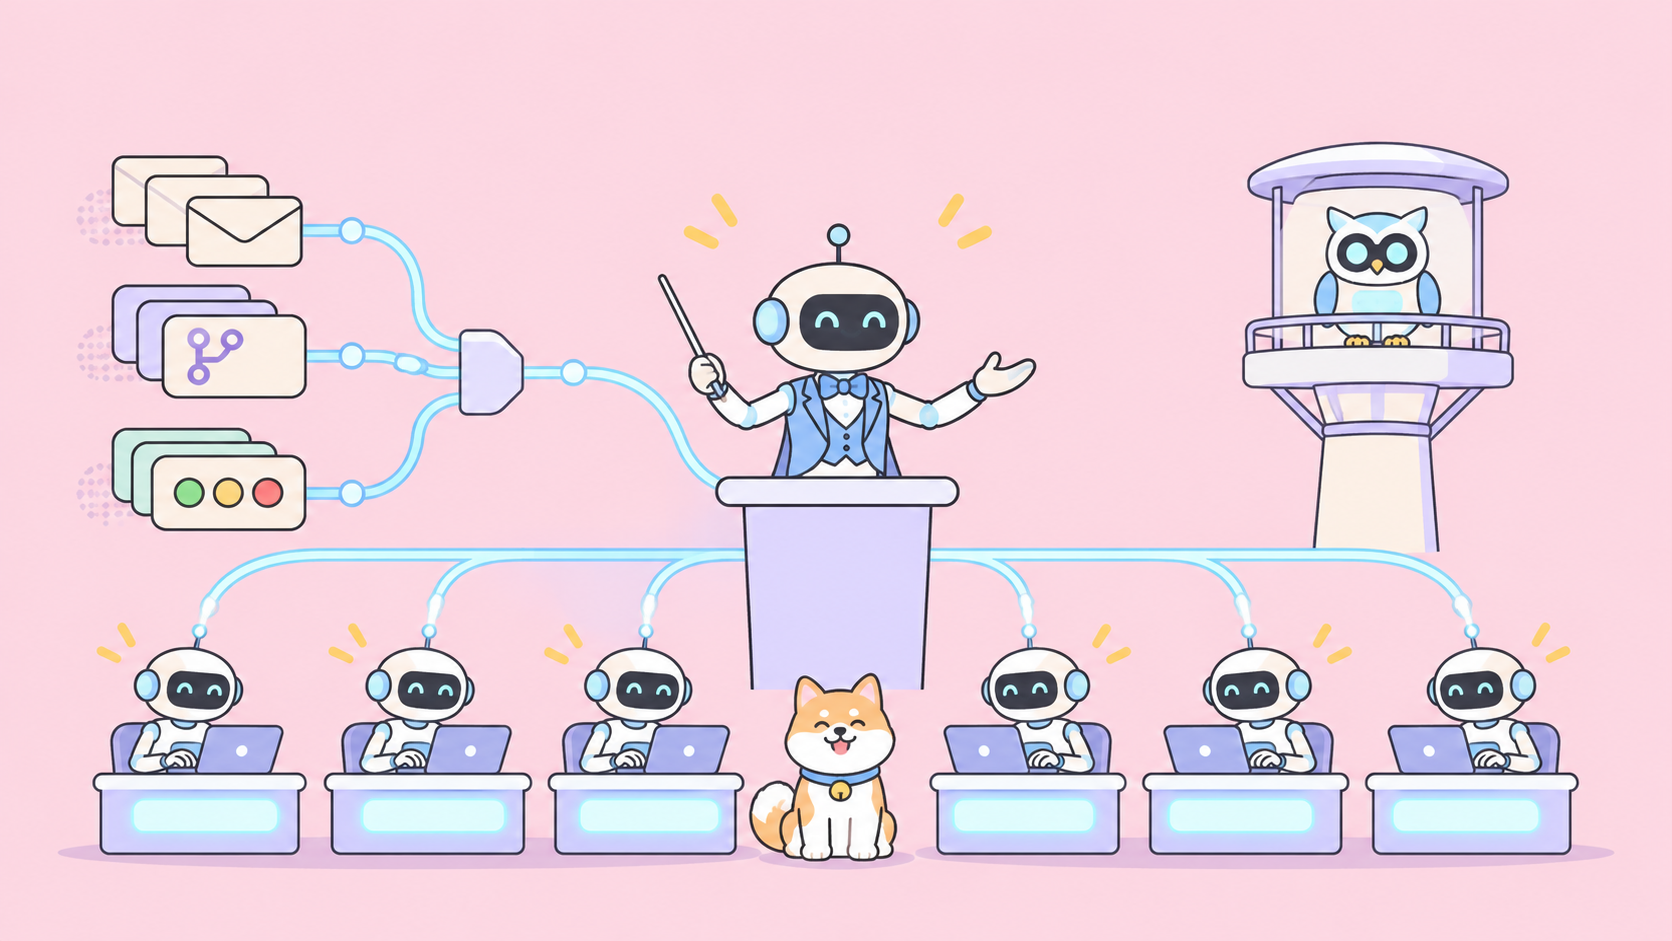
Para construir um superagente como o descrito pelo DeepSeek Harness, divida seu agente em duas camadas: uma sessão de longa duração do Router, que interage com humanos e despacha tarefas, e várias sessões isoladas de Workers, cada uma executando uma única tarefa com acesso completo a ferramentas. Alimente ambas com Triggers de eventos (chat, GitHub, CI), encaminhe os desdobramentos por Thread e adicione um Watchdog independente para monitorar tudo.
Este guia transforma o artigo conceitual do DeepSeek Harness, “Exploring Super-agent Design”, em um roteiro prático de implementação. Um aviso importante: o artigo descreve uma arquitetura, e não um recurso já lançado. Partes dele existem em um plugin de protótipo chamado dsh-superagent-prototype, que os próprios autores afirmam ser “um produto não oficial da DeepSeek”. Todos os trechos de código abaixo são puramente ilustrativos, e não o código real da DeepSeek.
O que é um superagente?
Um superagente é um colega de equipe de IA único e sempre online, capaz de receber eventos de múltiplos canais (chat, pull requests, CI), executar diversas tarefas em paralelo em sessões isoladas e responder às pessoas mantendo uma identidade consistente.
O problema: as sessões dos agentes são isoladas e “uma pessoa normalmente só consegue acompanhar de 3 a 5 sessões ativas ao mesmo tempo”. Uma única tarefa é limitada pela capacidade do modelo. Já a execução multitarefa é limitada pela atenção humana. O superagente busca resolver justamente esse segundo gargalo.
Ele possui quatro características principais:
- Contínuo: um único agente atuando tanto em apps de mensagens instantâneas quanto no GitHub. Você discute o Plano A no chat, muda para o Plano B em um comentário de PR e ele acompanha o contexto sem se perder.
- Produtivo: ele executa tarefas em paralelo e já aceita sua próxima instrução antes mesmo de concluir a anterior.
- Proativo: ele monitora eventos e permanece em silêncio, a menos que sua intervenção seja necessária.
- Persistente: fica sempre online e se recupera sozinho em caso de falhas.
Se você ainda não conhece o framework em si, comece descobrindo o que é o DeepSeek Harness e veja como ele se compara ao Claude Code.
Arquitetura do superagente: os cinco módulos
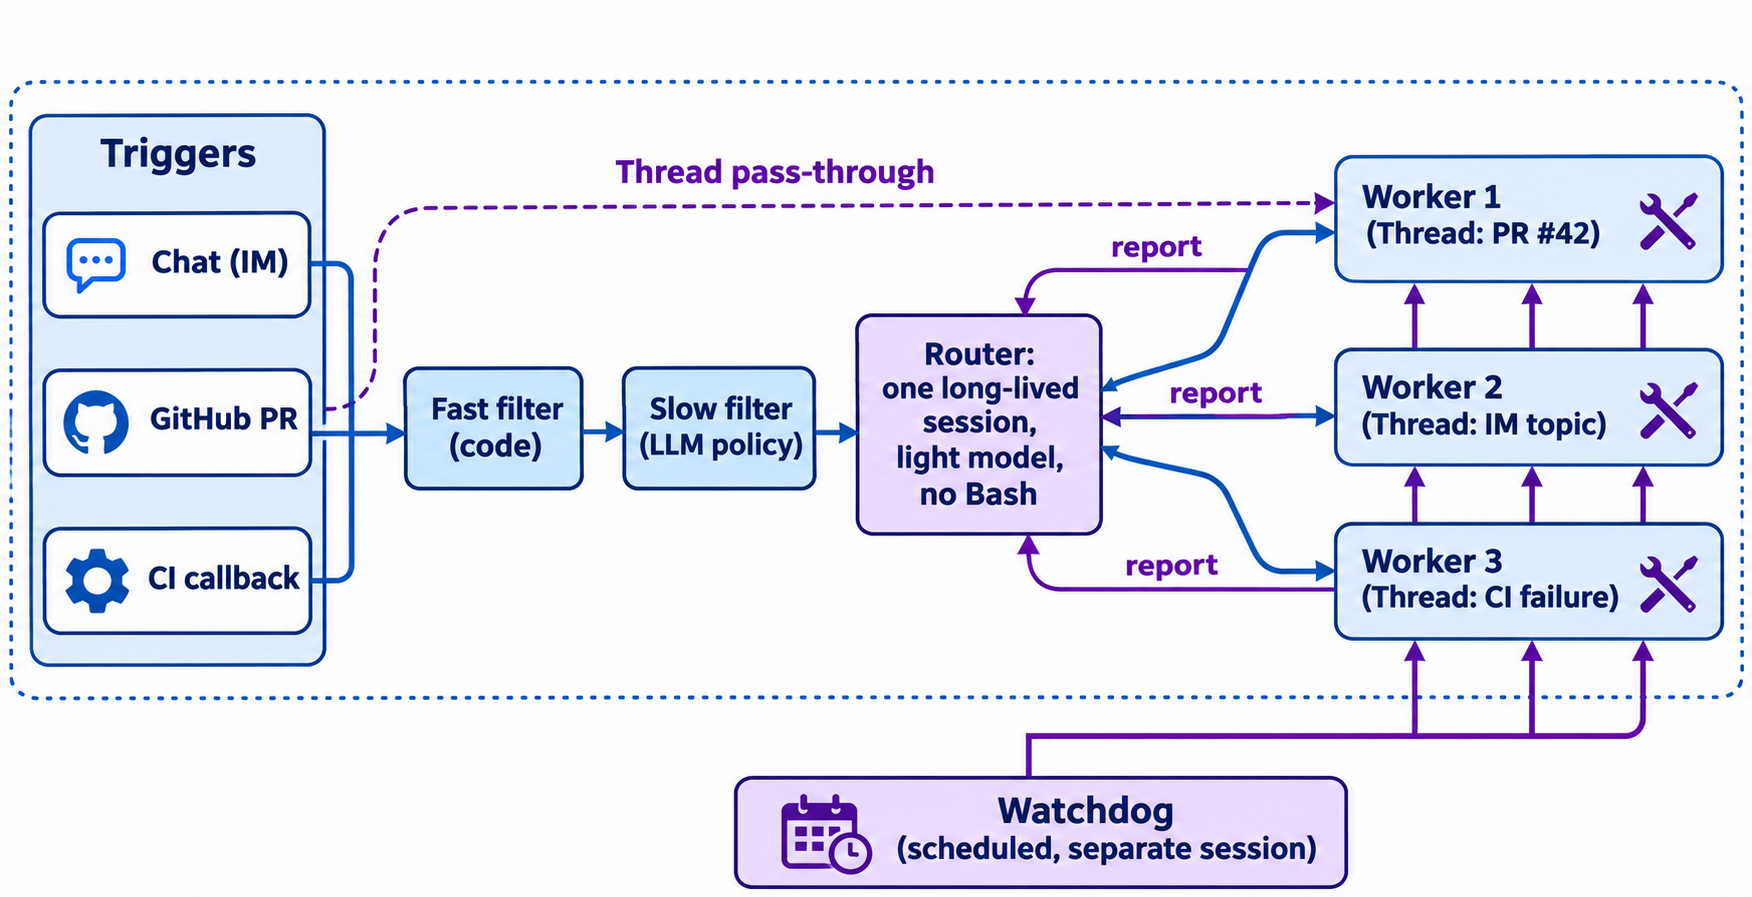
O artigo apresenta cinco módulos. Veja a seguir o que cada um faz e a etapa correspondente para construí-los:
| Módulo | O que faz | Etapa de construção |
|---|---|---|
| Arquitetura de dois níveis | O Router despacha, os Workers executam | 1 |
| Triggers orientados a eventos | Transformam eventos de chat, GitHub e CI em entradas para o agente | 2 |
| Full-duplex multicanal | Ferramentas assíncronas e respostas adaptadas ao canal | 4 |
| Separação de computação, estado e ambiente | Loop sem estado, estado em banco de dados e máquinas locais preservadas | 5 |
| Watchdog | Sessão independente que monitora o progresso e verifica erros | 6 |
Etapa 1: Separe o Router dos Workers
O Router é uma sessão única e de longa duração. Ele gerencia toda a interação com humanos e o despacho de tarefas, sem nunca executá-las diretamente. Ele pode operar sem ferramentas como o Bash, sendo suficiente utilizar um modelo mais leve e econômico. Quando múltiplos Triggers chegam durante um único ciclo do Router, eles são agrupados em lote para a próxima chamada: entrada longa, saída curta e mesclados na etapa de prefill.
Cada Worker é uma sessão isolada dedicada a uma única tarefa. Ele tem acesso completo a ferramentas e ao modelo mais potente que o seu orçamento permitir. O Worker nunca se comunica diretamente com humanos; ele sempre se reporta ao Router. Um Worker pode, inclusive, acionar subagentes ou funcionar como uma equipe inteira de agentes.
Não confunda essa estrutura com uma equipe de agentes (agent team). O líder de uma equipe decompõe uma tarefa interligada em partes; já o Router apenas despacha tarefas independentes. É possível, inclusive, combinar ambas as abordagens.
# Illustrative sketch, not DeepSeek's code
class Router:
    def on_events(self, batch):              # triggers arriving mid-turn are batched
        plan = self.llm_light.decide(batch)  # dispatch, reply, or ignore
        for task in plan.new_tasks:
            Worker.spawn(task, model="strongest", tools="all", report_to=self)
        for msg in plan.replies:
            self.channels.send(msg)          # only the Router speaks to humans
Etapa 2: Transforme eventos em Triggers
Toda entrada em um superagente é um Trigger: uma mensagem de chat, um evento de webhook do GitHub, uma carga útil da Slack Events API ou um callback de CI. A grande maioria desses eventos nem sequer deveria chegar a um modelo; por isso, o artigo propõe uma filtragem em duas etapas.
- Caminho rápido (via código). Filtra por origem, grupo e listas de permissão de usuários ou bots. Cada origem recebe um modo de operação: “responder apenas a solicitações explícitas”, “candidato” ou “ignorar”.
- Caminho lento (via LLM). Os eventos candidatos são enviados a um modelo que aplica diretrizes definidas via prompts, como “responder quando alguém relatar um bug neste canal”.
Seu endpoint de entrada deve confirmar o recebimento rapidamente e processar depois. As boas práticas para webhooks do GitHub exigem uma resposta com status 2XX em até 10 segundos — algo que uma chamada a um modelo não pode garantir. Retorne 202 Accepted, enfileire o Trigger e deixe o Router processá-lo. Nosso guia sobre como projetar webhooks confiáveis aborda tentativas de repetição (retries) e idempotência para essa camada.
Etapa 3: Encaminhe desdobramentos por Thread
Uma Thread é uma sequência de eventos consecutivos em um mesmo PR, tópico de chat ou encadeamento de e-mails. O Worker criado para o primeiro evento de uma Thread se inscreve nela. Com isso, os eventos seguintes são encaminhados diretamente a esse Worker, sem passar pelo Router.
O mapeamento é de muitos para muitos. Se dois Workers atuarem no mesmo PR, ambos recebem seus eventos e podem resolver conflitos por meio do próprio PR, sem precisar trocar mensagens diretamente entre si.
Ignorar essa etapa tem um custo alto: no experimento do artigo, a remoção desse repasse direto (pass-through) fez o Router tomar cerca de 30% mais decisões e aumentou o consumo de tokens em aproximadamente 37%.
Etapa 4: Trate o contexto como cache e torne as ferramentas assíncronas
Como o Router não consegue reter tudo, o artigo propõe tratar o contexto como um cache:
- Inclua diretamente (inline) o que for mais provável de ser necessário: IDs, resumos curtos e mensagens adjacentes.
- Transborde (spill) o restante: trunque o conteúdo e deixe um ponteiro que o agente possa consultar quando necessário.
IDs estáveis atribuídos a Triggers, Threads e Workers formam um grafo de referências que os autores chamam de “Chain of Recall” (Cadeia de Recordação). O agente navega de um Trigger para sua Thread e desta para o Worker responsável, garantindo uma recuperação de contexto em múltiplos saltos sem a necessidade de um prompt gigantesco.
Em seguida, adote a comunicação full-duplex. Substitua uma ferramenta bloqueante do tipo run() pelas operações assíncronas start() e stop(). O comando start() retorna “Started” imediatamente, e o resultado chega posteriormente na forma de um novo evento. É isso que permite ao agente receber sua próxima instrução enquanto a anterior ainda está em execução. O artigo menciona que o DeepSeek Harness implementa esse comportamento, mas não o mantém ativado por padrão.
Por fim, torne as respostas sensíveis ao canal. A regra testada pelos autores limita as respostas em aplicativos de mensagens instantâneas a 100 palavras, enquanto o GitHub, e-mails e documentações recebem relatórios estruturados e detalhados.
Essa abordagem também viabiliza a execução especulativa: no grupo de testes dos autores, uma diretriz de “reproduzir e corrigir silenciosamente” só entrega a alteração se uma correção simples for confirmada; caso contrário, o agente permanece em silêncio.
Etapa 5: Separe computação, estado e ambientes
Execute o loop do agente em contêineres sem estado (stateless) na nuvem e mantenha o estado da sessão em um banco de dados. Os ambientes permanecem onde estão: cada máquina executa um daemon leve, modelo que o artigo chama de BYOM (Bring Your Own Machine). Se um loop falhar, ele pode ser reiniciado em qualquer lugar e recarregar seu estado, enquanto os repositórios continuam nas máquinas locais.
O artigo cita o texto da Anthropic, “Scaling Managed Agents: Decoupling the brain from the hands”, como uma proposta com a mesma ideia, voltada para sandboxes gerenciadas em vez de máquinas próprias.
Etapa 6: Adicione um Watchdog
O Watchdog é uma sessão independente com execução agendada, situada fora do sistema principal. Ele lida com erros de API e consulta um modelo para avaliar se cada Worker está progredindo ou se desviando do objetivo. Os mantenedores também podem perguntar diretamente a ele por que algo falhou. Mantenha-o fora do processo do Router para evitar que um travamento no Router derrube também o seu monitor.
O que os experimentos demonstraram
Os autores processaram cerca de 300 mensagens de chat e CI contendo por volta de 20 solicitações de trabalho, simularam o processo de codificação com um temporizador e executaram cada configuração 5 vezes. Eles destacam que os resultados são “apenas indicativos”.
| Configuração | p50 (min) | p95 (min) | Tokens lidos do cache por execução |
|---|---|---|---|
| Superagente | 12.4 | 15.7 | 23.2M |
| Sem repasse por Thread (Thread pass-through) | 12.6 | 15.5 | 31.8M |
| Sessão única + ferramenta de subagente, prompt neutro | 20.4 | 29.5 | 6.1M |
| Sessão única, prompt focado em delegação | 13.8 | 29.0 | 10.8M |
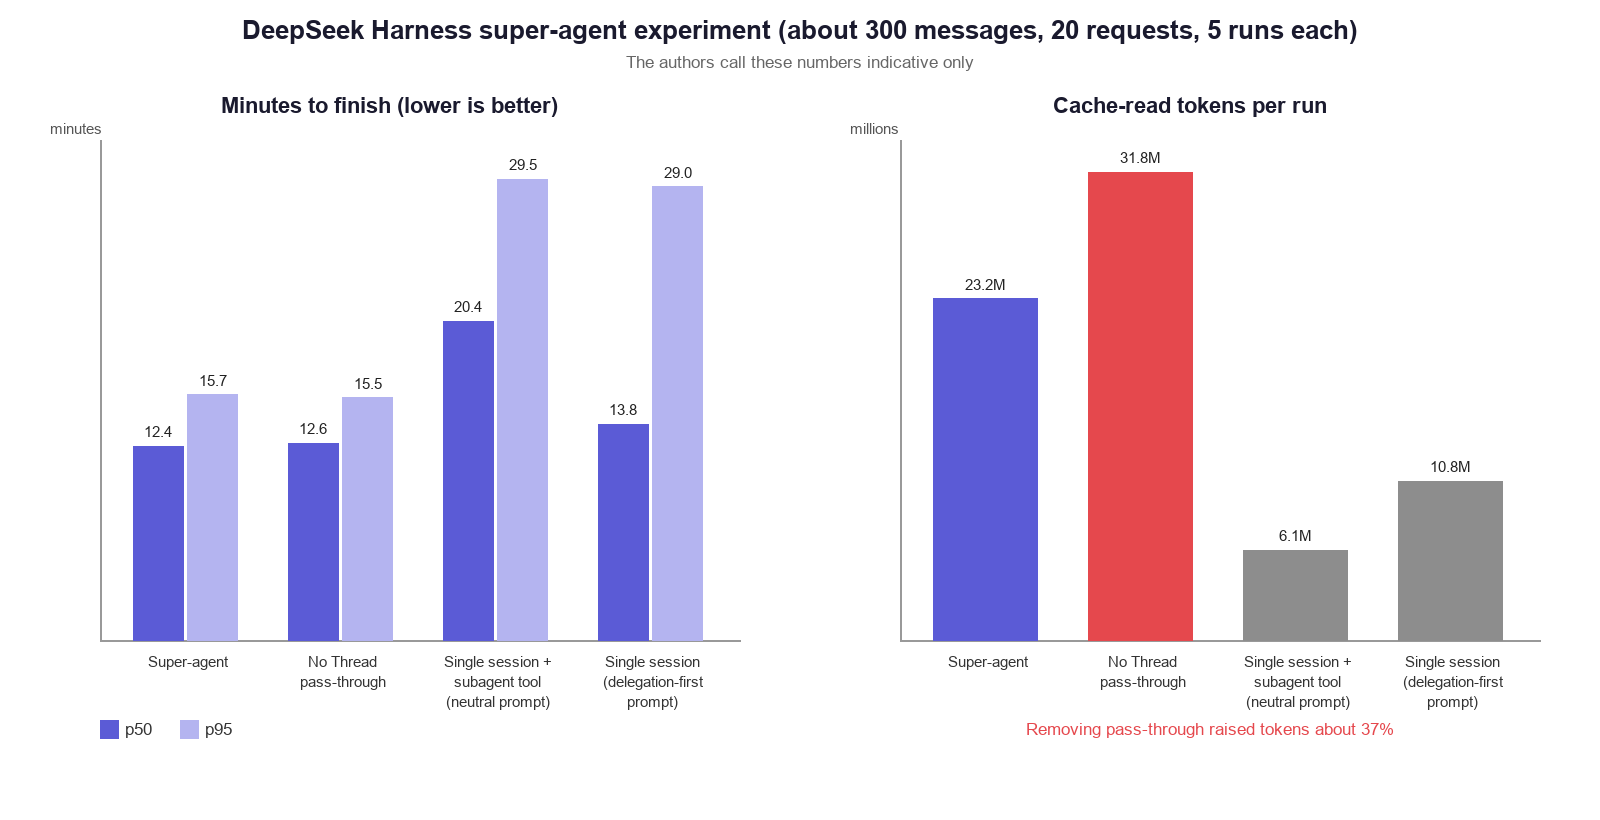
Duas conclusões se destacam. Com um prompt neutro, a sessão única não delegou tarefas nenhuma vez nas 5 execuções, fazendo com que seu p95 fosse quase o dobro do obtido pelo superagente. Já um prompt focado em delegação corrigiu a mediana, mas não a cauda longa. O superagente consome mais tokens do que uma sessão única; portanto, você troca tokens por menor latência e economia de atenção humana.
Um segundo teste submeteu apenas o Router a estresse. À medida que os Triggers aumentavam de 1 para 40 por minuto, o tamanho do lote passou de 1,0 para 2,8 e o tempo por solicitação subiu de 2,5 s para 3,9 s, enquanto o tempo por decisão caiu de 6,4 s para 1,6 s. O agrupamento em lote (batching) é o que impede que um único Router se torne um gargalo precocemente.
Teste a ingestão de Triggers com o Apidog CLI
Todo Trigger começa sua vida útil como uma requisição HTTP enviada ao seu endpoint de ingestão; logo, esse endpoint é a primeira coisa que vale a pena testar. Se ele descartar o comentário de um PR ou atribuir um novo thread_id a cada evento, o roteamento por Thread se romperá e todos os desdobramentos terão que passar novamente pelo Router. Permita que seu agente de programação escreva e execute esse teste usando o Apidog CLI.
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Em seguida, passe um único prompt para o seu agente:
In Apidog project <id>, create POST /triggers/github for a GitHub
pull_request_review_comment webhook. Add a test case that sends two
comments on the same PR and asserts: status 202, a trigger_id in the
body, and the same thread_id both times. Run it against staging and
summarize any failures.
O agente lê o schema de cada payload, valida seu JSON, cria o endpoint e o caso de teste, e executa a validação:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <id> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <stagingEnvId> -r cli,json
A mesma chamada do comando apidog run com -r junit se integra perfeitamente ao seu pipeline; confira Apidog CLI no CI/CD. Se o seu agente for o próprio DeepSeek Harness, siga este guia de configuração; para o Claude Code, utilize este aqui. O plano gratuito do Apidog atende até 4 usuários.
Problemas em aberto
O artigo lista o que ainda não foi solucionado:
- Escalabilidade do Router e escolha da topologia de Workers conforme a carga aumenta.
- Memória de longo prazo além da Chain of Recall.
- UX sem sessões: direcionar um agente sem uma janela de chat exclusiva.
- Limites de contexto e protocolos agente-a-agente, sendo o A2A um dos candidatos.
- Segurança. Uma injeção de prompt que atinja o loop na nuvem pode alcançar todas as máquinas conectadas, além do risco de vazamento de credenciais presentes no contexto. O objetivo dos autores é que os agentes usem credenciais sem nunca ter acesso direto a elas.
Perguntas Frequentes (FAQ)
O superagente é um recurso do DeepSeek Harness que posso simplesmente ativar? Não. O artigo descreve uma arquitetura. Partes dela existem no plugin dsh-superagent-prototype, que os autores destacam não ser um produto oficial da DeepSeek. As ferramentas full-duplex estão implementadas, mas vêm desativadas por padrão.
Por que o Router usa um modelo mais leve? Ele apenas faz despachos e conversa com pessoas; nunca executa tarefas nem precisa de Bash. Os Workers é que realizam o raciocínio mais complexo com o modelo mais potente.
Qual a diferença entre um superagente e uma equipe de agentes? O líder de uma equipe divide uma única tarefa interdependente em partes. O Router despacha tarefas independentes. Além disso, um Worker pode executar sua própria equipe de agentes dentro do superagente.
O que é o repasse por Thread (Thread pass-through)? Eventos de desdobramento em um PR, tópico de chat ou encadeamento de e-mails vão direto para o Worker responsável por essa Thread, pul... [truncated 795 chars]