
O Groq dá a cada conta uma chave do Plano Gratuito para seu endpoint compatível com OpenAI, e essa chave funciona no momento em que você se cadastra. O que costuma complicar as pessoas não é conseguir acesso, mas permanecer dentro dos limites quando seu aplicativo realmente está chamando o modelo. O Groq publica números do Plano Gratuito por modelo em sua documentação, mas esses números mudam e sua própria conta pode ser diferente. O hábito confiável é verificar as configurações da sua conta e, em seguida, ler os cabeçalhos de resposta em cada chamada, já que os limites podem mudar no meio da sessão.
Este guia aborda como obter uma chave, apontar um cliente OpenAI padrão para o endpoint do Groq e a parte que a maioria dos posts sobre "nível gratuito" pula: acompanhar seus limites em tempo real em vez de descobri-los por meio de um erro 429 em produção. Depois, seu agente de codificação transforma essa verificação em um teste de CLI do Apidog, para que seja repetível, e não um comando curl avulso que você esquece.
TL;DR
O Groq opera dois níveis: Plano Gratuito e Plano Desenvolvedor. Os limites de taxa se aplicam no nível da organização (não por usuário), você bate no primeiro limite que vier entre requisições, tokens ou totais diários, e tokens em cache não contam contra você. O Groq publica números do Plano Gratuito por modelo, mas os números que se aplicam à sua conta ficam na página de limites do seu console, então a atitude confiável é lê-los a partir dos cabeçalhos de resposta x-ratelimit-* em cada chamada, em vez de confiar em uma tabela que pode mudar sem aviso.
Obtendo uma chave e chamando o endpoint
Crie uma conta em console.groq.com e gere uma chave na página de chaves. O Groq expõe essa chave por meio de uma API compatível com OpenAI, então se você já chamou o SDK da OpenAI antes, você já conhece o formato. Aponte a URL base para o Groq em vez da OpenAI e mantenha todo o resto igual:
curl https://api.groq.com/openai/v1/chat/completions \
  -H "Authorization: Bearer $GROQ_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "llama-3.1-8b-instant",
    "messages": [{"role": "user", "content": "Summarize this ticket in one sentence."}]
  }'
Ou com o cliente Python oficial da OpenAI:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["GROQ_API_KEY"],
    base_url="https://api.groq.com/openai/v1",
)

response = client.chat.completions.create(
    model="llama-3.3-70b-versatile",
    messages=[{"role": "user", "content": "List three causes of API timeout errors."}],
)

print(response.choices[0].message.content)
A documentação de compatibilidade com OpenAI do Groq observa algumas lacunas que vale a pena conhecer antes de copiar código existente: logprobs, logit_bias, top_logprobs e messages[].name retornam todos um erro 400, n precisa ser igual a 1 se você defini-lo, e uma temperatura de 0 é convertida em um pequeno float positivo em vez de uma decodificação gulosa verdadeira.
Plano Gratuito vs Plano Desenvolvedor
As próprias palavras do Groq são diretas: "Upgrade to Developer plan to access higher limits, Batch and Flex processing, and more." O Plano Gratuito é onde toda chave nova começa, e é genuinamente utilizável para testes e pequenos projetos paralelos.
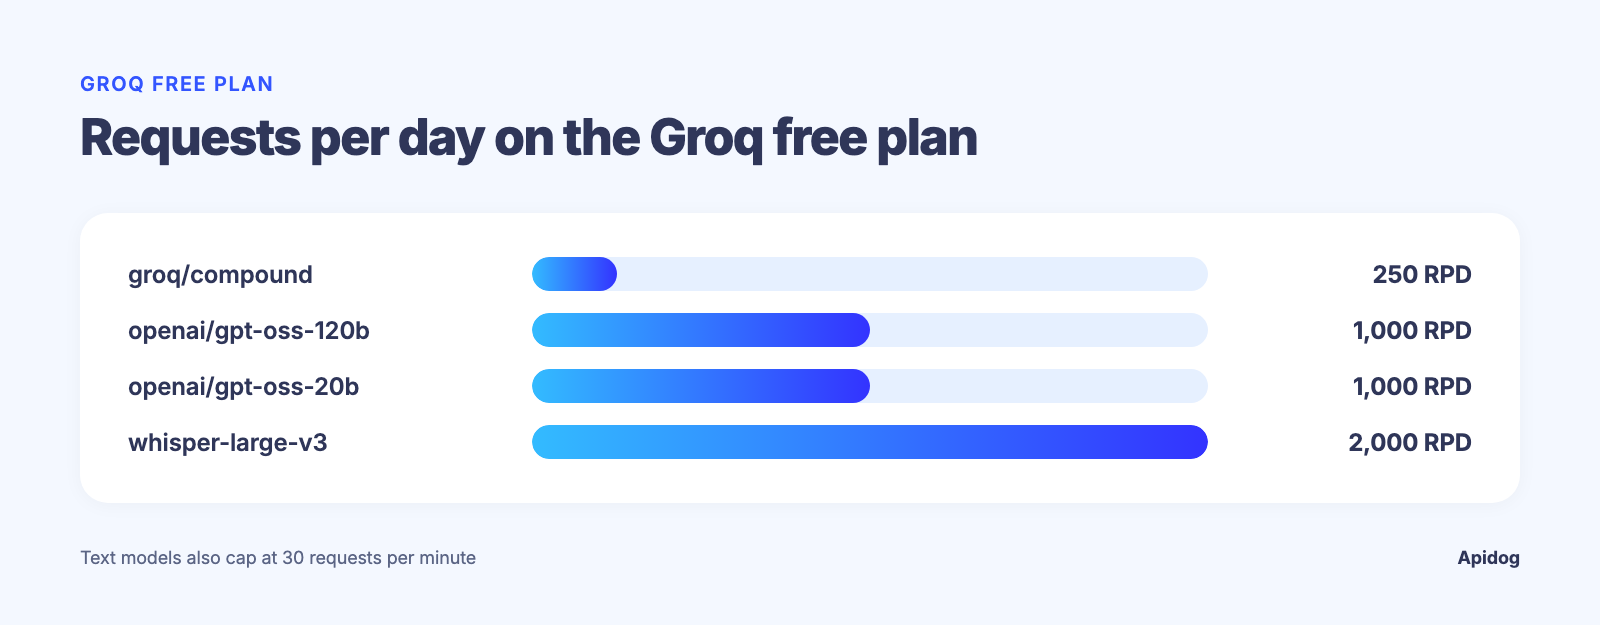
Aqui está o que o Plano Gratuito permite para alguns modelos, segundo a documentação de limites de taxa do Groq conforme lida em 2026-09-15:
| Model | RPM | RPD | TPM | TPD | Audio |
|---|---|---|---|---|---|
groq/compound |
30 | 250 | 70K | - | - |
openai/gpt-oss-120b |
30 | 1K | 8K | 200K | - |
openai/gpt-oss-20b |
30 | 1K | 8K | 200K | - |
whisper-large-v3 |
20 | 2K | - | - | 7.2K ASH / 28.8K ASD |
Essa mesma página tem uma aba do Plano Desenvolvedor com tetos mais altos para cada modelo, além de processamento Batch e Flex. Trate a tabela acima como um instantâneo, já que o Groq pode alterar esses números sem aviso. Seus próprios números ficam na página de limites nas configurações da sua conta: confie nessa página em vez desta, se elas discordarem.
Dois detalhes de política importam mais do que os números brutos. Os limites de taxa se aplicam "no nível da organização, não a usuários individuais", então cinco pessoas compartilhando uma mesma organização do Groq compartilham um limite, não cinco separados. E "tokens em cache não contam para seus limites de taxa", o que significa que uma estrutura de prompt bem armazenada em cache lhe rende mais throughput real do que o número destacado sugere.
Modelos que vale a pena conhecer antes de atingir um limite
O limite que importa depende de qual modelo você chama. Os modelos de texto e os sistemas Compound do Groq rodam com uma janela de contexto de 131.072 tokens:
| Model ID | Type |
|---|---|
llama-3.1-8b-instant |
Fast general-purpose text |
llama-3.3-70b-versatile |
Larger general-purpose text |
openai/gpt-oss-120b |
Open-weight reasoning model |
openai/gpt-oss-20b |
Smaller open-weight reasoning model |
groq/compound |
Agentic system |
groq/compound-mini |
Lighter agentic system |
Os modelos Whisper, whisper-large-v3 e whisper-large-v3-turbo, não se encaixam nessa tabela. Eles são modelos de transcrição de áudio, e o Groq mede seu throughput em segundos de áudio por hora e por dia (ASH/ASD), além de seus próprios limites de RPM e RPD, não em tokens.
Cada modelo tem seus próprios limites de RPM, RPD e tokens, então não presuma que os limites de llama-3.1-8b-instant se aplicam a openai/gpt-oss-120b.
Leia os cabeçalhos de limite de taxa em vez de adivinhar
Toda resposta de api.groq.com traz um conjunto de cabeçalhos que dizem exatamente onde você está, sem precisar visitar o console:
x-ratelimit-limit-requestsex-ratelimit-limit-tokens, seu teto para a janela atualx-ratelimit-remaining-requestsex-ratelimit-remaining-tokens, o que resta agorax-ratelimit-reset-requestsex-ratelimit-reset-tokens, quando a janela é reiniciadaretry-after, enviado em um 429, informando quanto tempo esperar
Leia x-ratelimit-remaining-tokens após cada chamada e você tem um medidor ao vivo, não um número estático que você consultou uma vez e esqueceu de revisitar. Aqui está uma verificação rápida com cURL, imprimindo apenas os cabeçalhos:
curl -sD - https://api.groq.com/openai/v1/chat/completions \
  -H "Authorization: Bearer $GROQ_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "llama-3.1-8b-instant", "messages": [{"role": "user", "content": "hi"}]}' \
  -o /dev/null | grep -i ratelimit
Execute isso algumas vezes em um loop contra um script de teste falador e você verá x-ratelimit-remaining-tokens diminuir. Se seu aplicativo precisar de lógica de backoff, veja nosso guia sobre como implementar limitação de taxa de API para padrões que respeitam um cabeçalho retry-after em vez de adivinhar um atraso.
Deixe seu agente de codificação executar a verificação com o Apidog CLI
Fazer a dança de curl e grep manualmente funciona para uma sessão de depuração. Não escala para uma equipe, e ninguém reexecuta um comando de shell avulso antes de cada implantação. Entregue a verificação ao seu agente de codificação: com o Apidog CLI, ele escreve o teste uma vez e o executa sempre que você pedir. Configure uma vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
O token vem do Apidog em Account Settings, API Access Token. Depois dê ao agente um prompt:
Use Apidog CLI on project <id>. Create a Groq environment with base URL
https://api.groq.com/openai/v1 and add POST /chat/completions with Bearer auth
from {{GROQ_API_KEY}}. Create one test case per model we run in production
(llama-3.1-8b-instant, openai/gpt-oss-120b) that asserts status 200 and fails
when x-ratelimit-remaining-tokens drops below 10% of x-ratelimit-limit-tokens.
Put both cases in a "Groq limits" test suite, run it, and report the headers.
Os comandos que ele executa, verificados contra o Apidog CLI 2.2.7:
apidog environment create Groq --project <id> --base-url https://api.groq.com/openai/v1
apidog endpoint create --project <id> --file groq-chat.json
apidog cli-schema validate test-case-create --file groq-8b-case.json
apidog test-case create --project <id> --file groq-8b-case.json
apidog test-suite create --project <id> --name "Groq limits"
apidog run --test-suite <suiteId> --project <id> -e <envId> \
  --env-var "GROQ_API_KEY=$GROQ_API_KEY" -r cli,junit
Um orçamento que encolhe agora aparece como um teste com falha em vez de um 429 surpresa durante uma demonstração. Coloque essa última linha no seu job de CI de pré-implantação, como em nosso guia de pipeline CI/CD do Apidog CLI, ou peça ao agente um apidog scheduled-task create, que executa a suíte em um runner seguindo um cron. Isso importa mais dado o agrupamento no nível da organização do Groq: um colega de equipe executando um job em lote pode consumir o orçamento compartilhado que seu endpoint de produção precisa uma hora depois. É a mesma ideia por trás do nosso post sobre testar uma API para limites de taxa do GPT.
O que fazer quando você realmente atinge o limite
Quando um 429 volta, respeite retry-after em vez de tentar novamente imediatamente. Um loop de retentativa apertado contra um limite no nível de requisição apenas gasta seu orçamento restante mais rápido e empurra a janela de reinício ainda mais para frente. Se você está incorporando isso em um serviço de produção em vez de um script de teste, nosso guia completo do erro de limite de taxa excedido aborda estratégias de backoff que funcionam entre provedores, não apenas no Groq.
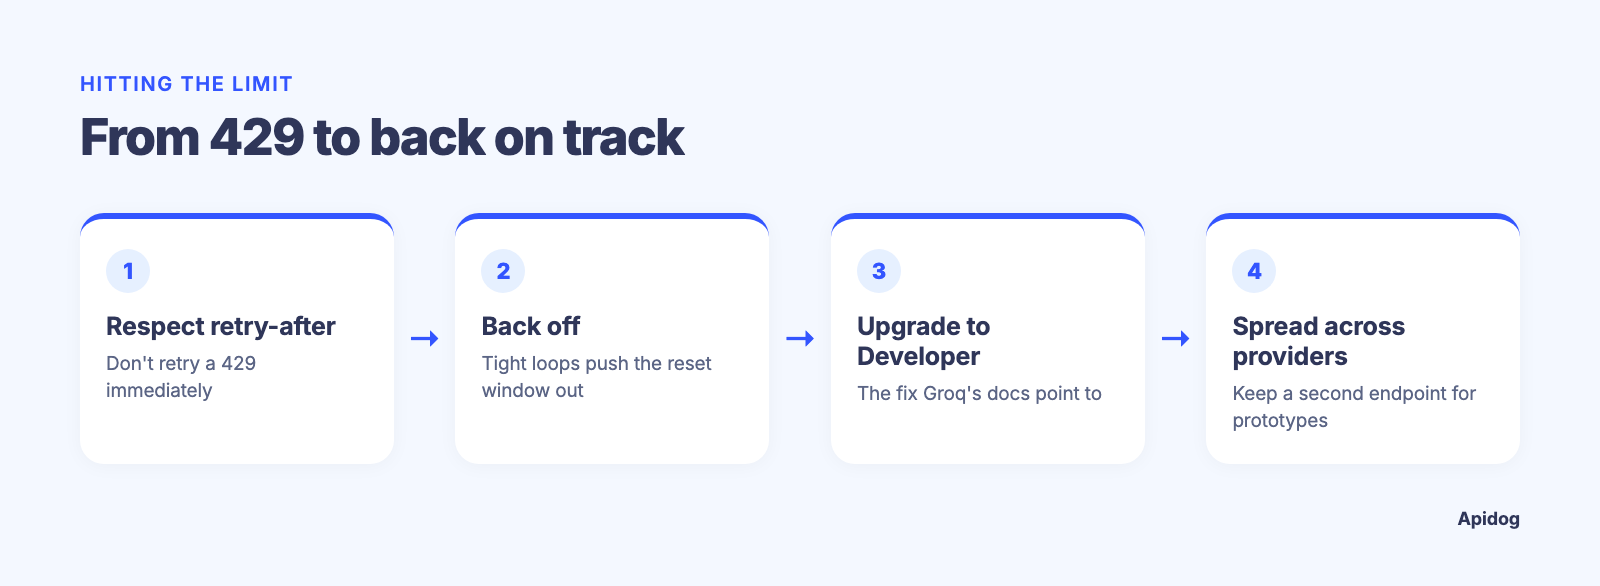
Se você está consistentemente batendo no teto do Plano Gratuito, a correção mais rápida é o upgrade para o Plano Desenvolvedor que o Groq indica diretamente em sua documentação. A segunda correção mais rápida, especialmente para um protótipo, é distribuir o tráfego entre mais de um provedor. Nossa compilação de alternativas ao OpenRouter cobre outros endpoints que vale a pena ter na manga exatamente para essa situação.
Perguntas frequentes
O Groq tem um nível gratuito para sua API? Sim. Toda conta nova começa no Plano Gratuito com acesso ao endpoint compatível com OpenAI. O Groq publica limites de exemplo do Plano Gratuito para vários modelos, mas os limites que realmente se aplicam à sua conta estão na página de limites nas configurações do seu console.
Como verifico meu limite de taxa atual do Groq? De duas formas: abra a página de limites nas configurações da sua conta, ou leia os cabeçalhos x-ratelimit-limit-requests e x-ratelimit-limit-tokens em qualquer resposta da API. Os cabeçalhos refletem o limite real da sua conta no momento em que você chamou, o que é mais confiável do que um número que você viu uma vez e memorizou.
O que acontece quando excedo o limite de taxa do Groq? Você recebe uma resposta 429 com um cabeçalho retry-after informando quantos segundos esperar. Veja nosso guia de limite de taxa excedido para lidar com isso em código em vez de adivinhar um atraso.
Tokens em cache contam contra meu limite de taxa do Groq? Não. O Groq afirma diretamente que tokens em cache não contam para seus limites de taxa, então uma estrutura de prompt que reutiliza uma mensagem de sistema em cache obtém mais throughput real do que o limite bruto de tokens implica.
O limite de taxa do Groq é por usuário ou por organização? Por organização. Todas as chaves sob a mesma organização do Groq compartilham um único pool de requisições e tokens, então o script de um colega de equipe pode consumir o orçamento que seu aplicativo de produção precisa.
Quais modelos do Groq têm a maior janela de contexto? llama-3.1-8b-instant, llama-3.3-70b-versatile, openai/gpt-oss-120b, openai/gpt-oss-20b e os sistemas Compound rodam todos com 131.072 tokens de contexto. Os modelos Whisper são de transcrição de áudio, não de texto, então o Groq mede seus limites em duração de áudio. Os limites de taxa diferem de modelo para modelo mesmo dentro da mesma janela de contexto, então verifique cada um separadamente.
Onde isso deixa você
A forma gratuita de usar a API do Groq não é um número secreto, é um hábito. Obtenha uma chave, aponte o endpoint compatível com OpenAI para ela e leia os cabeçalhos de resposta em cada chamada em vez de confiar em um número que você encontrou em um post de blog, incluindo este.
Faça seu agente de codificação construir essa verificação uma vez com o CLI do Apidog, com uma asserção sobre os tokens restantes para cada modelo, e ela será executada em cada implantação a partir de então. A configuração leva menos tempo do que ler o resto da documentação do Groq. Para uma cobertura mais profunda sobre testar uma camada de API de IA sob carga, nosso guia sobre as melhores ferramentas de teste de API para agentes de IA é uma boa próxima parada.