
O Grok 4.6 foi lançado em 12 de agosto com uma afirmação que reformula a decisão de modelos de fronteira: inteligência que empata com o GPT-5.6 Sol no Índice de Análise Artificial, a US$ 6 por milhão de tokens de saída em vez de US$ 30. A maioria dos artigos de comparação que você encontrará ainda compara o Grok 4.5, que ficou tão atrás da fronteira que o preço não importava. Essa não é mais a situação, então esta comparação começa do zero com os números do 4.6.
A resposta curta: o GPT-5.6 Sol continua sendo a escolha mais forte para agentes de codificação em escala de repositório, o Claude Fable 5 lidera o trabalho autônomo de longo prazo por pouco, e o Grok 4.6 é agora a opção de valor que está próxima o suficiente em capacidade para fazer com que os outros dois justifiquem seus preços. A escolha certa depende da sua carga de trabalho, então abaixo estão os números, as considerações da API e uma maneira reproduzível de testar os três em sua própria pilha. Se você quiser realizar esse teste hoje, o Apidog permite que você acesse as três APIs lado a lado em um único espaço de trabalho, gratuitamente.
TL;DR
- Índice de Inteligência: Claude Fable 5 lidera com 62; Grok 4.6 e GPT-5.6 Sol empatam com 61.
- Preços (saída, por 1M de tokens): Grok 4.6 a US$ 6, Claude Opus 4.8 a US$ 25, GPT-5.6 Sol a US$ 30, uma diferença de 5x.
- Contexto: GPT-5.6 Sol 1,05M de tokens, Claude Fable 5 1M, Grok 4.6 500K.
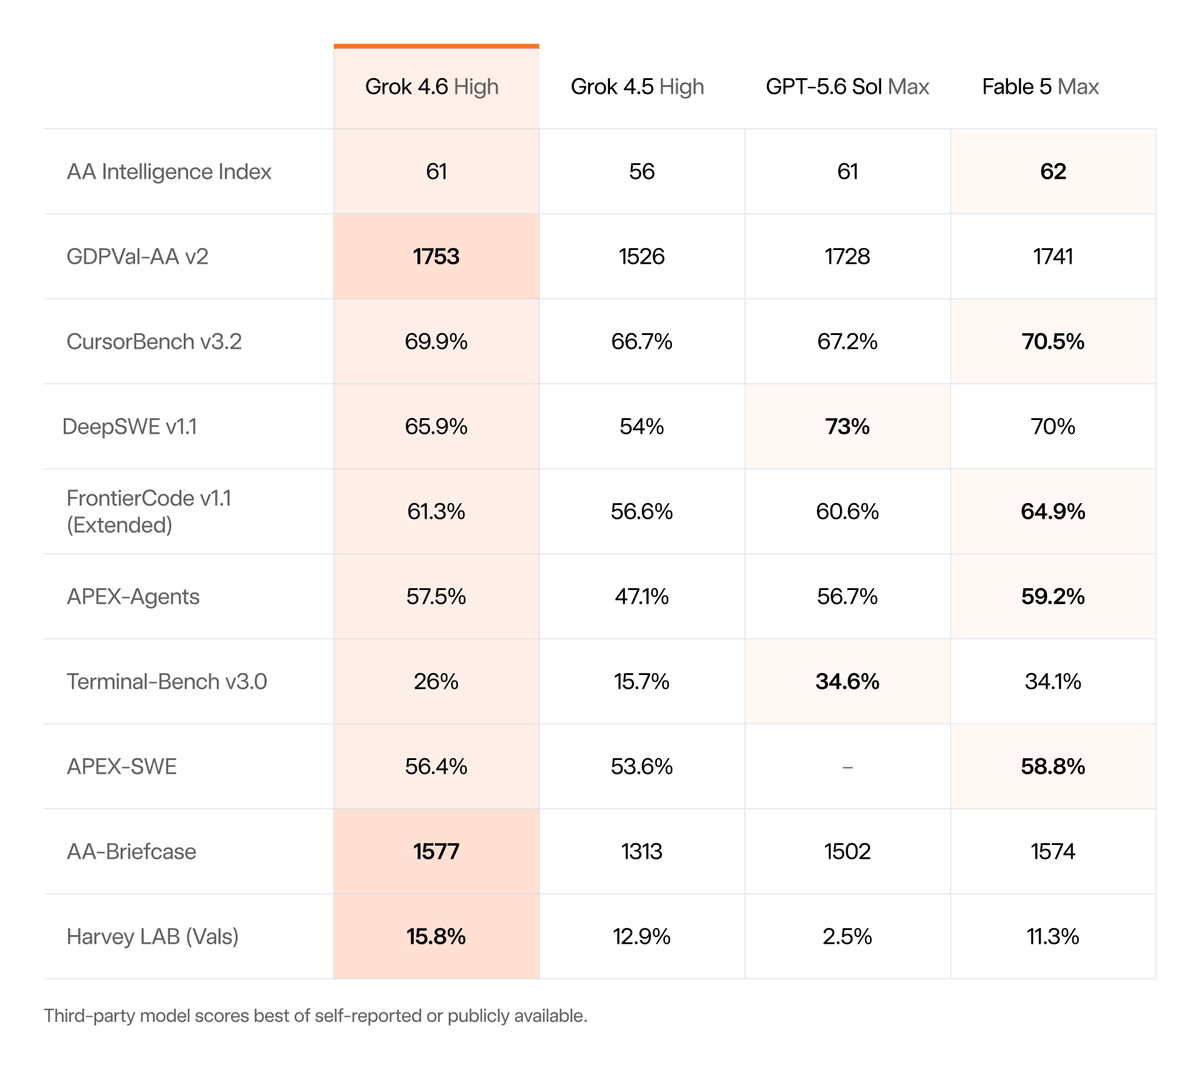
- Codificação: Sol Max lidera DeepSWE (73,0% vs 65,9% do Grok); Fable 5 Max lidera FrontierCode (63,6% vs 61,3%).
- Agentes: Fable 5 Max lidera APEX-Agents com 59,2%; Grok 4.6 (57,5%) supera Sol Max (56,7%).
- Custo por tarefa concluída: Grok 4.6 medido em US$ 0,84 pela Artificial Analysis, o mais baixo na fronteira.
- Não decida apenas por benchmarks: execute um teste comparativo de 20 prompts em sua própria carga de trabalho (método abaixo).
Especificações e preços lado a lado
| Grok 4.6 | GPT-5.6 Sol | Claude Fable 5 | |
|---|---|---|---|
| Desenvolvedor | xAI | OpenAI | Anthropic |
| Índice de Inteligência | 61 | 61 | 62 |
| Janela de contexto | 500K | 1,05M | 1M |
| Preço de entrada / 1M | $2 | $12 | $10 |
| Preço de saída / 1M | $6 | $30 | $25* |
| Variante rápida/premium | 2x preço | Nível Sol Max | Nível Fable 5 Max |
| Estilo de API | Compatível com OpenAI | Nativo OpenAI | Anthropic Messages |
| Corte de conhecimento | Fev 2026 |
*Preços do Claude exibidos para Opus 4.8; os preços do nível Fable 5 variam de acordo com a configuração de esforço. Consulte nosso guia de preços do GPT-5.6 e a análise de redução de custos do Claude para as matrizes completas.
A assimetria de preços é o que importa. No lado da entrada, o Grok cobra um sexto do que o OpenAI cobra; no lado da saída, um quinto. Para cargas de trabalho de chat, isso é bom; para cargas de trabalho de agentes, onde uma única tarefa pode gerar dezenas de chamadas de modelo e longas transcrições de uso de ferramentas, isso se traduz na diferença entre um agente de US$ 50/dia e um de US$ 250/dia.
Benchmarks de codificação: Sol para profundidade, Grok para valor
Nos números de lançamento, cada modelo possui seu território:
| Benchmark | Grok 4.6 | GPT-5.6 Sol Max | Claude Fable 5 Max |
|---|---|---|---|
| DeepSWE v1.1 (correções em escala de repositório) | 65.9% | 73.0% | |
| FrontierCode v1.1 Estendido | 61.3% | 60.6% | 63.6% |
| CursorBench v3.2 | 69.9% | ||
| APEX-Agents | 57.5% | 56.7% | 59.2% |
| Terminal-Bench v2.1 | 88.4% |
Leia desta forma:
- A liderança de 7 pontos do GPT-5.6 Sol Max no DeepSWE é real e importa. A correção de bugs em escala de repositório é o benchmark de codificação mais difícil e economicamente valioso. Se seu agente trabalha em grandes bases de código existentes com supervisão mínima, o Sol ainda é a aposta mais segura. Nossa comparação entre GPT-5.6 Sol e Claude Fable 5 aborda esse confronto em profundidade.
- O Claude Fable 5 vence em consistência. Ele lidera o índice composto, o FrontierCode e o APEX-Agents. Nada irregular, ele raramente é pior que o segundo. Esse perfil é adequado para trabalhos autônomos de longo prazo, onde um passo errado pode atrapalhar uma hora de progresso.
- O Grok 4.6 nunca está muito atrás e, às vezes, está à frente. Liderar o CursorBench e o Terminal-Bench enquanto se mantém próximo em outros lugares, a uma fração do custo, é exatamente o perfil de um modelo para o qual você direciona a maior parte do seu tráfego, escalonando apenas os casos difíceis.
Uma nota de honestidade: estes são números da semana de lançamento, amplamente relatados pelos fornecedores. Os benchmarks de lançamento do Grok 4.5 precisaram de leitura cuidadosa, e a mesma cautela se aplica a todos os fornecedores aqui.
Custo por tarefa, não custo por token
Os preços dos tokens enganam quando os modelos diferem em verbosidade e taxas de repetição. Um modelo barato que falha em uma execução terminal cria trabalho de revisão e reparo que custa mais do que os tokens economizados. A melhor métrica é o custo por tarefa concluída, e aqui a medição independente da Artificial Analysis é impressionante: o Grok 4.6 teve uma média de US$ 0,84 por tarefa em suas avaliações de agente, o mais baixo entre os modelos de fronteira, auxiliado por um uso de tokens relativamente disciplinado em vez de apenas preços baixos.
Um exemplo prático. Digamos que seu agente de codificação use em média 500K de tokens de entrada e 100K de tokens de saída por tarefa concluída:
| Modelo | Custo de entrada | Custo de saída | Por tarefa |
|---|---|---|---|
| Grok 4.6 | $1.00 | $0.60 | $1.60 |
| Claude Opus 4.8 | $5.00 | $2.50 | $7.50 |
| GPT-5.6 Sol | $6.00 | $3.00 | $9.00 |
Com 1.000 tarefas por mês, o Grok economiza aproximadamente US$ 6.000–7.400 em comparação com as alternativas, se sua taxa de sucesso em sua carga de trabalho se mantiver. Essa condição é crucial, por isso você deve testar antes de se comprometer.
Ergonomia da API: o custo real da integração
- O Grok 4.6 é compatível com OpenAI. Se você possui algum cliente estilo OpenAI, basta apontar a
base_urlparahttps://api.x.ai/v1e você estará funcionando. Ele também está disponível no OpenRouter, Vercel e Cloudflare para usuários de gateway. - O GPT-5.6 Sol possui o ecossistema mais profundo: a Responses API, chamada programática de ferramentas e SDKs próprios em todos os lugares. Consulte como usar a API GPT-5.6 para a estrutura de níveis.
- O Claude Fable 5 usa a API Messages da Anthropic, um formato de solicitação diferente, excelente confiabilidade no uso de ferramentas e um parâmetro de esforço que troca custo por capacidade dentro de um único modelo.
O atrito de migração é menor entre Grok e OpenAI (formato compartilhado), e maior ao mover para ou de Anthropic. Se você antecipa alternar ou rotear entre modelos, essa assimetria deve ser considerada em sua decisão de arquitetura.
Janelas de contexto: quando 500K é suficiente
No papel, a janela de 1,05M de tokens do GPT-5.6 Sol dobra a do Grok 4.6 (500K), com a de 1M do Claude Fable 5 logo atrás. Na prática, a questão é o que sua carga de trabalho realmente mantém em contexto.
Uma janela de 500K comporta aproximadamente 350.000 palavras: toda a base de código de um serviço de médio porte, um ano de transcrições de suporte ou várias centenas de páginas de documentos legais. A maioria das tarefas de agente nunca se aproxima disso. As cargas de trabalho que realmente precisam do nível de um milhão de tokens são específicas: análise de monorepo completo, transcrições de agente de várias sessões muito longas que você se recusa a resumir e processamento único de grandes conjuntos de documentos.
Duas notas práticas desaconselham a escolha apenas pelo tamanho da janela. Primeiro, todo modelo degrada à medida que o contexto se preenche; a qualidade de recuperação com 80% da capacidade é pior do que com 20% em todos os três, então arquiteturas que preenchem a janela raramente superam arquiteturas que recuperam seletivamente. Segundo, tokens de entrada são onde os orçamentos morrem: preencher a janela completa do Sol custa cerca de US$ 12,60 por solicitação no preço de tabela, enquanto preencher a do Grok custa US$ 1. Se seus prompts rotineiramente excedem 400K tokens, você não precisa apenas de uma janela maior, você precisa de uma estratégia de cache e recuperação, independentemente do fornecedor que escolher.
Prazos de corte de conhecimento e maturidade do ecossistema
O Grok 4.6 é lançado com um prazo de corte de conhecimento de 1º de fevereiro de 2026, o mais recente dos três, o que importa para agentes de codificação que referenciam frameworks em rápida evolução. É uma vantagem real, mas menor: qualquer pilha de agente séria se baseia em ferramentas de recuperação e documentação, em vez de confiar no conhecimento paramétrico.
O ecossistema é o inverso. O OpenAI tem a superfície de integração de terceiros mais profunda, o Anthropic tem a maior participação no mercado de frameworks de agentes, e a xAI é a novata que se apoia na compatibilidade com OpenAI para usar ambos. Essa aposta funciona na maioria das vezes: qualquer coisa que use o formato de preenchimento de chat funciona com o Grok hoje, e a disponibilidade de gateway através do OpenRouter, Vercel e Cloudflare significa que você pode adotá-lo sem tocar em sua infraestrutura. O que você perde é o polimento de primeira parte; APIs de lote, camadas de cache e controles de uso granular são menos maduros do que os dos incumbentes.
Qual modelo para qual tarefa
- Agente de codificação autônomo em escala de repositório, qualidade em primeiro lugar: GPT-5.6 Sol. A liderança no DeepSWE se traduz em menos execuções desviadas em grandes bases de código.
- Trabalho de conhecimento de longo prazo e sessões de agente de várias horas: Claude Fable 5. Melhor pontuação composta, melhor benchmark de agente, histórico mais forte de manter-se no rumo.
- Tráfego de agente de alto volume, produtos sensíveis ao custo ou modelo padrão de um roteador: Grok 4.6. Saída de nível de fronteira a preços de commodity; escale as 10% tarefas mais difíceis para Sol ou Fable.
- Codificação interativa em um IDE: a liderança do Grok 4.6 no CursorBench, somada à sua variante 2x mais rápida, o torna um sério candidato; ele foi efetivamente construído para isso após treinamento em sessões reais do Cursor.
Teste os três em sua pilha em uma tarde
Benchmarks preveem médias, não sua carga de trabalho. Aqui está um teste comparativo reproduzível usando o Apidog:
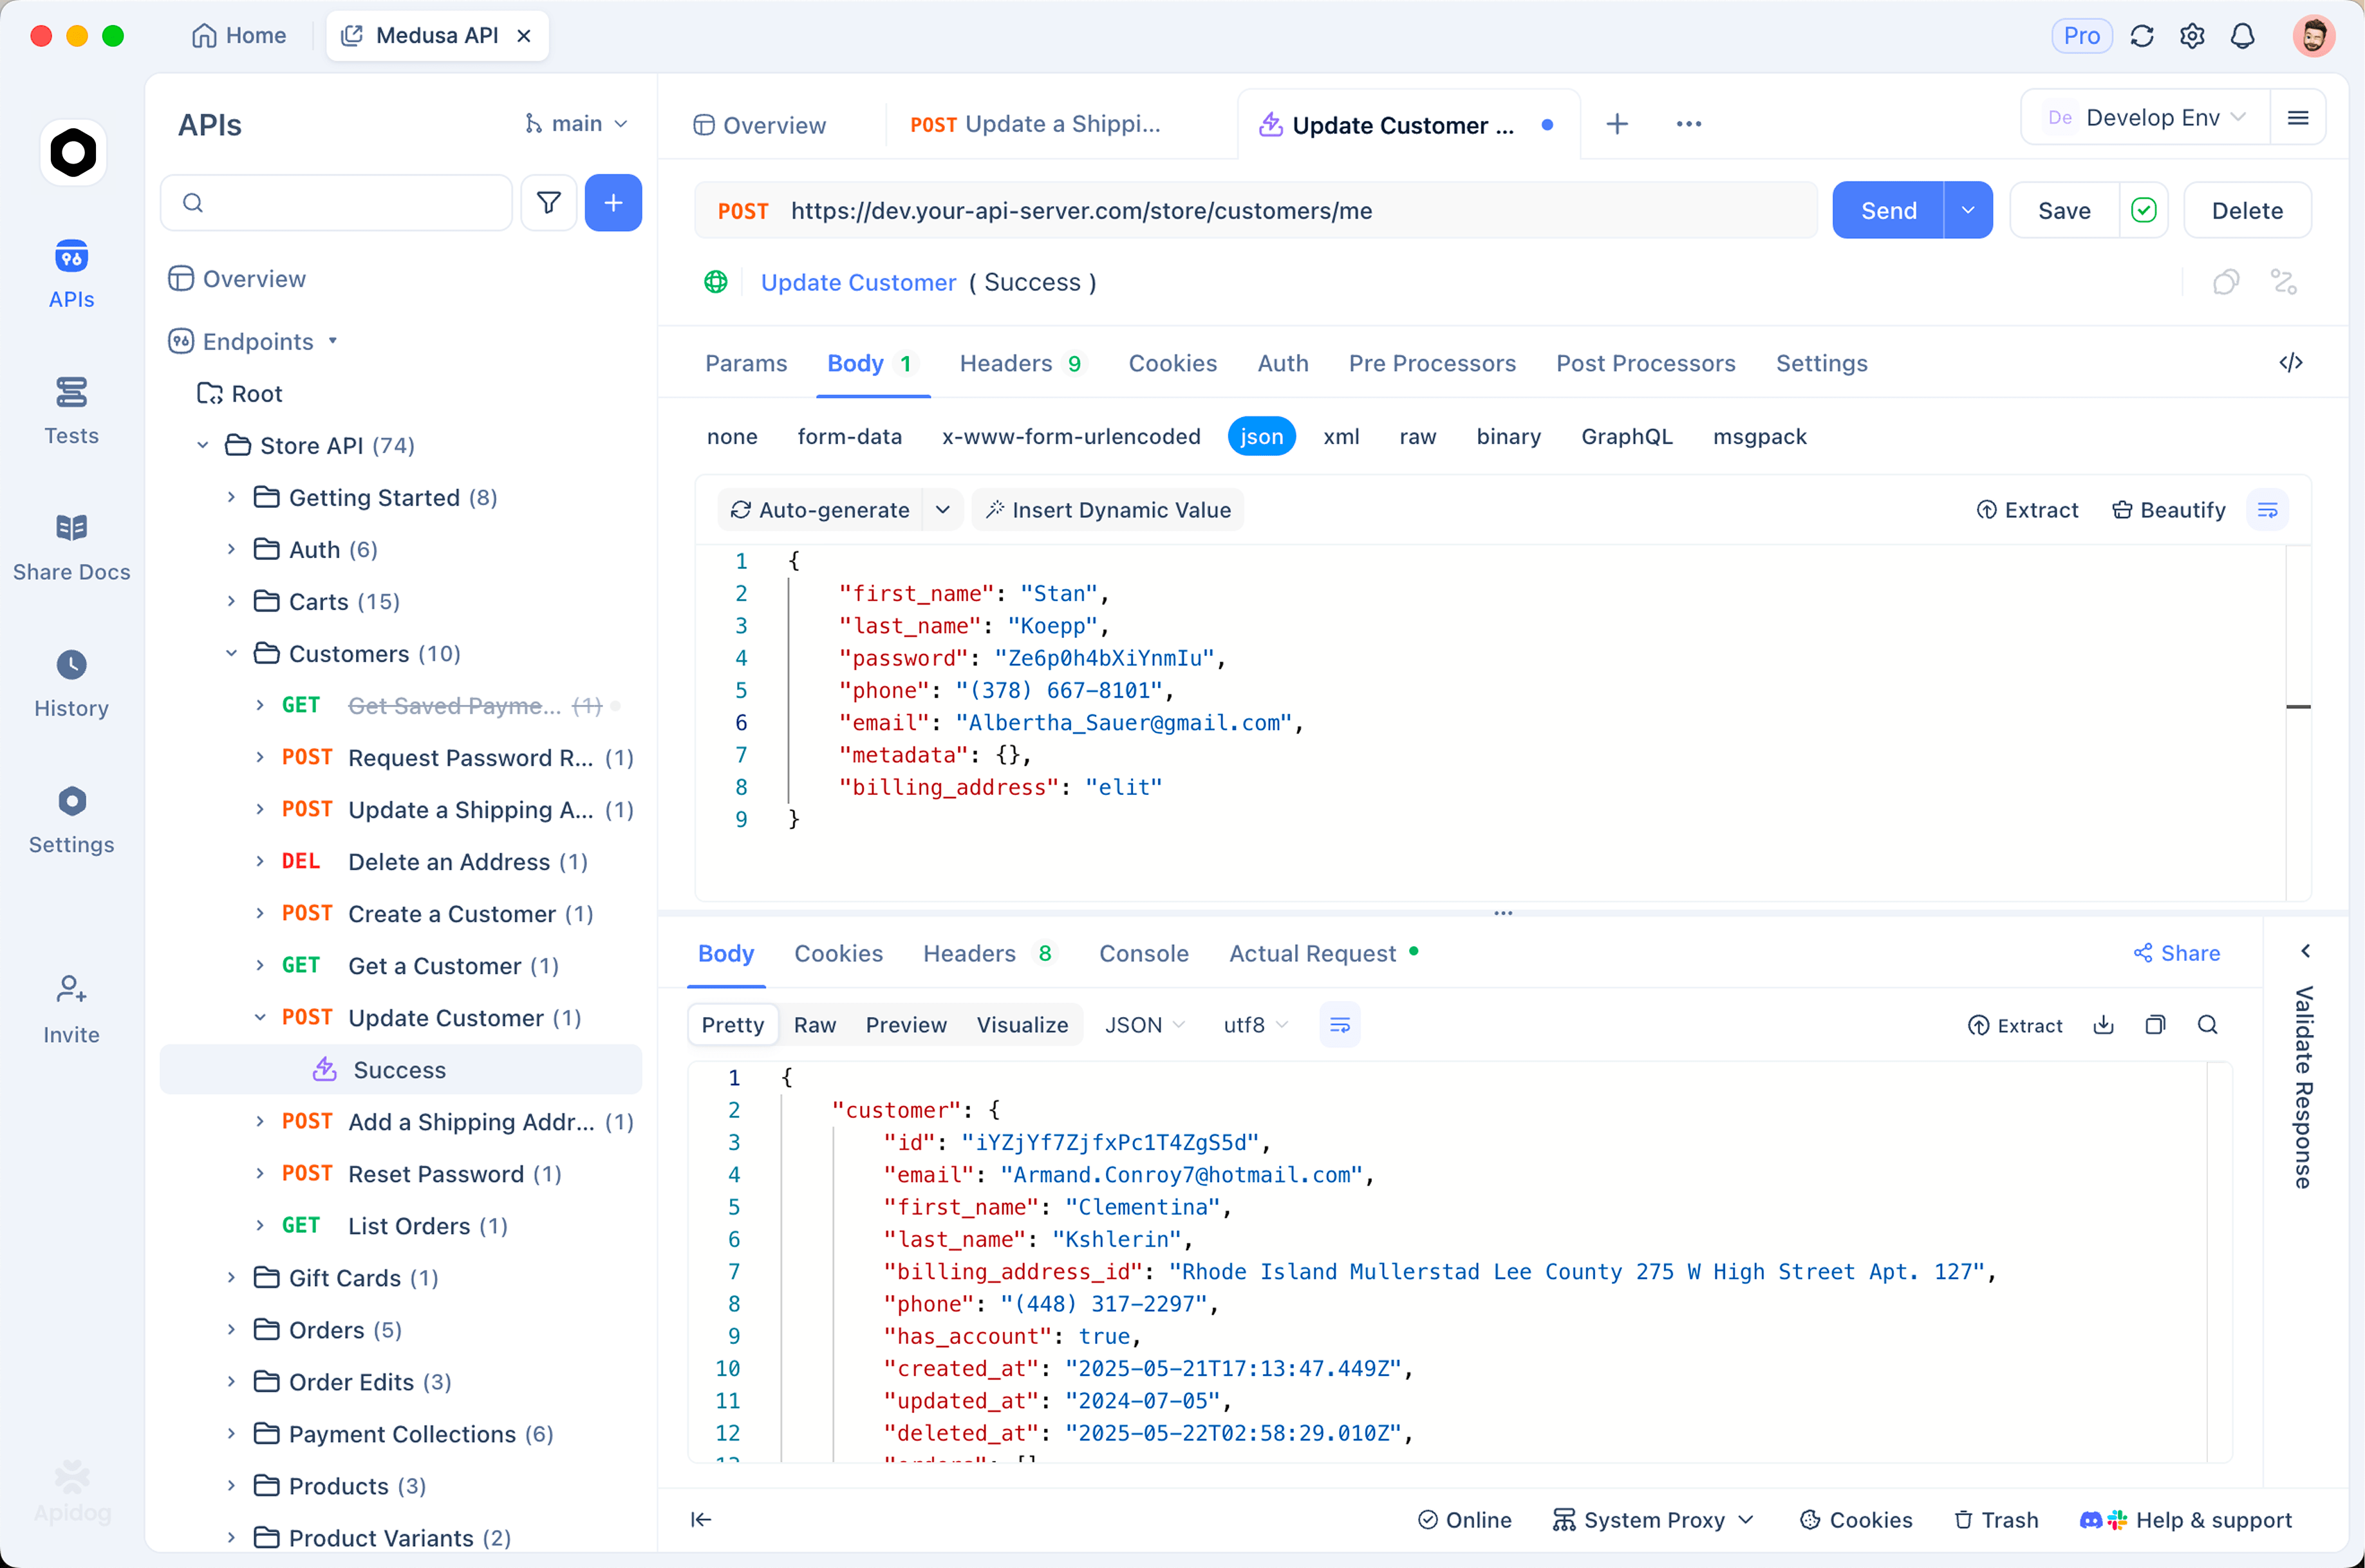
- Um projeto, três ambientes. Crie ambientes para xAI (
api.x.ai/v1), OpenAI e Anthropic, cada um com sua própria autenticação. A mesma solicitação troca de provedor com um único menu suspenso. - Colete 20 prompts reais. Use tarefas reais do seu produto, não perguntas de exemplo. Inclua seu prompt de sistema, suas definições de ferramenta se usar chamada de função, e pelo menos cinco casos notoriamente difíceis.
- Afirme o que importa para você. Adicione asserções do Apidog para validade da resposta, uso de tokens do objeto
usagee limites de latência. Para cargas de trabalho de chamada de ferramenta, certifique-se de que o JSON da chamada de ferramenta seja analisado e corresponda ao seu esquema; os modelos falham aqui com muito mais frequência do que na prosa. - Execute como um cenário de teste, três vezes por modelo. As saídas de LLM variam; três execuções expõem a variância que uma única demonstração oculta. Exporte os resultados e compare a taxa de sucesso e o custo por sucesso, não o custo por token.
- Mantenha o conjunto de testes. Quando a próxima versão do modelo for lançada (no ritmo atual, em meses), execute-o novamente. A escolha do modelo agora é uma decisão trimestral, e equipes com uma estrutura de avaliação estabelecida mudam semanas mais rápido do que equipes que redecidem por anedotas.
FAQ
- O Grok 4.6 é melhor que o GPT-5.6 Sol? Eles empatam no índice composto com 61. Sol lidera claramente a codificação em escala de repositório (DeepSWE 73,0% vs 65,9%); Grok lidera CursorBench e Terminal-Bench e custa 5x menos na saída. "Melhor" depende se sua carga de trabalho se parece mais com DeepSWE ou com uma sessão de IDE.
- O Grok 4.6 é melhor que o Claude Fable 5? Fable 5 lidera no índice (62 vs 61), FrontierCode e APEX-Agents, todos por pouco. A vantagem do Grok é o preço. Para trabalho autônomo crítico de precisão, Fable 5; para volume sensível ao custo, Grok.
- Qual modelo de IA é o mais barato na fronteira em 2026? Grok 4.6, a US$ 2/US$ 6 por milhão de tokens e com uma medição independente de US$ 0,84 por tarefa de agente. Os tokens de saída do concorrente de fronteira mais próximo custam cerca de 4x mais.
- Devo mudar meu agente de produção para o Grok 4.6? Não apenas com base em benchmarks. Execute o teste comparativo acima em sua carga de trabalho real primeiro; a diferença de preço de 5x só compensa se a taxa de sucesso se mantiver em suas tarefas.
- Posso usar os três modelos com um único formato de API? Em grande parte sim. O Grok 4.6 é compatível nativamente com o formato de preenchimento de chat do OpenAI, então ele compartilha código cliente com o GPT-5.6. O Claude requer a API Messages da Anthropic, ou um gateway como o OpenRouter que normaliza os três por trás de uma única interface com uma pequena margem de preço.
- A janela de contexto menor do Grok 4.6 importa? Para a maioria das cargas de trabalho de agentes e chat, não; 500K tokens está muito acima do uso típico, e todos os três modelos degradam perto de seus limites de qualquer forma. Isso importa se você processa rotineiramente monorepos inteiros ou conjuntos massivos de documentos em uma única chamada, onde a janela de 1,05M do Sol oferece espaço real.