
GPT-Live-1.1 vs GPT-Realtime se resume a arquitetura. O GPT-Live-1.1 é um frontend de voz full-duplex que entrega raciocínio e ferramentas a um modelo backend separado e cobra US$ 0,05 por minuto ativo. O GPT-Realtime-2.1 é um único modelo speech-to-speech que ouve, raciocina, chama ferramentas e fala, cobrado por token. Escolha o GPT-Live-1.1 quando você já tem um agente de texto; escolha o Realtime quando quiser um único modelo fazendo tudo.
A OpenAI disponibilizou o GPT-Live-1.1 na API em 20 de novembro de 2026, então agora você tem duas stacks de voz com endpoints, cobrança e modelos de ferramentas diferentes. Nosso post de julho GPT-Live vs GPT-Realtime comparou o recurso do ChatGPT com a API; este aqui é API contra API.
GPT-Live-1.1 vs GPT-Realtime em resumo
Veja como as duas stacks se comparam, com base na página do modelo GPT-Live-1.1, na página do modelo gpt-realtime-2.1 e na página de preços da OpenAI em 20 de novembro de 2026:
| GPT-Live-1.1 | gpt-realtime-2.1 | |
|---|---|---|
| Endpoint | v1/live/sessions |
v1/realtime |
| Design | Voz full-duplex mais backend delegado | Um único modelo de raciocínio speech-to-speech |
| Entrada | Áudio, texto | Áudio, texto, imagem |
| Saída | Áudio, texto | Áudio, texto |
| Cobrança | US$ 0,05/min ativo, US$ 0,02/min em standby | US$ 32 na entrada, US$ 64 na saída por 1M de tokens de áudio |
| Raciocínio e ferramentas | Modelo backend, cobrado à parte | Dentro do mesmo modelo e preço |
| Chamada de funções | Por delegação | session.tools |
| Transportes | WebRTC, WebSocket, SIP (entrada e saída) | WebRTC, WebSocket, SIP (entrada) |
| Limites de taxa | Sessões simultâneas | Requisições e tokens por minuto |
O guia de agentes de voz da OpenAI resume a divisão na sua tabela de arquitetura. O GPT-Live é para “conversas full-duplex com um backend separado”. A Realtime API é para “fala, raciocínio e uso de ferramentas em uma única sessão”.
Arquitetura: delegação vs um único modelo
O GPT-Live-1.1 separa o falar do pensar. O modelo de voz cuida da conversa em tempo real e escuta enquanto fala. Quando uma requisição precisa de raciocínio, busca ou alguma ferramenta, ele delega o trabalho a um modelo backend e mantém a conversa fluindo enquanto isso roda.
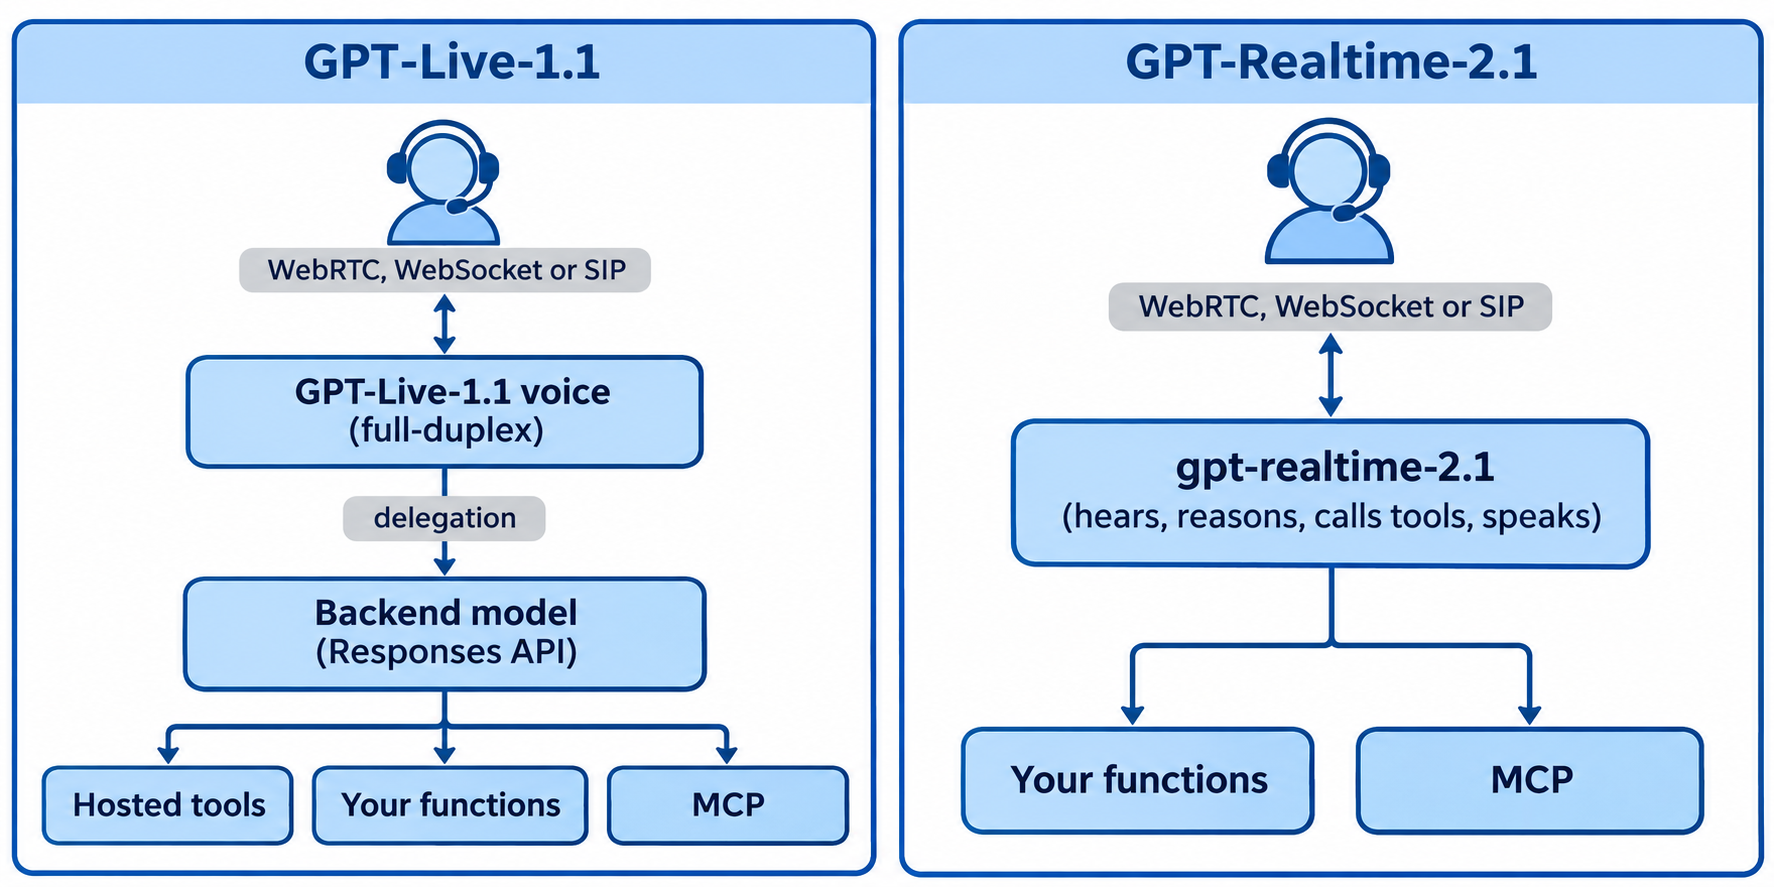
Você define a delegação uma única vez, ao criar a sessão, de acordo com o guia de conversas ao vivo. Ela tem dois modos:
responses: a OpenAI roda o backend através da Responses API. Você escolhe o modelo emdelegation.responses.modele adicionainstructions,tools,tool_choice,reasoningeservice_tier. A documentação sugere começar comgpt-6-lunae migrar paragpt-6-solem tarefas mais difíceis.client: seu app roda o backend. O GPT-Live envia um eventosession.delegation.created, e você retorna resultados com eventos comosession.instructions.append.
O modo não pode mudar no meio da sessão; trocar significa uma nova sessão. As configurações do backend dentro dela podem mudar com session.update.
O gpt-realtime-2.1 adota a abordagem oposta: um único modelo de raciocínio interpreta o áudio, chama ferramentas e responde em fala. Sem segundo modelo, sem handoff e com todo o contexto em um só lugar.
Com o GPT-Live-1.1, você pode trocar o backend ou manter seu agente de texto existente sem mexer na camada de voz. Com o Realtime, o modelo de voz é o agente.
Preços: por minuto vs por token
O GPT-Live-1.1 cobra por tempo, e o Realtime cobra por tokens. Isso faz seus custos se comportarem de formas bem diferentes quando os interlocutores pausam, falam demais ou ficam na linha.
| Item de custo | GPT-Live-1.1 | gpt-realtime-2.1 | gpt-realtime-2.1-mini |
|---|---|---|---|
| Áudio | US$ 0,05/min ativo, US$ 0,02/min em standby | US$ 32 na entrada, US$ 64 na saída por 1M de tokens | US$ 10 na entrada, US$ 20 na saída por 1M de tokens |
| Texto | Cobrado pela duração da sessão | US$ 4 na entrada, US$ 24 na saída por 1M de tokens | US$ 0,60 na entrada, US$ 2,40 na saída por 1M de tokens |
| Entrada em cache | n/a | US$ 0,40 por 1M de tokens | US$ 0,30 áudio, US$ 0,06 texto por 1M |
| Raciocínio e ferramentas | Modelo backend com suas próprias tarifas | Incluído no preço por token | Incluído no preço por token |
O GPT-Live cobra por segundo, então uma chamada de 90 segundos custa US$ 0,075 de tempo de voz, não US$ 0,10. Uma sessão WebRTC cobra 15 segundos de inicialização, creditados assim que começa a rodar.
O standby é a alavanca de custo que o Realtime não tem. No WebRTC, defina wake_policy.type como "speech" e idle_timeout_s com um número inteiro de 5 a 60. Depois desses segundos sem fala, a sessão cai para US$ 0,02 por minuto até alguém falar de novo. O standby está documentado apenas para WebRTC, então sessões WebSocket e SIP cobram cada segundo conectado pela tarifa ativa.
Para comparar as duas de acordo com o seu próprio tráfego, use um número de break-even em vez de adivinhar. US$ 0,05 compra cerca de 1.560 tokens de áudio de entrada ou 780 tokens de áudio de saída no gpt-realtime-2.1, e cerca de 5.000 tokens de entrada ou 2.500 de saída no 2.1-mini. Puxe as contagens de tokens de áudio por minuto dos seus eventos de uso do Realtime. Se o seu minuto ativo médio usar mais do que isso, o tempo de voz do GPT-Live é mais barato; então adicione a conta de tokens do modelo backend para ver o quadro completo.
O Realtime embute o raciocínio no preço por token; o GPT-Live soma uma conta de backend por tarefa delegada mas reduz o custo dos trechos silenciosos com o standby. Para o lado dos tokens, veja nosso guia do gpt-realtime-2.1-mini.
Chamada de funções e ferramentas
Ambas as stacks chamam suas funções, mas de lugares diferentes.
No Realtime, as ferramentas ficam na sessão. O guia de ferramentas do Realtime mostra uma ferramenta "type": "function" em session.tools, enviada com session.update. Seu cliente executa a função e retorna um item function_call_output. Servidores MCP remotos também funcionam: adicione uma ferramenta com "type": "mcp", um server_label e um server_url, e a Realtime API chama o servidor por você. Você também pode limitar ferramentas a um único turno com response.tools.
No GPT-Live-1.1, as ferramentas ficam no backend. Você coloca ferramentas de função, servidores MCP e ferramentas hospedadas como busca na web, busca em arquivos e Code Interpreter em delegation.responses.tools. Os eventos do backend chegam até você embrulhados em envelopes response.event, e os resultados das suas funções voltam como itens function_call_output seguidos de response.create.
O lado bom: a voz continua responsiva enquanto uma ferramenta lenta roda no backend. O custo: dois modelos, dois fluxos de eventos e duas faturas.
Turnos, interrupções e transportes
É aqui que as duas stacks soam mais diferentes para quem está do outro lado da linha.
Turnos. O GPT-Live-1.1 é full-duplex: ele processa o áudio recebido enquanto gera saída, então consegue escutar, dar feedback e se ajustar no meio da frase. O Realtime funciona em turnos detectados por atividade de voz. O guia de VAD do Realtime lista dois modos em session.audio.input.turn_detection.type:
server_vad, o padrão, ajustado comthreshold,prefix_padding_msesilence_duration_ms.semantic_vad, ajustado comeagerness(low,medium,highouauto, que equivale amedium).
O Realtime trata interrupções com interrupt_response. O GPT-Live não precisa dessa configuração, porque já está escutando enquanto fala.
Transportes. Ambos suportam WebRTC no navegador e WebSocket no servidor. As chamadas telefônicas são diferentes. Segundo o guia de SIP, o GPT-Live suporta SIP de entrada e de saída, e as chamadas de saída estão “disponíveis para todas as organizações através da Live API, não do endpoint de criação de chamadas da Realtime API”. Uma chamada SIP conectada ao GPT-Live é limitada a 2 horas. O guia de SIP do Realtime cobre chamadas de entrada através do webhook realtime.call.incoming.
Limites e contexto
| Limite | GPT-Live-1.1 | gpt-realtime-2.1 |
|---|---|---|
| Contexto | 128.000 tokens por sessão, gerenciado automaticamente | 128.000 tokens |
| Máximo de tokens de saída | Não publicado | 32.000 |
| Instruções | Até 16.384 tokens | Não publicado |
| Limites de taxa | Sessões simultâneas, por modelo | 400 RPM e 200.000 TPM no tier Build |
O GPT-Live conta concorrência, não tokens. A página do GPT-Live-1 lista 50 sessões simultâneas no Build, 300 no Launch e 500 no Grow, sem acesso no tier Free. O GPT-Live-1.1 tem seu próprio limite separado, e sua página ainda não publica números, então confira a página de limites da sua organização antes de um lançamento.
Os limites do Realtime escalam até 10.000 RPM no Launch e 20.000 RPM no Grow.
Qual API de voz da OpenAI você deve usar?
Use o GPT-Live-1.1 quando a voz for uma camada sobre um agente que você já confia, e use o Realtime quando o modelo de voz deve ser o agente.
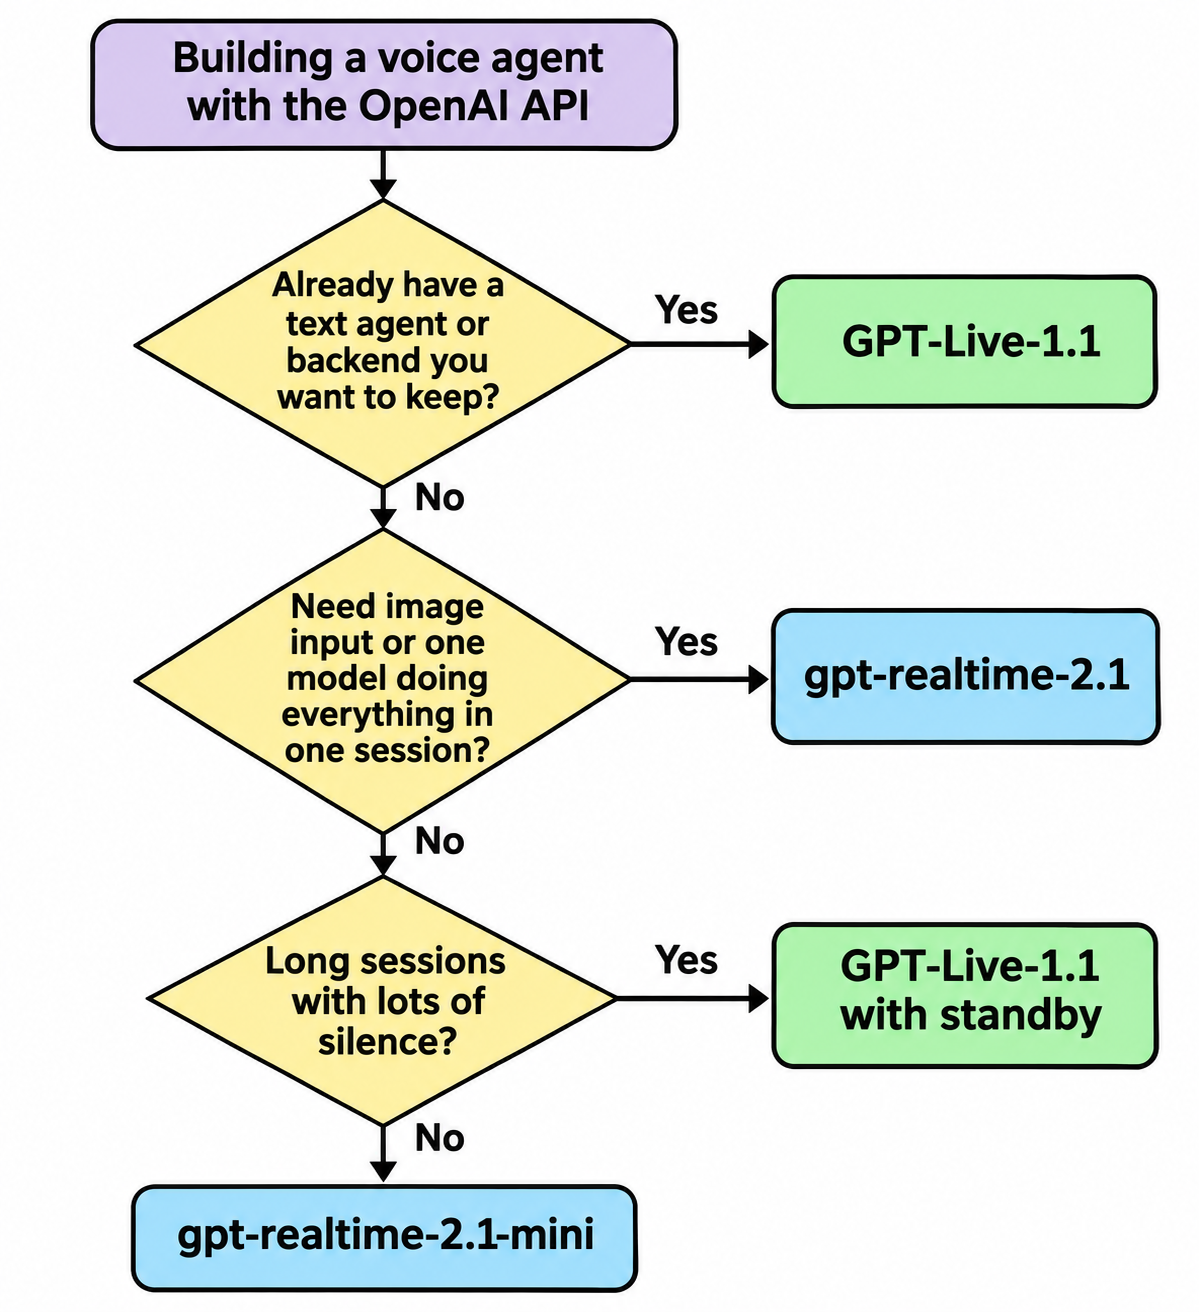
Escolha o GPT-Live-1.1 para:
- Adicionar voz a um agente de texto, bot de suporte ou fluxo de trabalho existente sem reconstruí-lo.
- Sessões longas com pausas, como tutoria, coaching ou companheiros virtuais, onde o standby compensa.
- Chamadas telefônicas de saída, que apenas a Live API oferece.
- Conversas que precisam de sobreposição natural de fala e feedback.
Escolha o gpt-realtime-2.1 para:
- Agentes de voz autocontidos, onde um único modelo deve raciocinar e agir.
- Apps que enviam imagens junto com a fala.
- Equipes que querem um único fluxo de eventos e uma única fatura.
Escolha o gpt-realtime-2.1-mini para tarefas de voz curtas, de alto volume e baixo custo, onde preços por token ganham dos por minuto. Nosso guia da GPT-Realtime-2 API cobre a configuração do Realtime em profundidade.
Deixe seu agente de programação testar a API de ferramentas com o Apidog CLI
Seja qual for a stack vencedora, ambas chamam a mesma coisa: sua API de ferramentas. Uma consulta lenta é silêncio do outro lado da linha de qualquer jeito, então teste a latência e o contrato dela antes que qualquer interlocutor a escute. Deixe o Claude Code, o Codex ou o Cursor fazerem isso com o Apidog CLI.
Configure uma vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Depois dê um único prompt ao seu agente:
Import ./voice-tools-openapi.yaml into Apidog project <projectId>. Build a test scenario
that calls GET /orders/{order_id} and GET /customers/{id} in sequence, asserts 200 and
the fields my voice agent reads aloud, and fails any request slower than 800 ms.
Run it 20 times against staging and tell me which step is slowest.
O agente importa a spec, verifica o formato do payload, monta o cenário e o executa:
apidog import --project <projectId> --format openapi --file ./voice-tools-openapi.yaml
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <projectId> --file scenario.json
apidog test-scenario import-steps <scenarioId> --project <projectId> --source endpoint --ids <endpointIds> --sync manual
apidog run -t <scenarioId> --project <projectId> -e <envId> -n 20 --timeout-request 800 -r cli,json
-n 20 repete a execução para que uma resposta sortuda não esconda uma cauda lenta, e --timeout-request 800 falha qualquer chamada lenta o bastante para deixar alguém esperando. Troque -r cli,json por -r junit no CI para que uma regressão bloqueie o deploy, como mostra nosso guia de CI/CD do Apidog CLI. Novo no fluxo de trabalho com agentes? Comece com o Apidog CLI no Claude Code. O plano Free do Apidog cobre até 4 usuários.
Perguntas frequentes
Qual é mais barato, GPT-Live-1.1 ou GPT-Realtime? Depende dos seus tokens de áudio por minuto e do seu backend. A voz do GPT-Live custa US$ 0,05 por minuto ativo mais os tokens do modelo backend. No gpt-realtime-2.1, US$ 0,05 compra cerca de 1.560 tokens de áudio de entrada ou 780 tokens de áudio de saída. Compare com seus próprios logs de uso.
Posso usar chamada de funções com o GPT-Live-1.1? Sim, por delegação. Coloque ferramentas de função em delegation.responses.tools, ou rode o backend você mesmo no modo de delegação client. O modelo de voz não aceita uma lista de ferramentas direta como o session.tools do Realtime.
O GPT-Realtime suporta cobrança por standby? Não. O standby a US$ 0,02 por minuto é um recurso do GPT-Live, e apenas para sessões WebRTC configuradas com wake_policy e idle_timeout_s. O Realtime cobra os tokens que cada sessão usa.
O GPT-Live-1.1 pode fazer chamadas telefônicas de saída? Sim. Crie uma sessão com transport.type: "sip" e os dados do seu trunk SIP em POST /v1/live/sessions. A documentação da OpenAI diz que o SIP de saída funciona através da Live API, não do endpoint de criação de chamadas da Realtime API.
O GPT-Live-1.1 aceita entrada de imagem? Não. A página do modelo lista áudio e texto na entrada e na saída. Se o seu agente de voz precisa ver imagens, o gpt-realtime-2.1 aceita entrada de imagem a US$ 5 por 1M de tokens.