
O preço do GPT-Live-1.1 é baseado em tempo, não em tokens. A OpenAI cobra a sessão de voz a $0,05 por minuto ativo e $0,02 por minuto em standby, cobrados por segundo, sem arredondamento para o minuto seguinte. O modelo de backend e as chamadas de ferramentas são cobrados separadamente, nas tarifas normais. Uma hora de conversa ininterrupta custa $3,00 em cobranças de voz; uma hora parada em standby custa $1,20.
A tabela de preços é curta. O que importa é o comportamento dela em um aplicativo real, em que os chamadores fazem pausas, os backends demoram a responder e as sessões ficam abertas por tempo demais. Abaixo estão três exemplos práticos e as configurações que mantêm a fatura previsível.
Preços do GPT-Live-1.1 em resumo
O GPT-Live-1.1 tem duas tarifas de voz e uma cobrança separada para o backend. Veja o que a página do modelo GPT-Live-1.1 e a página de preços da OpenAI listam em 20 de novembro de 2026:
| Cobrança | Tarifa | Por hora | Observações |
|---|---|---|---|
| Tempo de sessão ativo | $0,05 por minuto | $3,00 | Fala, silêncio antes do idle timeout, espera por trabalho do backend |
| Tempo de sessão em standby | $0,02 por minuto | $1,20 | Apenas WebRTC, enquanto a inferência está pausada |
| Modelo Responses de backend | Tarifas normais de token | Varia | O modelo que você escolher para a delegação |
| Ferramentas hospedadas | Tarifas normais de ferramentas | Varia | Web search, file search, Code Interpreter e outras |
Três detalhes importam mais do que as tarifas de destaque:
- Cobrança por segundo. Uma chamada de 90 segundos custa $0,075, e não $0,10; a duração não é arredondada para um minuto inteiro.
- Mesmo preço do GPT-Live-1. Ambos os modelos compartilham tarifas idênticas, então fazer upgrade não altera a fatura de voz.
- Tarifa de inicialização de 15 segundos. Criar uma sessão WebRTC cobra 15 segundos durante a inicialização, valor creditado quando a sessão começa a rodar. Só custa extra nas sessões que você cria e abandona.
Para contexto sobre as stacks de voz, consulte GPT-Live vs GPT-Realtime.
O que conta como minutos ativos vs. em standby
Minutos ativos são todo o tempo em que a inferência está em execução. Minutos em standby são o tempo em que uma sessão WebRTC permanece conectada com a inferência pausada, aguardando fala. A diferença de $0,03 por minuto entre eles decide a maior parte da sua fatura de voz.
O guia de custos da OpenAI detalha o que cai na categoria de tempo ativo:
- Tempo em que o usuário ou o modelo está falando.
- Silêncio antes de o idle timeout expirar.
- Tempo de espera por trabalho do backend enquanto a inferência está em execução.
Silenciar o microfone não aciona o standby; a sessão continua sendo cobrada a $0,05 por minuto.
O standby exige duas configurações na criação da sessão, documentadas no guia de conversas ao vivo:
{
  "session": {
    "model": "gpt-live-1.1",
    "wake_policy": { "type": "speech", "vad_threshold": 0.5 },
    "idle_timeout_s": 15
  }
}
wake_policy.type: "speech" instrui a sessão a aguardar fala antes de iniciar a inferência. idle_timeout_s aceita um número inteiro de 5 a 60 e devolve a sessão ao standby após esse número de segundos sem uma transcrição de entrada ou saída. Se omitir o timeout, a inferência permanece ativa até o fim da sessão, e você nunca obtém a tarifa de standby.
Duas ressalvas: o standby é exclusivo do WebRTC, então sessões WebSocket e SIP são cobradas por cada segundo conectado na tarifa ativa, e a primeira resposta após o standby pode demorar mais.
Exemplos práticos de custos
As tarifas de voz são as publicadas; as contagens de tokens do backend são premissas ilustrativas. Os preços do backend vêm da página de preços da OpenAI: gpt-6-luna a $0,10 de entrada e $0,50 de saída por 1M de tokens, gpt-6-sol a $2,00 de entrada e $10,00 de saída por 1M de tokens (camada padrão, contexto curto). O guia de delegação da OpenAI sugere começar com o gpt-6-luna e experimentar o gpt-6-sol para tarefas de backend mais complexas.
Exemplo 1: uma linha de suporte ao cliente
Uma chamada de suporte por telefone ou WebSocket dura 6 minutos. O standby não se aplica, então os 6 minutos inteiros são cobrados como ativos. O GPT-Live delega 4 consultas ao gpt-6-luna, cada uma usando cerca de 6.000 tokens de entrada e 400 de saída.
| Item | Cálculo | Custo |
|---|---|---|
| Voz | 6 min x $0,05 | $0,30 |
| Entrada do backend | 24.000 tokens x $0,10 / 1M | $0,0024 |
| Saída do backend | 1.600 tokens x $0,50 / 1M | $0,0008 |
| Por chamada | $0,3032 |
Com 10.000 chamadas por mês, isso dá cerca de $3.032, sendo $3.000 só de tempo de voz. Reduzir 30 segundos da chamada média economiza mais do que a fatura inteira do backend.
Exemplo 2: um tutor de idiomas no navegador
Uma sessão de tutoria WebRTC de 30 minutos com idle_timeout_s definido como 15. O aluno passa longos períodos lendo e pensando, então a sessão roda 18 minutos em modo ativo e 12 em standby. O tutor delega 10 explicações ao gpt-6-sol, com cerca de 8.000 tokens de entrada e 600 de saída cada.
| Item | Cálculo | Custo |
|---|---|---|
| Voz ativa | 18 min x $0,05 | $0,90 |
| Voz em standby | 12 min x $0,02 | $0,24 |
| Entrada do backend | 80.000 tokens x $2,00 / 1M | $0,16 |
| Saída do backend | 6.000 tokens x $10,00 / 1M | $0,06 |
| Por sessão | $1,36 |
Sem standby, os mesmos 30 minutos de voz custariam $1,50 em vez de $1,14, ou seja, o standby reduz a fatura de voz em 24%.
Exemplo 3: um assistente de desktop sempre ativo
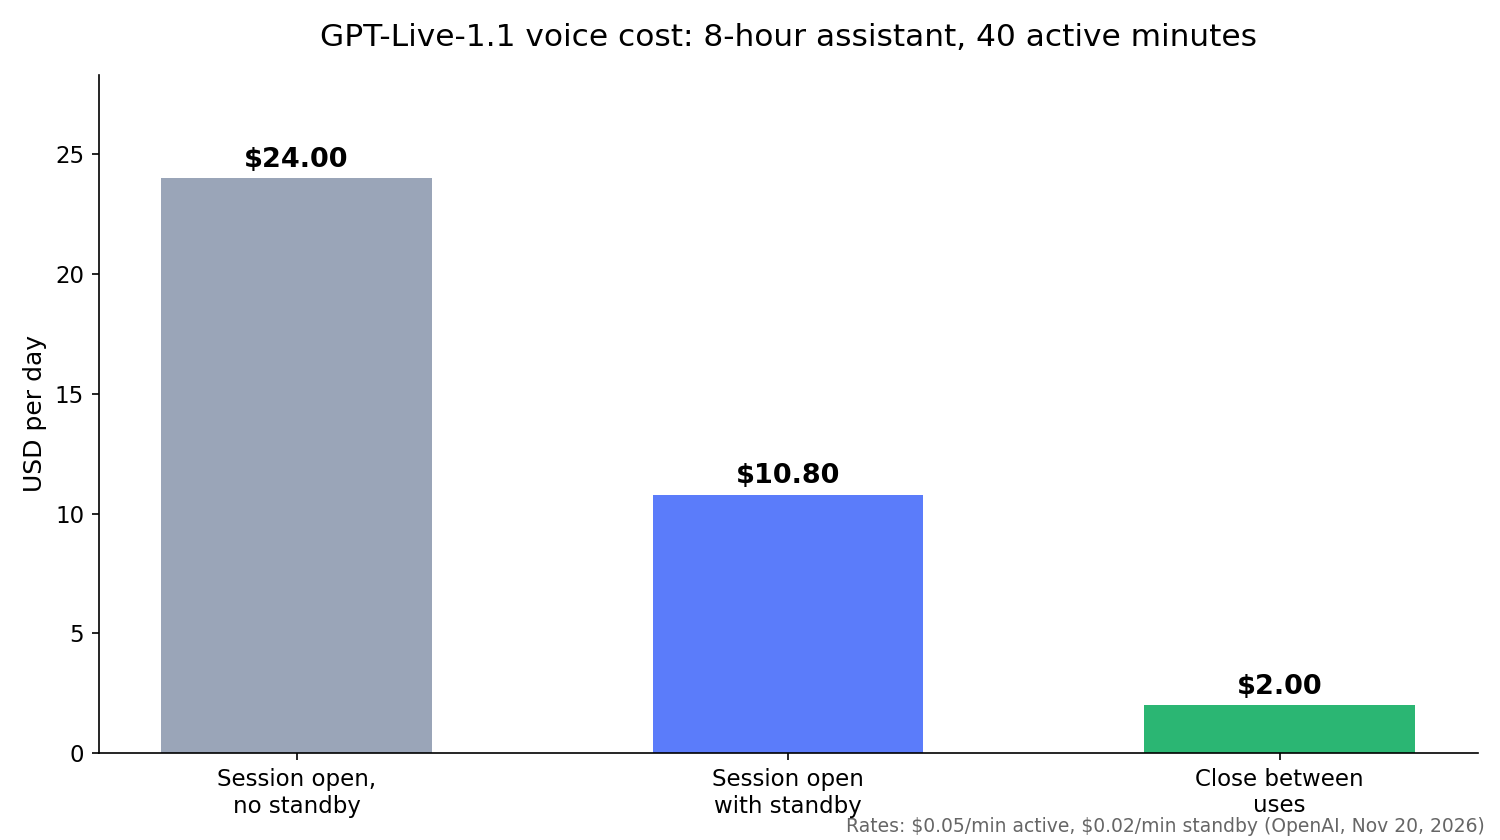
Um assistente fica aberto durante um dia de trabalho de 8 horas, mas o usuário só conversa com ele por 40 minutos, em rajadas curtas. Aqui, a estratégia escolhida muda a fatura em mais de 10x:
| Estratégia | Cálculo | Por dia | Por mês de 22 dias |
|---|---|---|---|
| Sessão aberta, sem standby | 480 min x $0,05 | $24,00 | $528,00 |
| Sessão aberta com standby | 40 x $0,05 + 440 x $0,02 | $10,80 | $237,60 |
| Fechar entre os usos | 40 min x $0,05 | $2,00 | $44,00 |
O standby ainda custa $1,20 por hora ociosa. O guia da OpenAI recomenda fechar a sessão durante longas pausas e iniciar uma nova, alimentada com o histórico salvo, quando o usuário voltar. A tarifa de inicialização de 15 segundos é creditada assim que a nova sessão roda, então, considerando apenas as cobranças de voz, fechar vence. Você abre mão do despertar instantâneo: uma sessão fechada não consegue ouvir o usuário, então é preciso usar push-to-talk ou o seu próprio gatilho de ativação.
Como o idle timeout afeta a sua fatura
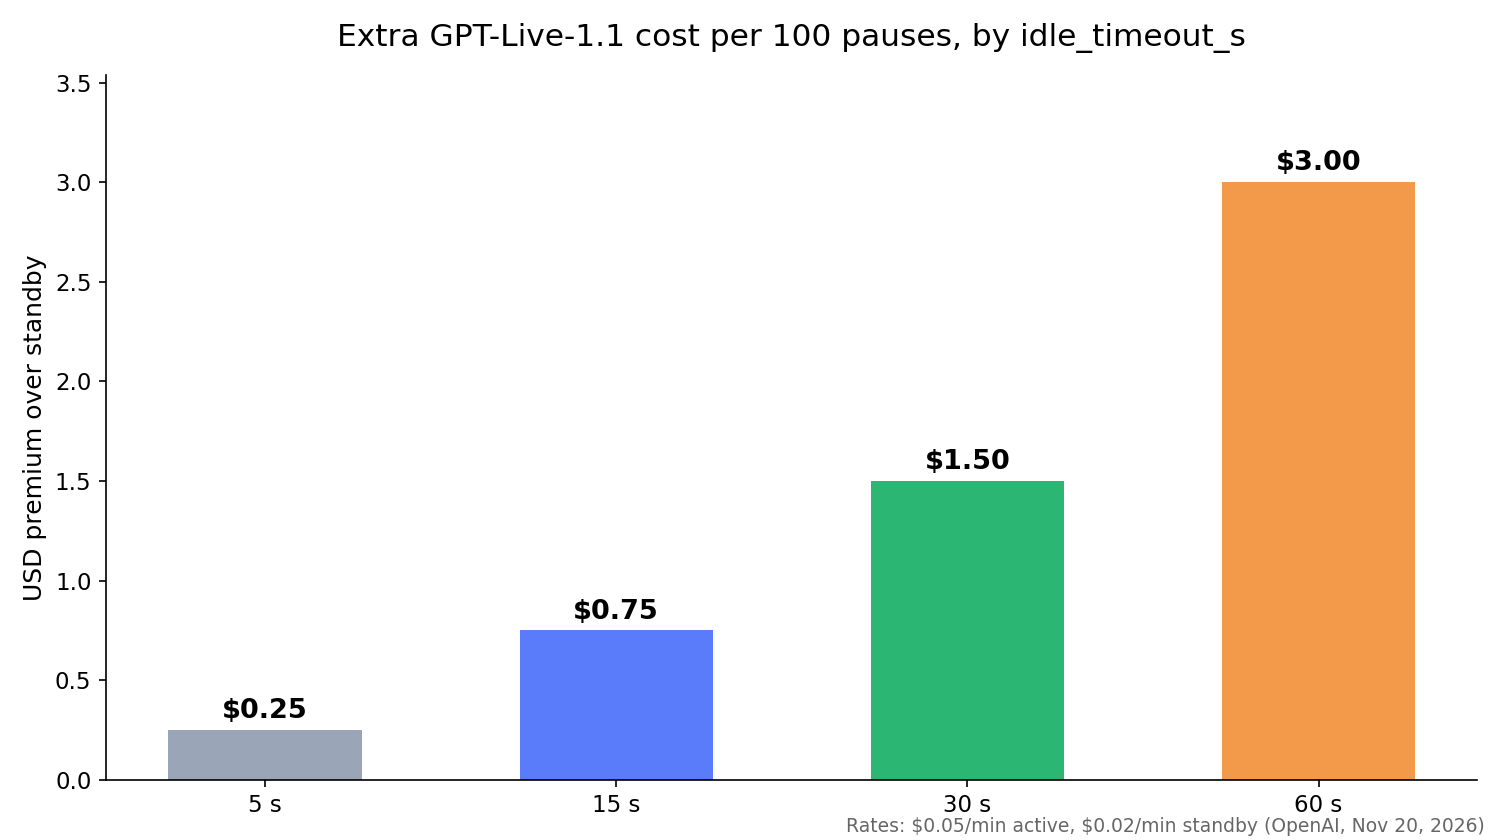
Cada pausa custa tempo ativo até o idle timeout ser acionado. Um timeout mais curto chega antes à tarifa mais barata de standby, ao custo de mais ciclos de pausa e retomada e de uma primeira resposta mais lenta após cada um deles.
O sobrecusto por pausa é o comprimento do timeout cobrado pela diferença de $0,03 entre as duas tarifas. Ao longo de 100 pausas em uma sessão ou em um dia:
idle_timeout_s |
Segundos ativos por pausa | Sobrecusto sobre o standby, por 100 pausas |
|---|---|---|
| 5 | 5 | $0,25 |
| 15 | 15 | $0,75 |
| 30 | 30 | $1,50 |
| 60 | 60 | $3,00 |
Números pequenos, e é justamente esse o ponto: o timeout é, sobretudo, uma configuração de experiência do usuário. Escolha um valor que não interrompa os usuários no meio do raciocínio e deixe o standby cobrir pausas longas e o fechamento de sessão cobrir as muito longas.
Como o preço do GPT-Live-1.1 se compara ao do GPT-Realtime
O GPT-Live-1.1 cobra por minuto; os modelos GPT-Realtime cobram por token. A página de preços da OpenAI lista o áudio do gpt-realtime-2.1 a $32,00 por 1M de tokens de entrada e $64,00 por 1M de tokens de saída, e o áudio do gpt-realtime-2.1-mini a $10,00 e $20,00.
| GPT-Live-1.1 | GPT-Realtime-2.1 | |
|---|---|---|
| Unidade de cobrança | Segundos de sessão | Tokens de entrada e saída |
| Tarifa de voz | $0,05/min ativo, $0,02/min standby | $32 / $64 por 1M de tokens de áudio |
| Raciocínio e ferramentas | Modelo de backend separado | Dentro do mesmo modelo |
| Curva de custo | Fixa por minuto | Aumenta por turno conforme o contexto cresce |
O guia de custos da OpenAI observa que uma sessão Realtime envia a conversa inteira ao modelo em cada resposta, então os turnos seguintes custam mais. Um minuto de GPT-Live custa o mesmo no minuto 2 e no minuto 40, o que torna as previsões simples. Nosso guia da API GPT-Realtime-2 aborda a configuração baseada em tokens.
Acompanhe o uso e evite faturas surpresa
O GPT-Live reporta o uso acumulado de voz em segundos por meio dos eventos session.usage.updated:
{
  "type": "session.usage.updated",
  "usage": { "seconds": 12 },
  "context_window": { "usage_ratio": 0.42 }
}
Cada atualização substitui o total anterior, portanto nunca os some. Envie session.close, aguarde o session.closed e registre o usage.seconds final. Para separar ativo de standby, meça os intervalos entre os eventos session.paused e session.resumed.
Hábitos que mantêm os custos estáveis:
- Feche sessões concluídas. Uma sessão aberta e abandonada continua sendo cobrada.
- Acelere o backend. Esperar por uma tarefa delegada é tempo ativo; terminar um minuto mais cedo economiza $0,05.
- Feche durante trabalhos longos. Feche a voz enquanto o backend trabalha e reabra quando o resultado estiver pronto.
- Planeje a concorrência. Os limites contam sessões concorrentes, e o GPT-Live-1.1 tem um limite separado do GPT-Live-1, cujos limites publicados são 50 (Build), 300 (Launch) e 500 (Grow). A camada Free não é suportada.
Deixe o Codex testar o seu registro de custos com o Apidog CLI
Seu registro de uso é um código que você mesmo mantém, e um bug nele precifica errado toda chamada. Teste-o em cada commit sem abrir uma sessão de voz, a $0 em tempo de voz, e deixe o seu agente de programação executar os testes com o Apidog CLI.
Instale o CLI, faça login e adicione a skill do Apidog ao seu agente:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # escolha seu agente quando solicitado
Depois, dê ao Codex um único prompt:
In Apidog project <projectId>, create a test case for POST /api/voice-usage.
Send {"session_id":"test-1","active_seconds":90,"standby_seconds":30} and assert
the response cost is 0.085 (90 s at $0.05/min plus 30 s at $0.02/min).
Add a second case with standby_seconds 0 that expects 0.075. Run both against
the local environment and summarize any failures.
O agente lê o schema, valida o payload, cria os casos e os executa:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Troque -r cli,json por -r junit e a mesma execução se integra ao CI; consulte executar o Apidog CLI em um pipeline de CI/CD. O guia Apidog CLI no Codex cobre a configuração do agente. O plano Free do Apidog atende equipes de até 4 usuários.
FAQ
Quanto custa o GPT-Live-1.1 por minuto? $0,05 por minuto ativo e $0,02 por minuto em standby, cobrados por segundo. O uso do backend é adicional.
O GPT-Live-1.1 é mais caro que o GPT-Live-1? Não. A OpenAI lista ambos com as mesmas tarifas ativas e de standby.
O standby funciona em chamadas telefônicas? Não. A tarifa mais baixa de standby se aplica apenas a sessões WebRTC enquanto a inferência está pausada. Sessões WebSocket e SIP cobram o tempo conectado na tarifa ativa.
As chamadas do modelo de backend estão incluídas no preço por minuto? Não. As chamadas delegadas ao Responses são cobradas pelas tarifas de token do modelo escolhido, mais os custos das ferramentas.
O que aconteceu com a pergunta sobre a API do GPT-Live de julho? Naquela época, o GPT-Live era um recurso de voz do ChatGPT sem API, como nosso artigo sobre a API do GPT-Live observou na ocasião. O GPT-Live-1.1 é o modelo de API, servido em v1/live/sessions.