
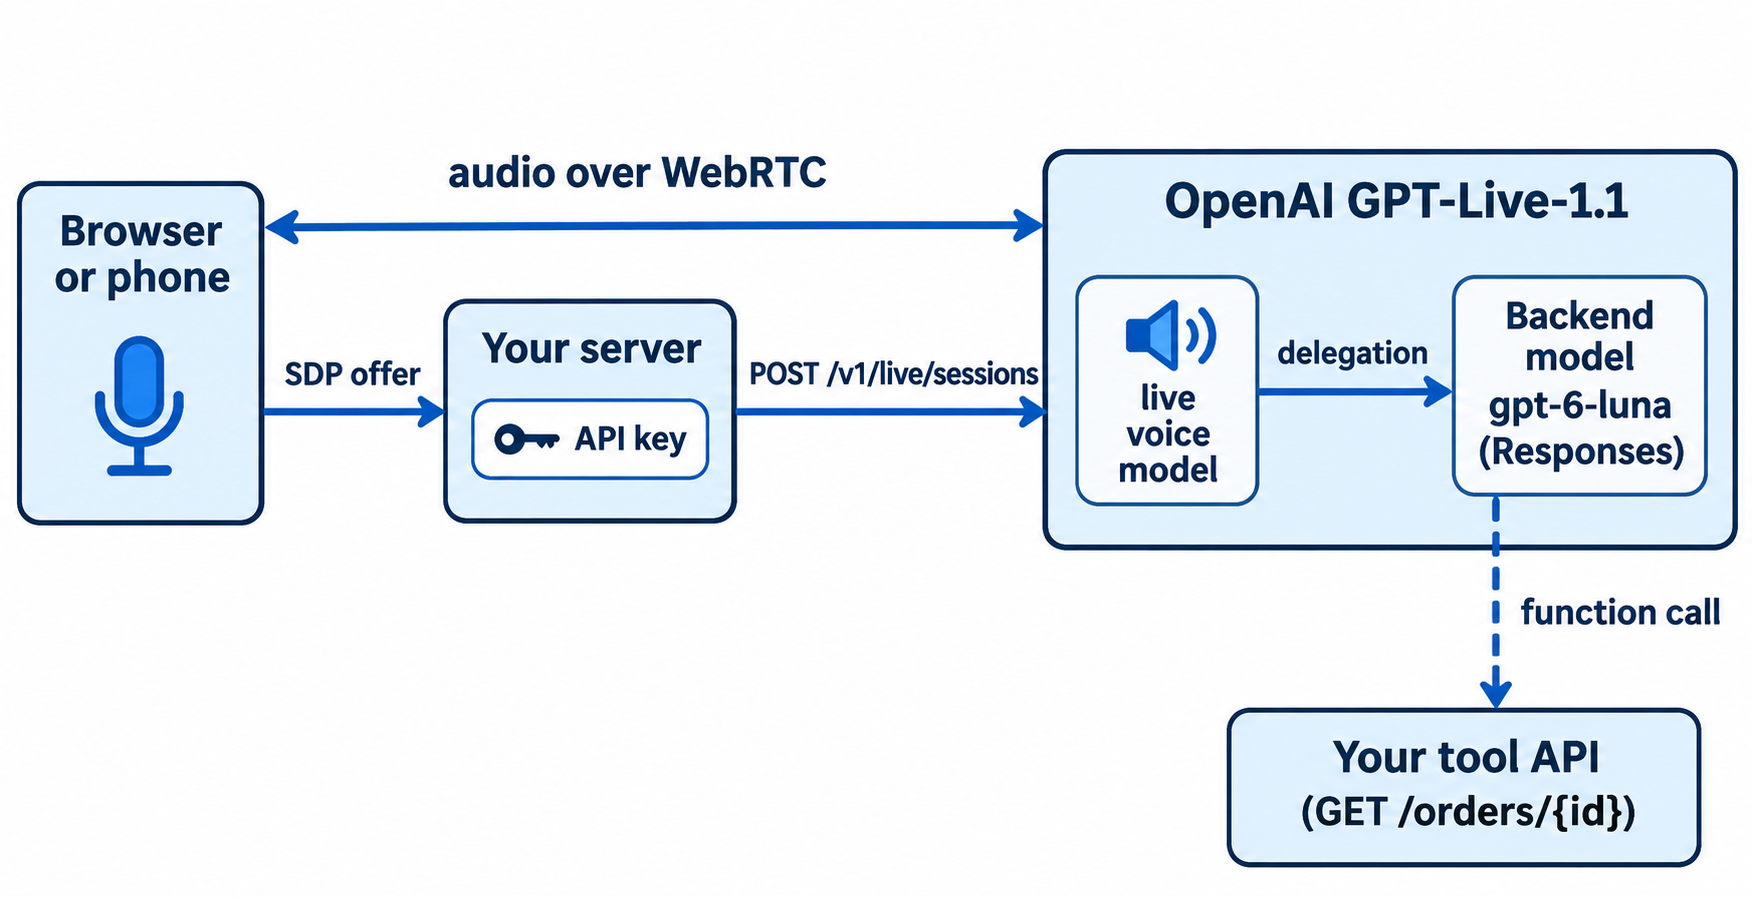
A API GPT-Live-1.1 é o modelo de voz full-duplex da OpenAI, servido em v1/live/sessions. Você abre uma sessão via WebRTC, WebSocket ou SIP, envia uma configuração session com o modelo, as instruções e a voz, e deixa que ela encaminhe o raciocínio e as chamadas de ferramentas para um modelo Responses no backend por meio da delegação. Custa US$ 0,05 por minuto ativo e US$ 0,02 por minuto em espera.
A OpenAI disponibilizou o GPT-Live-1.1 na API em 20 de novembro de 2026, conforme o anúncio da OpenAI Developers. Se você leu nossa cobertura de julho, Existe uma API GPT-Live? respondia “ainda não”. Isso mudou. Este guia o conduz por uma sessão funcional, uma configuração de delegação, uma ferramenta de função e uma estrutura de testes para o backend que seu agente de voz chama.
O que é a API GPT-Live-1.1?
O GPT-Live-1.1 é um modelo de fala-entrada, fala-saída que ouve enquanto fala. Ele roda no endpoint v1/live/sessions, não em v1/realtime ou v1/responses. Sua função própria é a conversa. O raciocínio mais pesado e o uso de ferramentas ficam a cargo de um modelo de backend que você configura, para que a voz continue responsiva enquanto o trabalho é executado.
Veja o que a página do modelo GPT-Live-1.1 lista atualmente:
| Item | GPT-Live-1.1 |
|---|---|
| ID do modelo | gpt-live-1.1 (um snapshot) |
| Entrada / saída | Áudio e texto de entrada, áudio e texto de saída |
| Endpoint | Apenas v1/live/sessions |
| Transportes | WebRTC (recomendado), WebSocket, SIP |
| Preço ativo | US$ 0,05 por minuto |
| Preço em espera | US$ 0,02 por minuto (WebRTC, inferência pausada) |
| Modelo de backend e ferramentas | Cobrados separadamente nas tarifas normais |
| Concorrência | Limite separado do GPT-Live-1, por organização |
Para o contexto do produto, veja o que é o GPT-Live e como ele se diferencia do GPT Realtime.
GPT-Live-1.1 vs GPT-Live-1: o que mudou
A página do modelo e o guia de prompting listam quatro diferenças práticas:
- Transcrição: o 1.1 “transcreve a fala com mais precisão”.
- Voz: o 1.1 mantém “um sotaque e uma voz mais consistentes entre idiomas”.
- Prompts de delegação: o 1.1 aceita linguagem natural (“Delegue ao backend quando:”). O GPT-Live-1 exige o marcador
<|SpawnThinking|>em sua política. - Redação do faturamento: o GPT-Live-1 é cobrado por segundo e nunca arredonda para um minuto inteiro. A página do 1.1 diz apenas “cobrado por duração”.
Os dois modelos compartilham o mesmo endpoint, preços e estrutura de sessão, então migrar para o 1.1 é basicamente uma mudança na string do modelo mais um prompt mais limpo.
Como abrir uma sessão GPT-Live-1.1
O guia de primeiros passos do GPT-Live recomenda WebRTC para áudio em navegador, dispositivos móveis e servidores. O WebSocket é o caminho mais simples para um protótipo no servidor, então comece por ele:
- Abra
wss://api.openai.com/v1/live/sessionscomAuthorization: Bearer $OPENAI_API_KEYe sem parâmetros de consulta. - Envie
session.startcomo primeira mensagem, com sua configuraçãosession. - Aguarde
session.startedantes de enviar áudio. - Transmita o áudio no formato escolhido. O padrão é PCM de 24 kHz.
import WebSocket from "ws";

const ws = new WebSocket("wss://api.openai.com/v1/live/sessions", {
  headers: { Authorization: `Bearer ${process.env.OPENAI_API_KEY}` },
});

ws.on("open", () => {
  ws.send(JSON.stringify({
    type: "session.start",
    event_id: "start_1",
    session: {
      model: "gpt-live-1.1",
      instructions: "You are the voice agent for Acme order support. Keep answers short.",
      audio: {
        format: { type: "audio/pcm", rate: 24000 },
        output: { voice: "marin" },
      },
    },
  }));
});

ws.on("message", (raw) => {
  const msg = JSON.parse(raw);
  if (msg.type === "session.started") console.log("Session ready");
});
Algumas regras de configuração do guia de conversação:
instructionsaceita até 16.384 tokens. Adicione mais no meio da sessão comsession.instructions.append(500 tokens por append).audio.output.voicetem como padrãomarin. Outros nomes da API incluemquartz,stone,meridianewillow.- Os formatos WebSocket são
audio/pcma 24.000 ou 16.000 Hz, eaudio/pcmuouaudio/pcmaa 8.000 Hz para telefonia. storetem como padrãofalse. Alterar omodelexige uma nova sessão.
Para produção em navegador, troque para WebRTC. Seu servidor guarda a chave da API e repassa a oferta SDP do navegador:
const res = await fetch("https://api.openai.com/v1/live/sessions", {
  method: "POST",
  headers: {
    Authorization: `Bearer ${process.env.OPENAI_API_KEY}`,
    "Content-Type": "application/json",
  },
  body: JSON.stringify({
    session: { model: "gpt-live-1.1", instructions: "..." },
    transport: { type: "webrtc", sdp: offerSdp },
  }),
});
const { session, transport } = await res.json(); // HTTP 201
// session.id looks like "live_123"; return transport.sdp to the browser
Deixe audio.format de fora das requisições WebRTC, e não envie session.start no canal de dados. Observe um detalhe de faturamento: criar uma sessão WebRTC cobra 15 segundos durante a inicialização, com crédito assim que a sessão entrar em execução.
Delegação no GPT-Live-1.1: deixe um modelo de backend fazer o raciocínio
A delegação é a razão de existir desta API. O modelo de voz continua falando enquanto um modelo de backend raciocina, busca informações ou chama ferramentas. Você escolhe um de dois modos na criação da sessão, e não é possível trocar de modo durante a sessão.
| Modo | delegation.type |
Quem executa o backend | Melhor para |
|---|---|---|---|
| Responses | "responses" |
OpenAI, usando o modelo e as ferramentas que você configura | A maioria dos apps; ferramentas hospedadas, function calling |
| Client | "client" (também o padrão) |
Seu aplicativo | Seu próprio loop de agente ou um backend que não seja da OpenAI |
O guia de delegação sugere começar com gpt-6-luna e experimentar gpt-6-sol para tarefas de backend mais difíceis. Se você ainda não escolheu um, nossa visão geral do GPT-6 Luna cobre os trade-offs.
"delegation": {
  "type": "responses",
  "responses": {
    "model": "gpt-6-luna",
    "instructions": "Look up orders with get_order. Answer in one sentence.",
    "tools": [{ "type": "web_search" }],
    "tool_choice": "auto",
    "parallel_tool_calls": false
  }
}
O bloco responses também aceita max_output_tokens (16 ou mais), service_tier (auto, default, flex ou priority, em que priority é o modo rápido) e as configurações de reasoning e text que seu modelo de backend suportar. Você pode alterar esses campos durante a sessão com session.update. A validação é assíncrona: uma configuração inválida chega como um error com o código responses_validation_failed, e a sessão permanece aberta.
Depois, informe ao modelo de voz quando delegar. No 1.1, isso é feito em linguagem natural dentro de instructions:
Delegate to the backend when: the caller asks about an order, a refund or anything you must look up.
Do not delegate when: the caller greets you, asks you to repeat, or says goodbye.
While the backend works, briefly say what you are checking.
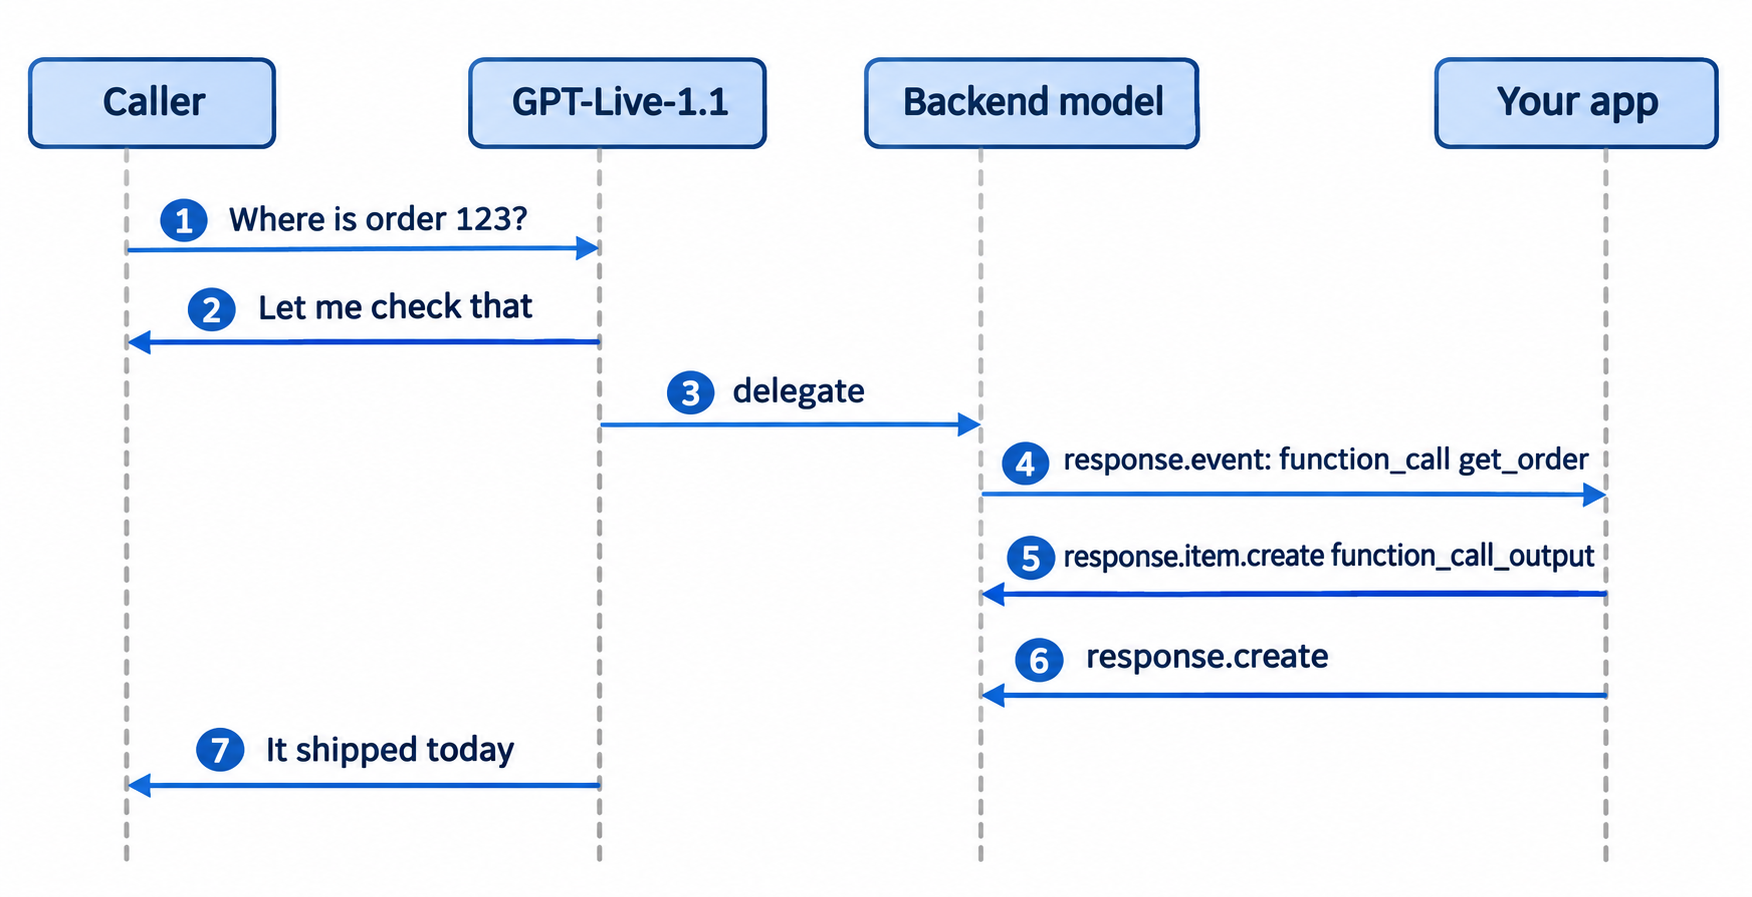
O guia de prompting alerta que um “Estou verificando isso” falado não prova que o trabalho do backend começou. Em vez disso, observe session.delegation.created nos seus logs.
Adicionar function calling a uma sessão GPT-Live-1.1
Ferramentas hospedadas como a busca na web rodam dentro da OpenAI. Suas próprias funções rodam no seu aplicativo. Coloque uma ferramenta de função padrão do Responses em delegation.responses.tools:
{
  "type": "function",
  "name": "get_order",
  "description": "Get the shipping status of an order by its ID.",
  "parameters": {
    "type": "object",
    "properties": { "order_id": { "type": "string" } },
    "required": ["order_id"],
    "additionalProperties": false
  },
  "strict": true
}
Os eventos do backend chegam até você encapsulados em um envelope response.event que carrega um delegation_id e um event aninhado. Uma chamada de função concluída chega como um response.output_item.done aninhado cujo item contém call_id, name e arguments. Execute a função, envie um response.item.create com o resultado e, então, envie response.create:
ws.on("message", async (raw) => {
  const msg = JSON.parse(raw);
  if (msg.type !== "response.event") return;
  const ev = msg.event;
  if (ev.type !== "response.output_item.done" || ev.item?.type !== "function_call") return;

  const { order_id } = JSON.parse(ev.item.arguments);
  const order = await fetch(`${ORDERS_API}/orders/${order_id}`).then((r) => r.json());

  ws.send(JSON.stringify({
    type: "response.item.create",
    item: { type: "function_call_output", call_id: ev.item.call_id, output: JSON.stringify(order) },
  }));
  ws.send(JSON.stringify({ type: "response.create" }));
});
Três detalhes costumam confundir:
- Adicionar apenas o output não retoma o backend. Você precisa do
response.create. - Deixar de enviar um resultado pendente gera
function_call_outputs_required. Valores duplicados ou incompatíveis decall_idsão rejeitados. - Eventos
response.completedrepassados trazem umresponse.outputvazio. Leia os eventos individuais de output-item.
Preços e limites do GPT-Live-1.1
O tempo de voz é fácil de estimar. Uma chamada de suporte de 5 minutos que permanece ativa o tempo todo custa 5 × US$ 0,05 = US$ 0,25 em tempo de voz. Mil dessas custam US$ 250, mais o que o modelo de backend e as ferramentas cobrarem nas tarifas normais.
| Linha de custo | Tarifa |
|---|---|
| Voz ativa | US$ 0,05 por minuto |
| Voz em espera (WebRTC, inferência pausada) | US$ 0,02 por minuto |
| Inicialização WebRTC | 15 segundos, com crédito assim que a sessão entrar em execução |
| Modelo de backend e ferramentas | Preço normal do modelo e da ferramenta |
Os limites de taxa contam sessões simultâneas, não tokens. O GPT-Live-1.1 e o GPT-Live-1 têm limites separados que se aplicam em todas as regiões de inferência. A página do GPT-Live-1 lista 50, 300 e 500 sessões simultâneas para os planos Build, Launch e Grow, sem acesso no plano Free. A página do 1.1 não traz números, então verifique a página de limites da sua organização antes de um lançamento.
Deixe seu agente de codificação testar o backend de ferramentas com a Apidog CLI
Seu agente de voz é tão confiável quanto a API por trás do get_order. Uma resposta lenta ou malformada se transforma em silêncio ou em uma resposta errada dita em voz alta. Por isso, teste esse backend antes que qualquer chamador o ouça, e deixe seu agente de codificação fazer isso com a Apidog CLI.
Configure uma única vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Depois, dê ao Claude Code, Codex ou Cursor um único prompt:
Import ./orders-openapi.yaml into Apidog project <projectId>. Create test cases for
GET /orders/{order_id}: a known ID returns 200 with a status field in under 800 ms,
and an unknown ID returns 404 with a JSON error. Run them against the staging
environment and tell me what failed.
O agente lê o schema, valida seu payload, cria os casos de teste e os executa:
apidog import --project <projectId> --format openapi --file ./orders-openapi.yaml
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
O limite de 800 ms é importante para voz: o chamador ouve cada milissegundo que sua ferramenta leva. Coloque o mesmo apidog run com -r junit no CI para que uma regressão quebre o build, como mostrado em nosso guia de CI/CD da Apidog CLI. Novato no fluxo de trabalho com agentes? Comece com Apidog CLI no Claude Code. O plano Free da Apidog cobre até 4 usuários.
FAQ
O GPT-Live-1.1 está disponível na API? Sim. Desde 20 de novembro de 2026, você pode chamar gpt-live-1.1 em v1/live/sessions via WebRTC, WebSocket ou SIP. Ele não é servido em v1/realtime, v1/responses ou Chat Completions.
Quanto custa a API GPT-Live-1.1? US$ 0,05 por minuto ativo e US$ 0,02 por minuto em espera. As chamadas do modelo de backend e as ferramentas são cobradas separadamente em suas próprias tarifas.
Qual é a diferença entre GPT-Live-1.1 e GPT Realtime? O GPT-Live roda em um endpoint próprio, cobra pela duração da voz e encaminha o raciocínio a um modelo de backend por meio da delegação. O GPT Realtime roda em v1/realtime. Veja nossa comparação entre GPT-Live e GPT Realtime.
Qual modelo de backend devo usar para a delegação? O guia da OpenAI sugere gpt-6-luna para começar e gpt-6-sol para tarefas de backend mais complexas. Defina service_tier como priority se a latência importar mais que o custo.
Posso usar meu próprio agente em vez de um modelo Responses? Sim. Defina delegation.type como client. Seu aplicativo executa o trabalho do backend e envia os resultados de volta com session.commentary.append. Você também gerencia as transcrições por conta própria.
O GPT-Live-1.1 suporta function calling? Sim, por meio da delegação Responses. Defina as funções em delegation.responses.tools, leia as chamadas em response.event e retorne os resultados com response.item.create mais response.create.