A API GPT-Image-2.6 gera e edita imagens por meio de dois modelos da OpenAI, gpt-image-2.6-flare e gpt-image-2.6-sunburst. Envie um prompt para POST /v1/images/generations com sua chave de API e depois decodifique o b64_json da resposta. A versão 2.6 adiciona marcação de imagem, saída em SVG e GIF e um parâmetro complexity.
Este guia aborda autenticação, uma primeira geração, uma edição com marcação, exportação em SVG e as configurações de quality e complexity. Ele se concentra no que há de novo, então leia nosso guia da API gpt-image-2.5 para streaming e a ferramenta da Responses API, e nosso explicativo do ChatGPT Images 2.6 para conhecer o lançamento completo. Montamos cada requisição abaixo com base na documentação da OpenAI em 5 de novembro de 2026. Não as executamos com uma chave ativa, então teste-as antes de colocá-las em produção.
Visão geral da API GPT-Image-2.6
| Item | Detalhe |
|---|---|
| IDs dos modelos | gpt-image-2.6-flare, gpt-image-2.6-sunburst |
| Gerar | POST /v1/images/generations |
| Editar | POST /v1/images/edits |
| Autenticação | Authorization: Bearer $OPENAI_API_KEY |
| Saída | b64_json; PNG por padrão, além de JPEG, WebP, GIF, SVG |
quality |
low, medium, high, xhigh, max, auto (padrão) |
complexity |
low, medium, high (high se omitido) |
| Tarifas de tokens de imagem | US$ 8 de entrada, US$ 2 de entrada em cache, US$ 30 de saída por 1M |
| Tarifas de tokens de texto | US$ 5 de entrada, US$ 1,25 de entrada em cache por 1M |
As tarifas vêm da página de preços da OpenAI. Os dois modelos custam o mesmo por token, então escolha com base na velocidade e na precisão de edição.
Flare ou Sunburst: qual modelo você deve chamar?
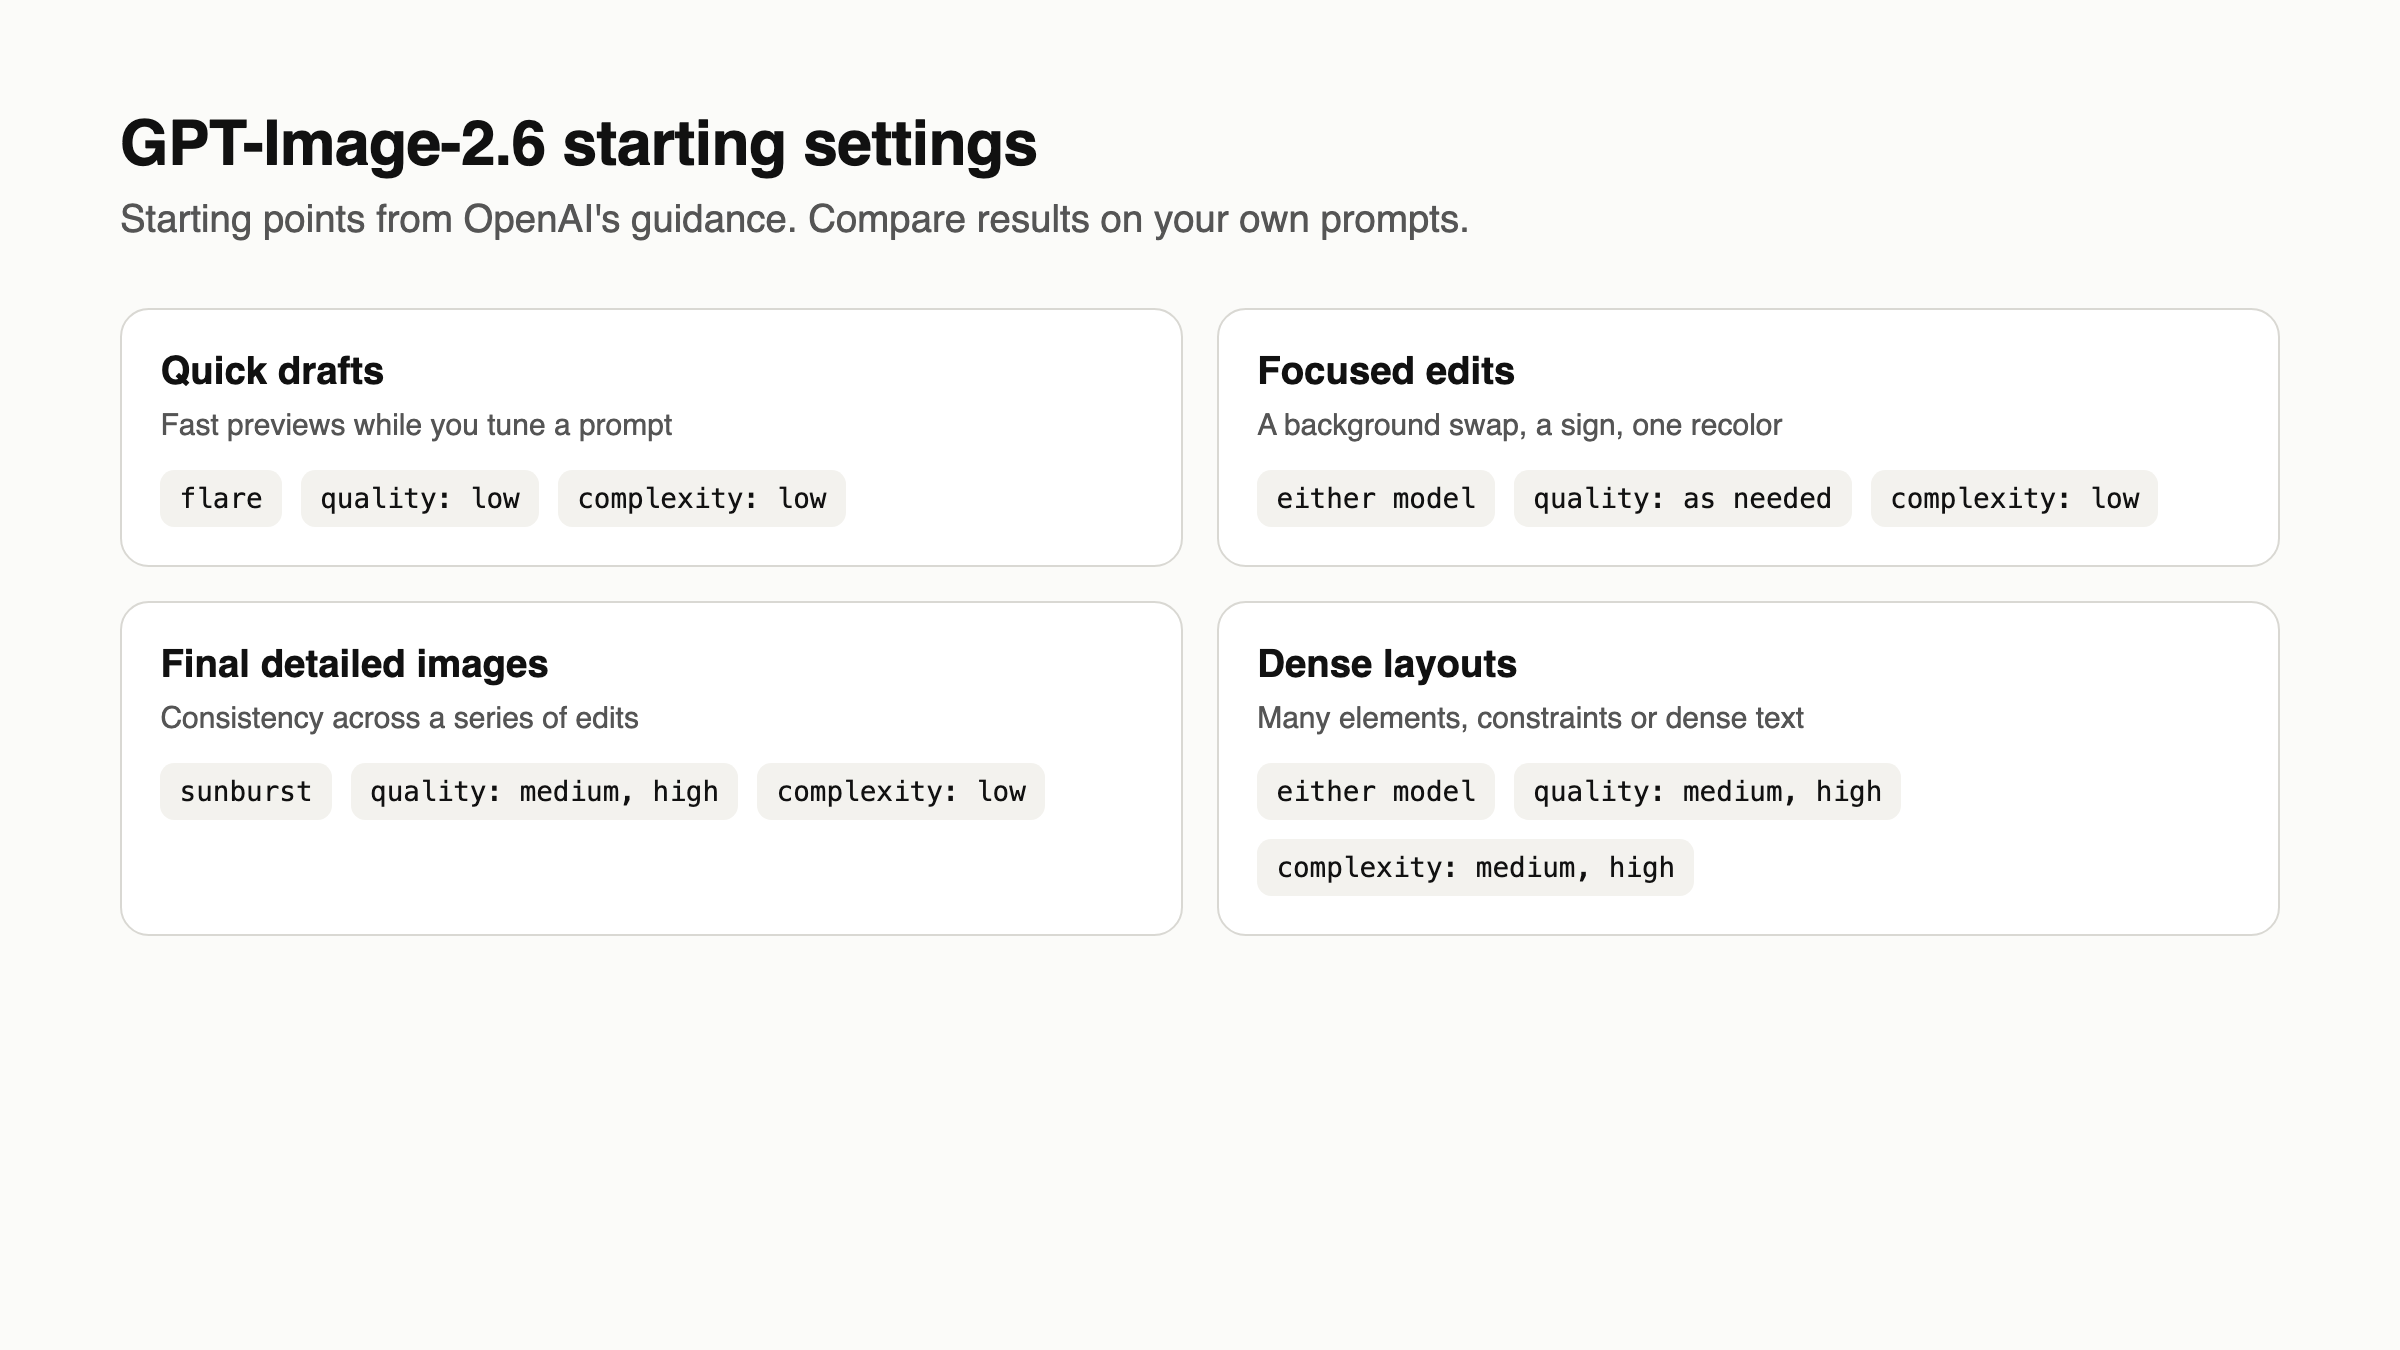
Use o Flare para iteração rápida e geração do dia a dia. A OpenAI afirma que ele pode retornar uma imagem em apenas seis segundos com qualidade low e que melhora o layout de pôsteres e imagens de produtos. Use o Sunburst para trabalhos detalhados e edições repetidas, em que a OpenAI alega melhor consistência com qualidade medium ou high.
Essas são alegações da OpenAI, não benchmarks independentes. Nossa comparação entre Flare e Sunburst na versão 2.5 explica essa divisão.
Autenticação e configuração
Você precisa de três coisas antes da sua primeira chamada:
- Crie uma chave de API no painel da OpenAI e exporte-a como
OPENAI_API_KEY. - Conclua a Verificação de Organização da API se sua organização precisar. A OpenAI afirma que talvez seja necessário fazê-la antes de usar os modelos GPT Image.
- Instale o
jqpara os exemplos com curl, ou o pacoteopenaipara Python.
Se seu app atende usuários individuais, envie também um safety_identifier com hash de até 128 caracteres. Ele substitui o parâmetro user, que está obsoleto.
Gere sua primeira imagem
Esta requisição usa o Flare com qualidade low, o que é adequado para rascunhos.
curl --fail-with-body --silent --show-error \
  https://api.openai.com/v1/images/generations \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2.6-flare",
    "prompt": "A minimal poster for a developer meetup, with the words SHIP IT in bold type",
    "size": "1024x1536",
    "quality": "low",
    "complexity": "low"
  }' | jq -er '.data[0].b64_json' | base64 --decode > poster.png
A mesma chamada em Python:
import base64
from pathlib import Path
from openai import OpenAI

client = OpenAI()

result = client.images.generate(
    model="gpt-image-2.6-sunburst",
    prompt="A product shot of a ceramic mug on a walnut desk, soft morning light",
    size="1536x1024",
    quality="medium",
    extra_body={"complexity": "low"},
)

Path("mug.png").write_bytes(base64.b64decode(result.data[0].b64_json))
Passamos complexity por meio de extra_body para que a chamada não dependa de a sua versão do SDK expô-lo como argumento nomeado. Os modelos GPT Image sempre retornam base64, então não envie response_format nem procure um campo url.
O guia da OpenAI recomenda ler o objeto usage da resposta para medir o uso de tokens. A referência da API descreve esse campo como sendo apenas do gpt-image-1, embora sua resposta de exemplo o inclua, então confirme se ele aparece nas suas respostas do 2.6 antes de basear o monitoramento de custos nele.
Edite uma imagem com marcação
A marcação diz ao modelo onde fazer uma alteração. Você envia a imagem original, um PNG transparente com seus círculos ou esboços, e um prompt que descreve a edição.
curl --fail-with-body --silent --show-error \
  https://api.openai.com/v1/images/edits \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2.6-flare",
    "images": [{"image_url": "https://your-bucket.example/kitchen.png"}],
    "markup": {"image_url": "https://your-bucket.example/vase-overlay.png"},
    "prompt": "Recolor the vase inside the red circle to solid cobalt blue. Keep everything else unchanged. Remove the red circle.",
    "quality": "medium",
    "complexity": "low"
  }' | jq -er '.data[0].b64_json' | base64 --decode > vase.png
Requisições JSON usam o array images e um objeto markup que contém exatamente um de image_url ou file_id. Um image_url pode ser uma URL HTTPS ou uma URL de dados base64. Requisições multipart recebem um upload de arquivo, e o guia de geração de imagens tem essa versão em Python.
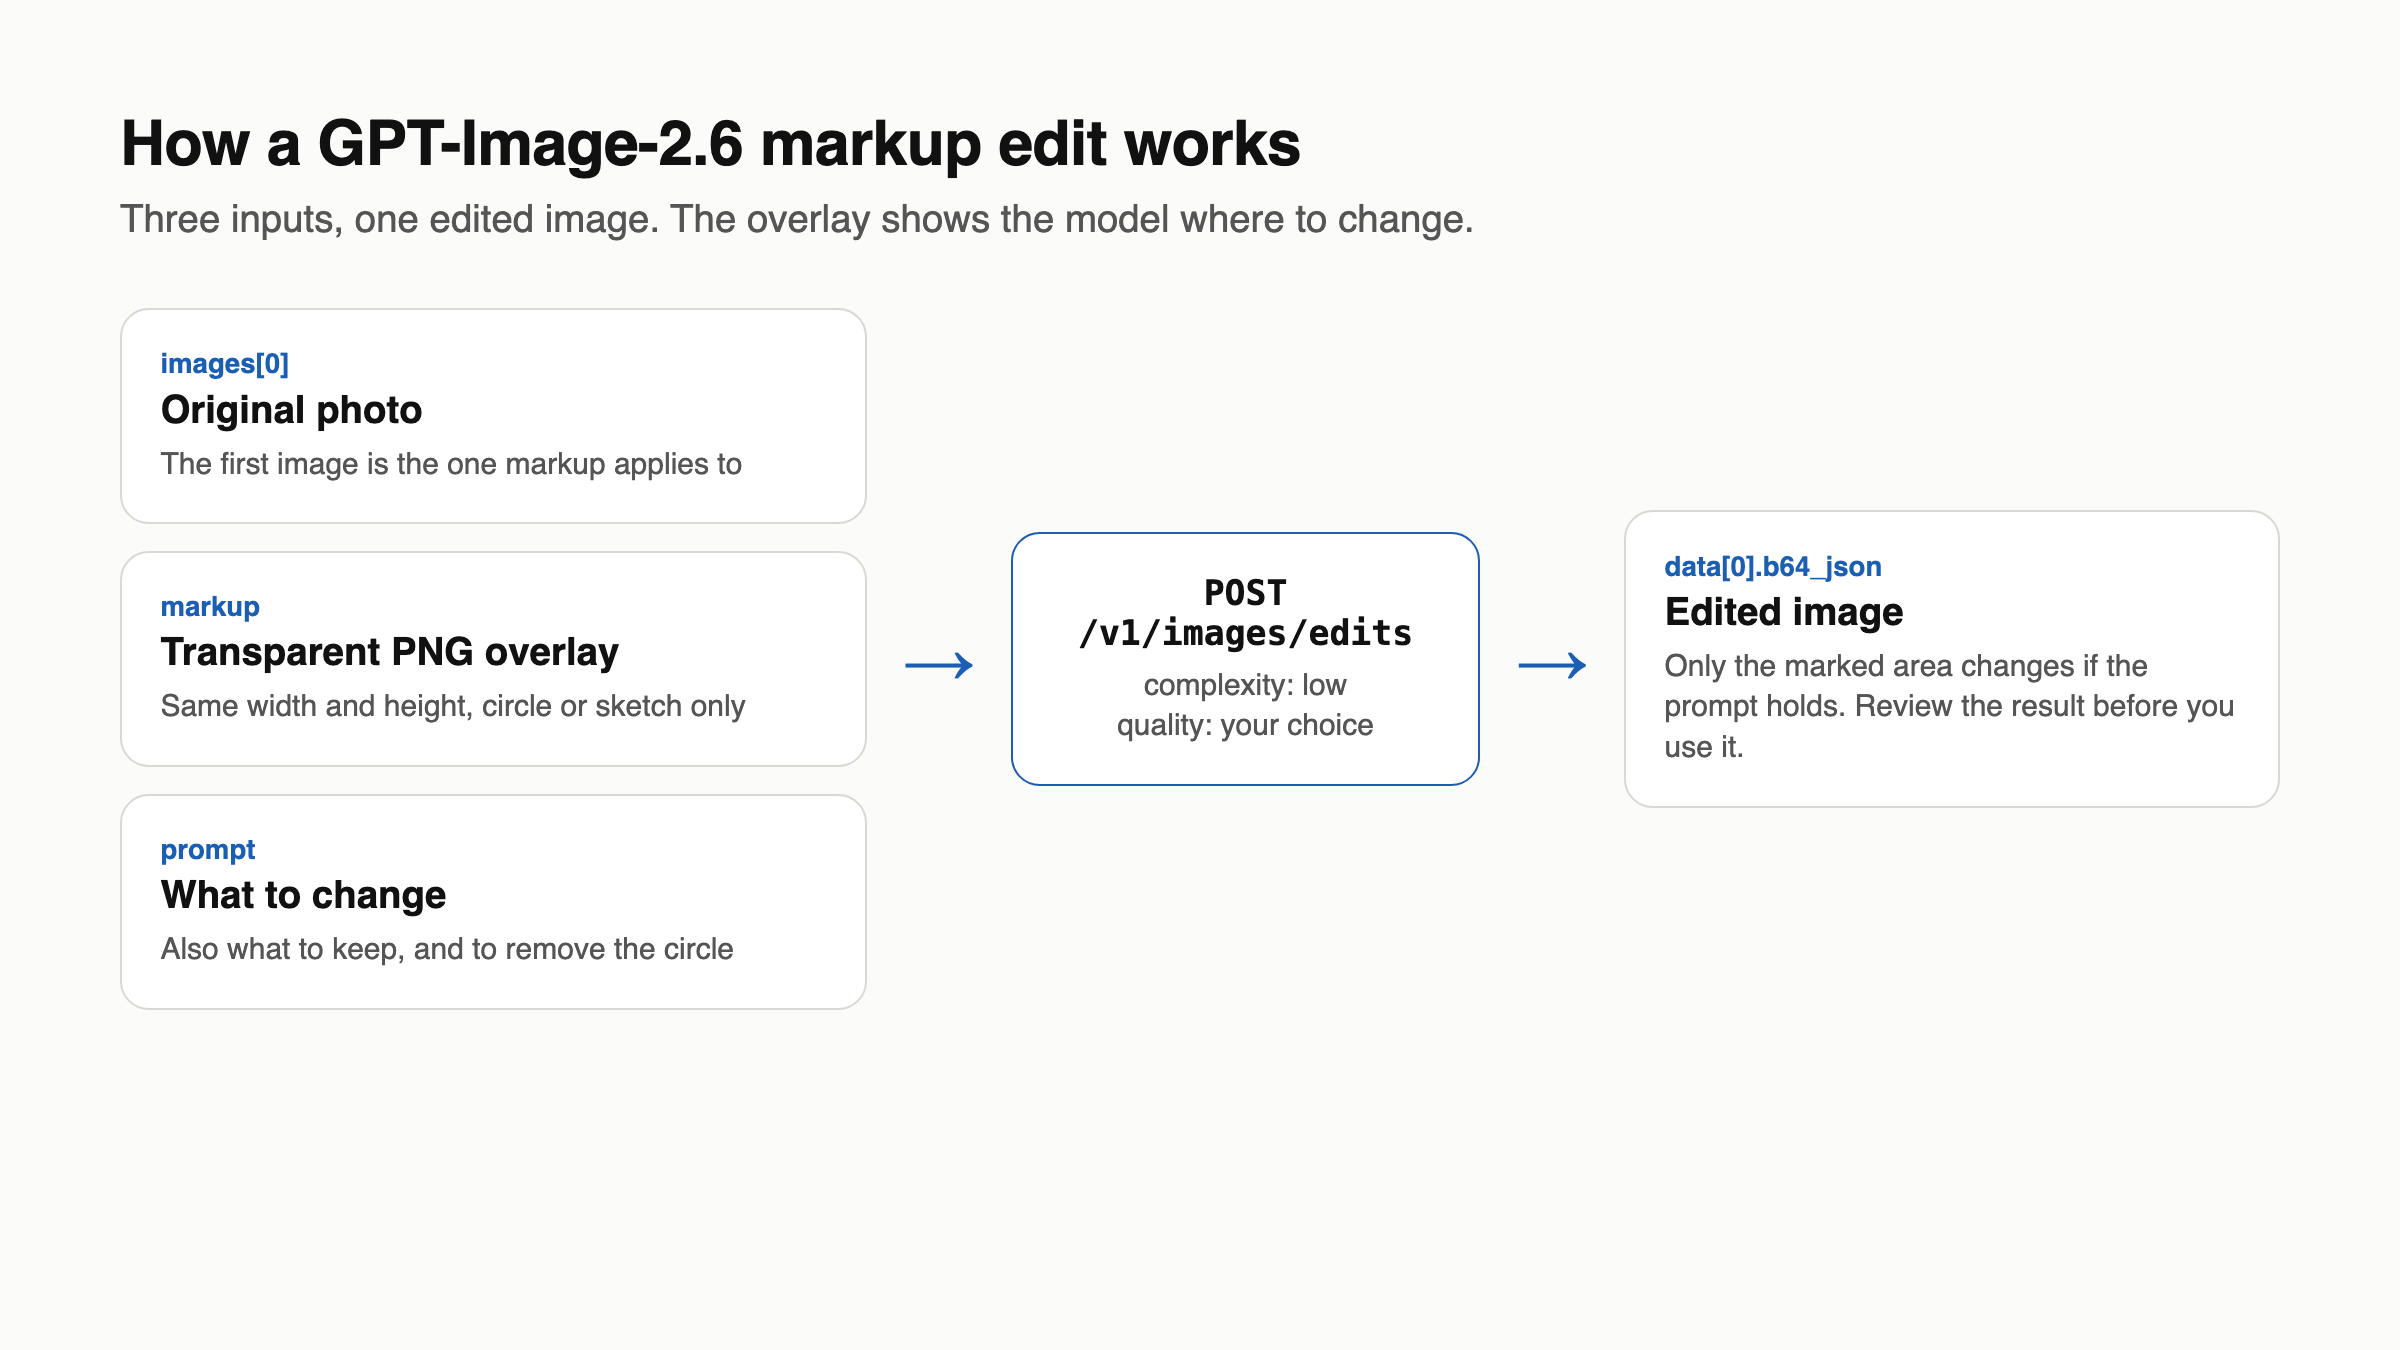
A sobreposição tem regras rígidas:
- Após a orientação, ela deve corresponder à largura e à altura da primeira imagem.
- Ela deve conter pixels transparentes, então não a achate sobre a foto.
- Ela se aplica à primeira imagem de entrada. Quaisquer outras servem como referências.
- Cada uma das duas imagens pode ter no máximo 16.777.216 pixels, e o arquivo de sobreposição não pode exceder 50 MB.
- Você não pode combinar
markupcommaskouprompt_rewriter.
Peça ao modelo para remover a anotação, como faz o próprio exemplo da OpenAI. A marcação custa o mesmo que qualquer outra edição. A Responses API não a aceita, então use uma máscara lá.
Exporte em SVG
Defina output_format como svg no endpoint de gerações para ícones, logos e ilustrações que precisam de caminhos editáveis.
curl --fail-with-body --silent --show-error \
  https://api.openai.com/v1/images/generations \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-image-2.6-sunburst",
    "prompt": "A flat two-color wheat logo for a bakery called Field and Flour",
    "output_format": "svg",
    "quality": "medium",
    "n": 1
  }' | jq -er '.data[0].b64_json' | base64 --decode > logo.svg
A API primeiro renderiza uma imagem de referência, que é controlada por quality, e depois escreve o SVG a partir dela. Os bytes decodificados são XML UTF-8 sem scripts, recursos externos ou rasters incorporados.
Quatro limites se aplicam:
ndeve ser 1.- Streaming, imagens parciais,
output_compressioneprompt_rewriternão funcionam. - O endpoint de edições não pode produzir SVG e não aceitará um SVG como entrada raster.
- O objeto
svgopcional escolhe o modelo de autoria, mas apenas se sua conta tiver seleção de modelo SVG. Caso contrário, omita-o.
Você paga duas vezes: a tarifa de imagem pela imagem de referência e a tarifa do modelo de autoria pelos seus tokens. A referência da API lista um objeto svg_usage separado para essa segunda parte, então registre-o.
Gere um GIF
A API retorna um GIF finalizado, não uma sprite sheet. Adicione três campos a uma requisição de geração:
{
  "model": "gpt-image-2.6-flare",
  "prompt": "A small orange robot waves, blinks and returns to its starting pose. Make it loop.",
  "output_format": "gif",
  "frame_count": 9,
  "frame_duration_ms": 200,
  "size": "auto"
}
Decodifique o b64_json da mesma forma e salve-o como .gif. Verifique duas coisas primeiro:
- Limite de quadros. O guia diz que
frame_countvai de 2 a 64. A referência da API diz de 2 a 16. Fique em 16 ou menos até testar valores maiores. - Acesso. A referência diz que a saída em GIF exige acesso ao preview de GIF do modelo selecionado, enquanto o guia não menciona isso. Uma requisição de GIF rejeitada pode ser uma questão de acesso, não um payload ruim.
A saída em GIF não oferece suporte a streaming, imagens parciais ou output_compression personalizado, e o endpoint de edições não pode retorná-la. A OpenAI não publica uma fórmula de cobrança específica para GIF, então faça um teste pequeno e verifique sua fatura antes de escalar.
Defina quality e complexity
quality controla o nível de detalhe da renderização e determina o custo em tokens. complexity controla quanto o modelo planeja antes de renderizar, e alterá-lo não gera cobrança separada.
Defina complexity em todas as requisições. O padrão é high, mas a OpenAI recomenda low para a maioria das edições. O guia alerta que configurações mais altas podem aumentar a latência e introduzir alterações indesejadas.
A qualidade também determina sua conta de saída. Esta tabela usa a calculadora da OpenAI para uma imagem de 1024x1024, consultada em 5 de novembro, e exclui os tokens de entrada:
quality |
Tokens de saída | Custo de saída |
|---|---|---|
low |
823 | $0.02469 |
medium |
1,449 | $0.04347 |
high |
1,756 | $0.05268 |
xhigh |
3,122 | $0.09366 |
max |
7,024 | $0.21072 |
A diferença entre medium e high é de cerca de um centavo, então compare os dois. A aba Batch da página de preços ainda não lista o 2.6, então não presuma que o desconto de batch do 2.5 se aplica.
Lide com erros e timeouts
Classifique as falhas conforme a possibilidade de uma nova tentativa ajudar:
| Falha | O que fazer |
|---|---|
| Limite de taxa ou erro de servidor | Tente novamente com backoff |
| Erro de cota | Não tente novamente; corrija o faturamento |
error.type é image_generation_user_error |
Altere o prompt ou a entrada primeiro |
error.code é moderation_blocked |
Leia moderation_details e depois revise |
Use error.code como sua verificação estável e registre o ID da requisição. moderation_details traz moderation_stage e categories aproximados, que pertencem aos seus logs, não a mensagens exibidas ao usuário. Defina timeouts do cliente acima de dois minutos, porque a OpenAI diz que prompts complexos podem levar esse tempo.
Deixe seu agente de codificação testá-la com o Apidog CLI
Seu agente de codificação pode transformar essas requisições e limites em uma suíte de testes com o Apidog CLI. Configure-o uma vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Depois, dê um prompt ao Claude Code, Codex ou Cursor:
In Apidog project <id>, add POST /v1/images/generations and POST /v1/images/edits
on https://api.openai.com. Read the bearer token from OPENAI_API_KEY.
Create test cases for gpt-image-2.6-flare at low quality and low complexity:
1. PNG generation: assert status 200 and data[0].b64_json exists.
2. SVG generation: assert status 200 and output_format equals svg.
3. GIF with frame_count 6: assert status 200 and output_format equals gif.
4. SVG with n set to 2: assert a 4xx status and that error.message exists.
5. GIF with frame_count 17: record the status, because OpenAI's docs disagree.
Put them in a test suite named "GPT-Image-2.6", run it against environment
<envId>, and summarize every failure.
O agente lê cada schema, valida seu payload e então escreve e executa a suíte:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <id> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog cli-schema validate test-suite-create --file suite.json
apidog test-suite create --project <id> --file suite.json
apidog test-suite run <suiteId> --project <id> -e <envId> \
  --env-var "OPENAI_API_KEY=$OPENAI_API_KEY" --on-error continue -r cli,json
O caso 5 define o limite de quadros da sua conta, e o caso 3 mostra se você tem acesso a GIF. Casos bem-sucedidos geram imagens reais e cobráveis, então mantenha a qualidade baixa. Substitua por -r junit para executar a suíte em um pipeline de CI, e veja o guia de configuração do Claude Code para detalhes sobre o agente.
Perguntas frequentes
Quais são os nomes dos modelos da API GPT-Image-2.6? gpt-image-2.6-flare e gpt-image-2.6-sunburst. A referência da API ainda não lista snapshots datados para eles, ao contrário dos modelos 2.5.
Quanto custa a API GPT-Image-2.6? Os tokens de imagem custam US$ 8 por 1M de entrada e US$ 30 por 1M de saída. Uma imagem de 1024x1024 custa cerca de US$ 0,025 em saída com low e cerca de US$ 0,053 com high, antes dos tokens de entrada.
Devo migrar do gpt-image-2.5? Migre se você precisa de SVG, GIF ou complexity. Teste seus custos primeiro: uma imagem low usa cerca de 4,2 vezes os tokens que usava no 2.5, e os modelos 2.6 ainda não têm preço de Batch listado.
Posso usar complexity no endpoint de edições? Sim. A OpenAI recomenda low para a maioria das edições.
Posso transformar uma imagem enviada em GIF pela API? Não. O endpoint de edições não retorna GIF nem SVG, então ambos os formatos partem de um prompt de texto no endpoint de gerações.
A API retorna uma URL? Não. Os modelos GPT Image sempre retornam base64 em b64_json, então decodifique-o e armazene o arquivo você mesmo.