
A OpenAI lançou o ChatGPT Images 2.5 em 8 de setembro de 2026, com dois modelos de API: gpt-image-2.5-flare e gpt-image-2.5-sunburst. Ambos cobram as mesmas taxas por token que o gpt-image-2, e ambos compartilham uma única entrada na calculadora de preços da OpenAI. Portanto, a tabela por token não o ajudará a escolher. O que mudou foi a escada de qualidade subjacente, e a remarcação de rótulos move o preço de uma imagem com quality: "high" em cerca de 4x.
Esta é a página de decisão: taxas por token, estimativas por imagem para todos os cinco níveis de qualidade 2.5 ao lado dos números do gpt-image-2, a reconfiguração dos rótulos, um orçamento mensal de 10.000 imagens, o rumor de "preço 2x" e uma lista de verificação de migração. Se você quiser a sintaxe da solicitação primeiro, leia como usar a API gpt-image-2.5. A página de preços da OpenAI é a fonte de todas as taxas abaixo. Cada valor por imagem é uma estimativa da calculadora, já que a OpenAI adverte que o consumo de tokens "pode diferir por modelo e configuração de qualidade"; sua fatura virá de usage.output_tokens na resposta.
Taxas por token: idênticas em todos os três
A página de preços da OpenAI lista as mesmas taxas de nível Padrão para ambos os modelos 2.5, e cada página de modelo afirma que suas "Taxas de token correspondem ao GPT Image 2". Aqui está a tabela completa, incluindo a linha de Lote (Batch) que causou confusão no lançamento.
| Modelo | Entrada de imagem | Entrada de imagem em cache | Saída de imagem | Entrada de texto | Entrada de texto em cache |
|---|---|---|---|---|---|
gpt-image-2.5-sunburst |
$8.00 | $2.00 | $30.00 | $5.00 | $1.25 |
gpt-image-2.5-flare |
$8.00 | $2.00 | $30.00 | $5.00 | $1.25 |
gpt-image-2 (Padrão) |
$8.00 | $2.00 | $30.00 | $5.00 | $1.25 |
gpt-image-2 (Lote, 50% de desconto) |
$4.00 | $1.00 | $15.00 | $2.50 | $0.625 |
Todos os valores são por 1M de tokens. A saída é apenas de imagem em todos os modelos aqui, portanto, a saída de texto nunca aparece na fatura.
Sobre a alegação de "preço 2x" em algumas coberturas iniciais: ela veio da comparação da linha 2.5 Padrão com a linha gpt-image-2 Lote, que oferece um desconto de 50%. Compare o Padrão com o Padrão na página de preços e todas as taxas permanecem inalteradas.
O custo de cada imagem em cada nível de qualidade
A paridade por token é onde a semelhança termina. A calculadora da OpenAI (consultada em 09/09/2026) relata estas contagens de tokens de saída de imagem sob uma única entrada compartilhada, "GPT Image 2.5 (Sunburst e Flare)". O custo é tokens vezes $30 por 1M, apenas tokens de saída.
| Qualidade | Tokens 1024x1024 | Custo 1024x1024 | Tokens 1536x1024 | Custo 1536x1024 |
|---|---|---|---|---|
| baixa | 196 | $0.00588 | 158 | $0.00474 |
| média | 439 | $0.01317 | 343 | $0.01029 |
| alta | 1,756 | $0.05268 | 1,372 | $0.04116 |
| superalta | 3,122 | $0.09366 | 2,459 | $0.07377 |
| máxima | 7,024 | $0.21072 | 5,488 | $0.16464 |
Aqui está a tabela do gpt-image-2 da mesma página de documentação, para os mesmos tamanhos.
| Qualidade | 1024x1024 | 1536x1024 (e 1024x1536) |
|---|---|---|
| baixa | $0.006 | $0.005 |
| média | $0.053 | $0.041 |
| alta | $0.211 | $0.165 |
Duas coisas se destacam. O tamanho paisagem é mais barato que o quadrado em todas as linhas, um padrão que a documentação da OpenAI aponta. E a linha high do 2.5 não está nem perto da linha high do gpt-image-2. Essa é a remarcação.
O texto do prompt e as imagens de referência são cobrados à parte. Uma imagem de referência enviada para images/edits custa tokens de entrada de imagem a $8 por 1M; a OpenAI não publica a contagem de tokens de entrada por imagem, então leia-a de usage.input_tokens.
A escada de qualidade foi remarcada
Combine os orçamentos de token e o mapeamento fica claro. No 2.5, high são 1.756 tokens de saída, o orçamento que o gpt-image-2 gastava em medium. No 2.5, max são 7.024 tokens, o orçamento que o gpt-image-2 gastava em high. low permanece inalterado em 196 tokens.
| Rótulo 2.5 | Tokens (1024x1024) | Custo 2.5 | Mesmo orçamento no gpt-image-2 | Custo gpt-image-2 |
|---|---|---|---|---|
| baixa | 196 | $0.00588 | baixa | $0.006 |
| média | 439 | $0.01317 | nenhuma (abaixo do médio antigo) | n/a |
| alta | 1,756 | $0.05268 | média | $0.053 |
| superalta | 3,122 | $0.09366 | nenhuma (entre médio antigo e alto antigo) | n/a |
| máxima | 7,024 | $0.21072 | alta | $0.211 |
Assim, uma migração que mantém quality: "high" fica cerca de 4x mais barata por imagem e renderiza com o orçamento antigo de médio. Uma que deseja o orçamento antigo de high deve mudar para max, efetivamente com o preço antigo. xhigh é um novo nível intermediário sem equivalente no gpt-image-2.
A matemática mensal, derivada das estimativas da calculadora da OpenAI em 1024x1024:
- 10.000 imagens em 2.5
high: 10.000 x $0.05268 = $526.80 - 10.000 imagens em gpt-image-2
high: 10.000 x $0.211 = $2.110 - 10.000 imagens em 2.5
max: 10.000 x $0.21072 = $2.107.20, efetivamente o mesmo que o antigohigh - Streaming com
partial_images: 3adiciona 300 tokens, ou $0.009 por imagem, já que cada parcial custa 100 tokens de saída de imagem
Flare vs Sunburst: o que o premium oferece
Ambos os modelos compartilham a entrada da calculadora, então as contagens de tokens documentadas são idênticas. O Sunburst não custa mais por imagem; o premium é tempo. A publicação de lançamento da OpenAI direciona o Flare para "geração de alto volume" e o Sunburst para "fluxos de trabalho visuais premium que se beneficiam de um controle mais rigoroso nas edições". A documentação resume em uma linha: "Escolha Sunburst para fluxos de trabalho onde a precisão da edição é mais importante, e Flare para geração de imagens rápida e de alta qualidade para o dia a dia."
Sinal da comunidade, rotulado como tal:
- No tópico do HN, o usuário jjcm, que relatou cerca de 50.000 imagens através do gpt-image-2 para uma ferramenta de design de UI de IA, disse que a latência média "se manteve em cerca de 104s" no gpt-image-2 e as imagens 2.5 "estão chegando em cerca de 35-40s". Um ponto de dados, uma carga de trabalho; a própria afirmação da OpenAI é de latência "até 50% menor".
- O ranking de texto para imagem da Arena (votos da comunidade, atualizado em 7 de setembro de 2026) classifica o Sunburst em primeiro lugar com 1421, o Flare em segundo com 1399, o gpt-image-2 em médio em terceiro com 1381, e então o mai-image-2.6 da Microsoft com 1331; o Nano Banana 2 está em 1261. No ranking de edição de imagem a lacuna aumenta: Sunburst 1520, Flare 1491, gpt-image-2 1461. São pontuações de preferência da multidão, não benchmarks da OpenAI.
A regra de decisão: opte por Flare por padrão. Mude para Sunburst para fluxos de trabalho de edição em várias etapas onde um assunto de referência deve sobreviver a várias rodadas de instruções. A lacuna da Arena é de 22 pontos em texto para imagem e 29 em edições, o que apoia a afirmação da OpenAI de que as edições são onde o Sunburst justifica sua espera. Se essa lacuna não aparecer em seus próprios prompts, você estará pagando por latência à toa.
Quando o gpt-image-2 ainda faz sentido
Descontos para lotes. A aba Lote da página de preços lista apenas o gpt-image-2, a $15 por 1M de tokens de saída; se `/v1/batch` aceita os IDs 2.5 não está documentado no momento da escrita. Se sua carga de trabalho tolera o tempo de resposta da API de Lote, o gpt-image-2 em Lote medium (metade de $0.053) supera o 2.5 high nas taxas padrão para o mesmo orçamento de tokens.
Snapshots fixados. O gpt-image-2-2026-04-21 tem sido enviado desde abril sem aviso de depreciação até 09/09/2026. Se seu pipeline depende de uma saída que alguém revisou visualmente, um snapshot que não muda é um recurso; nosso guia da API gpt-image-2 cobre seus parâmetros. Para um ponto de comparação entre fornecedores, compare os preços da API Nano Banana 2 e a API FLUX.2 no mesmo tamanho de saída; o 2.5 high a aproximadamente cinco centavos por imagem quadrada é o número a ser batido.
Lista de verificação de migração de gpt-image-2 para 2.5
- Troque o ID do modelo.
gpt-image-2se tornagpt-image-2.5-flare(ou-sunburst); fixegpt-image-2.5-flare-2026-09-08para saída estável. - Remapeie os rótulos de qualidade. O antigo
mediumse torna o novohigh, o antigohighse torna o novomax,lowpermanecelow. Faça isso na configuração, não por local de chamada. - Considere
xhighemax. Ambos são novos no 2.5;xhighcom 3.122 tokens fica entre os orçamentos antigos de médio e alto. - Abandone as suposições de `thinking`. A documentação do 2.5 não descreve um parâmetro
thinking; remova-o dos modelos em vez de assumir que é aceito ou ignorado. - Remessa o
usage. Registreusage.output_tokenseusage.input_tokenspor uma semana de prompts reais; os números da calculadora são estimativas. - Verifique a elegibilidade para Lote. Se você confia no desconto de 50% do Lote, confirme se
/v1/batchaceita os IDs 2.5 antes de fazer a transição.
Compare todos os três modelos no Apidog com uma solicitação salva
Apidog é um cliente API e plataforma de teste. Ele envia a solicitação images/generations e verifica a resposta; ele não gera imagens nem executa o modelo. Isso o torna o lugar ideal para decidir entre Flare, Sunburst e gpt-image-2 com seus próprios prompts.
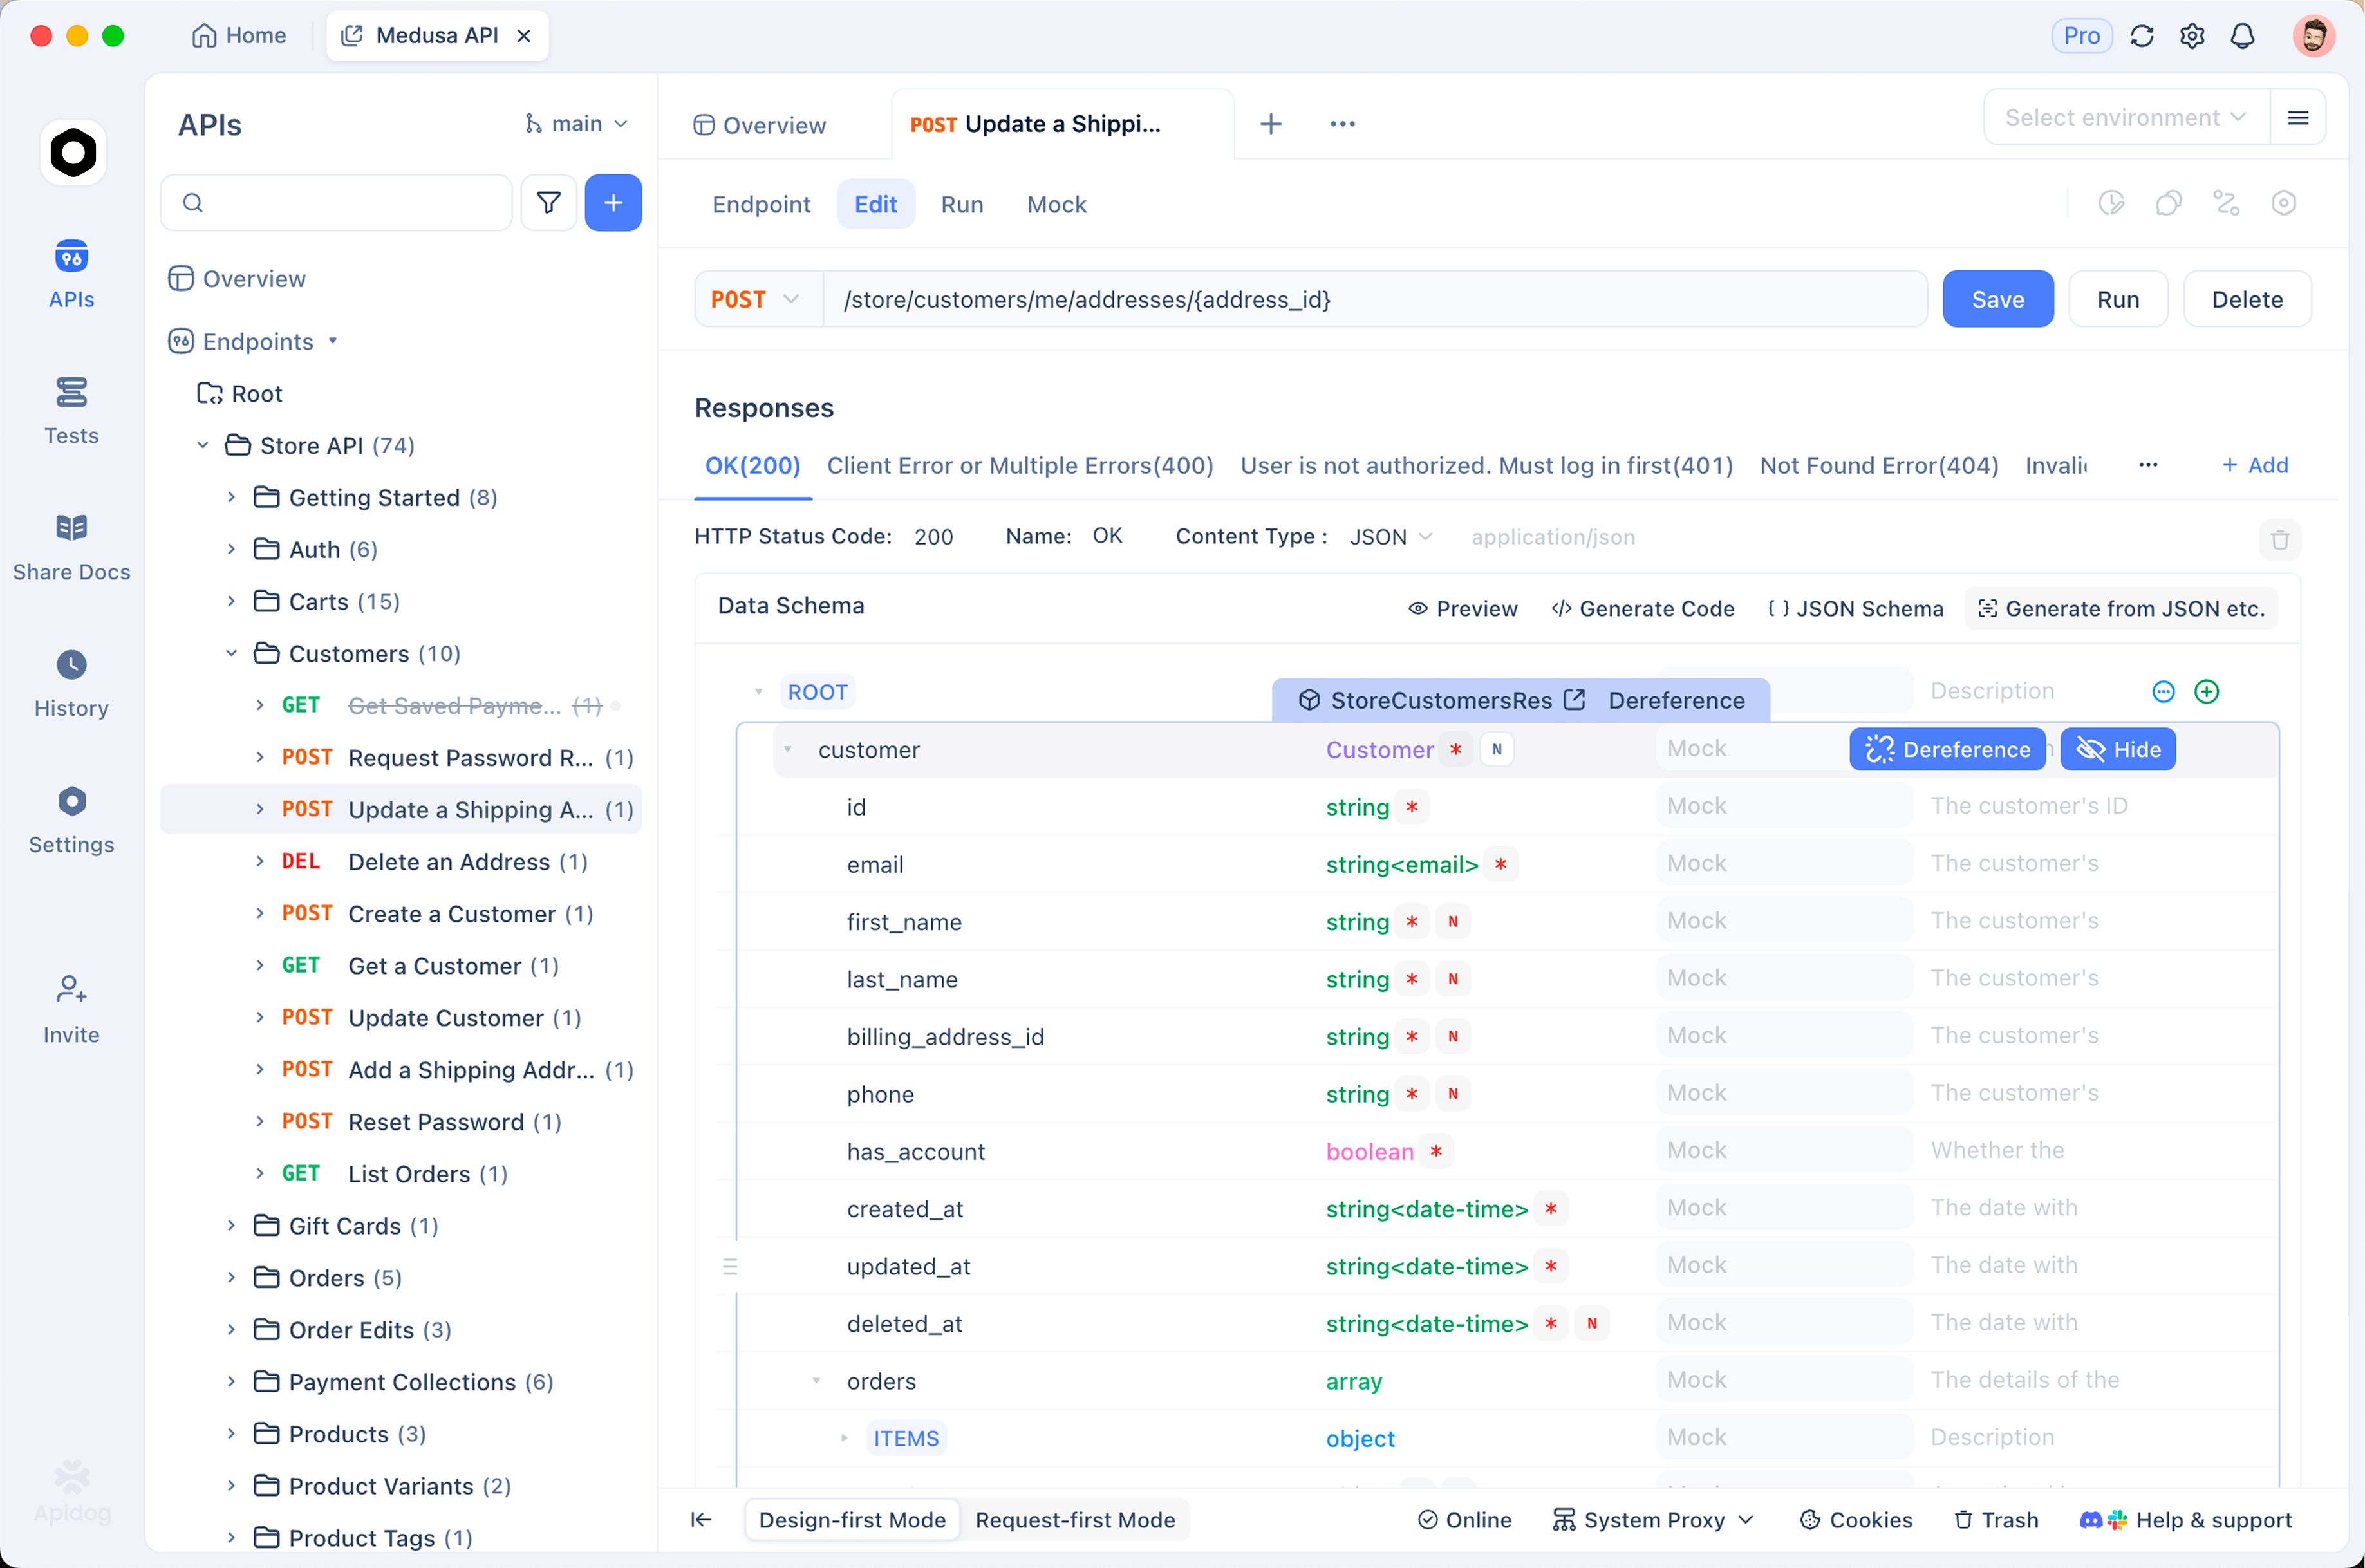
Crie uma solicitação para POST https://api.openai.com/v1/images/generations com o modelo como uma variável, então crie três ambientes chamados flare, sunburst e gpt-image-2. Cada um define {{model}} e armazena OPENAI_API_KEY como uma variável de ambiente, para que a chave nunca vá para o corpo da solicitação.
{
  "model": "{{model}}",
  "prompt": "Product photo of a matte black ceramic mug on a walnut desk, soft window light",
  "size": "1024x1024",
  "quality": "high",
  "output_format": "jpeg",
  "output_compression": 80
}
Adicione um script de pós-processamento que registra os números e falha a execução se o orçamento de tokens for excedido:
const body = pd.response.json();
const tokens = body.usage.output_tokens;
pd.environment.set("last_output_tokens", tokens);
pd.environment.set("last_wall_clock_ms", pd.response.responseTime);
pd.test("output tokens within budget", () => {
  pd.expect(tokens).to.be.below(2000);
});
Execute a solicitação em cada ambiente. O tempo de resposta do Apidog é o seu número de tempo real, last_output_tokens é a contagem medida para comparar com os 1.756 da calculadora, e a diferença entre as execuções de flare e sunburst é o prêmio do Sunburst para o seu prompt. A mesma troca de ambiente funciona para a chamada multipart images/edits; verifique usage.input_tokens lá para saber o custo de uma foto de referência. Baixe o Apidog para executar a comparação antes de alterar o código de produção.
FAQ
O gpt-image-2.5 é mais caro que o gpt-image-2? Por token, não. Ambos os modelos 2.5 e o gpt-image-2 Padrão cobram $30 por 1M de tokens de saída de imagem, $8 por 1M de entrada de imagem e $5 por 1M de entrada de texto. Por imagem, uma solicitação 2.5 high custa cerca de $0.053 em 1024x1024, versus $0.211 para gpt-image-2 high.
O Sunburst custa mais que o Flare? Não. Ambos os modelos compartilham uma entrada na calculadora, então as contagens de tokens documentadas são idênticas em todos os níveis de qualidade e tamanhos. O premium do Sunburst é um tempo de geração mais longo, que a OpenAI chama de "nível extra de precisão" para trabalhos intensivos em edição.
Qual configuração de qualidade substitui meu antigo gpt-image-2 high? max. Ele usa 7.024 tokens em 1024x1024, o mesmo orçamento do gpt-image-2 high, e custa $0.21072 pela calculadora. Deixe high no lugar e você obtém o orçamento antigo de médio a cerca de um quarto do preço. A publicação principal sobre ChatGPT Images 2.5 aborda o que mais mudou.
Existe uma maneira gratuita de experimentar o Images 2.5 antes de pagar pela API? Sim. O modelo está em todos os níveis do ChatGPT com limites de geração por plano, abordados em como usar o ChatGPT Images 2.5 gratuitamente. A API não tem um nível gratuito para endpoints de imagem; qualidade low a cerca de $0.006 por imagem quadrada é o caminho real mais barato.
Qual modelo escolher
Flare para qualquer coisa de alto volume ou sensível à latência, em high para a maioria dos trabalhos e max quando a aparência antiga do gpt-image-2 high é um requisito. Sunburst para edições multi-turno onde um assunto de referência deve sobreviver, após uma comparação lado a lado em seus prompts; gpt-image-2 para trabalhos em Lote e pipelines fixados que você não está pronto para revisar. Seja qual for sua escolha, leia usage.output_tokens de respostas reais; três ambientes no Apidog e uma solicitação salva fornecem esse número em uma tarde.