
Não. O GPT-6 Sol não é gratuito em nenhuma superfície lançada pela OpenAI. A frase de disponibilidade no próprio anúncio da OpenAI é inequívoca: Sol e Luna estão no ChatGPT Work e Codex para usuários Plus, Pro, Business, Enterprise e Edu, e usuários Free e Go podem acessar o GPT-6 Luna no aplicativo para desktop. Sol está ausente dessa linha gratuita. Nenhum dos modelos está no Chat ainda. Na API, gpt-6-sol é pago por uso a US$2 por milhão de tokens de entrada e US$10 por milhão de tokens de saída.
Aqui está a parte que vale o seu tempo. Há um modelo GPT-6 genuinamente gratuito, ele foi lançado no mesmo dia, e para uma grande parte do que as pessoas querem Sol, esta é a resposta honesta. O GPT-6 Luna funciona sem custo no aplicativo para desktop para contas Free e Go, e não é um brinquedo: contexto de 1M de tokens e 66,6% no DeepSWE 1.1 no esforço máximo contra os 68,8% do Sol. Se você chegou aqui porque queria um trabalho de ponta sem uma assinatura, vá por esse caminho primeiro. Detalhamos essa rota separadamente em como usar o GPT-6 Luna gratuitamente.
Este artigo aborda as três coisas que são realmente verdadeiras: quem obtém o Sol e como, quais rotas gratuitas existem e o que elas esgotam, e como é o caminho pago mais barato para o gpt-6-sol depois que você aceita que está pagando por ele.
Quem obtém o GPT-6 Sol, em resumo
| Superfície | GPT-6 Sol | GPT-6 Luna |
|---|---|---|
| ChatGPT Gratuito | Não | Sim, aplicativo para desktop |
| ChatGPT Go | Não | Sim, aplicativo para desktop |
| ChatGPT Plus, Pro, Business, Enterprise, Edu | Sim, no Work e Codex | Sim, no Work e Codex |
| Chat | Ainda não | Ainda não |
| API | Pago por uso, gpt-6-sol |
Pago por uso, gpt-6-luna |
Dois detalhes nesta tabela são constantemente mal interpretados. Primeiro, "no aplicativo para desktop" é um limite real na rota gratuita do Luna, não um preenchimento de marketing. Segundo, Work e Codex são onde o acesso pago reside, então uma assinatura Plus não coloca Sol na superfície de Chat a que você pode estar acostumado.
A rota gratuita que realmente existe
O GPT-6 Luna custa US$0,10 por milhão de tokens de entrada e US$0,50 por milhão de saída na API, e nada no aplicativo para desktop em Free e Go. Seu Índice de Inteligência de Análise Artificial é de 37 contra 48 do Sol, então é um degrau abaixo, mas veja onde o degrau aterrissa. No DeepSWE 1.1 com esforço máximo, Luna pontua 66,6%, o que a OpenAI descreve como comparável ao Claude Opus 5 e Claude Fable 5 em esforço médio, com 93% menos por tarefa que o Opus 5 e 96% menos que o Fable 5. No OSWorld 2.0 offline, Luna no máximo supera o GPT-5.6 Sol no médio por aproximadamente um décimo do custo. Em termos de factualidade, Luna com maior esforço iguala o GPT-5.6 Sol por cerca de um centésimo do custo.
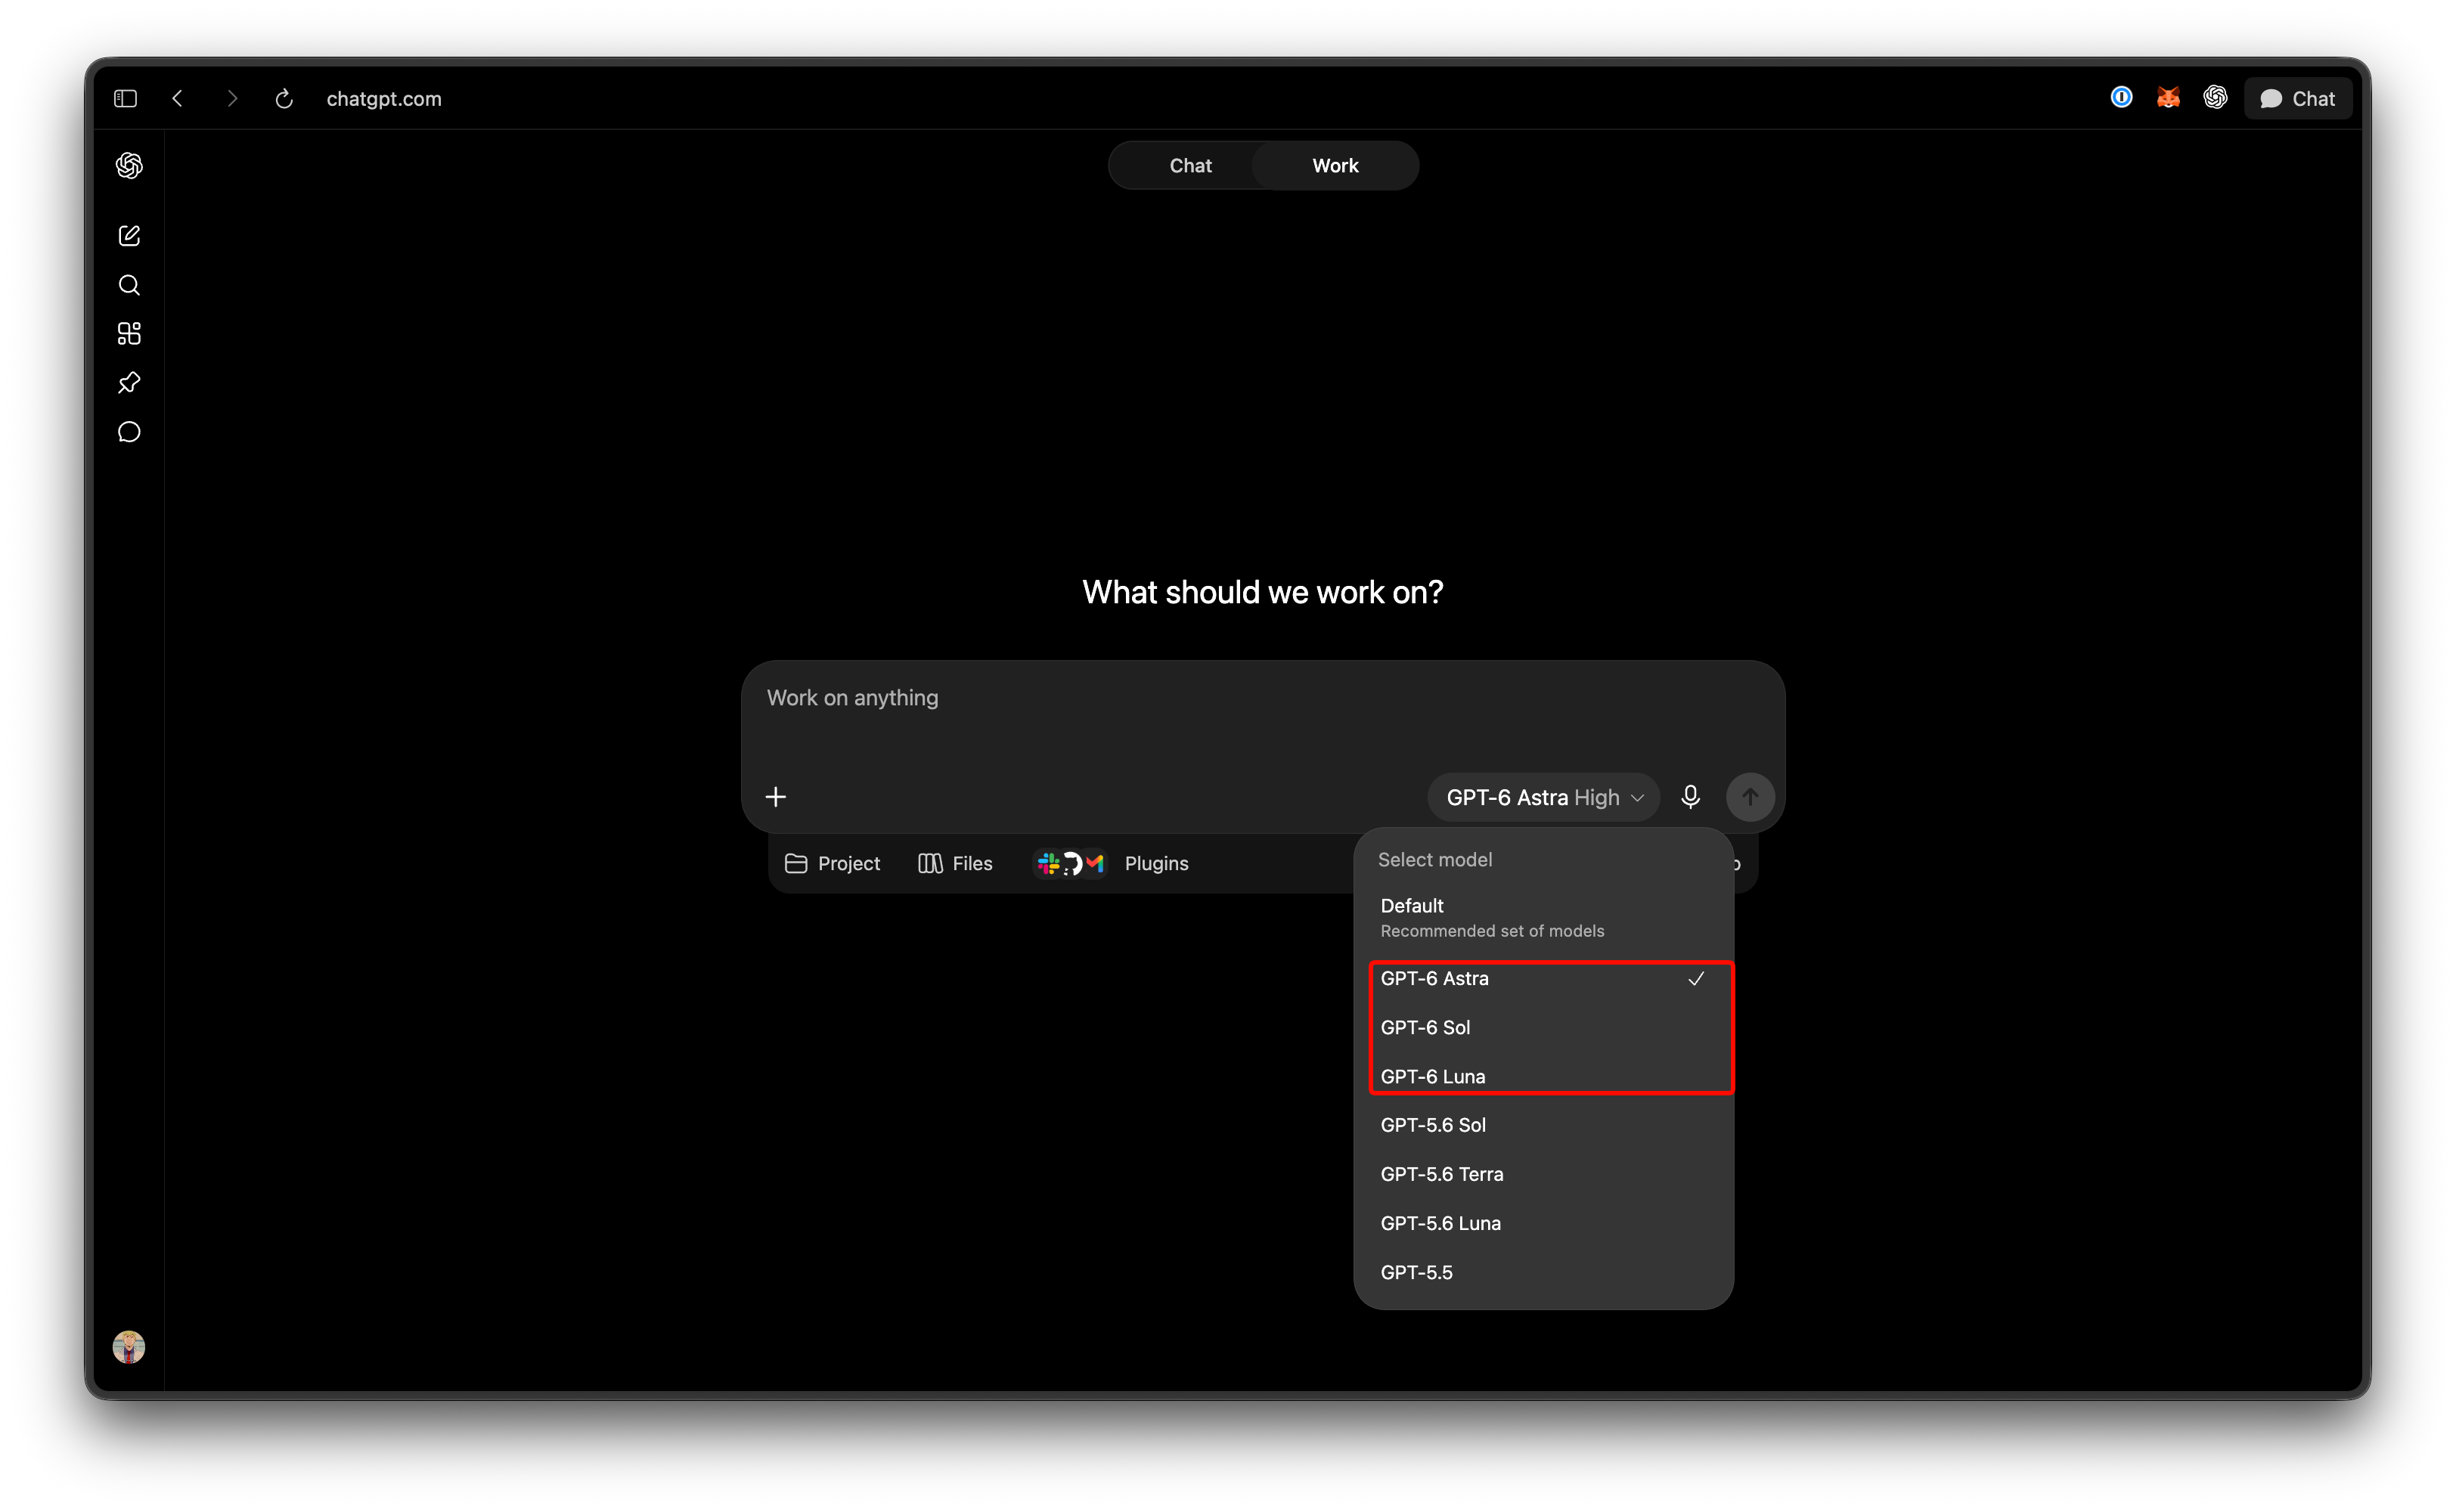
Seja preciso sobre o que a metade gratuita dessa frase cobre. O direito Free e Go é o uso interativo do Luna dentro do aplicativo de desktop do ChatGPT. Não é uma chave de API e não pode acionar um script, um trabalho de CI ou uma execução automatizada de agente. Qualquer coisa programática passa pela API com as taxas de US$0,10 e US$0,50 do Luna, barato, mas não zero.
Leia isso como um guia de compras, e não como um placar. Se o seu trabalho envolve edições de código, loops agenticos sobre um repositório, processamento de documentos, classificação ou qualquer coisa que você teria anteriormente entregue a um modelo de nível médio, o Luna não é um compromisso pelo qual você deva pedir desculpas. Sol justifica seu preço na ponta mais difícil: 33,2% no AutomationBench 1.0.6 com esforço extra-alto, 56,4% no Agents’ Last Exam V1 no máximo, e cerca de metade dos erros factuais de seu predecessor.
As fichas técnicas completas estão em o que é GPT-6 Sol e o que é GPT-6 Luna, e a decisão de nível sobre o custo por tarefa está em Luna vs Sol vs Astra.
Teste de API e créditos promocionais da nuvem
A segunda rota gratuita honesta são os créditos, com uma propriedade que você deve internalizar antes de planejar: um saldo de crédito se esgota e depois para. É um teste, não um nível.
- Créditos para novas contas da API OpenAI. Novas contas geralmente começam com um pequeno saldo, o suficiente para confirmar que uma integração funciona e medir as contagens reais de tokens antes que um cartão seja anexado.
- Créditos promocionais da nuvem. Novas contas nas principais plataformas de nuvem frequentemente incluem créditos promocionais que podem ser usados para o uso do modelo. Antes de planejar com base nisso, verifique se a plataforma em que você está oferece o
gpt-6-sol: as superfícies de lançamento que podemos obter são a própria API da OpenAI, ChatGPT Work e Codex, e não uma nuvem de terceiros. Leia os termos atuais de cada plataforma diretamente também, pois os valores e as regras de elegibilidade mudam com frequência suficiente para que qualquer número impresso aqui estaria desatualizado em semanas.
Gaste esses créditos em medição, não em tráfego de produção. Execute seus prompts reais, leia o bloco usage de cada resposta, e você saberá seu próprio custo por tarefa antes de alocar um orçamento. Isso vale mais do que os próprios créditos.
Não há caminho gratuito ilimitado para gpt-6-sol
Vale a pena dizer claramente, porque esta pergunta atrai respostas desonestas. Nenhuma camada gratuita da API da OpenAI oferece chamadas gpt-6-sol ilimitadas. Nenhum proxy, pool de chaves ou revendedor concede legitimamente acesso gratuito a modelos de ponta. Esses esquemas violam os termos do provedor, são revogados e roteiam seus prompts através de uma infraestrutura que você não controla. Uma vez que os créditos de teste ou promocionais são gastos, você paga por token ou para.
O caminho pago mais barato
A taxa base é de US$2 para entrada e US$10 para saída por milhão de tokens. A OpenAI descreve isso como 50% mais barato que o GPT-5.6, e o qualificador em sua própria redação é importante: é 50% mais barato que o preço promocional do GPT-5.6, não o de tabela. As alavancas abaixo movem a conta muito além do que o título sugere.
Alavanca 1: cache, que é o maior desconto único
O GPT-6 foi lançado com uma verdadeira implementação de cache de prompts. As leituras de entrada em cache têm um desconto de 90%, o que coloca a taxa de entrada efetiva do Sol em US$0,20 por milhão de tokens na porção em cache de um prompt. Isso é um corte maior do que a redução de preço sobre a qual todos escreveram.
Três coisas mudaram junto com o desconto, e cada uma remove um motivo pelo qual os caches costumavam falhar:
- As taxas de acerto são mais altas por padrão.
- Alterar o esforço de raciocínio ou a disponibilidade de ferramentas não invalida mais o cache, então um agente que muda de esforço no meio da execução mantém seu prefixo.
- Pontos de interrupção explícitos permitem que você escolha onde um prefixo em cache termina, em vez de esperar que o provedor escolha o mesmo limite que você.
Há também um painel de cache e uma ferramenta de diagnóstico, então a taxa de acerto agora é algo que você observa em vez de inferir. O GitHub relata mais de 50% menos tokens de prompt precisando de processamento novo em bilhões de requisições. Uma lacuna a ser respeitada: nossas fontes não informam a taxa de gravação de cache para o GPT-6, então não modele as gravações como gratuitas. A mecânica está em cache de prompt GPT-6.
Alavanca 2: esforço de raciocínio, o verdadeiro eixo de custo
Cada linha de benchmark que a OpenAI publicou emparelha uma pontuação com um nível de esforço, e isso não é decoração. O esforço troca tokens por precisão, e tokens são a conta. Sol em xhigh pontua 33,2% no AutomationBench a US$0,27 por tarefa; o mesmo modelo com um esforço menor custa menos e pontua menos. Uma configuração mais barata que precisa de três tentativas não é mais barata, então a única maneira de escolher corretamente é executar sua própria avaliação em duas configurações e comparar o custo por tarefa concluída, não o custo por chamada.
Alavanca 3: tokens de saída, que custam cinco vezes a entrada
Com US$2 de entrada e US$10 de saída, uma resposta vale cinco tokens de entrada por token de saída. Respostas longas e prolixas são onde contas pequenas se tornam grandes. Peça o formato desejado, limite a resposta onde a tarefa permitir, e prefira saída estruturada em vez de prosa quando uma máquina estiver lendo o resultado.
O que um pequeno saldo de crédito realmente compra
Aqui está a aritmética, feita com base nas taxas acima e não em algo impresso pela OpenAI. Considere uma etapa comum de agente: um prompt de 40.000 tokens e uma conclusão de 2.000 tokens.
| Configuração | Custo por chamada | Chamadas por US$5 de crédito |
|---|---|---|
| GPT-6 Sol, sem acertos de cache | US$0,100 | 50 |
| GPT-6 Sol, 32k do prompt em cache | US$0,042 | 118 |
| GPT-6 Luna, sem acertos de cache | US$0,005 | 1.000 |
| GPT-6 Luna, 32k do prompt em cache | US$0,0021 | 2.358 |
A linha do Sol em cache é de 32.000 tokens a US$0,20 por milhão mais 8.000 a US$2,00 mais 2.000 de saída a US$10,00. O cache mais que dobra o que um saldo fixo compra, e mover a mesma carga de trabalho para o Luna a multiplica por vinte.
No trabalho de agente, a unidade é novamente diferente. Sol com esforço extra-alto custa US$0,27 por tarefa no conjunto de testes AutomationBench da OpenAI, então um saldo de US$5 equivale a aproximadamente dezoito tarefas desse tipo antes que ele pare. Isso é suficiente para medir, mas longe de ser o suficiente para executar, o que é precisamente o objetivo de um saldo de teste.
Para contexto de escala, a OpenAI divulgou que seu pesquisador interno mediano gasta mais de US$600 por dia em agentes de codificação, com o 90º percentil em US$7.000 por dia. Essas taxas foram projetadas para esse padrão, e não para uma camada gratuita.
O caminho barato não é o caminho rápido
Uma troca está por trás de tudo isso. A Artificial Analysis, uma terceira parte e não o fornecedor, mede a variante de raciocínio máximo do GPT-6 Sol em 115,2 tokens de saída por segundo com um tempo para o primeiro token de 102,15 segundos, e a variante máxima do Luna em 153,9 tokens por segundo com 124,23 segundos para o primeiro token. [VERIFICAR] Alto esforço significa uma longa pausa silenciosa antes que algo chegue. Se um usuário estiver esperando, ou se algo a jusante tiver um tempo limite, reduza o nível de esforço ou escolha um nível diferente. Dissecamos isso em Latência do GPT-6 Sol.
Meça antes de orçar
As tabelas de custos do fornecedor são medidas em sistemas de teste do fornecedor contra cargas de trabalho do fornecedor, e as suas serão diferentes. Quatro verificações valem a pena serem feitas antes que tudo isso se torne um número em uma planilha:
- Envie prompts de produção reais e leia o
usageda resposta, em vez de estimar por contagem de caracteres. - Execute o mesmo prompt contra
gpt-6-solegpt-6-lunae compare o custo por tarefa concluída, não por chamada. A linha Luna acima é uma economia apenas se a resposta for boa o suficiente. - Execute dois níveis de esforço e registre os tokens e o tempo real para ambos.
- Meça os casos com e sem cache separadamente. Um desconto de 90% na metade errada de um prompt vale muito pouco.
Isso é um teste comum de requisição HTTP. Construa as chamadas, salve as variantes Sol e Luna como requisições separadas, verifique o formato da resposta e observe os tempos no Apidog em vez de em um script rascunho que você descartaria. Mantida como uma coleção salva, a comparação é executada novamente na próxima vez que um preço mudar, o que, com base nas evidências atuais, será em breve.
A versão resumida
O GPT-6 Sol não é gratuito, e nenhum artigo honesto pode dizer o contrário. Contas Free e Go obtêm o GPT-6 Luna no aplicativo para desktop, que é a resposta real para a maioria das pessoas que vieram aqui procurando por uma. Créditos de teste e promocionais da nuvem lhe darão medição, não produção. E se você estiver pagando, o desconto de 90% na leitura em cache e um nível de esforço escolhido corretamente farão mais pela sua conta do que a redução de preço de lançamento.
Onde isso se encaixa em uma semana que também trouxe o Claude Opus 5.5 é abordado em a guerra de preços de modelos de IA de setembro de 2026, e o detalhamento completo das taxas está em Preços do GPT-6 Sol.