
O GPT-6 Astra elevou a pontuação MATH-500 do Qwen3.5-0.8B de 7,9% para 48,1% sem nenhum treinamento. Ele leu os pesos do modelo, encontrou uma direção que fazia o modelo entrar em loop em seu raciocínio e a subtraiu de duas camadas MLP. Essa edição tocou 131.072 pesos, 0,016% do modelo. Os números vêm de um post de 2 de novembro de quatro pesquisadores do MIT CSAIL, e o modelo editado é público, então você pode verificar a afirmação por conta própria.
A seguir: o que é programação em espaço de pesos, o que o Astra alterou, onde o método deixa de funcionar e como fazer seu agente de codificação comparar os dois modelos com o Apidog CLI.
O que é programação em espaço de pesos?
A programação em espaço de pesos é um LLM de propósito geral lendo e escrevendo os pesos de uma rede neural diretamente, guiado por um objetivo em linguagem natural, sem descida de gradiente e sem loop de treinamento. O modelo raciocina sobre o que cada parte da rede computa e então altera os números manualmente, do mesmo jeito que um programador edita o código-fonte.
O termo vem de Sparks of Weight-Space Programming, de Rikiya Takehi, Jayden Teoh, Alex Zhang e Omar Khattab, publicado em 2 de novembro de 2026. Os autores chamam cada resultado de "muito preliminar", e vários vêm de uma ou de poucas execuções. Para contexto sobre o modelo que faz a edição, veja a análise prática do GPT-6 Astra.
Como o GPT-6 Astra corrigiu o Qwen3.5-0.8B
O resultado principal é o Experimento 8. Os pesquisadores pediram ao GPT-6 Astra que tornasse o Qwen3.5-0.8B melhor em matemática editando seus pesos. Eis o que aconteceu, passo a passo:
- A configuração. O Astra recebeu uma sessão Python (como um notebook) com os pesos do modelo carregados, sem GPU, e 7.469 problemas de prática do GSM8K mais 7.275 do MATH, vindos dos conjuntos de treinamento. Ele nunca viu os conjuntos de teste.
- O orçamento. Em vez de treinar, o Astra podia gastar 10, 25 ou 50 passagens forward. Uma passagem forward permitia ao modelo responder até 512 problemas ou ler até 1.024 textos.
- O diagnóstico. O Astra viu que o modelo base entra em loop: 85 de suas primeiras 96 respostas de prática correram até o limite de 32.768 tokens sem chegar a uma resposta. Os autores observam que o próprio card do modelo do Qwen alerta que esse modelo é propenso a loops de raciocínio.
- O rastreamento. O Astra rastreou o loop até uma direção escrita pelas MLPs das camadas 15 e 19.
- A edição. Ele subtraiu essa direção de 64 colunas de saída de
down_projem cada uma das duas camadas. São 131.072 pesos de 0,8 bilhão.
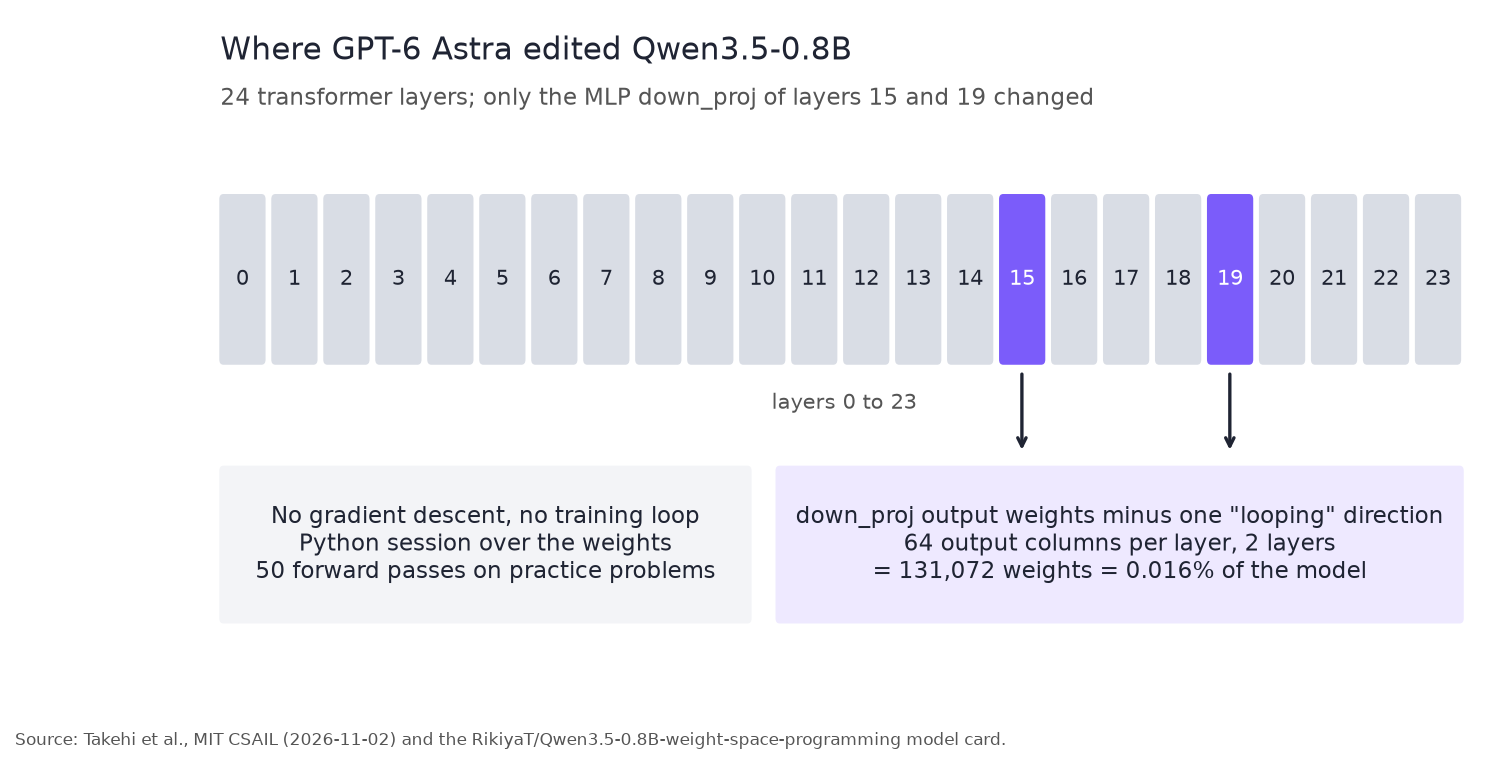
De acordo com o card do modelo no Hugging Face, apenas esses dois tensores down_proj diferem do checkpoint base Qwen/Qwen3.5-0.8B, e cada tensor reconstruído é verificado com sha256 contra aquele que os autores avaliaram. O modelo editado é distribuído sob a licença Apache 2.0.
Resultados: Qwen3.5-0.8B base vs. editado
Todos os números aqui são do post dos autores (thinking ativado, até 32.768 tokens, várias amostras por problema). "Atingiu o limite de tokens" é a proporção de respostas do MATH-500 que ficaram sem tokens.
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | Atingiu o limite de tokens |
|---|---|---|---|---|
| Base | 7,9% | 13,8% | 21,0% | 93,0% |
| Editado, 10 passagens forward | 12,3% | 25,7% | 49,0% | 87,2% |
| Editado, 25 passagens forward | 14,1% | 25,1% | 39,9% | 86,4% |
| Editado, 50 passagens forward | 48,1% | 67,1% | 62,3% | 33,1% |
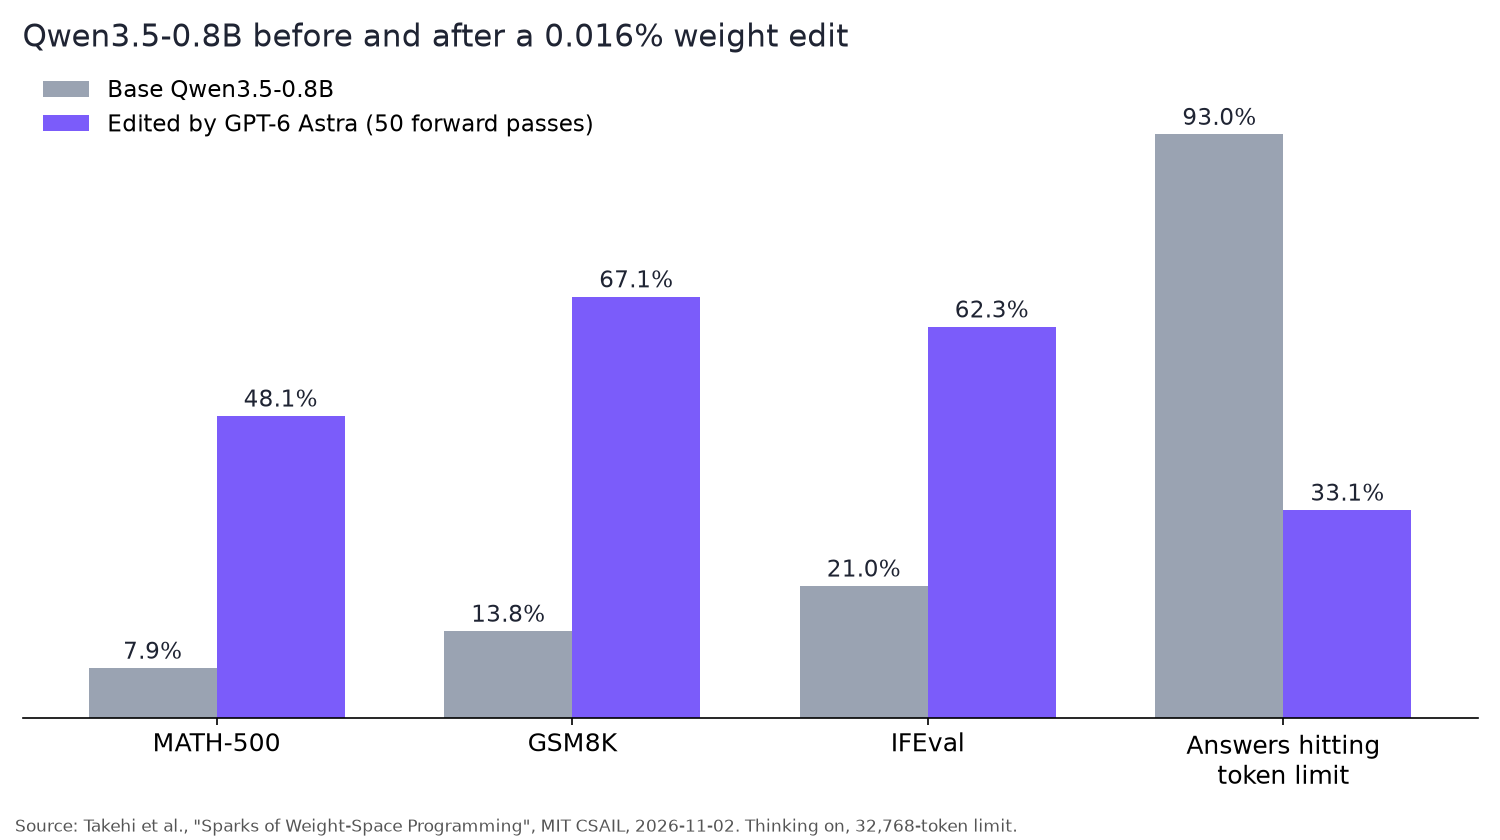
- A correção generalizou. O loop não é específico de matemática, então o IFEval também quase triplicou.
- O orçamento importou. Com 10 ou 25 passagens forward, os loops praticamente não desapareceram.
- Outra pessoa reproduziu. Ahsen Khaliq, do Hugging Face, reconstruiu o checkpoint a partir dos logs e refez todo o MATH-500 (500 problemas, 4 amostras cada). O modelo editado marcou 51,0%, com 31,6% das respostas atingindo o limite. Um smoke test de 25 problemas do modelo base deu 5,0%.
O Space de demonstração permite digitar um problema e ver os dois modelos responderem.
O que a edição de pesos não consegue fazer
Os autores fizeram um controle que importa mais do que o resultado principal. Eles tentaram a mesma abordagem no Gemma 3 270M, um modelo que raramente entra em loop (8,5% de suas respostas atingiram o limite, contra 93% do Qwen).
| Gemma 3 270M | MATH-500 |
|---|---|
| Base | 6,8% |
| Melhor edição (25 passagens forward) | 7,7% |
Os erros do Gemma eram erros comuns, como aritmética incorreta, sem um único componente para desligar. A conclusão dos autores: a edição removeu um obstáculo que escondia uma habilidade, mas não conseguiu adicionar uma habilidade que o modelo não tinha. O Qwen já conseguia resolver muitos problemas. Ele simplesmente nunca os terminava.
Então isso não é "o treinamento acabou". É um modelo de fronteira encontrando e removendo uma falha que vive em um único lugar.
O resto do artigo sobre programação em espaço de pesos
O Experimento 8 é um entre oito. Os outros usam redes muito menores:
- Ler pesos. Apenas a partir dos pesos brutos, o Astra identificou o jogo de 4 de 4 políticas de jogos treinadas com PPO e o idioma de treinamento de 3 de 3 pequenos modelos de linguagem em nível de caractere.
- Corrigir uma política. Uma política de carro do Kinetix que falhou em 256 de 256 episódios teve sucesso em 1.024 de 1.024 depois que o Astra editou 3,5% de seus pesos em uma única resposta.
- Escrever pesos do zero. O Astra escreveu pesos do MinAtar Breakout que marcaram 517,4 contra 25,3 de um PPO treinado por 500 milhões de passos. Ele perdeu no Seaquest, 53,1 contra 88,9.
- Go. Ele escreveu uma rede de Go 9x9 com 1,48 milhão de pesos a partir de zeros que, com 50 passagens forward, superou uma rede PPO de tamanho igual.
- Um erro. Apenas a partir dos pesos, ele não conseguiu dizer qual de duas cópias do Gemma 3 270M havia sido treinada para ser bajuladora. Com acesso aos padrões de atenção, ele identificou o bajulador em todos os três pares.
Os logs completos dos experimentos incluem cada prompt, os resumos de raciocínio do Astra e cada trecho de código que ele executou.
Verifique você mesmo a correção do loop de raciocínio do Qwen3.5-0.8B
O teste mais limpo é servir os dois checkpoints atrás da mesma API compatível com OpenAI e enviar a ambos prompts idênticos. O vLLM faz isso com um comando por modelo:
vllm serve Qwen/Qwen3.5-0.8B --port 8001 \
  --served-model-name qwen --max-model-len 34816 --gpu-memory-utilization 0.45

vllm serve RikiyaT/Qwen3.5-0.8B-weight-space-programming --port 8002 \
  --served-model-name qwen --max-model-len 34816 --gpu-memory-utilization 0.45
Ambos os servidores respondem pelo nome qwen, então um único corpo de requisição funciona em qualquer porta. --max-model-len 34816 corresponde ao exemplo do card do modelo.
Cada requisição espelha as configurações de amostragem dos autores e ativa o thinking:
{
  "model": "qwen",
  "messages": [{"role": "user", "content": "{{question}}\nPlease reason step by step, and put your final answer within \\boxed{}."}],
  "temperature": 0.6,
  "top_p": 0.95,
  "top_k": 20,
  "presence_penalty": 1.5,
  "max_tokens": 32768,
  "chat_template_kwargs": {"enable_thinking": true}
}
O último valor \boxed{} é a resposta, e finish_reason indica se o modelo parou (stop) ou ficou sem tokens (length). Um término length é um loop.
Se você preferir não rodar uma GPU, pode testar a API do GPT-6 Astra da mesma forma, ou comparar modelos Qwen pequenos localmente com a configuração gratuita do Qwen3.5 no Ollama.
Deixe seu agente de codificação testar os dois modelos com o Apidog CLI
Avaliar vinte gerações longas à mão é trabalho para o seu agente de codificação. O Apidog CLI dá ao agente ambientes, cenários de teste, execuções orientadas por dados e relatórios, e roda na sua máquina, então endpoints localhost funcionam.
Instale e dê a skill ao seu agente:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Depois, dê ao Claude Code, Codex, Cursor ou OpenCode um único prompt:
In Apidog project <id>, create two environments: qwen-base at http://localhost:8001
and qwen-edited at http://localhost:8002. Create a test scenario that POSTs to
/v1/chat/completions with the body in request.json, using {{question}} from the
first 10 GSM8K test questions in gsm8k-10.csv. Assert that the last \boxed{} value
equals {{answer}} and that choices[0].finish_reason is not "length". Run it against
both environments and give me a table: correct answers and length finishes per model.
O agente lê o esquema do payload, valida seu JSON e então executa estes comandos:
apidog environment create qwen-base --project <id> --base-url http://localhost:8001
apidog environment create qwen-edited --project <id> --base-url http://localhost:8002
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <id> --file scenario.json
apidog run -t <scenarioId> --project <id> -e <baseEnvId> \
  -d gsm8k-10.csv --timeout-request 1800000 -r cli,json --out-file qwen-base
apidog run -t <scenarioId> --project <id> -e <editedEnvId> \
  -d gsm8k-10.csv --timeout-request 1800000 -r cli,json --out-file qwen-edited
-d alimenta cada linha do CSV como uma iteração. --timeout-request está em milissegundos, e uma resposta em loop pode levar minutos para consumir 32.768 tokens. -r cli,json imprime um resumo e grava um relatório JSON que o agente pode comparar por diff. As 10 perguntas vêm da divisão de teste do GSM8K.
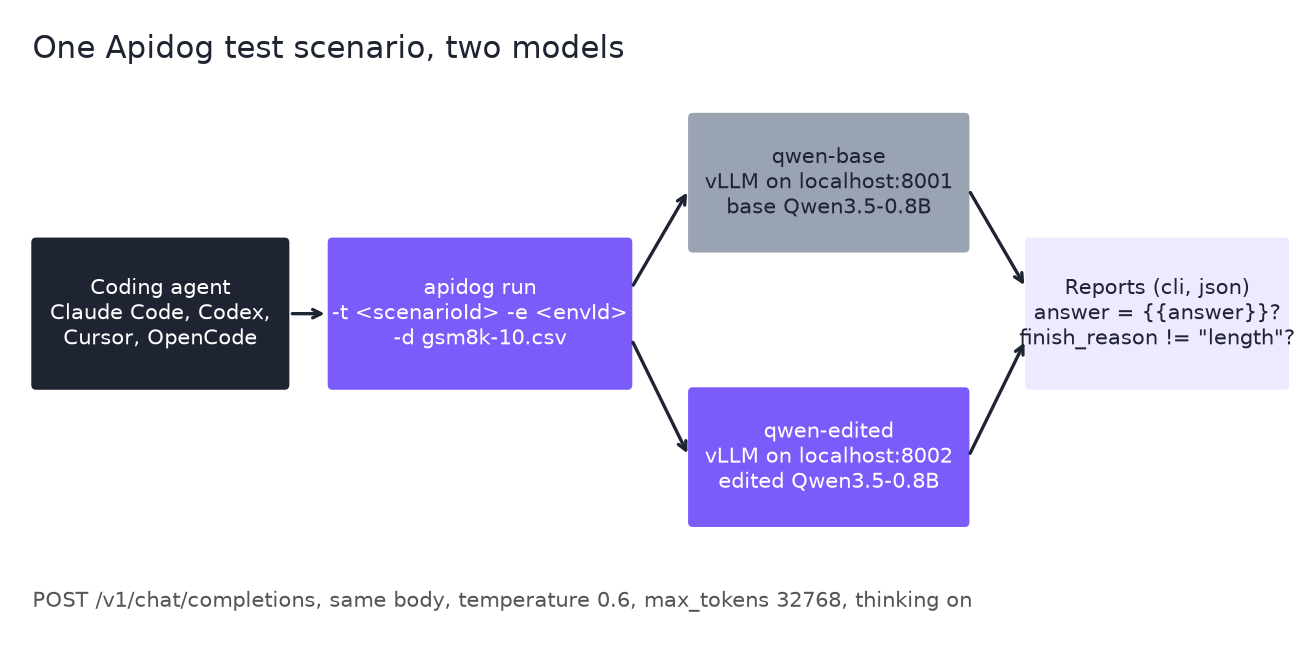
Se sua execução se parecer com a dos autores, a maioria das respostas do modelo base falhará na asserção de finish_reason e a maioria das respostas editadas passará. Dez perguntas são um smoke test, não um benchmark, então trate uma diferença como um sinal, não como uma pontuação. Adicione --upload-report para ver a execução no app, e consulte a referência do comando apidog run para ver todas as flags.
O mesmo cenário funciona como teste de regressão para qualquer troca de modelo; o guia de CI/CD do Apidog CLI mostra a configuração de -r junit.
O que isso significa se você entrega modelos pequenos
- Meça o truncamento, não só a acurácia. Os 7,9% do Qwen escondiam um modelo que na maioria das vezes nunca terminava. Uma verificação de
finish_reasondetecta isso. - Procure falhas de causa única. Loops e repetições podem viver em uma parte estreita da rede.
- Lembre-se do controle. Se seu modelo está errado em vez de travado, uma edição como essa não vai ajudar.
Escolhendo um nível do GPT-6 para trabalho com agentes? Veja GPT-6 Luna vs Sol vs Astra.
Perguntas frequentes
O GPT-6 Astra treinou o Qwen3.5-0.8B? Não. Os autores não permitiram descida de gradiente nem loop de treinamento. O Astra editou pesos em uma sessão Python e observou o modelo apenas por meio de 10, 25 ou 50 passagens forward.
Quantos pesos a edição alterou? 131.072 pesos, o que os autores estimam em 0,016% do modelo. As mudanças estão nas matrizes down_proj das MLPs nas camadas 15 e 19, 64 colunas de saída em cada.
O modelo editado está disponível? Sim, como RikiyaT/Qwen3.5-0.8B-weight-space-programming no Hugging Face sob Apache 2.0, com hashes dos dois tensores alterados e uma reexecução independente (51,0% no MATH-500).
Por que as pontuações de matemática subiram tanto? Porque o modelo base entrava em loop. No MATH-500, 93,0% de suas respostas atingiram o limite de 32.768 tokens. A edição reduziu isso para 33,1%, então o modelo terminou respostas que já conseguia resolver. Ele não aprendeu matemática nova.
A programação em espaço de pesos funciona em qualquer modelo? Ainda não, segundo os próprios autores. No Gemma 3 270M, que raramente entra em loop, a melhor edição moveu o MATH-500 de 6,8% para 7,7%. Os autores chamam todos os seus resultados de muito preliminares.
Posso testar o modelo editado sem escrever código? Sim. O Space de demonstração do Hugging Face roda os dois modelos em um problema que você digitar. Para uma verificação repetível, use o vLLM mais o Apidog CLI como mostrado acima.