
GPT-6.2 Astra vs Claude Fable 5.2 se resume ao seguinte: ambos custam $8 por milhão de tokens de entrada e $40 por milhão de tokens de saída, ambos oferecem cerca de um milhão de tokens de contexto e 128K de saída, e ambos visam tarefas longas de codificação com agentes. As diferenças que definem sua escolha são os preços de cache, o faturamento de contexto longo, as peculiaridades de API que seu harness de agente precisa tratar e o comportamento de cada modelo nas suas próprias tarefas.
A OpenAI lançou o GPT-6.2 Astra em 17 de novembro de 2026, oito dias depois que a Anthropic disponibilizou o Claude Fable 5.2. Este guia aborda as especificações, o custo de uma sessão real de agente, os erros de requisição que quebram um harness construído para o outro modelo e como testar ambos com o Apidog CLI.
GPT-6.2 Astra vs Claude Fable 5.2: o veredito rápido
Escolha o Claude Fable 5.2 se seu agente envia prompts longos e relê um grande contexto em cache, porque suas leituras de cache custam metade do preço e sua janela completa de 1M é cobrada pela tarifa padrão. Escolha o GPT-6.2 Astra se sua stack já vive na API Responses da OpenAI e você quer as ferramentas hospedadas dela, como apply_patch, shell hospedado e subagentes multiagente. Para qualquer outro caso, teste ambos nas suas próprias tarefas antes de decidir.
As primeiras análises tendem a favorecer o Fable em capacidade bruta. Simon Willison escreveu no dia do lançamento que o Astra "não pontua tão alto quanto o Fable 5.2 em vários benchmarks" e que alguns testadores acham seu estilo de comunicação confuso. Trate isso como um sinal para testar, não como um veredito.
Como o GPT-6.2 Astra e o Claude Fable 5.2 se comparam em especificações e preço?
Ambos os modelos listam o mesmo preço base, então a comparação está nos detalhes. Todos os números abaixo vêm da página do modelo GPT-6.2 Astra e da visão geral do Claude Fable 5.2, verificados em 18 de novembro de 2026.
| Especificação | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|
| ID do modelo na API | gpt-6.2-astra |
claude-fable-5-2 |
| Lançamento | 17 de nov de 2026 | 9 de nov de 2026 |
| Entrada / saída por 1M de tokens | $8 / $40 | $8 / $40 |
| Entrada em cache (leitura de cache) | $0.40 | $0.20 |
| Escrita de cache | $10 (30 min), $20 (12 h) | $10 (5 min), $16 (1 h) |
| Janela de contexto | 1.050.000 (922.000 de entrada máxima) | 1M |
| Saída máxima | 128.000 | 128K |
| Prompts longos | Acima de 272K de entrada: entrada 2x, saída 1,5x | 1M completo pelo preço padrão |
| Batch | 50% de desconto | 50% de desconto |
| Limite de conhecimento | 18 de maio de 2026 | jun de 2026 |
| Controle de raciocínio | reasoning.effort (none rejeitado) |
effort, padrão high, thinking sempre ativo |
Ambos os preços caíram 20% em relação à geração anterior. O GPT-6 Astra e o Claude Fable 5 custavam ambos $10 / $50, como observa Willison. Se você ainda usa o modelo antigo, o guia da API do GPT-6 Astra e a análise de preços do Claude Fable 5.2 cobrem o que mudou.
Quanto custa, na prática, uma sessão de agente de codificação?
Um agente de codificação raramente envia um único prompt curto. Ele recarrega o contexto do repositório, as definições de ferramentas e o histórico da conversa a cada turno, então as leituras de cache e as regras de prompt longo pesam mais que o preço de referência.
Aqui estão duas cargas de trabalho de exemplo, precificadas com base nas tabelas oficiais, em processamento Standard.
| Carga de trabalho | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|
| Sessão de agente: 150K tokens gravados em cache, 1,35M de leituras de cache, 150K de saída (todas as requisições abaixo de 272K) | $1,50 + $0,54 + $6,00 = $8,04 | $1,50 + $0,27 + $6,00 = $7,77 |
| Uma requisição longa: 400K de entrada, 8K de saída, sem cache | $6,40 + $0,48 = $6,88 | $3,20 + $0,32 = $3,52 |
O custo da sessão fica próximo porque a saída domina: 150K de tokens de saída custam $6,00 em qualquer um dos modelos. A diferença nas leituras de cache economiza 27 centavos aqui e cresce com sessões mais longas.
É na requisição longa única que as contas divergem. Quando uma requisição ao Astra ultrapassa 272K de tokens de entrada, a OpenAI dobra a taxa de entrada para $16 e eleva a saída para $60 para a requisição inteira. O Fable 5.2 cobra um prompt de 400K pela mesma taxa de $8 aplicada a um prompt de 4K.
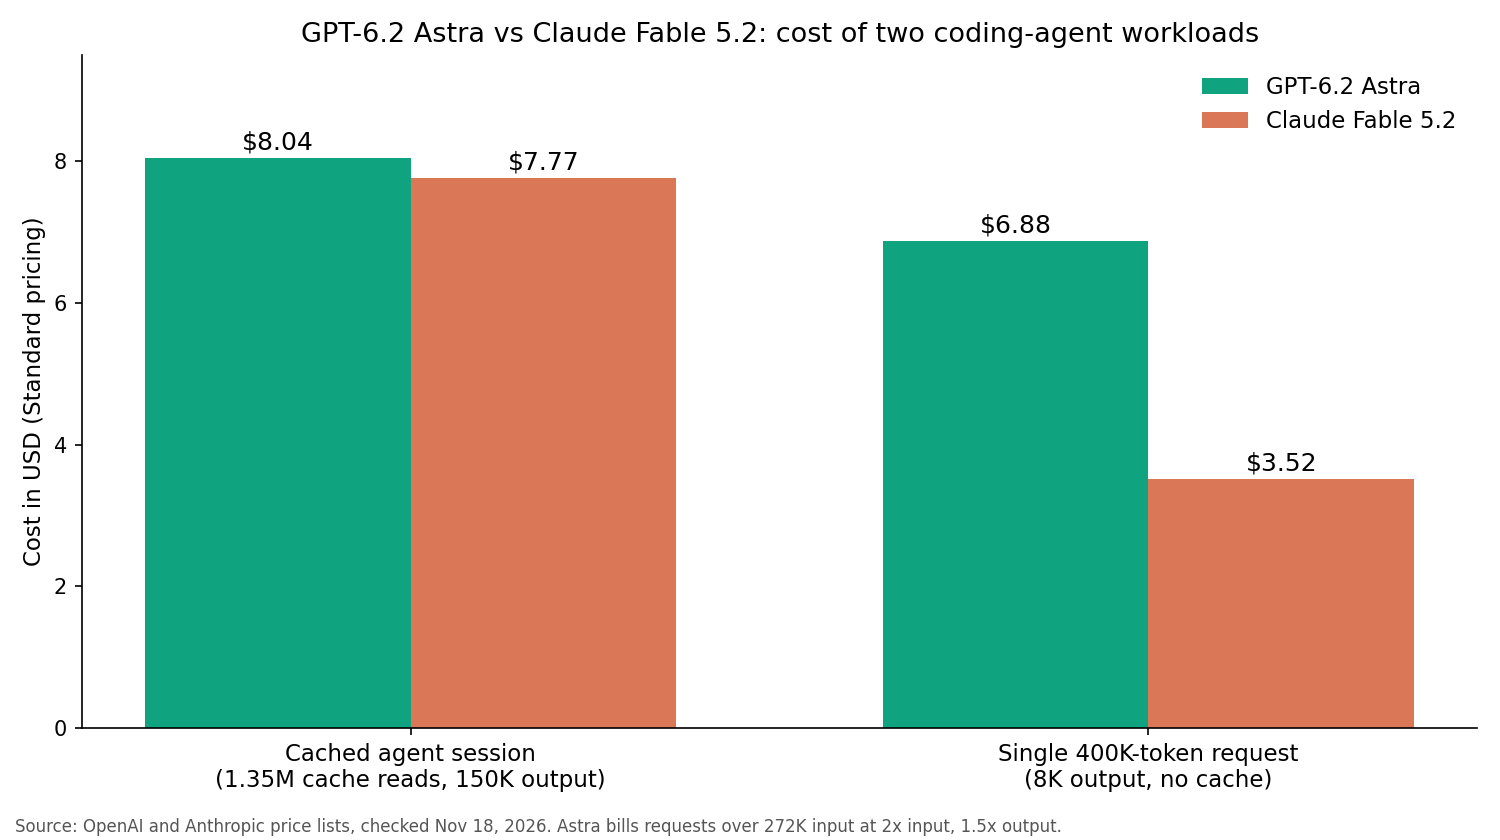
Se seu agente coloca um monorepo grande ou logs extensos em uma única requisição, mantenha-a abaixo de 272K no Astra ou espere pagar quase o dobro.
Quais peculiaridades de API quebrarão um harness construído para o outro modelo?
Trocar de modelo é mais do que mudar a string do modelo. Cada API rejeita configurações que a outra aceita, e ambas as falhas retornam como erros HTTP 400.
O Claude Fable 5.2 rejeita:
- Uso forçado de ferramentas. Definir
tool_choicecomoanyoutoolretorna um 400, segundo as notas do Fable 5.2 da Anthropic. - Parâmetros de amostragem. Omita
temperature,top_petop_k; os valores listados pela Anthropic retornam um 400. - Desativar o thinking. O adaptive thinking está sempre ativo, então o parâmetro effort é sua única alavanca para profundidade, latência e custo.
O GPT-6.2 Astra rejeita:
reasoning.effortdefinido comonone(API Responses) oureasoning_effort: "none"(Chat Completions), segundo o guia de raciocínio da OpenAI.- Os endpoints Realtime, Assistants e fine-tuning, listados como não suportados na página do modelo.
Se seu harness força uma chamada de ferramenta para obter saída estruturada, isso funciona no Astra e falha no Fable; mova a estrutura para o prompt ou para o esquema da ferramenta. Se ele define temperature: 0, remova-o para o Fable.
O tratamento de dados também difere. A Anthropic informa que o Fable 5.2 exige retenção de dados de 30 dias e não está disponível sob retenção zero de dados, a menos que a Anthropic autorize expressamente. Verifique isso contra sua política de segurança antes de rotear código de produção por ele.
Onde o GPT-6.2 Astra se destaca?
A força do Astra é o conjunto de ferramentas em seu entorno. Na API Responses, a OpenAI lista apply_patch, hosted_shell, computer_use, code_interpreter, mcp, skills e tool_search como ferramentas suportadas. Um beta multiagente permite que o Astra delegue trabalho a subagentes.
Isso importa se você prefere não construir seu próprio aplicador de patches e executor de shell.
O feedback pré-lançamento de Theo Browne, citado por Willison, diz que o Astra "consegue reunir muitos subagentes e geri-los muito bem" em tarefas longas, mas às vezes para para perguntar sobre detalhes internos que um usuário não conseguiria responder. Dê a ele condições de parada claras.
O Astra também oferece mais faixas de custo: Batch com 50% de desconto, modo Fast a 2x do Standard e janelas em segundo plano 30% abaixo do Standard para conclusão em 2 horas e 40% abaixo para conclusão em 8 horas. A geração de testes durante a noite pode rodar nessas faixas por menos.
Onde o Claude Fable 5.2 se destaca?
O Fable vence em contextos longos e pesados em cache. Suas leituras de cache custam $0,20 por milhão de tokens, 2,5% do preço de entrada, e sua janela completa de 1M é cobrada pela tarifa padrão, sem multiplicador de prompt longo.
A Anthropic posiciona o Fable 5.2 para sessões de agente que rodam por horas. Seu controle de effort vai de low a max; a Anthropic sugere começar em high, o padrão, e subir para xhigh apenas onde você tenha medido um ganho.
Ele também teve a recepção inicial mais forte em codificação criativa difícil. No teste de lançamento de Willison, um prompt de animação Three.js executado nos dois novos modelos da OpenAI com effort Ultra no Codex CLI não chegou perto do resultado que ele obteve com o Fable 5.2.
O Fable também roda no Amazon Bedrock, no Google Cloud e no Microsoft Foundry, e seu modo Fast oferece até 2,5x mais velocidade de saída por $16 / $80 por milhão de tokens. Para exemplos de requisições, consulte o guia da API do Claude Fable 5.2.
Como testar o GPT-6.2 Astra e o Claude Fable 5.2 na sua própria carga de trabalho de API?
Os benchmarks medem as tarefas de outra pessoa. Em vez disso, rode os mesmos prompts nas duas APIs:
- Escolha de 5 a 10 prompts reais do histórico do seu agente, como uma correção de bug, uma refatoração e uma tarefa de escrita de testes.
- Escreva uma requisição por modelo com conteúdo idêntico, usando o formato próprio de cada API.
- Verifique um status 200, uma resposta não vazia e o formato que seu agente interpreta.
- Execute cada requisição várias vezes e compare tokens, latência e taxa de aprovação.
Ambas as chamadas são HTTP puro. Aqui está a requisição ao Astra na API Responses:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "gpt-6.2-astra", "reasoning": {"effort": "high"},
       "input": "Review this diff and list the bugs."}'
O Fable 5.2 passa pela API Messages da Anthropic com claude-fable-5-2 como modelo e sem o campo temperature.
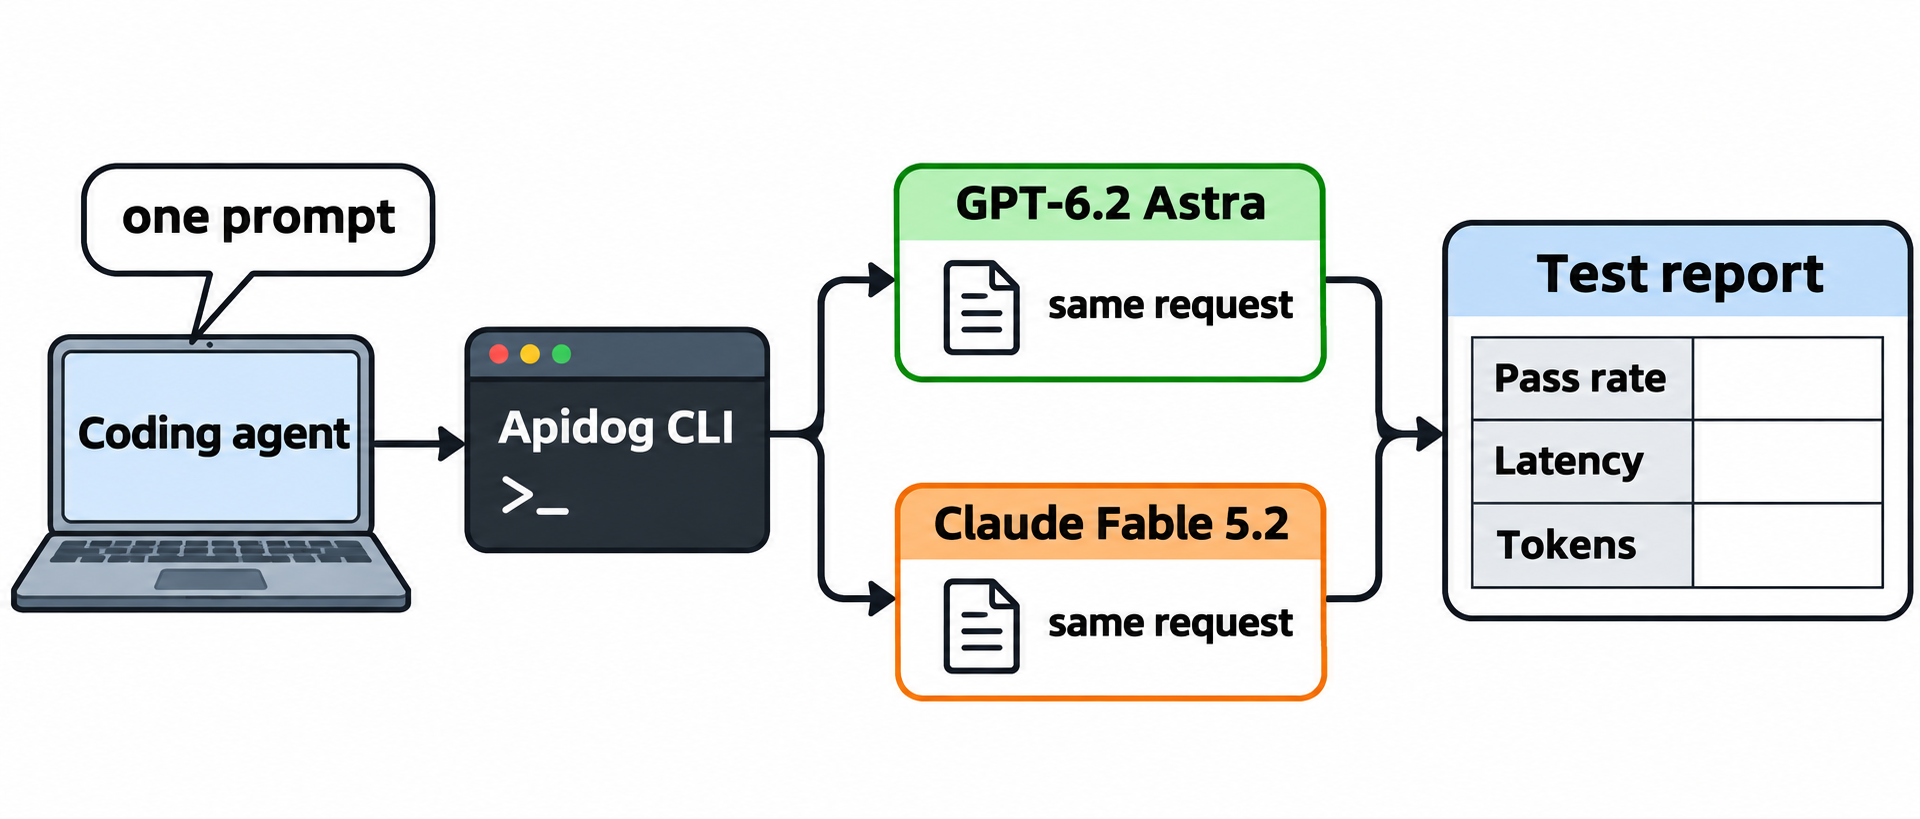
Deixe seu agente de codificação executar o A/B com o Apidog CLI
Rodar pares de requisições manualmente cansa rápido. Em vez disso, deixe o Claude Code, o Codex ou o Cursor comandar o Apidog CLI. A configuração leva três comandos:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Depois, dê ao seu agente um único prompt:
In Apidog project <PROJECT_ID>, create two test cases: one that sends
our code-review prompt to gpt-6.2-astra through the OpenAI Responses
API, and one that sends the same prompt to claude-fable-5-2 through
the Claude Messages API with no temperature field. Keep both API keys
in private environment variables. Assert a 200 status and a non-empty
answer, record token usage and response time, run each case 5 times
and summarize cost per run. Validate every payload before you write it.
O agente verifica o esquema do payload, escreve os casos e os executa. Os parâmetros abaixo vêm do apidog run --help na CLI 2.2.12:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file astra-case.json
apidog test-case create --project <PROJECT_ID> --file astra-case.json
apidog test-case create --project <PROJECT_ID> --file fable-case.json
apidog run --test-case <ASTRA_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
apidog run --test-case <FABLE_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
-n 5 repete cada caso cinco vezes, para que uma resposta lenta não decida o resultado. Adicione --upload-report para visualizar as execuções no aplicativo Apidog. Este é um modelo de fluxo de trabalho; não o executamos contra o Astra a partir desta máquina.
Você também pode transformar a seção de peculiaridades em testes. Peça ao agente um caso negativo que envie tool_choice: any ao Fable e espere um 400, e outro que envie effort: none ao Astra e espere um 400. Se qualquer um dos provedores mudar a regra, sua suíte avisará antes do seu agente. O guia do Apidog CLI no Claude Code e o guia do Apidog CLI no Codex cobrem a configuração do agente.
O plano gratuito do Apidog cobre até 4 usuários, o suficiente para executar essa comparação.
FAQ
O GPT-6.2 Astra é mais barato que o Claude Fable 5.2? O preço base é idêntico: $8 de entrada e $40 de saída por milhão de tokens. O Fable é mais barato nas leituras de cache ($0,20 vs $0,40) e em qualquer requisição acima de 272K de tokens de entrada, onde o Astra dobra sua taxa de entrada.
Qual modelo tem a maior janela de contexto? O Astra lista 1.050.000 tokens de contexto com limite de entrada de 922.000 tokens. O Fable 5.2 lista 1M de tokens. Ambos limitam a saída a 128K tokens por requisição.
Posso usar chamadas de ferramenta forçadas com o Claude Fable 5.2? Não. Um tool_choice definido como any ou tool retorna um erro 400. Deixe o modelo escolher as ferramentas por conta própria e descreva a estrutura esperada no prompt ou no esquema da ferramenta.
Posso desativar o raciocínio no GPT-6.2 Astra? Não. A API rejeita reasoning.effort definido como none com um erro 400. Escolha um nível de effort suportado mais baixo para chamadas rápidas e baratas.
Em qual modelo devo rodar meu agente de codificação? Comece pela sua carga de trabalho. Prompts longos e pesados em cache favorecem o Fable 5.2, enquanto stacks nativas da OpenAI que querem ferramentas hospedadas de patch, shell e subagentes favorecem o Astra. Rode ambos em 5 a 10 prompts reais antes de fazer a troca.