
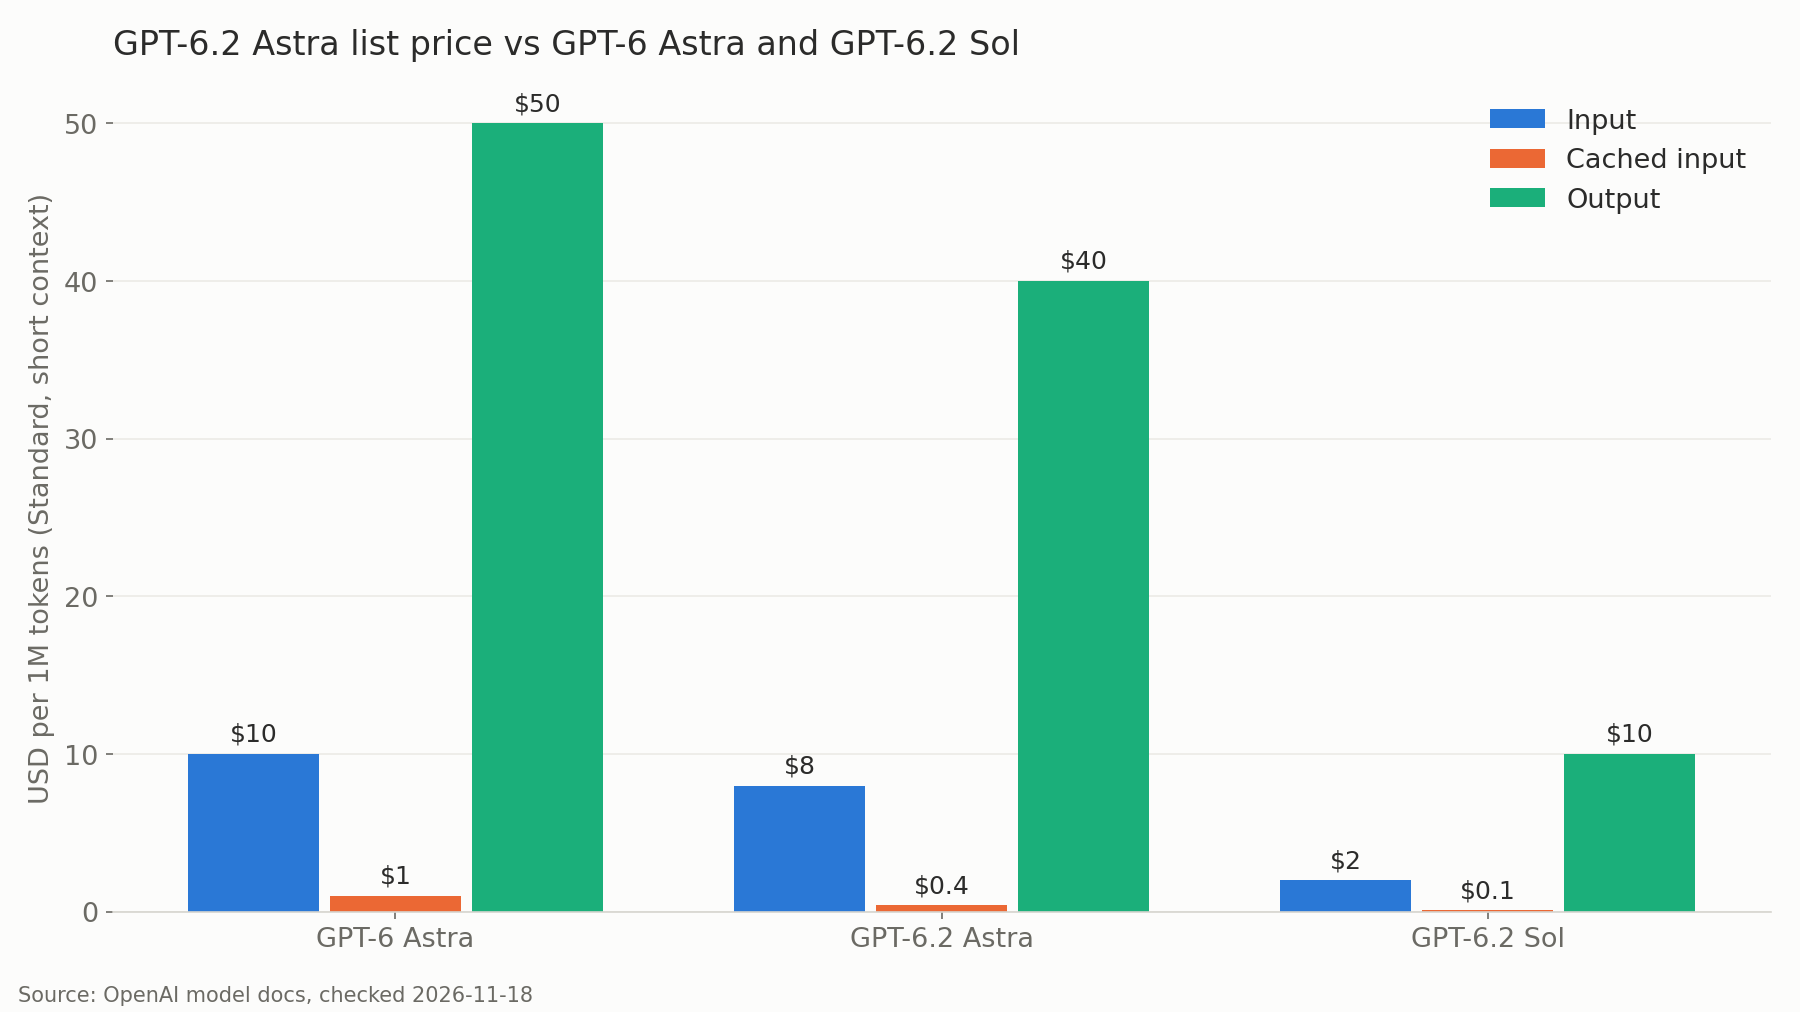
O preço do GPT-6.2 Astra é de US$ 8 por 1 milhão de tokens de entrada e US$ 40 por 1 milhão de tokens de saída no plano Standard da OpenAI, com entrada em cache a US$ 0,40 por 1 milhão. Isso é 20% abaixo do GPT-6 Astra (US$ 10/US$ 50), e a taxa de leitura do cache caiu 60%. Seu irmão, o GPT-6.2 Sol, custa US$ 2 de entrada e US$ 10 de saída por 1 milhão de tokens.
A OpenAI lançou os dois modelos em 17 de novembro de 2026 como gpt-6.2-astra e gpt-6.2-sol.
Preços do GPT-6.2 Astra em resumo
O GPT-6.2 Astra é o modelo de fronteira da OpenAI para projetos longos e complexos: programação, uso do computador e trabalho com documentos, com uma janela de contexto de 1.050.000 tokens e até 128.000 tokens de saída. No plano Standard, ele é cobrado a US$ 8 por 1 milhão de tokens de entrada, US$ 0,40 por 1 milhão de tokens de entrada em cache e US$ 40 por 1 milhão de tokens de saída, para prompts de até 272 mil tokens.
| Tarifa (por 1M de tokens, Standard) | GPT-6.2 Astra | GPT-6.2 Sol | GPT-6 Astra |
|---|---|---|---|
| Entrada | US$ 8,00 | US$ 2,00 | US$ 10,00 |
| Entrada em cache | US$ 0,40 | US$ 0,10 | US$ 1,00 |
| Gravação em cache (30 minutos) | US$ 10,00 | US$ 2,50 | US$ 12,50 |
| Gravação em cache (12 horas) | US$ 20,00 | US$ 5,00 | US$ 25,00 |
| Saída | US$ 40,00 | US$ 10,00 | US$ 50,00 |
Os tokens de raciocínio são cobrados como tokens de saída. Isso importa no Astra, porque o modelo rejeita solicitações que definem o esforço de raciocínio como none, então cada chamada carrega algum custo de raciocínio além da resposta visível.
Custo do GPT-6.2 Astra na API por token
Um token de entrada custa US$ 0,000008 e um token de saída custa US$ 0,00004. A saída custa 5 vezes o preço da entrada, então tudo o que o modelo escreve, incluindo o raciocínio oculto, é o que domina sua fatura.
Uma solicitação típica de chat com 3.000 tokens de entrada e 800 tokens de saída custa:
- GPT-6.2 Astra: US$ 0,024 de entrada + US$ 0,032 de saída = US$ 0,056
- GPT-6.2 Sol: US$ 0,006 + US$ 0,008 = US$ 0,014
- GPT-6 Astra: US$ 0,030 + US$ 0,040 = US$ 0,070
Dimensione isso para um aplicativo que atende 20.000 solicitações assim por dia. Em 30 dias, são 600.000 solicitações: cerca de US$ 33.600 no GPT-6.2 Astra, US$ 8.400 no GPT-6.2 Sol e US$ 42.000 no GPT-6 Astra. O Sol mantém o mesmo preço de tabela de US$ 2/US$ 10 do GPT-6 Sol e do GPT-6.1 Sol, então, se você já faz orçamento para o Sol, nada muda.
Preço do cache do GPT-6.2 Astra: a maior mudança
O corte principal foi de 20%, mas o corte no cache foi maior. Leituras em cache no GPT-6.2 Astra custam US$ 0,40 por 1 milhão, o que equivale a 0,05x da taxa de entrada. O GPT-6 Astra cobrava US$ 1,00, ou 0,1x. O guia de cacheamento de prompts da OpenAI confirma que a taxa de leitura de 0,05x se aplica ao GPT-6.2 Astra, GPT-6.2 Sol, GPT-6.1 Sol e GPT-6.1 Terra.
Três regras determinam quanto você paga:
- Gravações substituem a entrada, elas não se acumulam. Um token gravado no cache é cobrado pela taxa de gravação em vez da taxa de entrada, nunca por ambas. Uma gravação de 30 minutos custa 1,25x a entrada (US$ 10 no Astra); uma gravação de 12 horas custa 2,5x (US$ 20).
- O prefixo mínimo é de 1.024 tokens. Prompts mais curtos nunca são armazenados em cache.
- As leituras custam o mesmo nos dois tempos de vida. Escolha gravações de 12 horas apenas para prompts de sistema estáveis e documentação de referência reutilizada em longos intervalos.
Nessas tarifas, o cache se paga na primeira reutilização. Uma gravação de 30 minutos mais uma leitura custa 1,30x o preço sem cache de um prefixo, contra 2x para enviá-lo duas vezes. Em dez solicitações, são 1,70x contra 10x.
Simon Willison chamou o preço em cache de "ótima notícia para sessões agentivas de longa duração" em seu texto do dia do lançamento. Para táticas, consulte nosso guia sobre cacheamento de prompts no GPT-6.
Quanto custa uma sessão agentiva de 50 turnos
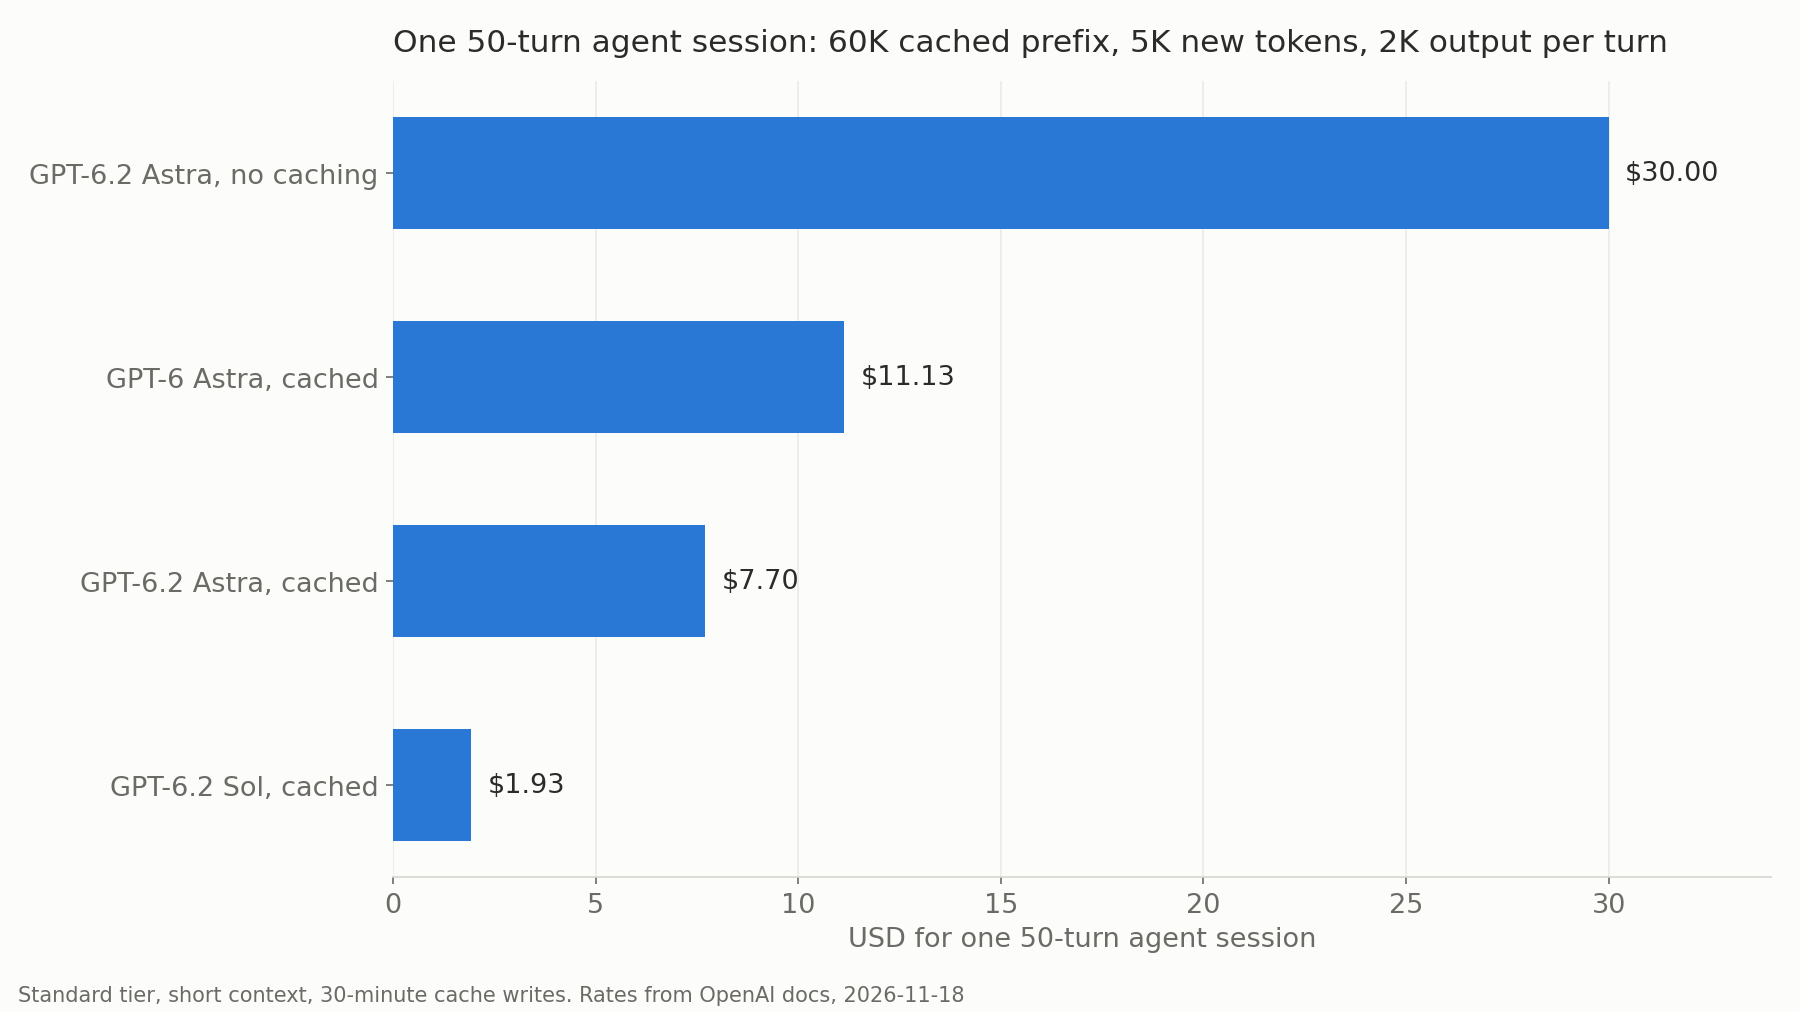
Considere um agente de programação que executa 50 turnos. Cada turno relê um prefixo de 60 mil tokens do cache, grava 5 mil tokens novos em um cache de 30 minutos e produz 2 mil tokens de saída.
| Modelo e configuração | Custo por turno | Custo por sessão |
|---|---|---|
| GPT-6.2 Astra, sem cache | US$ 0,600 | US$ 30,00 |
| GPT-6 Astra, com cache | US$ 0,223 | US$ 11,13 |
| GPT-6.2 Astra, com cache | US$ 0,154 | US$ 7,70 |
| GPT-6.2 Sol, com cache | US$ 0,039 | US$ 1,93 |
O cacheamento reduz a sessão do GPT-6.2 Astra em 74%. Em comparação com o GPT-6 Astra com o mesmo cacheamento, o novo modelo é 31% mais barato por sessão, mais do que o corte de 20% na tabela, porque o prefixo em cache é a maior parcela da entrada.
Preços de contexto longo acima de 272 mil tokens
O GPT-6.2 Astra aceita até 922.000 tokens de entrada, mas o preço muda a partir de 272 mil. Quando a entrada de uma solicitação ultrapassa 272 mil tokens, as taxas de entrada e de cache dobram e a de saída sobe para 1,5x, para toda a solicitação, não apenas para o excedente.
| Tarifa (por 1M de tokens) | Até 272 mil de entrada | Acima de 272 mil de entrada |
|---|---|---|
| Entrada | US$ 8,00 | US$ 16,00 |
| Entrada em cache | US$ 0,40 | US$ 0,80 |
| Gravação em cache (30 minutos) | US$ 10,00 | US$ 20,00 |
| Saída | US$ 40,00 | US$ 60,00 |
Uma única revisão de base de código de 400 mil tokens com 4 mil tokens de saída custa US$ 6,40 + US$ 0,24 = US$ 6,64. Se a mesma revisão for reduzida para 250 mil tokens, o custo cai para US$ 2,00 + US$ 0,16 = US$ 2,16. Se você executar a revisão de 400 mil repetidamente com 380 mil tokens servidos do cache e 20 mil tokens novos gravados, custa cerca de US$ 0,94 por execução.
Recuperação e redução de tamanho compensam quando um prompt fica logo acima de 272 mil.
Batch, janelas em segundo plano, Fast e Ultrafast
A página de preços da OpenAI lista o GPT-6.2 Astra em quatro níveis de processamento, além de janelas em segundo plano com desconto. O GPT-6.2 não aparece na tabela Flex, então as janelas em segundo plano assumem esse papel para trabalhos que podem esperar.
| Nível (contexto curto) | Astra entrada / saída | Sol entrada / saída |
|---|---|---|
| Standard | US$ 8 / US$ 40 | US$ 2 / US$ 10 |
| Batch (50% de desconto) | US$ 4 / US$ 20 | US$ 1 / US$ 5 |
| Segundo plano, janela de 8 horas (40% de desconto) | US$ 4,80 / US$ 24 | US$ 1,20 / US$ 6 |
| Segundo plano, janela de 2 horas (30% de desconto) | US$ 5,60 / US$ 28 | US$ 1,40 / US$ 7 |
| Fast (2x) | US$ 16 / US$ 80 | US$ 4 / US$ 20 |
| Ultrafast, até 28 de fevereiro de 2027 (3x) | US$ 24 / US$ 120 | US$ 6 / US$ 30 |
| Ultrafast, a partir de 1º de março de 2027 (6x) | US$ 48 / US$ 240 | US$ 12 / US$ 60 |
As janelas em segundo plano são uma beta pública na API Responses. Você define background como true e background_options.completion_window como 2h ou 8h, e deixa o streaming desativado. O guia do modo em segundo plano aponta duas ressalvas: essas solicitações compartilham o limite de taxa do Batch, e solicitações Standard não podem reutilizar entradas de cache criadas por solicitações de 2h ou 8h.
Aqui está um trabalho noturno que resume 10.000 documentos, cada um com 4 mil tokens de entrada e 500 de saída:
| Nível | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Standard | US$ 520 | US$ 130 |
| Segundo plano, 2 horas | US$ 364 | US$ 91 |
| Segundo plano, 8 horas | US$ 312 | US$ 78 |
| Batch | US$ 260 | US$ 65 |
A taxa de 3x do Ultrafast é uma promoção; em 1º de março de 2027 ela dobra para 6x, então não conte com ela no seu orçamento.
GPT-6.2 Astra vs GPT-6.2 Sol e flagships rivais
O Astra custa exatamente 4x o Sol em todas as linhas. A página do modelo do Sol lista o mesmo contexto de 1.050.000 tokens, o mesmo limite de saída de 128.000 tokens, as mesmas ferramentas e os mesmos limites de taxa. Portanto, a escolha se resume à qualidade por tarefa, não a recursos.
| Modelo (por 1M de tokens) | Entrada | Leitura em cache | Saída |
|---|---|---|---|
| GPT-6.2 Astra | US$ 8,00 | US$ 0,40 | US$ 40,00 |
| Claude Fable 5.2 | US$ 8,00 | US$ 0,20 | US$ 40,00 |
| Claude Opus 5.5 | US$ 4,00 | US$ 0,20 | US$ 20,00 |
| GPT-6.2 Sol | US$ 2,00 | US$ 0,10 | US$ 10,00 |
Os preços do Claude vêm da página de preços da Anthropic, verificados em 18 de novembro de 2026. O GPT-6.2 Astra e o Claude Fable 5.2 compartilham o mesmo preço de tabela de US$ 8/US$ 40; os acertos de cache do Fable 5.2 custam US$ 0,20 e suas taxas de gravação seguem os tempos de vida de 5 minutos e 1 hora da Anthropic, não os de 30 minutos e 12 horas da OpenAI, então compare o custo realizado no seu próprio tráfego.
As primeiras análises são mistas quanto à qualidade. Willison observa que o GPT-6.2 Astra "não pontua tão alto quanto o Fable 5.2 em vários benchmarks", então faça sua própria avaliação antes de decidir. Se você está vindo da geração anterior, nosso guia da API do GPT-6 Astra cobre o formato das requisições, e a migração do GPT-6 Astra para o Sol explica quando o modelo mais barato é suficiente.
Ambos os modelos compartilham os mesmos limites de taxa do plano Standard: 5.000 solicitações e 1 milhão de tokens por minuto no nível Build, até 15.000 solicitações e 40 milhões de tokens por minuto no Grow.
Deixe o Codex verificar seus custos do GPT-6.2 Astra com a Apidog CLI
As tabelas de preços só ajudam se suas solicitações realmente aproveitarem o cache e ficarem abaixo de 272 mil tokens. Seu agente de programação pode verificar isso a cada build com a Apidog CLI.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Depois, dê ao seu agente um único prompt:
Create an Apidog test case in project <id> for POST /v1/responses with model
gpt-6.2-astra. Send the same 2,000-token system prompt twice. Assert both calls
return 200, usage.input_tokens stays under 272000, and the second call reports
usage.input_tokens_details.cached_tokens above 0. Run it against the openai
environment and summarize any failures.
O agente lê o schema, valida o payload, cria o caso de teste e o executa:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Se uma alteração de prompt quebrar o cache ou empurrar uma solicitação além de 272 mil tokens, a execução falha antes de a conta chegar. O mesmo apidog run com -r junit se encaixa no CI; nosso guia sobre o pipeline de CI/CD da Apidog CLI tem uma configuração pronta para copiar e colar, e o Apidog CLI no Codex cobre o lado do agente. O plano gratuito da Apidog cobre até 4 usuários.
FAQ
Quanto custa o GPT-6.2 Astra por 1 milhão de tokens? US$ 8 por 1 milhão de tokens de entrada, US$ 0,40 por 1 milhão de tokens de entrada em cache e US$ 40 por 1 milhão de tokens de saída no plano Standard, para solicitações de até 272 mil tokens de entrada.
O GPT-6.2 Astra é mais barato que o GPT-6 Astra? Sim. Entrada e saída são 20% menores (US$ 8/US$ 40 vs US$ 10/US$ 50) e as leituras em cache são 60% menores (US$ 0,40 vs US$ 1,00). Nossa sessão agentiva com cache saiu 31% mais barata.
Quanto custa o GPT-6.2 Sol? US$ 2 por 1 milhão de tokens de entrada, US$ 0,10 em cache e US$ 10 de saída, o mesmo preço de tabela do GPT-6.1 Sol e do GPT-6 Sol. É um quarto do preço do Astra em todas as linhas.
O GPT-6.2 Astra cobra mais por prompts longos? Sim. Acima de 272 mil tokens de entrada, as taxas de entrada e de cache dobram e a de saída vai para 1,5x para toda a solicitação: US$ 16 de entrada, US$ 0,80 em cache e US$ 60 de saída por 1 milhão de tokens.
Posso obter desconto no GPT-6.2 Astra? O Batch custa 50% do Standard. Solicitações em segundo plano na API Responses têm 30% de desconto com janela de 2 horas ou 40% com janela de 8 horas (beta pública). O cacheamento reduz prefixos repetidos a 0,05x da taxa de entrada.
Os tokens de raciocínio contam na fatura do GPT-6.2 Astra? Sim. Os tokens de raciocínio são cobrados pela taxa de saída de US$ 40 por 1 milhão, e o modelo rejeita esforço de raciocínio none, então inclua o raciocínio no orçamento de cada chamada.