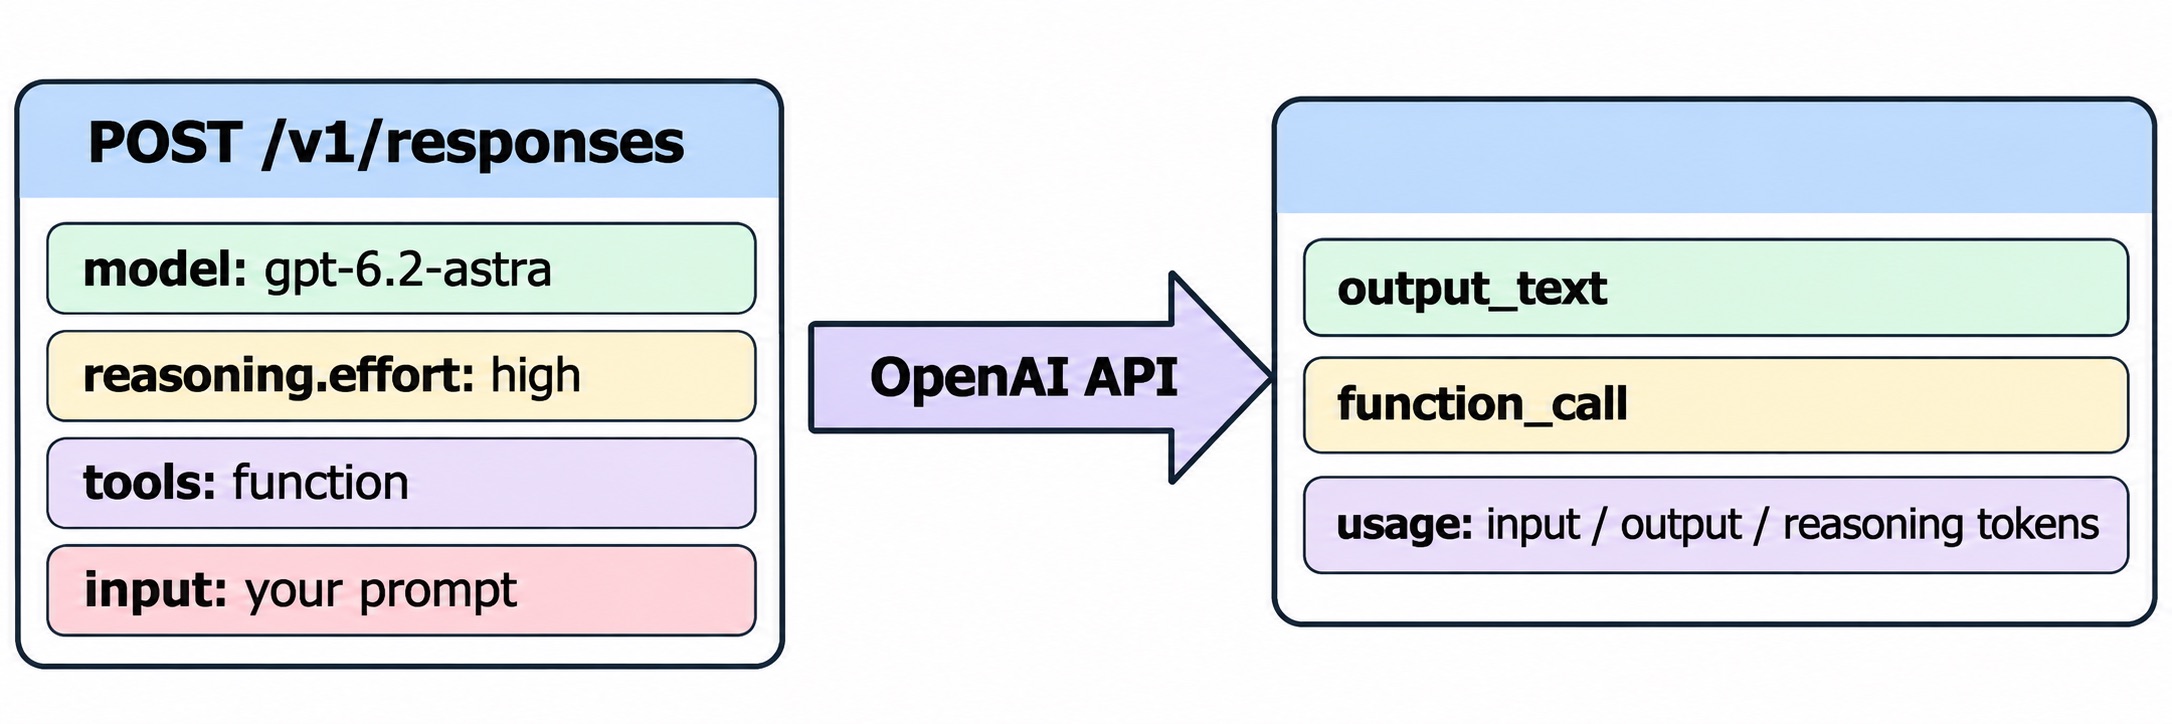
Resposta rápida: Para usar a API do GPT-6.2 Astra, envie uma requisição ao endpoint Responses da OpenAI (POST /v1/responses) com "model": "gpt-6.2-astra", um nível de esforço de raciocínio como "high" e o seu input. Ela custa $8 por milhão de tokens de entrada e $40 por milhão de tokens de saída, aceita até 922 mil tokens de entrada e retorna até 128 mil. Não defina o esforço como none: a API rejeita esse valor.
A OpenAI lançou o GPT-6.2 Astra e seu irmão mais barato, o GPT-6.2 Sol, em 17 de novembro de 2026. Se você já chamou o GPT-6 Astra antes, quase todo o seu código continua funcionando. Este guia apresenta a API do GPT-6.2 Astra, desde a primeira requisição até chamadas de ferramentas, ajuste de esforço, armadilhas de preço e um teste repetível que seu agente de programação pode executar para você.
O que você precisa antes da primeira chamada à API do GPT-6.2 Astra
Você precisa de quatro coisas, e provavelmente já tem três delas:
- Uma chave de API da OpenAI obtida no painel da plataforma, exportada como
OPENAI_API_KEY. - Um nível pago de uso. A página de modelos da OpenAI lista limites de taxa do Astra a partir do nível Build (5.000 requisições e 1 milhão de tokens por minuto).
- O ID do modelo
gpt-6.2-astra. O modelo mais barato é ogpt-6.2-sol. - Um endpoint suportado: Responses, Chat Completions ou Batch. Realtime, Assistants e fine-tuning não suportam nenhum dos dois modelos.
Essas especificações vêm da página do modelo GPT-6.2 Astra da OpenAI, verificadas em 18 de novembro de 2026.
| Especificação | GPT-6.2 Astra |
|---|---|
| ID do modelo | gpt-6.2-astra |
| Janela de contexto | 1.050.000 tokens |
| Entrada máxima | 922.000 tokens |
| Saída máxima | 128.000 tokens |
| Limite de conhecimento | 18 de maio de 2026 |
| Endpoints | Responses, Chat Completions, Batch |
| Recursos | Streaming, function calling, saídas estruturadas, entrada de imagem, cache de prompt |
Como fazer sua primeira requisição à API do GPT-6.2 Astra
A API Responses é o endpoint para o qual a OpenAI desenvolve novos recursos, então comece por ela. Aqui estão os passos:
- Exporte sua chave:
export OPENAI_API_KEY=sk-... - Envie uma requisição com o ID do modelo e um nível de esforço.
- Leia
output_textpara obter a resposta eusagepara ver a contagem de tokens.
Com curl:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.2-astra",
    "reasoning": { "effort": "high" },
    "input": "Review this migration plan and list the three biggest risks."
  }'
Com o SDK oficial de Python (pip install --upgrade openai):
from openai import OpenAI

client = OpenAI()  # reads OPENAI_API_KEY

response = client.responses.create(
    model="gpt-6.2-astra",
    reasoning={"effort": "high"},
    input="Review this migration plan and list the three biggest risks.",
)

print(response.output_text)
print(response.usage)
Com Node.js (npm install openai):
import OpenAI from "openai";

const client = new OpenAI();

const response = await client.responses.create({
  model: "gpt-6.2-astra",
  reasoning: { effort: "high" },
  input: "Review this migration plan and list the three biggest risks.",
});

console.log(response.output_text);
Verifique o bloco usage em todas as chamadas iniciais. O Astra gasta tokens de raciocínio antes de escrever uma única palavra, e esses tokens são cobrados como saída. Uma resposta curta pode custar mais do que você espera.
Escolhendo o esforço de raciocínio do GPT-6.2 Astra
O esforço de raciocínio é a alavanca mais importante tanto para a qualidade quanto para o custo. O guia de raciocínio da OpenAI lista os valores none, minimal, low, medium, high, xhigh e max, e informa que cada modelo suporta apenas um subconjunto. Para o GPT-6.2 Astra e o Sol, a única regra confirmada é que none é rejeitado, ou seja, toda chamada faz algum raciocínio.
| Esforço | Quando usar |
|---|---|
low / medium |
Edições simples, extração, respostas curtas |
high |
Revisão de código, planejamento, a maioria dos prompts difíceis. Um padrão sensato para começar a testar |
xhigh |
Execuções longas de agentes e trabalhos assíncronos, apenas quando os evals mostrarem ganho claro |
max |
Seus problemas mais difíceis, em que uma resposta melhor compensa várias vezes o custo dos tokens |
A OpenAI não informa o esforço padrão do Astra, por isso defina-o explicitamente em cada requisição. Isso mantém suas faturas e resultados de teste reproduzíveis.
Quanto o esforço muda a conta? Simon Willison executou o mesmo prompt de imagem em cada modelo em três níveis de esforço no dia do lançamento e publicou os custos. O Astra custou 11,55 centavos em high, 17,70 centavos em xhigh e 88,71 centavos em max. Ir de high para max multiplicou o custo por quase oito.
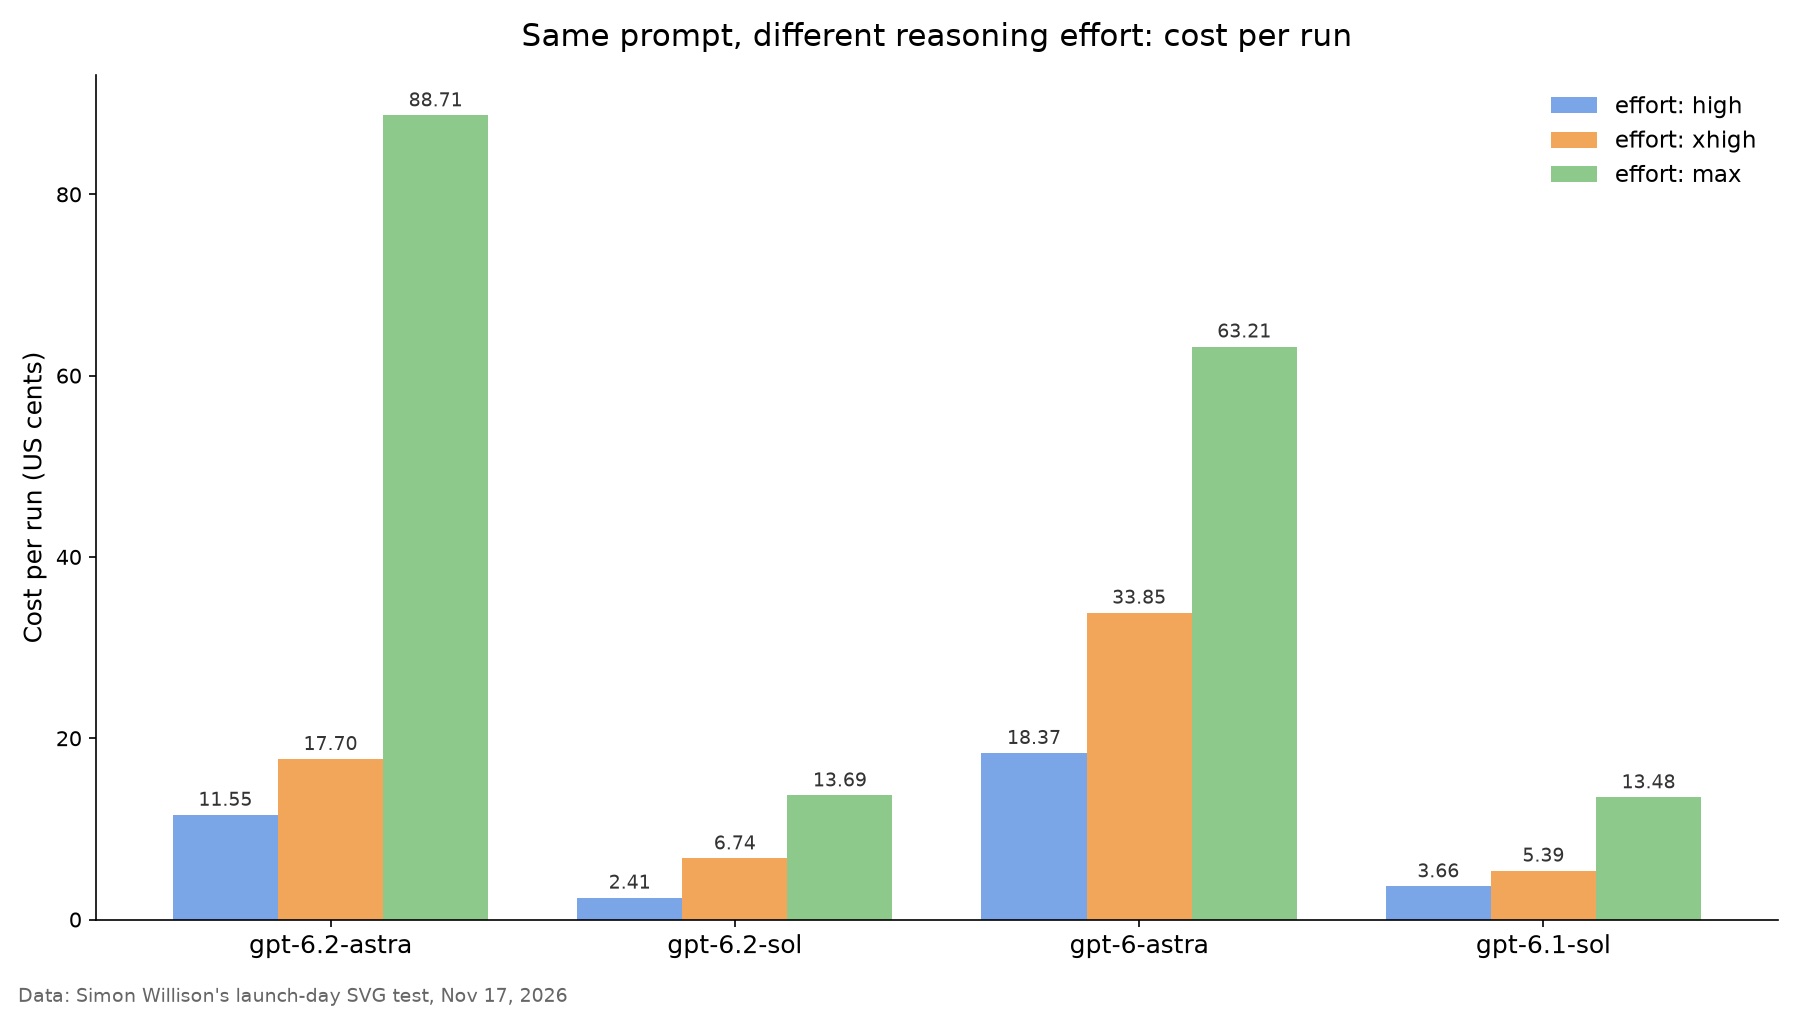
Note que o GPT-6.2 Astra ficou mais barato que o GPT-6 Astra em high e xhigh, mas mais caro em max. O preço por token caiu 20%, mas o esforço max raciocina por mais tempo. Meça o custo por tarefa concluída, não o custo por milhão de tokens.
Usando ferramentas e saídas estruturadas com a API do GPT-6.2 Astra
O Astra suporta function calling, saídas estruturadas e uma longa lista de ferramentas hospedadas na API Responses: busca na web, busca em arquivos, geração de imagens, interpretador de código, shell hospedado, apply patch, skills, uso de computador, MCP e busca de ferramentas.
Uma ferramenta de função é idêntica ao que era para o GPT-6 Astra:
response = client.responses.create(
    model="gpt-6.2-astra",
    reasoning={"effort": "high"},
    tools=[{
        "type": "function",
        "name": "get_order_status",
        "description": "Look up an order by its ID.",
        "parameters": {
            "type": "object",
            "properties": {"order_id": {"type": "string"}},
            "required": ["order_id"],
        },
    }],
    input="Where is order A-1042?",
)

for item in response.output:
    if item.type == "function_call":
        print(item.name, item.arguments)
Execute a função você mesmo e, em seguida, envie o resultado de volta como um item function_call_output com o call_id correspondente. O Astra escreve a resposta final a partir dele.
Para obter saída legível por máquina, passe um schema JSON em text.format com "type": "json_schema" e "strict": true. O modelo então retorna um JSON que corresponde ao seu schema, e você pode analisá-lo sem achismos.
Dois hábitos ajudam com um modelo tão capaz. Primeiro, dê a cada ferramenta uma descrição precisa e um schema rigoroso; avaliadores no dia do lançamento relataram que o Astra pode se desviar em tarefas longas e abertas. Segundo, defina max_output_tokens em loops de agentes para que uma etapa descontrolada não consuma seu orçamento. Para informações de fundo sobre o próprio endpoint, consulte nosso guia da API Responses da OpenAI.
Preços e limites de taxa da API do GPT-6.2 Astra
O Astra é cobrado por milhão de tokens, com uma sobretaxa para prompts muito longos. Estas tarifas vêm da página do modelo:
| Item | GPT-6.2 Astra | GPT-6 Astra (referência) |
|---|---|---|
| Entrada | $8.00 | $10.00 |
| Entrada em cache | $0.40 | $1.00 |
| Gravações em cache (retenção de 30 min) | $10.00 | n/a |
| Saída | $40.00 | $50.00 |
A armadilha está na regra de contexto longo. Quando uma requisição ultrapassa 272 mil tokens de entrada, as tarifas de entrada e cache dobram e a saída custa 1,5x para toda a requisição. Um prompt de 300 mil tokens é cobrado a $16 de entrada e $60 de saída, e não apenas os tokens além do limite. Se você está alimentando o Astra com repositórios inteiros, divida em blocos ou use cache abaixo de 272 mil sempre que possível.
Trabalhos em Batch servem para evals e backfills que podem esperar; a VentureBeat informa que o Batch roda pela metade do preço.
Limites de taxa padrão por nível:
| Nível | Requisições/min | Tokens/min |
|---|---|---|
| Build | 5.000 | 1.000.000 |
| Launch | 10.000 | 4.000.000 |
| Grow | 15.000 | 40.000.000 |
Trate respostas 429 com backoff exponencial. Uma execução longa de agente em xhigh pode esgotar rapidamente o orçamento de tokens de um nível Build.
Migrando do GPT-6 Astra para o GPT-6.2 Astra
A maioria dos códigos precisa de apenas uma mudança: a string do modelo. Antes de ativá-la em produção, verifique o seguinte:
- ID do modelo:
gpt-6-astraviragpt-6.2-astra. - Esforço
none: se algum caminho de código o enviar, agora falha. Troque pelo menor valor que seus evals aceitarem. - Cache de prompt: a entrada em cache caiu de $1.00 para $0.40, então system prompts e listas de ferramentas estáveis agora valem a pena cachear.
- Prompts longos: revise qualquer requisição próxima de 272 mil tokens contra a regra de contexto longo acima.
- Segurança: a OpenAI afirma que ambos os modelos GPT-6.2 atingem seu patamar "Critical" de segurança cibernética e vêm com salvaguardas mais rígidas. Prompts de ferramentas de segurança podem receber recusas que não recebiam antes.
As primeiras análises estão divididas, então teste antes de migrar. Ethan Mollick chamou o Astra de "muito irregular e estranho", e Dan Shipper disse que ele frequentemente parava cedo em builds de ponta a ponta, segundo o levantamento da VentureBeat. Outros elogiaram sua revisão de código e o uso de computador. Seus próprios prompts são o único benchmark que importa. O guia da API do GPT-6 Astra cobre o que continua valendo da geração anterior, e se a maior parte do seu tráfego for rotineira, o guia da API do GPT-6.1 Sol mostra o formato de requisição do nível mais barato.
Deixe seu agente de programação testar o GPT-6.2 Astra com o Apidog CLI
Colar prompts em um terminal mostra como o Astra se saiu hoje. Não mostra quando uma atualização quebrará seu schema no próximo mês. Em vez disso, deixe seu agente de programação criar a verificação e executá-la com o Apidog CLI; você escreve um único prompt.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Depois, dê ao Claude Code, Codex ou Cursor um único prompt:
In Apidog project <projectId>, create a test case for POST https://api.openai.com/v1/responses
with model "gpt-6.2-astra", reasoning effort "high" and a get_order_status function tool.
Assert status 200, that the output contains a function_call named get_order_status,
that its arguments parse as JSON with an order_id, and that usage.output_tokens is under 4000.
Read the API key from the OPENAI_API_KEY variable in environment <envId>, then run it.
O agente lê o schema do payload, verifica o arquivo correspondente, cria o caso de teste e o executa:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Mantenha a chave no ambiente do Apidog, não no prompt, para que ela nunca fique no contexto do seu agente. Adicione --upload-report para revisar a execução no app do Apidog, ou -n 5 para repeti-la e ver quão consistentes são as chamadas de ferramenta do Astra. Troque por -r junit em um pipeline e a verificação será executada a cada deploy; o guia do Apidog CLI em CI/CD mostra a configuração, e o Apidog CLI no Claude Code cobre o lado do agente. O plano gratuito do Apidog cobre equipes de até 4 usuários.
FAQ
Qual é o ID do modelo da API do GPT-6.2 Astra? gpt-6.2-astra. O irmão mais barato é o gpt-6.2-sol. Ambos funcionam nos endpoints Responses, Chat Completions e Batch.
Quanto custa a API do GPT-6.2 Astra? $8 por milhão de tokens de entrada, $0.40 por milhão de tokens de entrada em cache e $40 por milhão de tokens de saída. Requisições acima de 272 mil tokens de entrada pagam o dobro na entrada e 1,5x na saída para toda a requisição.
Por que minha requisição ao GPT-6.2 Astra falha com esforço de raciocínio none? Ambos os modelos GPT-6.2 rejeitam "effort": "none". Defina high, ou o menor nível que seus testes mostrarem que funciona para sua tarefa.
Qual é a janela de contexto do GPT-6.2 Astra? 1.050.000 tokens no total, com até 922.000 tokens de entrada e 128.000 tokens de saída.
Posso usar o GPT-6.2 Astra com a API Chat Completions? Sim. Ela é suportada, mas ferramentas hospedadas como busca na web, uso de computador e apply patch são listadas para a API Responses, então use Responses para trabalhos com agentes.
O GPT-6.2 Astra está disponível gratuitamente? Não na API; toda chamada é cobrada. No ChatGPT Work e no Codex, ele está incluído nos planos Plus, Pro, Enterprise e Edu, segundo o anúncio de lançamento da OpenAI.