
Z.ai agora vende dois modelos com nomes quase idênticos, a mesma janela de contexto de 1M de tokens e uma diferença de preço nove vezes maior entre eles. A nomenclatura não ajuda na escolha. "Flash" implica uma variante menor, mais rápida e mais fraca, e apenas uma dessas três palavras é precisa.
Aqui está a versão resumida: GLM-5.3-Flash é mais barato, lida com imagens nativamente e oferece aos usuários do plano de codificação o triplo da cota. GLM-5.3 é um pouco mais inteligente e gera quase duas vezes mais rápido. Para a maioria das cargas de trabalho, o Flash é o padrão correto e o ônus da prova recai sobre a escolha do mais caro.
Esta publicação explora onde essa regra se quebra.
A tabela de comparação
| GLM-5.3-Flash | GLM-5.3 | |
|---|---|---|
| Índice de Inteligência (Análise Artificial) | 57 | 60 |
| Preço combinado por 1M de tokens | $0.10 | $0.90 |
| Entrada / saída de lista por 1M | $0.15 / $0.50 | $1.40 / $4.40 |
| Velocidade de saída | ~49 tokens/seg | ~86 tokens/seg |
| Tempo até o primeiro token | 1.52s | 1.57s |
| Janela de contexto | 1.048.576 | 1.048.576 |
| Entrada nativa de imagem | Sim | Não, baseado em adaptador |
| Parâmetros | 320B total / 18B ativos | Maiores, não totalmente divulgados |
| Licença | MIT, pesos abertos | Pesos abertos |
| Cota do Plano de Codificação | 3x | 1x |
Os números de velocidade e inteligência são medições da Análise Artificial. Os preços são os de tabela da Z.ai, antes do desconto de lançamento discutido abaixo.
De onde vem a diferença de preço de nove vezes
GLM-5.3-Flash é um modelo de mistura de especialistas de 320B que ativa 18B de parâmetros por token, construído sobre uma nova base com atenção híbrida linear e esparsa. A Z.ai relata aproximadamente três vezes menos computação de atenção do que o GLM-5.3 e um cache KV cerca de 4,4 vezes menor.
O tamanho do cache KV é o que torna o serviço de contexto longo caro. Reduzi-lo em 4,4x é a principal razão pela qual a Z.ai pode oferecer uma janela de 1M de tokens a um décimo do preço. Você não está pagando menos por um contexto mais curto ou um modelo mais fraco. Você está pagando menos porque o footprint de serviço por solicitação é genuinamente menor.
Esse é um resultado de engenharia real, e não um desconto promocional, o que importa para a sustentabilidade do preço.
O que significa a diferença de três pontos de inteligência
57 versus 60 no Índice de Inteligência da Análise Artificial é uma lacuna estreita em termos absolutos. Para calibração, o modelo de pesos abertos mediano de tamanho comparável pontua 27, então ambos estão muito acima da média.
Três pontos não são nada, no entanto. Lacunas de índice desse tamanho geralmente se manifestam como: desempenho ligeiramente pior em cadeias de raciocínio de várias etapas, um pouco mais de desvio em tarefas de agente muito longas e maior sensibilidade a instruções ambíguas. Raramente aparecem em extração direta, classificação, sumarização ou edições de código de arquivo único.
O teste prático é se sua tarefa tem uma resposta verificável. Se você pode verificar a saída programaticamente, o erro ocasional do Flash é barato de detectar e de tentar novamente, e a um nono do preço você pode tentar novamente muitas vezes. Se sua tarefa produz um texto que um humano precisa ler e julgar, a diferença de qualidade é mais difícil de recuperar e a lacuna de preço importa menos do que o resultado.
A velocidade é o único ponto onde o Flash realmente perde
Esta é a parte em que o nome se inverte. GLM-5.3 gera a aproximadamente 86 tokens por segundo. GLM-5.3-Flash gerencia cerca de 49. O modelo maior e mais caro é quase duas vezes mais rápido na produção de saída.
O tempo até o primeiro token está praticamente empatado, em 1,52 contra 1,57 segundos, então ambos parecem igualmente responsivos no início de uma resposta.
A consequência depende inteiramente do comprimento da saída:
- Respostas curtas. Irrelevante. Ambos começam em cerca de 1,5 segundos e terminam antes que alguém note a diferença de throughput.
- Gerações longas. Uma resposta de 4.000 tokens leva cerca de 82 segundos no Flash e cerca de 47 no GLM-5.3. Em uma ferramenta interativa, essa é uma lacuna significativa.
- Trabalhos em lote com concorrência. Também em grande parte irrelevante, porque você escala com solicitações paralelas em vez de velocidade por stream, e a diferença de preço compra muito paralelismo.
Se você está transmitindo uma saída longa para alguém que está esperando, o GLM-5.3 oferece uma experiência melhor. Esse é o caso mais claro para pagar nove vezes mais.
A multimodalidade é a verdadeira linha divisória
GLM-5.3-Flash aceita imagens, vídeos e arquivos como blocos de conteúdo na mesma solicitação de conclusão de chat que o seu texto. O GLM-5.3 não faz isso nativamente; a visão passa por adaptadores separados.
Se sua aplicação precisa que um modelo "olhe" para algo, isso não é uma comparação, é um requisito. O Flash é o único dos dois que faz isso em uma única chamada, em uma única janela de contexto, em uma única linha de cobrança.
Essa capacidade combina-se com o contexto de 1M de uma forma genuinamente nova para esta família de modelos: um longo documento de especificação e uma captura de tela do resultado construído podem ocupar o mesmo prompt. O próprio posicionamento da Z.ai fala sobre observar interfaces e renderizar resultados, o que é um enquadramento de agente de codificação em vez de um de descrição de imagem.
Nosso guia de visão aborda o payload e os fluxos de trabalho. Os modelos de visão dedicados mais antigos são abordados no guia da API do GLM-5V-Turbo se você estiver mantendo algo construído nessa trajetória.
O ângulo do plano de codificação
Para os assinantes do Plano de Codificação GLM, o cálculo é diferente e mais simples. O Flash está incluído no plano e, segundo relatos, oferece o triplo da cota utilizável do GLM-5.3. A Z.ai também observa que as chamadas fora do horário de pico consomem metade dos pontos padrão.
Se você está executando Claude Code ou Cline em relação à sua cota do plano, o triplo das solicitações por uma queda de três pontos no índice é uma troca fácil para o trabalho de rotina. Mantenha o GLM-5.3 para os problemas difíceis e deixe o Flash absorver o volume. A configuração para ambos os frameworks está em nosso guia de Claude Code e Cline.
Verifique o multiplicador de cota em z.ai antes de planejar com base nele, já que os termos do plano mudam com mais frequência do que as especificações do modelo.
O prazo da precificação
Um desconto de lançamento de 50% no GLM-5.3-Flash vai até 9 de setembro de 2026. Até lá, as taxas efetivas são de $0.075 de entrada e $0.25 de saída por milhão, o que amplia a diferença em relação ao GLM-5.3 para aproximadamente dezoito vezes.
Após o término, os preços de tabela de $0.15 e $0.50 serão aplicados, e a diferença volta a ser de aproximadamente nove vezes. De qualquer forma, o Flash é dramaticamente mais barato. O prazo é importante para fixar as projeções de custo, não para a escolha entre os dois modelos. Nossa análise de preços contém os números detalhados.
Uma regra de decisão
Use GLM-5.3-Flash quando:
- Suas entradas incluem imagens, vídeos ou arquivos.
- O custo por token é a restrição que você está otimizando.
- Você executa extração, classificação ou roteamento de alto volume.
- Você está no Plano de Codificação e quer que sua cota renda mais.
- Você deseja pesos abertos licenciados pelo MIT que pode hospedar por conta própria. Executá-lo localmente abrange o hardware.
Use GLM-5.3 quando:
- Você transmite respostas longas para um humano esperando e o throughput é a experiência percebida.
- Seu trabalho é um raciocínio de longo prazo onde três pontos de índice se acumulam ao longo das etapas.
- A qualidade da saída é julgada por uma pessoa, e não verificada por um teste.
Use ambos quando: você puder rotear. Envie a maior parte do tráfego para o Flash e escale para o GLM-5.3 em caso de falha, baixa confiança ou tipo de tarefa. A diferença de preço de nove vezes torna um roteador digno de construção, e como ambos os modelos estão por trás do mesmo endpoint compatível com OpenAI, o roteamento é uma troca de ID de modelo em vez de uma integração.
Migrando entre eles
Se você já usa o GLM-5.3 e está avaliando uma mudança, a parte mecânica é trivial e a parte de validação é onde o trabalho se encontra.
O que não muda. A URL base, o esquema de autenticação, os formatos de solicitação e resposta, a semântica de streaming e os esquemas de chamada de ferramentas. Ambos os modelos estão por trás da mesma interface compatível com OpenAI. A troca é uma string de ID de modelo.
O que muda. O custo por chamada cai aproximadamente nove vezes. A geração desacelera em cerca de metade. A qualidade do raciocínio se desloca em três pontos de índice. E você ganha entrada de imagem que não estava disponível antes.
O que verificar antes de se comprometer. Execute seus prompts reais através de ambos e compare em quatro eixos: correção da saída em casos que você pode verificar, latência de ponta a ponta incluindo o tempo de geração em vez de apenas o primeiro token, contagens de tokens do objeto usage em cada resposta e comportamento em seu contexto realista mais longo.
O quarto item detecta a maioria dos problemas. Modelos que parecem equivalentes em prompts curtos podem divergir notavelmente quando o contexto está cheio, e uma tabela de benchmark nunca lhe dirá isso sobre seus próprios dados.
Se você começou no modelo base, o que é o GLM-5.3 o cobre em seus próprios termos, e o guia da API do GLM-5.3 tem a configuração da qual você está migrando.
Teste, em vez de confiar na tabela
Cada número acima é uma afirmação do fornecedor ou um benchmark de terceiros executado na carga de trabalho de outra pessoa. Nenhum deles diz como esses dois modelos se comportam em seus prompts.
A troca é uma string. Aponte um cliente compatível com OpenAI para https://api.z.ai/api/paas/v4/, execute seus prompts reais através de glm-5.3-flash e glm-5.3, e compare as saídas, latência e contagens de tokens no tráfego que você se importa. O guia da API tem a configuração.
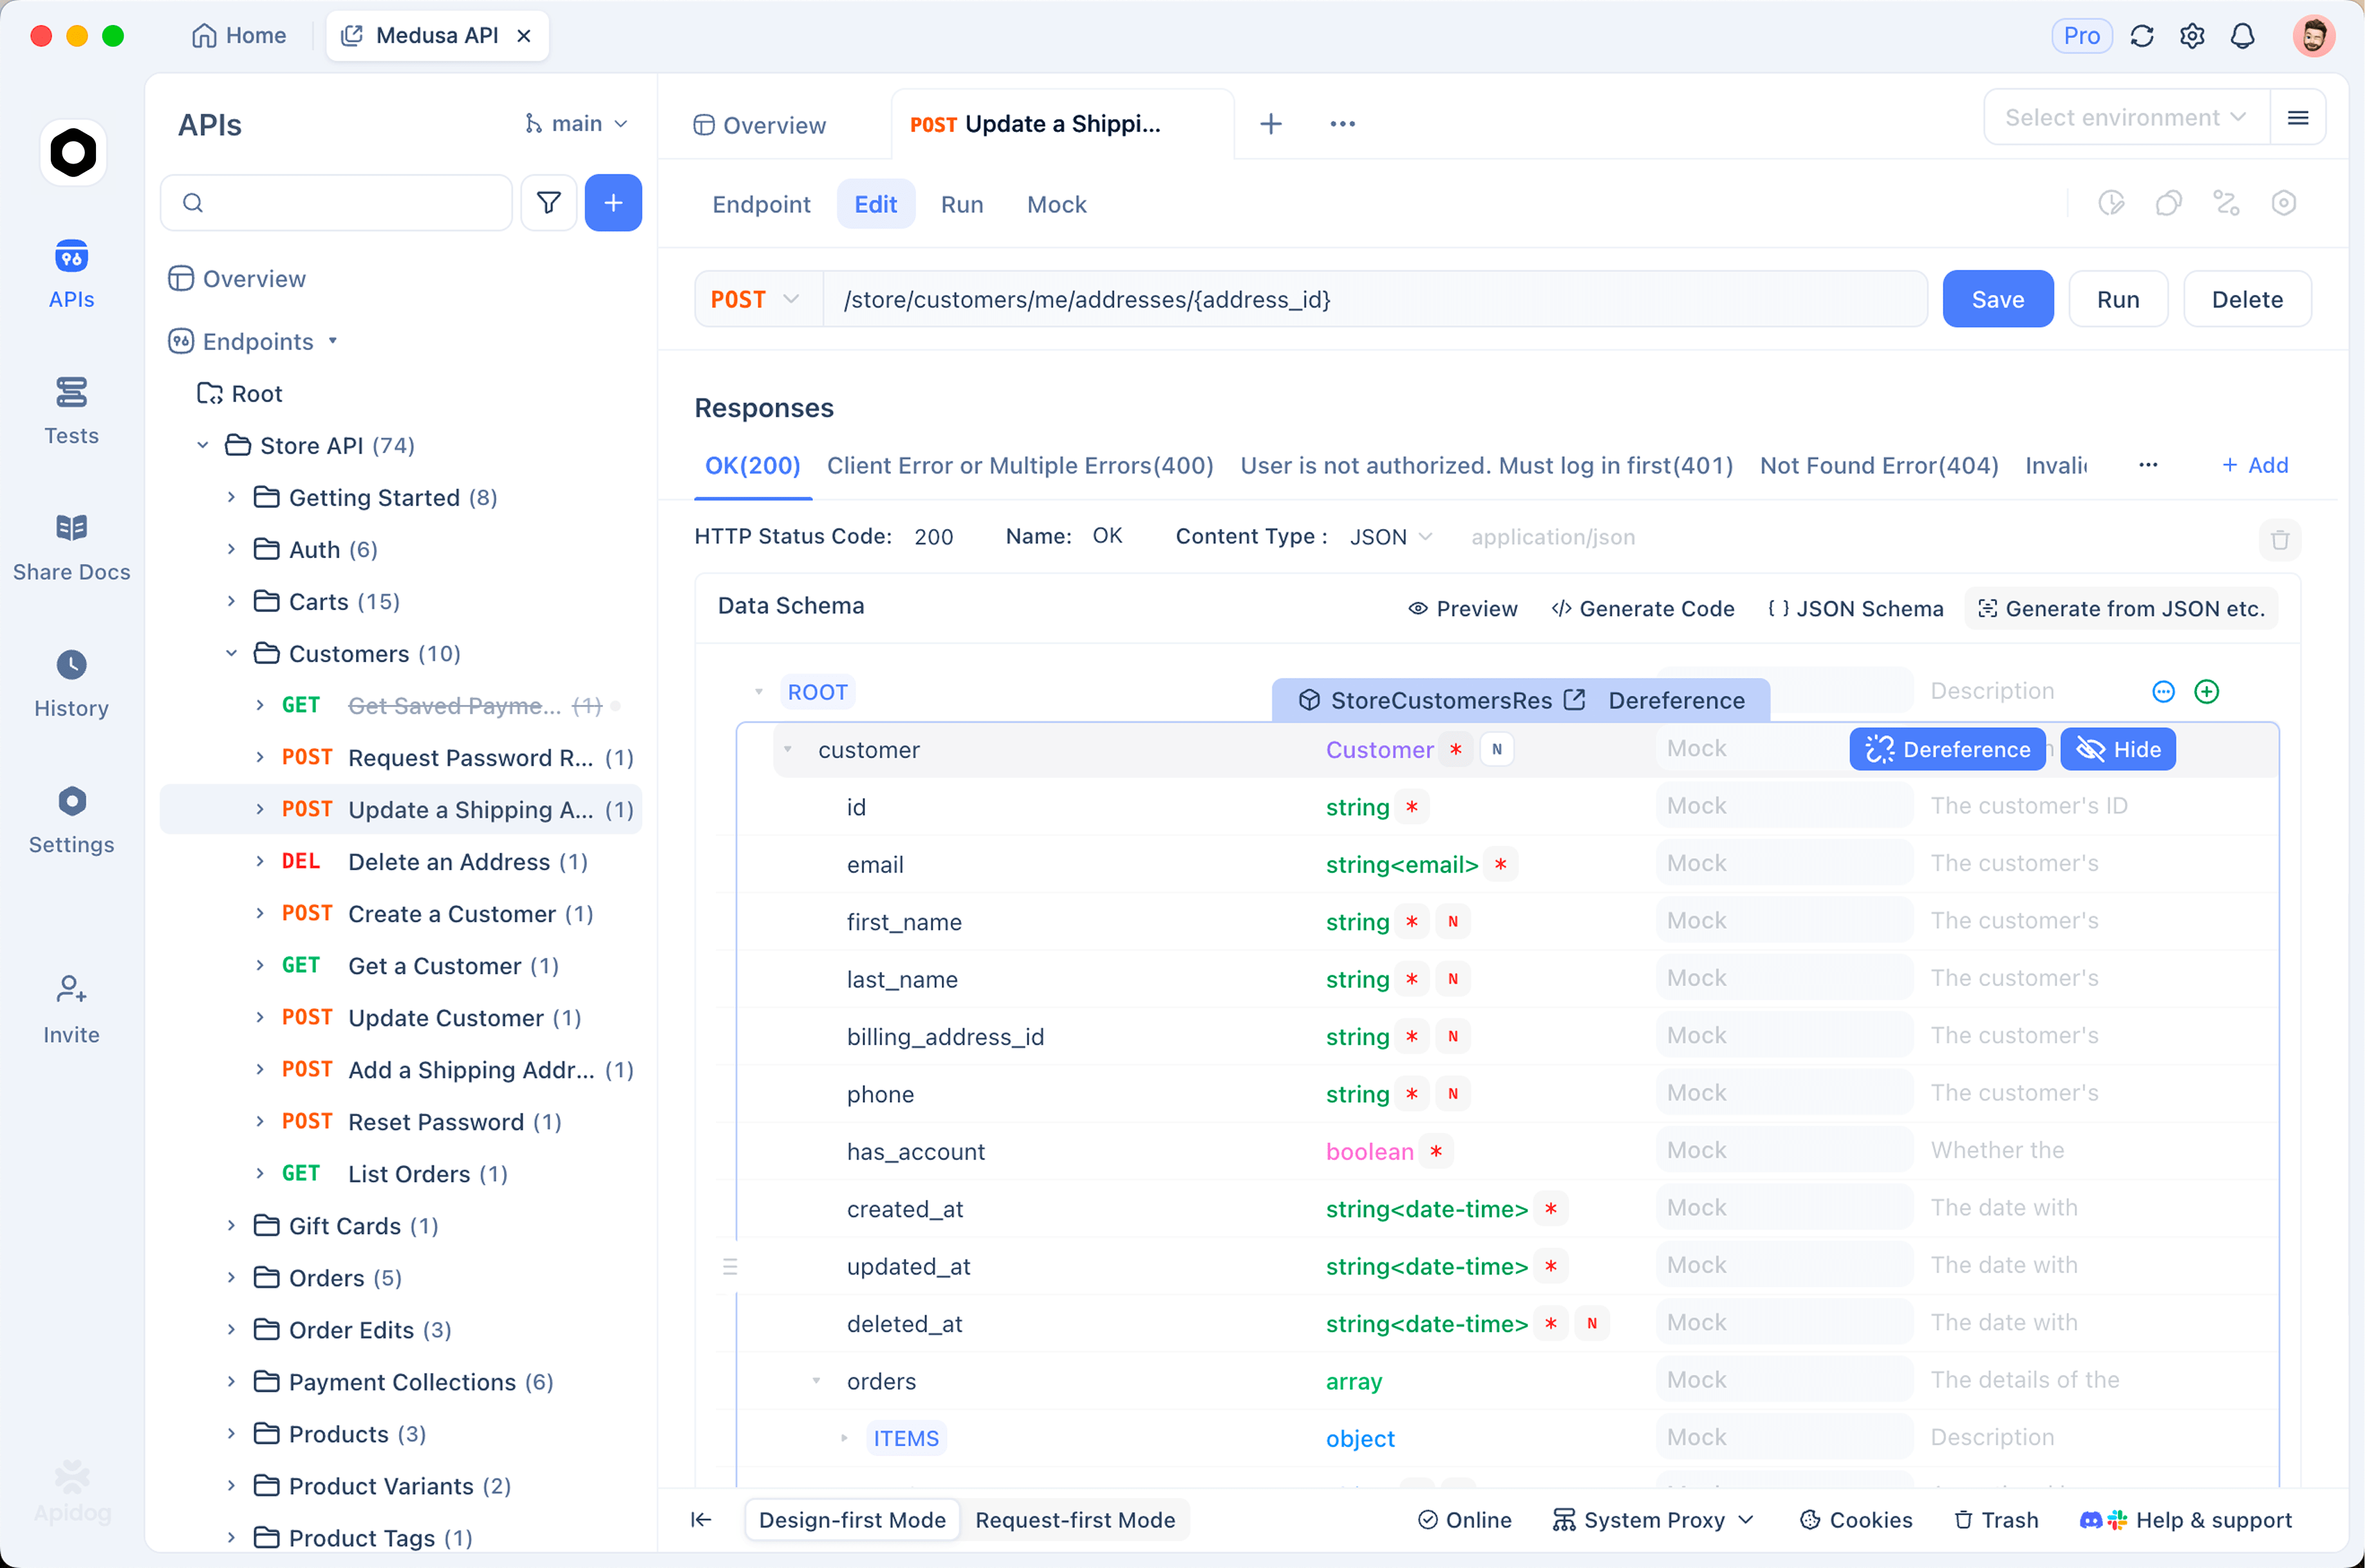
É aqui que salvar a comparação como um conjunto repetível vale a pena. No Apidog, você pode manter ambas as chamadas em uma coleção com o ID do modelo como uma variável de ambiente, anexar asserções aos campos que sua aplicação lê e reexecutar tudo quando o desconto expirar ou a Z.ai lançar a próxima revisão. Uma escolha de modelo que você pode retestar em trinta segundos é uma decisão que você pode revisitar; uma que vive em um histórico de shell não é.
FAQ
O GLM-5.3-Flash é apenas um GLM-5.3 menor? Não. É um modelo base treinado separadamente com uma arquitetura de atenção diferente, não uma destilação ou uma variante podada.
Eles têm a mesma janela de contexto? Sim, 1.048.576 tokens para ambos.
Qual é melhor para codificação? O Flash pontua 84.3 no Terminal-Bench 2.1 e 63.4 no DeepSWE, de acordo com a Z.ai, o que é forte. O GLM-5.3 é um pouco mais forte no raciocínio geral. Para usuários do plano de codificação, a cota 3x geralmente decide.
Posso alternar entre eles sem alterações no código? Sim. O mesmo endpoint compatível com OpenAI, ID de modelo diferente. Apenas a entrada de imagem é exclusiva do Flash.
O mais barato continuará barato? O preço reflete um cache KV menor e menor computação de atenção, em vez de uma promoção, então a vantagem estrutural deve persistir. O desconto adicional de lançamento de 50% expira em 9 de setembro de 2026.