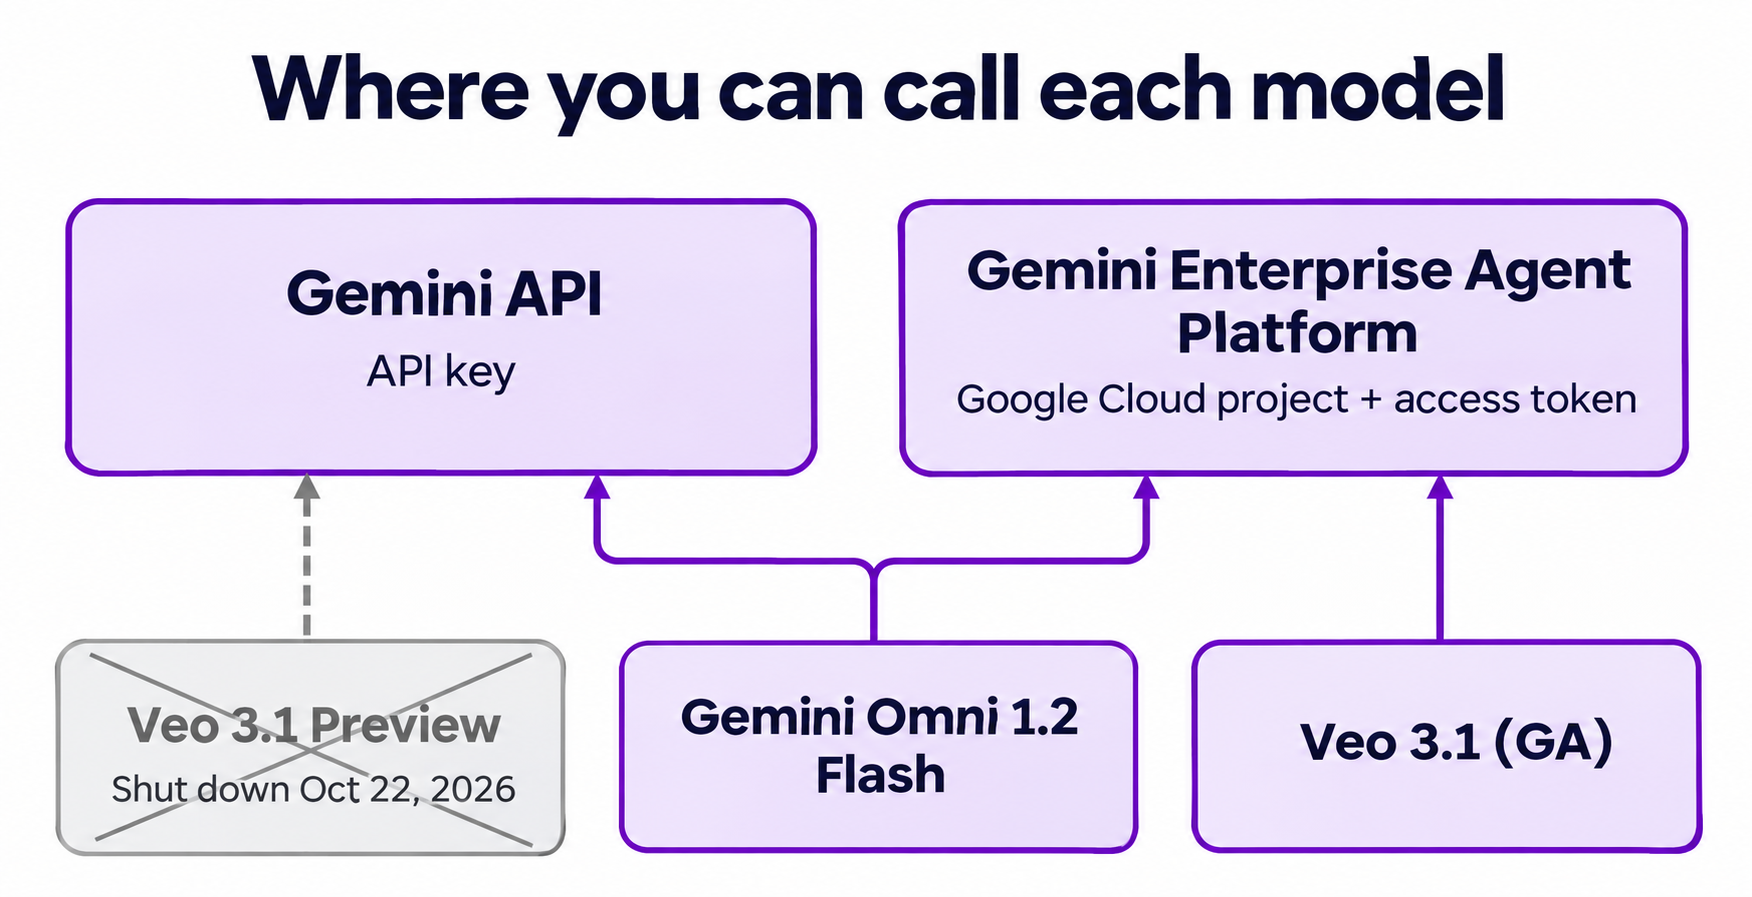
Resposta rápida: use o Gemini Omni 1.2 Flash como base se quiser uma única chave de API, edição conversacional ou clipes de até 15 segundos. Escolha o Veo 3.1 apenas se você já roda no Google Cloud e precisa dos controles de requisição dele, como até quatro saídas por chamada. Não é mais possível chamar o Veo pela API Gemini: seus modelos Preview foram desativados em 22 de outubro de 2026.
Essa desativação transforma uma comparação de modelos em uma decisão de plataforma. Nossa comparação entre Omni 1.1 e Veo 3.1 cobre as especificações antigas. Este guia responde a uma pergunta mais específica: em qual deles você desenvolve agora?
O Google não publicou benchmarks para o Omni 1.2, então nada aqui compara os dois pela qualidade visual. As especificações e os preços abaixo vêm da documentação do Google, consultada em 6 de novembro de 2026.
Gemini Omni 1.2 Flash vs Veo 3.1 em resumo
| Gemini Omni 1.2 Flash | Veo 3.1 | |
|---|---|---|
| Status | Disponibilidade geral | generate-001 e fast-generate-001 em GA, lite-generate-001 em Preview |
| Onde você chama | API Gemini, Gemini Enterprise Agent Platform | Apenas no Agent Platform |
| Autenticação | Chave de API (API Gemini) | Projeto do Google Cloud e token de acesso |
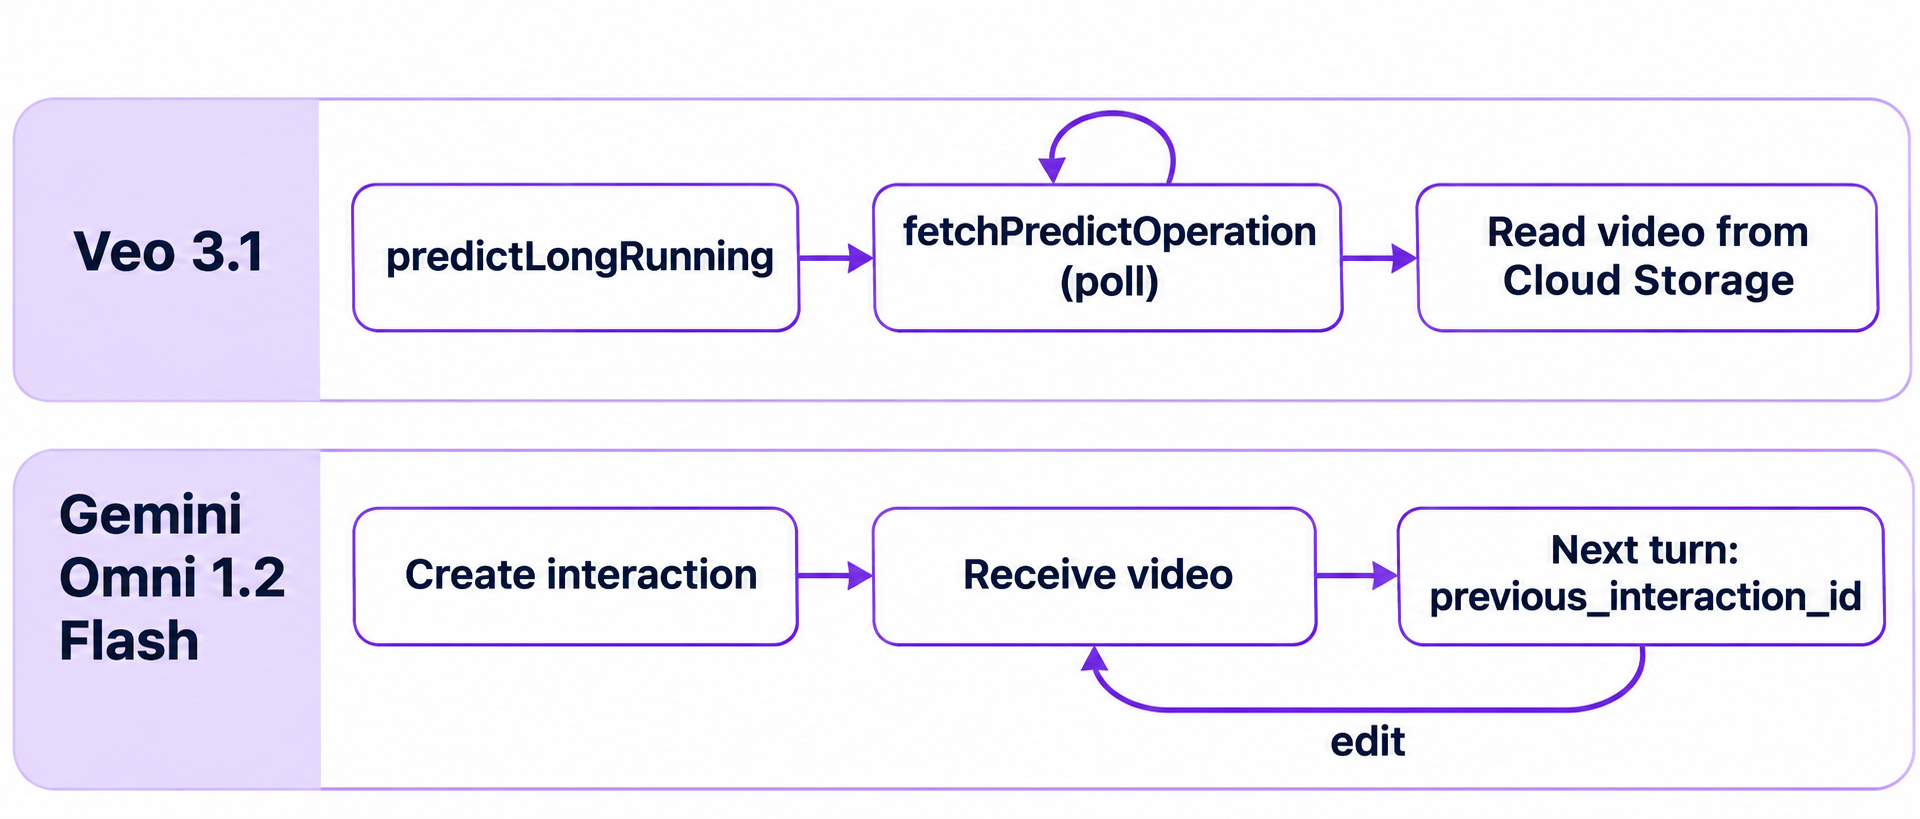
| Formato da requisição | Interactions API | predictLongRunning, com polling via fetchPredictOperation |
| Localização | global no Agent Platform |
us-central1 |
| Duração do clipe | 3 a 15 segundos, em incrementos de um segundo | 4, 6 ou 8 segundos |
| Áudio | Nativo | Geração de som compatível |
| Resoluções | 360p, 720p, 1080p e 4K (com upscale) | 720p, 1080p, além de 4K no Veo 3.1 |
| Extensão | 3 a 10 segundos por turno | 7 segundos por chamada, 37 segundos no total |
| Edição em vários turnos | Sim, com previous_interaction_id |
Sem equivalente na documentação que consultamos |
| Saídas por requisição | Um vídeo por turno nos exemplos | sampleCount de 1 a 4 |
| Prompt negativo | Sem suporte; escreva no próprio prompt | Parâmetro negativePrompt |
| Descontinuação mais próxima | Nenhuma listada | 4 de maio de 2027 ou depois (modelos GA) |
Um conflito para considerar no planejamento: a duração máxima estendida do Omni depende da plataforma. A documentação da API Gemini indica 30 segundos no total. A documentação de extensão do Agent Platform indica até 40. Se o seu produto promete uma duração, teste na plataforma em que vai entrar em produção.
O que mudou para o Veo
A documentação de vídeo da API Gemini agora informa que o Veo 3.1 Preview na API Gemini foi desativado. Três IDs de modelo saíram junto, em 22 de outubro de 2026:
veo-3.1-generate-previewveo-3.1-fast-generate-previewveo-3.1-lite-generate-preview
O Google aponta duas saídas: o Gemini Omni Flash ou os modelos GA do Veo no Gemini Enterprise Agent Platform (o sucessor do Vertex AI). Não encontramos nenhum Veo mais recente que o 3.1 na página atual de modelos do Veo do Google.
Ou seja, uma integração construída com uma chave do AI Studio e um ID de preview do Veo já parou de funcionar. Trocar a string do modelo não resolve, porque os modelos GA ficam em uma plataforma diferente, com autenticação diferente. Guias mais antigos, incluindo o nosso passo a passo da API do Veo 3.1, foram escritos para o caminho do preview.
Quanto cada API custa por segundo
O Omni cobra por tokens de saída. O Veo usa uma tarifa fixa por resolução. Esses valores são para vídeo com áudio:
| Saída | Omni 1.2 Flash | Veo 3.1 (GA) | Veo 3.1 Fast (GA) | Veo 3.1 Lite (Preview) |
|---|---|---|---|---|
| 360p | US$ 0,023 | n/a | n/a | n/a |
| 720p | cerca de US$ 0,07 | US$ 0,40 | US$ 0,10 | US$ 0,05 |
| 1080p | US$ 0,104 | US$ 0,40 | US$ 0,12 | US$ 0,08 |
| 4K | US$ 0,209 | US$ 0,60 | US$ 0,30 | n/a |
Os números do Omni vêm da página de preços do Gemini do Google, que também lista entrada a US$ 1,50 por milhão de tokens. As tarifas de 1080p e 4K já incluem upsampling. Os números do Veo vêm da lista de preços do Agent Platform. Essa lista os exibe por “count” e não define a unidade. Eles correspondem às tarifas por segundo divulgadas no lançamento, então os interpretamos como por segundo. Confirme na sua primeira fatura. A lista também precifica 4K para o Fast, embora a página do modelo mostre saída 4K apenas para o Veo 3.1.
Um clipe de 720p com 8 segundos custa cerca de US$ 0,56 no Omni, US$ 3,20 no Veo 3.1, US$ 0,80 no Fast e US$ 0,40 no Lite. O Lite é o único modelo do Veo, entre os com áudio, mais barato que o Omni, e ainda está em Preview. O Veo também lista tarifas só de vídeo, como US$ 0,08 para o Fast em 720p. Para a matemática dos tokens, veja nosso detalhamento de preços do Omni 1.1 e substitua pela nova tarifa de US$ 12,00 por milhão de tokens de saída de vídeo.
O Google lista o nível gratuito do Omni como “Not available” (indisponível) tanto no 1.2 quanto no 1.1.
Escolha o Gemini Omni 1.2 Flash se
- Você não quer um projeto do Cloud no caminho. Uma chave de API e um POST geram um vídeo.
- Os usuários refinam os clipes. Passe
previous_interaction_idcom um novo prompt e cada turno produz um novo vídeo. O Google sugere adicionar “Keep everything else the same” (mantenha todo o resto igual) quando você muda um elemento. - Você precisa de clipes com mais de 8 segundos em uma única chamada. O Omni vai até 15. O Veo para em 8.
- Você quer rascunhos baratos. Um teste em 360p de 10 segundos custa cerca de US$ 0,23.
- Você depende de imagens de referência. O Omni aceita até 6, com até 3 por personagem, para até 2 personagens.
Conheça as limitações primeiro. O Google cita ação esportiva rápida, mudanças rápidas de roteiro e física complexa como áreas que ainda estão sendo melhoradas. Uploads de áudio não têm suporte. Editar ou estender vídeos enviados não está disponível no EEE (Espaço Econômico Europeu), na Suíça ou no Reino Unido. Toda saída vem com uma marca d'água SynthID imperceptível.
Escolha o Veo 3.1 se
- Você já roda no Google Cloud. Projetos, IAM e Cloud Storage já estão no lugar, então a configuração extra não custa nada.
- Você quer várias tomadas por requisição. O
sampleCountretorna até 4 vídeos em uma única chamada. - Você depende do
negativePrompt. O Omni não tem um campo equivalente. - Você precisa de um compromisso de modelo com data definida. O Google lista a descontinuação dos modelos GA para 4 de maio de 2027 ou depois, o que dá uma data para planejar. O aviso curto do Omni 1.1 é o contraexemplo: a partir de 3 de dezembro de 2026, requisições para
gemini-omni-1.1-flashsão direcionadas ao 1.2 e cobradas nas tarifas do 1.2. - Você estende vídeos enviados no EEE, na Suíça ou no Reino Unido. A documentação de extensão do Veo não lista tal limitação. Confirme para a sua região antes de construir com base nisso.
O contraponto: apenas us-central1, um projeto do Google Cloud e um loop de polling. A entrada para extensão precisa ser MP4 a 24 fps, com duração de 1 a 30 segundos. A página de extensão também lista o Lite na tabela de modelos, mas o deixa de fora da seção REST, então trate a extensão do Lite como não confirmada.
Migrando uma integração do Veo para a Interactions API
Migrar para o Omni muda sua requisição, seu polling e o parsing da resposta. Aqui está uma chamada de extensão do Veo, seguindo a documentação do Google:
POST https://us-central1-aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/us-central1/publishers/google/models/veo-3.1-generate-001:predictLongRunning

{
  "instances": [{
    "prompt": "The drone keeps climbing above the harbor",
    "video": { "gcsUri": "gs://my-bucket/clip.mp4", "mimeType": "video/mp4" }
  }],
  "parameters": { "storageUri": "gs://my-bucket/out/", "sampleCount": 1 }
}
E o mesmo trabalho no Omni, por meio do Agent Platform:
POST https://aiplatform.googleapis.com/v1beta1/projects/PROJECT_ID/locations/global/interactions

{
  "model": "gemini-omni-1.2-flash",
  "store": false,
  "input": [
    { "type": "text", "text": "The drone keeps climbing above the harbor" },
    { "type": "video", "uri": "gs://my-bucket/clip.mp4", "mime_type": "video/mp4" }
  ],
  "response_format": [{
    "type": "video",
    "delivery": "uri",
    "gcs_uri": "gs://my-bucket/out/",
    "aspect_ratio": "16:9",
    "duration": "7s"
  }],
  "generation_config": { "video_config": { "task": "extend" } }
}
Mapeie seus campos assim:
| Veo | Omni |
|---|---|
instances[0].prompt |
item de texto em input |
instances[0].video.gcsUri |
uri do item de vídeo em input |
parameters.storageUri |
gcs_uri em response_format |
parameters.aspectRatio |
aspect_ratio em response_format |
parameters.seed |
generation_config.seed |
parameters.negativePrompt |
Uma linha “não faça X” no prompt |
parameters.sampleCount |
Sem campo na documentação que consultamos; envie requisições separadas |
fetchPredictOperation |
background: true e depois um GET do ID da interação |
videos[].gcsUri |
entrada em steps do tipo model_output, item de vídeo |
Quatro detalhes para ficar de olho:
- Formato da resposta. O exemplo do Agent Platform envolve o
response_formatem um array. A documentação da API Gemini descreve um objeto único. Copie o formato da plataforma que você chama. - Formato da duração. O Omni espera uma string como
"7s", de"3s"a"15s", e de"3s"a"10s"para extensões. - URIs perdidos. Na API Gemini,
GET /v1beta/interactions/{id}retorna base64 inline mesmo que você tenha pedido entrega por URI. O URI só vem garantido na resposta de criação ou no stream, então salve-o ali. - A edição precisa de armazenamento. Com
store: false, você não pode editar esse vídeo em um turno posterior.
Para uma primeira chamada à Interactions API, nosso guia da API do Omni 1.1 continua servindo, basta usar o novo ID de modelo.
Deixe seu agente de código testar os dois com a Apidog CLI
Se você pode trocar de provedor mais tarde, ou rodar os dois, vai querer um único conjunto de verificações que não liga para qual modelo respondeu. Passe essa tarefa para o seu agente de código. Ele define os dois endpoints com a Apidog CLI, envolve cada um em um cenário de teste e os agrupa em uma única suíte de testes com as mesmas asserções.
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Depois, dê um único prompt ao Claude Code, Codex ou Cursor:
In Apidog project <id>, create endpoints for Gemini Omni 1.2 Flash
(POST /v1beta/interactions) and Veo 3.1 Fast (predictLongRunning plus
fetchPredictOperation). Build one test scenario per provider and put both
in a test suite named video-provider-contract. Poll Veo until done. Assert
the same things on each: the job finishes, the output is video/mp4, and a
video URI or data field is present. Run it and summarize any failures.
O agente lê cada schema, valida o payload e depois monta e roda a suíte:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file omni.json
apidog endpoint create --project <id> --file omni.json
apidog test-scenario create --project <id> --name "omni-contract" --folder-id <folderId> --priority 1
apidog test-scenario import-steps <scenarioId> --project <id> --source endpoint --ids <endpointId> --sync manual
apidog test-suite create --project <id> --name "video-provider-contract"
apidog test-suite update <suiteId> --project <id> --file suite.json
apidog run --test-suite <suiteId> --project <id> -e <envId> \
  --timeout-request 300000 -r cli,junit --out-dir ./reports
Assim, uma troca de provedor aparece como uma asserção que falhou, e não como um player quebrado em produção. Mantenha as fixtures pequenas, porque cada execução cobra vídeo de verdade: um clipe Omni de 360p com 3 segundos mais um clipe Fast de 720p com 4 segundos somam cerca de US$ 0,47. Rode isso todas as noites, não a cada commit. A mesma linha entra em um pipeline, como mostra nosso guia de CI/CD com a Apidog CLI. O Apidog Free cobre até 4 usuários.
FAQ
Ainda posso chamar o Veo com uma chave da API Gemini? Não. Os modelos Veo 3.1 Preview na API Gemini foram desativados em 22 de outubro de 2026. Os modelos GA rodam no Gemini Enterprise Agent Platform, que usa um projeto do Google Cloud e um token de acesso.
Existe um Veo 4? Não que tenhamos encontrado. A página atual de modelos do Veo do Google lista apenas os modelos 3.1, conforme consulta feita em 6 de novembro de 2026.
O que acontece com meu código do Omni 1.1? A partir de 3 de dezembro de 2026, requisições para gemini-omni-1.1-flash são direcionadas ao gemini-omni-1.2-flash e cobradas nas tarifas do 1.2. Sua string de modelo continua funcionando, mas teste seus prompts no 1.2 antes dessa data, porque o modelo por trás dela muda.
Qual deles gera vídeo com melhor aparência? O Google não publica benchmarks sobre isso, então não vamos eleger um vencedor. Rode os mesmos prompts nos dois e julgue os clipes você mesmo.