
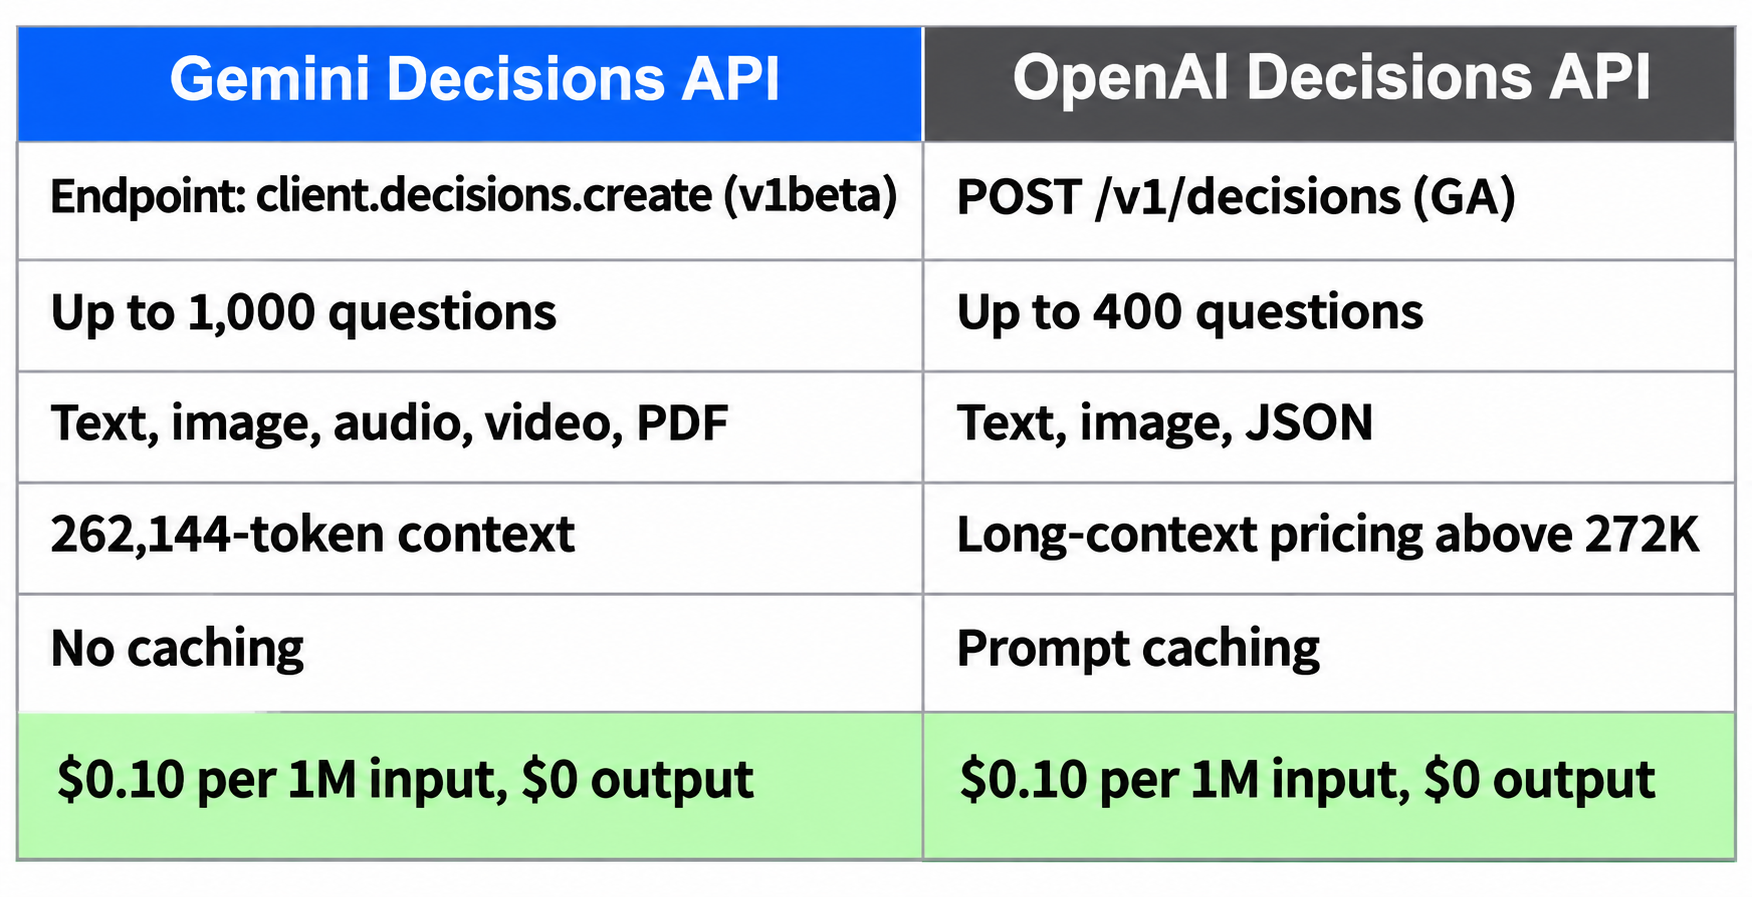
A comparação entre a Gemini Decisions API e a OpenAI Decisions API se resume a entradas e limites, não a preço. Ambas cobram US$ 0,10 por 1M de tokens de entrada e nada pela saída. Escolha a Gemini quando precisar de entrada de áudio, vídeo ou PDF, mais de 400 perguntas por requisição ou um nível gratuito. Escolha a OpenAI quando precisar de um endpoint em GA, cache de prompt, evidências em JSON e chamadas de ferramenta, ou termos de ZDR e HIPAA.
O que uma Decisions API faz
Uma Decisions API é um endpoint que responde a perguntas de conjunto fechado sobre a sua entrada em vez de gerar texto. Você envia evidências compartilhadas mais uma lista de perguntas tipadas (sim/não, escolher uma opção, avaliar em uma escala) e recebe probabilidades e uma pontuação de confiança para cada resposta. Os tokens de saída são zero, então você paga apenas pela entrada.
A OpenAI lançou a primeira. Sua Decisions API entrou em GA em 22 de outubro de 2026 com a gpt-6-luna. A Google respondeu em 11 de novembro de 2026 com a Gemini Decisions API, alimentada por um novo modelo, o gemini-decision-1.
Ambas visam roteamento, seleção de ferramentas, verificações de políticas e avaliação por rubricas. Elas se diferenciam no que você pode fornecer a elas e até onde uma única requisição chega.
Gemini Decisions API vs OpenAI Decisions API em resumo
Cada linha vem da documentação de cada fornecedor, consultada em 12 de novembro de 2026. “Não documentado” significa que a documentação não informa.
| Gemini Decisions API | OpenAI Decisions API | |
|---|---|---|
| Modelo | gemini-decision-1 (única opção) |
gpt-6-luna (única opção) |
| Status | v1beta na Gemini Developer API |
GA desde 22 de outubro de 2026 |
| Chamada | client.decisions.create(...), SDK 3.2+ |
POST /v1/decisions |
| Perguntas por requisição | 1 a 1.000 | 1 a 400 |
| Formato das perguntas | Mapa indexado pelos seus próprios IDs | Array, cada uma com um name opcional |
| Tipo sim/não | noul (0,01 a 0,99) |
predicate (0 a 1) |
| Opções de escolha | 2 a 255 | 2 a 255 |
| Níveis de pontuação | 2 a 255 (2 a 10 recomendado) | 2 a 10 |
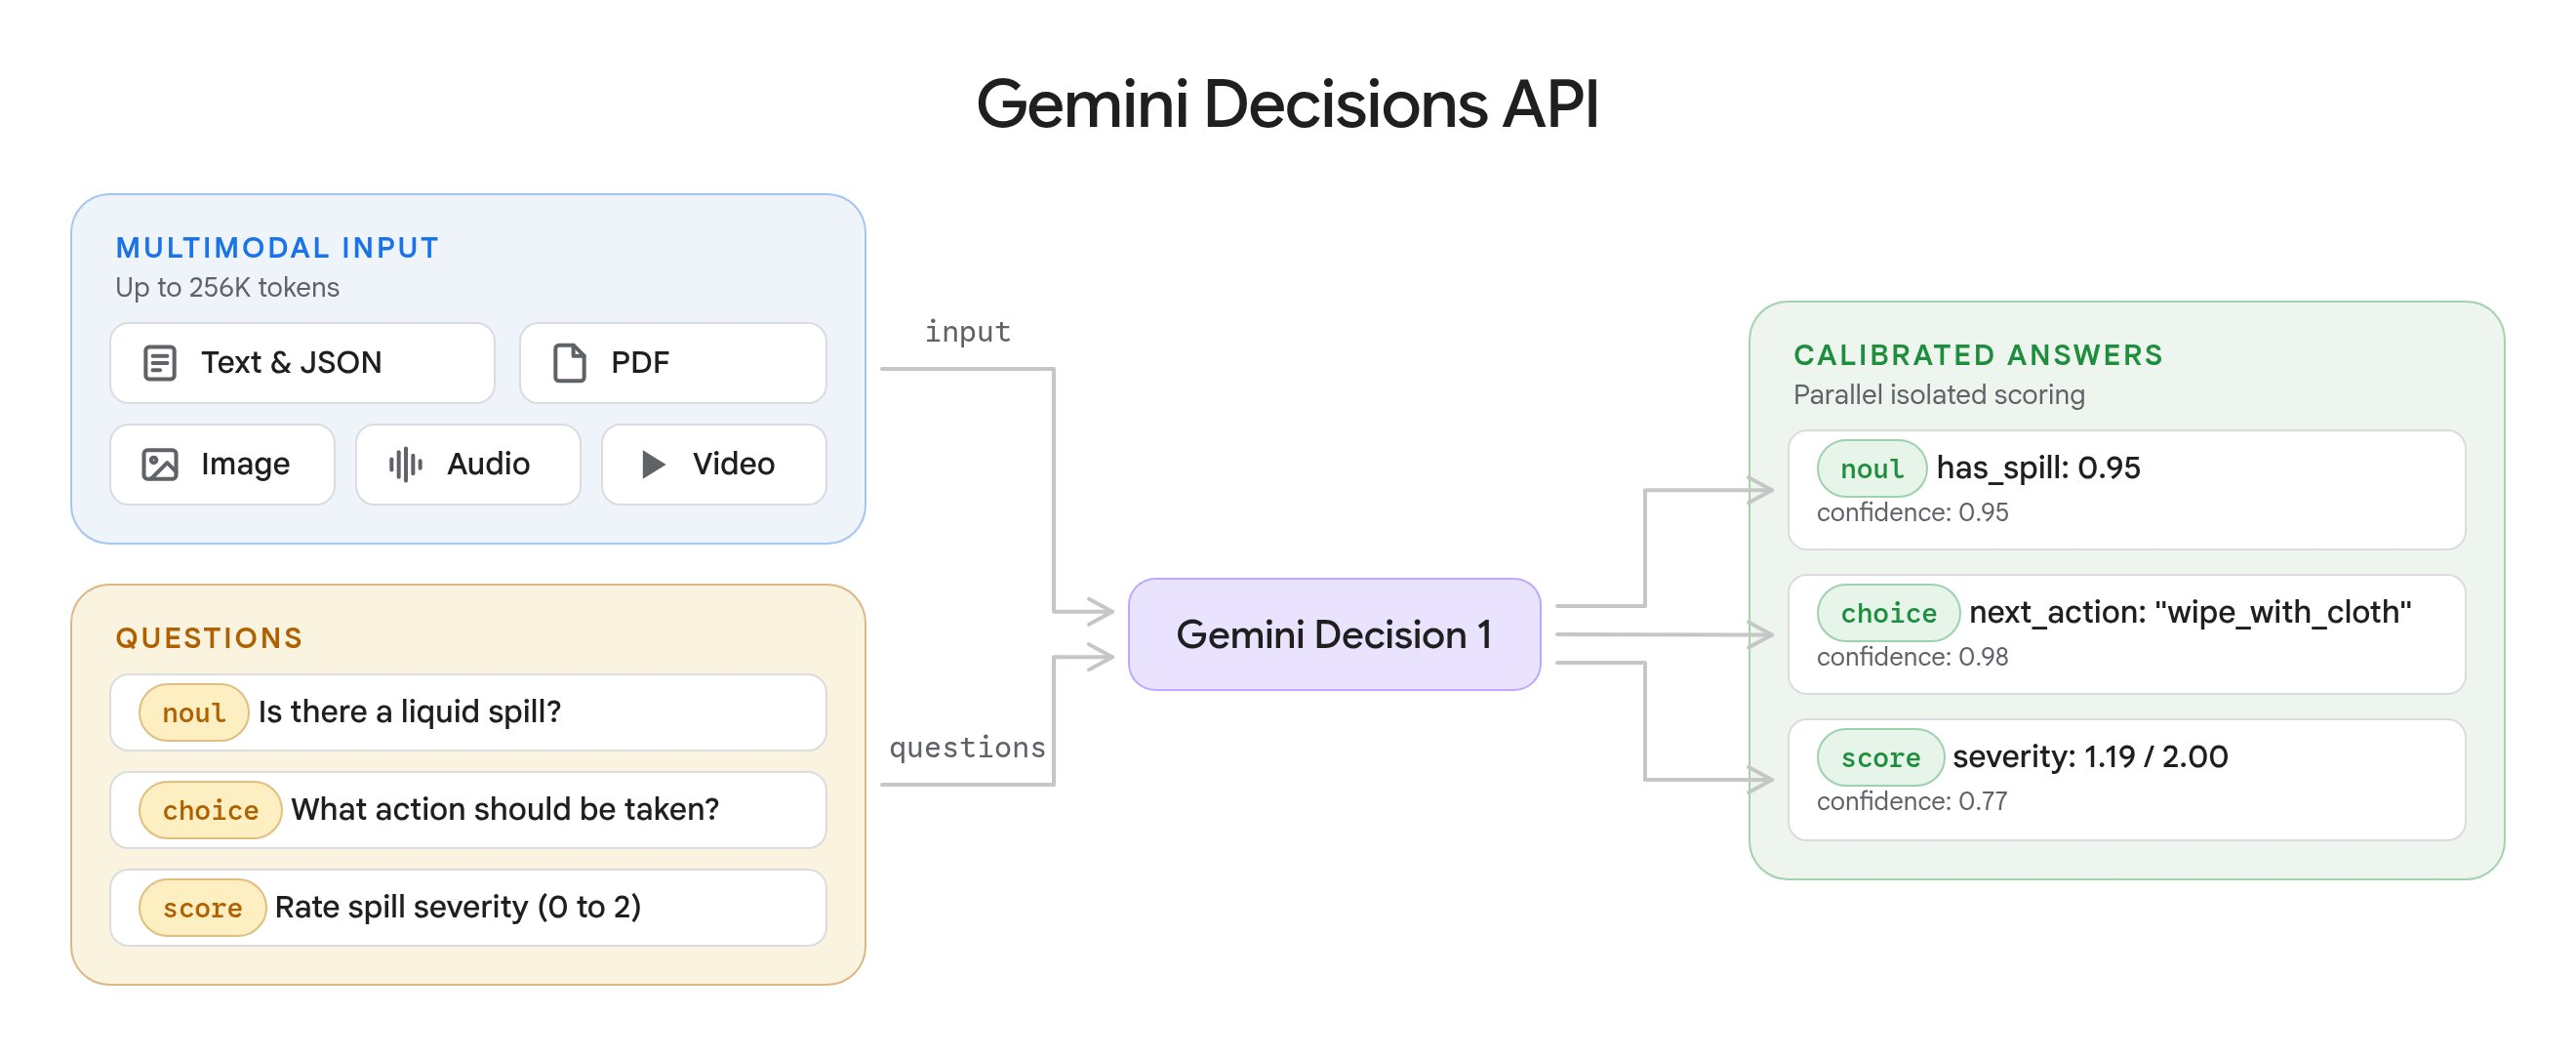
| Tipos de entrada | Texto, imagem, áudio, vídeo, PDF | Texto, imagem, input_json, chamadas de ferramenta e saídas |
| Mídia no texto da pergunta | Não, apenas texto | Sim, imagens em instructions |
| Janela de contexto | 262.144 tokens | Não documentado para o endpoint; preço de contexto longo acima de 272K |
| Preço da entrada | US$ 0,10 / 1M | US$ 0,10 / 1M (2x acima de 272K) |
| Preço da saída | US$ 0 | US$ 0 |
| Cache | Não suportado | Cache de prompt, US$ 0,01 / 1M de entrada em cache |
| Batch / Flex | Não suportado | Não documentado |
| Nível gratuito | Sim, no Google AI Studio | Não documentado para este endpoint |
| Latência publicada | 150 a 250 ms de ponta a ponta (número da Google) | “Cerca de 10x mais rápida que a Responses API” |
| Limites de taxa | Publicados por nível | Por organização, não publicados por endpoint |
| ZDR / HIPAA | Não documentado | Suportado para clientes elegíveis |
| Processamento regional | Não documentado | EUA e UE, acréscimo de 10% |
Formato da requisição: mesma ideia, JSON diferente
As duas APIs parecem semelhantes até você escrever o payload. A Gemini indexa as perguntas pelo seu próprio ID e chama seu tipo sim/não de noul:
result = client.decisions.create(
    model="gemini-decision-1",
    input="I was charged twice for my order.",
    questions={
        "department": {
            "type": "choice",
            "instructions": "Which department should handle this request?",
            "criteria": {"billing": "Payments and refunds.", "other": ""},
        },
    },
)
A OpenAI recebe um array ordenado, usa predicate para sim/não e lista as escolhas como objetos value e description. Nosso guia passo a passo da OpenAI tem a requisição completa.
Três diferenças importam em código de produção:
- Consulta às respostas. A Gemini retorna um mapa indexado pelos IDs das suas perguntas. A OpenAI retorna um array que você associa pelo
name. - Recusas. A OpenAI pode retornar uma resposta
refusalpara uma pergunta enquanto as outras continuam recebendo respostas. A Gemini bloqueia a requisição inteira com um HTTP 400 e um códigosafetyouprohibited_contentquando os filtros de entrada são acionados. - Ordenação das escolhas. A Gemini ordena as chaves das opções alfabeticamente antes de pontuar, então uma chave como
none_of_the_abovefica antes deshipping. Useothercomo sua opção genérica na Gemini.
As probabilidades do noul da Gemini ficam entre 0,01 e 0,99, então um limite > 0,99 nunca é atingido. O modelo de perguntas de três tipos parecerá familiar se você leu nossa comparação entre OpenAI e Jev.
Entradas e limites: onde a Gemini se destaca
A entrada da Gemini reutiliza os blocos de conteúdo da Interactions API: text, image, audio, video e document (PDF). Misture uma gravação de chamada com metadados da conta e faça 1.000 perguntas sobre ela. Dados inline vão até 100 MB por requisição (50 MB para PDFs); URIs da Files API e URLs HTTPS funcionam até 15 MB cada. Blocos de imagem e vídeo aceitam uma configuração de resolution para trocar detalhes por tokens.
A OpenAI cobre menos mídia, mas mais estrutura. De acordo com o guia de Decisions da OpenAI, o input aceita partes de texto, imagens e input_json, além de histórico de conversa com chamadas de função e suas saídas. Arquivos e áudio não são suportados. As instructions de cada pergunta podem conter sua própria imagem, o que é útil para comparar vários candidatos com uma única referência.
A divisão:
- Áudio, vídeo ou PDFs digitalizados como evidência: Gemini.
- Transcrições de chamadas de ferramenta ou JSON bruto: OpenAI nativamente; a Gemini exige que sejam serializados em texto.
- Imagens por pergunta: somente OpenAI.
Preços: mesmo rótulo, contas diferentes
Ambas listam US$ 0,10 por 1M de tokens de entrada sem cobrança de saída, e ambas cobram a entrada compartilhada uma vez por requisição. As contas divergem na entrada repetida.
A documentação da Gemini diz claramente que a Decisions API não suporta cache de contexto, Batch, Flex ou Priority, e que “entrada repetida entre requisições é contada integralmente”. A OpenAI adicionou cache de prompt no GA. Um prefixo de input compartilhado de pelo menos 1.024 tokens pode atingir o cache a US$ 0,01 por 1M, com gravações no cache cobradas às tarifas padrão da Luna (US$ 0,125 por 1M para gravações de 30 minutos). Consulte a página de preços da OpenAI para as tarifas de cache atuais.
Um exemplo prático (nossa aritmética, não uma cotação de fornecedor): cada requisição verifica o mesmo documento de política de 10.000 tokens com 20 perguntas de 50 tokens cada, um milhão de vezes por mês.
- Gemini: 11.000 tokens x 1M de requisições = 11B de tokens x US$ 0,10 por 1M = US$ 1.100.
- OpenAI, todos os acertos de cache: 10B de tokens em cache x US$ 0,01 por 1M = US$ 100, mais 1B de tokens de perguntas fora do cache x US$ 0,10 por 1M = US$ 100, ou seja, cerca de US$ 200 mais as gravações no cache.
Com entrada nova em cada requisição, como um novo ticket ou foto, o cache não ajuda e ambas custam o mesmo por token. A OpenAI também aplica um multiplicador de 2x acima de 272K tokens de entrada e um acréscimo de 10% para processamento regional.
A vantagem da Gemini é um nível gratuito. A página de preços da Google lista a entrada do Gemini Decision como “Gratuito” lá, mas os dados do nível gratuito são usados para melhorar os produtos da Google. Dados do nível pago não são.
Velocidade e limites de taxa
A Google diz que o Gemini Decision 1 pontua as opções em uma única passagem: 50 a 100 ms de computação mediana do modelo, 150 a 250 ms de ponta a ponta, quase constante de 1 a 100 perguntas, para entradas de até 16K tokens. Essas são afirmações da Google até você medi-las.
A OpenAI publica uma proporção, não um número: “cerca de 10x mais rápida que a Responses API”. Nosso detalhamento de Decisions vs Responses API explica o que isso significa.
Os limites de taxa seguem o mesmo padrão. A página de limites de taxa da Google lista os limites do Gemini Decision por nível:
| Nível | RPM | TPM | RPD |
|---|---|---|---|
| Gratuito | 200 | 50.000 | 10.000 |
| Nível 1 | 1.500 | 1.000.000 | 50.000 |
| Nível 2 | 5.000 | 4.000.000 | Ilimitado |
| Nível 3 | 15.000 | 10.000.000 | Ilimitado |
A OpenAI não publica um limite específico para a Decisions; verifique a página de limites da sua organização.
Quando escolher cada uma
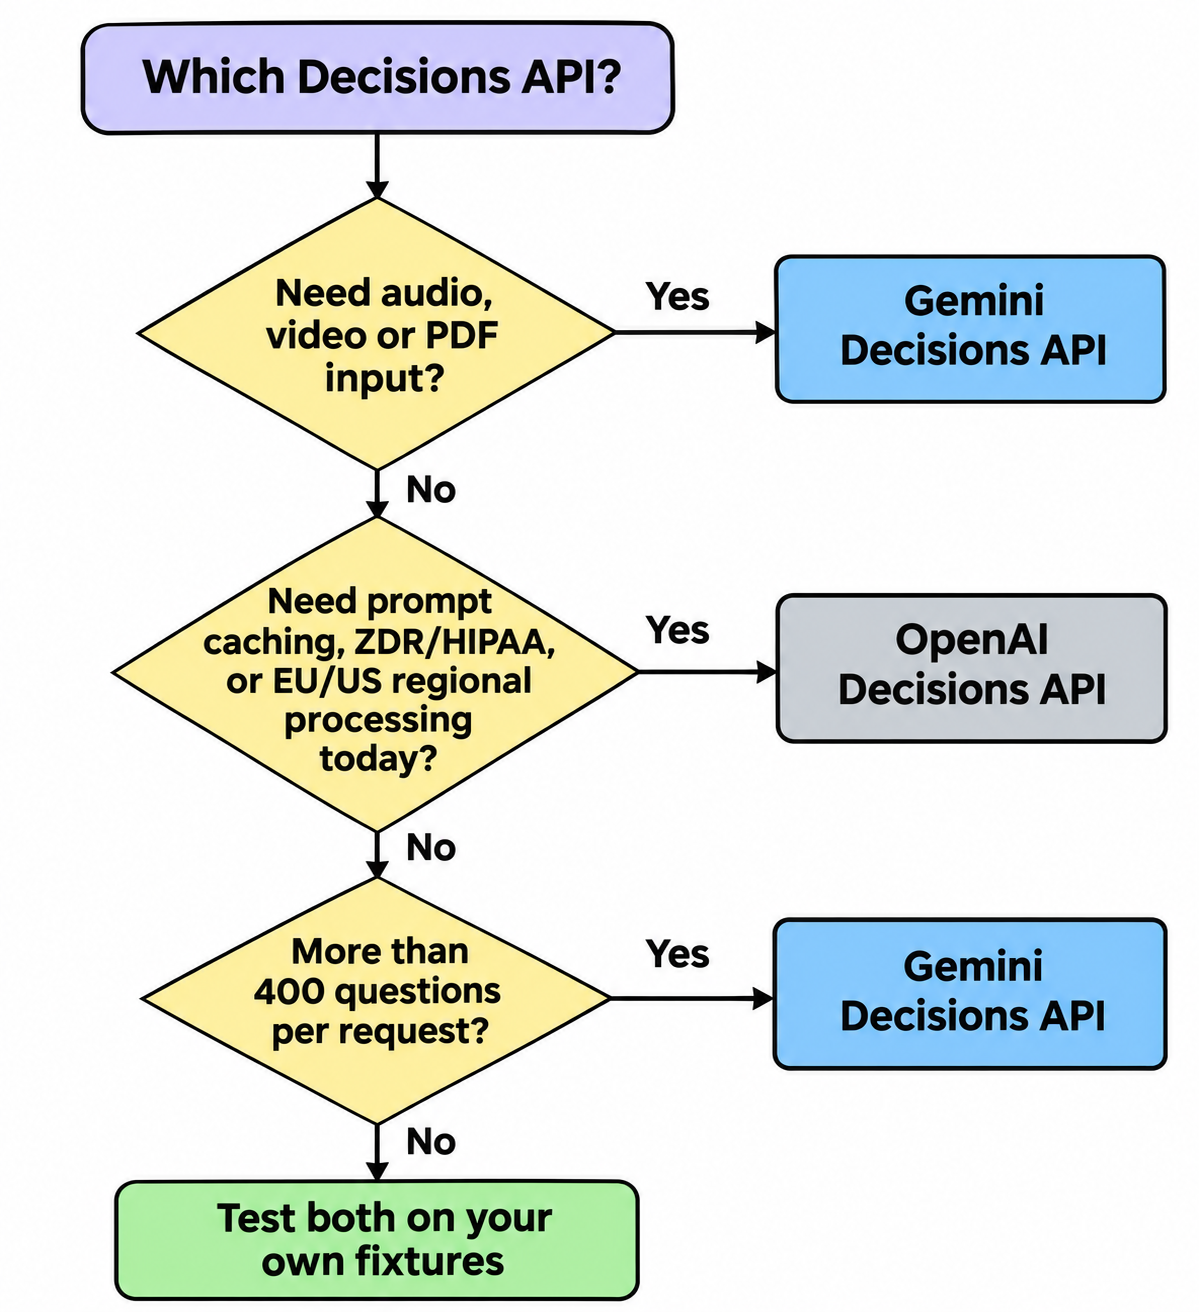
Escolha a Gemini Decisions API quando:
- Sua evidência for áudio, vídeo ou PDF, sem etapa de transcrição ou OCR.
- Você precisar de mais de 400 perguntas por requisição.
- Você quiser criar protótipos por US$ 0 no Google AI Studio.
Escolha a OpenAI Decisions API quando:
- Você precisar de um endpoint em GA hoje. O da Gemini está em
v1beta, e o suporte no Vertex AI está “em breve”. - Você reutilizar uma entrada compartilhada grande e quiser que o cache reduza a conta.
- Sua evidência for histórico de agentes com chamadas de ferramenta, ou JSON bruto.
- Você precisar de ZDR, elegibilidade HIPAA ou processamento regional nos EUA e na UE.
- Você já usar GPT-6 Luna ou GPT-Live; a OpenAI documenta um gatilho nativo do GPT-Live para a Decisions.
Se nenhuma dessas razões decidir, teste as duas.
Deixe seu agente de programação executar o teste A/B com a Apidog CLI
Benchmarks de fornecedores não mostram como nenhum dos modelos lida com os seus tickets. Um teste A/B orientado por fixtures mostra, e seu agente de programação pode construí-lo e executá-lo com a Apidog CLI.
Configure uma vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick Claude Code, Codex, Cursor or OpenCode
Depois dê ao seu agente um único prompt:
In Apidog project <id>, create two endpoints: Gemini Decisions
(take the REST path from Google's Decisions API docs, model
gemini-decision-1) and OpenAI Decisions (POST /v1/decisions,
model gpt-6-luna). Both ask the same "department" choice question
(billing, technical, shipping, other) about {{ticket}}.
Build a test scenario that calls both for each row of fixtures.csv,
asserts HTTP 200, saves each answer, confidence and response time,
and flags rows where the two answers disagree. Run it and summarize.
O agente valida seus payloads, escreve os recursos e executa o cenário uma vez por linha de fixture:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file gemini-decisions.json
apidog endpoint create --project <id> --file gemini-decisions.json
apidog endpoint create --project <id> --file openai-decisions.json
apidog cli-schema get test-scenario-create
apidog test-scenario create --project <id> --file decisions-ab.json
apidog run -t <scenarioId> --project <id> -e <envId> -d fixtures.csv -r cli,json
A flag -d alimenta uma linha de CSV por iteração, então 200 tickets rotulados viram 200 chamadas pareadas, e o relatório JSON alinha respostas, confiança e tempos. Compare-os com seus rótulos e você terá precisão e latência nos seus próprios dados. Mantenha as duas chaves de API no ambiente da Apidog, não no prompt. Consulte a referência do comando apidog run e Apidog CLI no Claude Code.
O plano gratuito da Apidog cobre até 4 usuários.
FAQ
A Gemini Decisions API é mais barata que a OpenAI Decisions API? Não no preço de tabela: ambas cobram US$ 0,10 por 1M de tokens de entrada. A OpenAI fica mais barata com uma entrada grande e reutilizada (US$ 0,01 por 1M em cache). A Gemini é mais barata para prototipagem graças ao seu nível gratuito.
A OpenAI Decisions API consegue ler áudio ou PDFs? Não. Ela aceita texto, imagens e JSON. A Gemini adiciona áudio, vídeo e PDFs.
A Gemini Decisions API está pronta para produção? Ela é lançada como v1beta; o suporte no Google Cloud está “em breve”. O endpoint da OpenAI está em GA desde 22 de outubro de 2026.
Quantas perguntas posso fazer por requisição? A Gemini permite de 1 a 1.000, limitadas pela sua janela de contexto de 262.144 tokens. A OpenAI permite de 1 a 400.
Posso alternar entre elas sem reescrever o código? Não diretamente: mapas de perguntas vs arrays, noul vs predicate, formatos de escolha diferentes. Coloque um adaptador fino na frente e teste ambas com as mesmas fixtures.