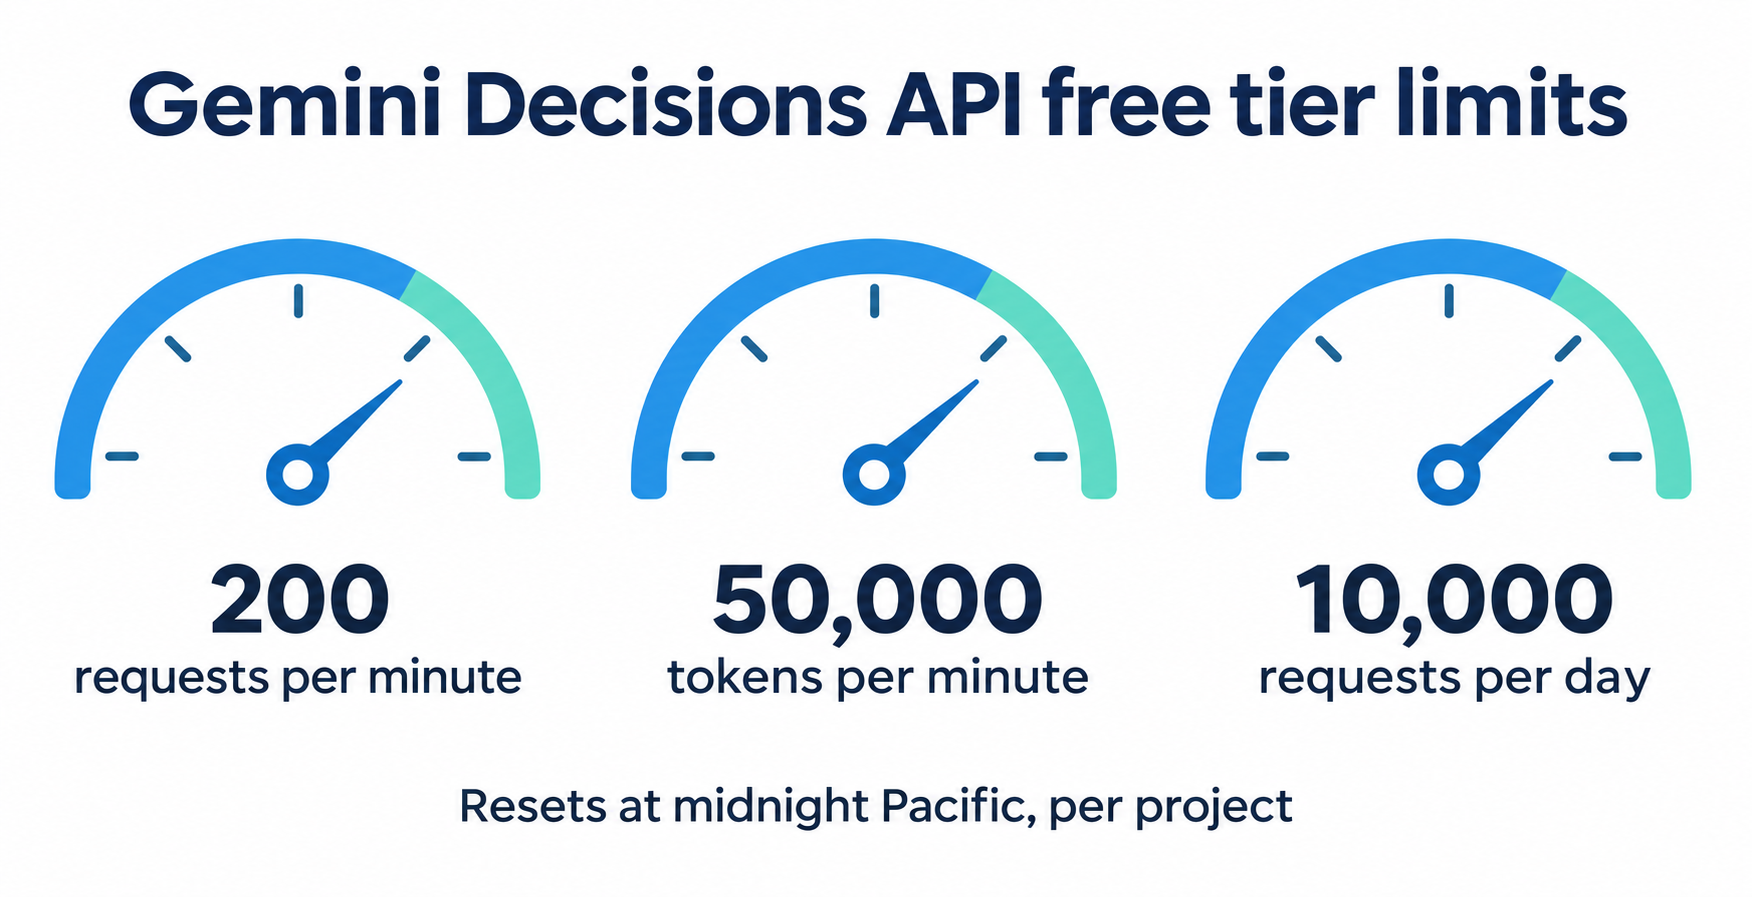
Você pode usar a Gemini Decisions API gratuitamente hoje. O nível gratuito do Google para o gemini-decision-1 não cobra nada pela entrada, não cobra tokens de saída e permite 200 solicitações por minuto, 50.000 tokens por minuto e 10.000 solicitações por dia por projeto. Você precisa de uma chave de API do AI Studio e não precisa de uma conta de faturamento. A ressalva: no nível gratuito, o Google pode usar seu conteúdo para melhorar seus produtos.
Confira abaixo o que esses limites significam em cargas de trabalho reais, a matemática de tokens por trás do preço pago de US$ 0,10 por 1 milhão, as outras rotas gratuitas e como manter os testes e o CI fora da sua cota diária. Cada cota e preço foram consultados nas páginas oficiais do Google em 12 de novembro de 2026. A API é distribuída como v1beta, então verifique novamente antes de fazer um orçamento. Para os próprios tipos de pergunta (noul, choice, score), consulte o guia da Decisions API do Google.
O que o nível gratuito da Gemini Decisions API inclui
O nível gratuito da Gemini Decisions API é o nível de uso sem custo da Gemini Developer API do Google aplicado ao modelo gemini-decision-1. Ele oferece a cada projeto do Google Cloud processamento de entrada gratuito, cobrança zero pela saída e limites de taxa fixos de 200 RPM, 50.000 TPM e 10.000 RPD, sem necessidade de configuração de faturamento.
Aqui está o que a página de preços e a página de limites de taxa do Google dizem, lado a lado:
| Item | Nível gratuito | Pago (Tier 1) |
|---|---|---|
| Preço de entrada (texto, imagem, vídeo, áudio, PDF) | Gratuito | US$ 0,10 por 1M de tokens |
| Preço de saída | Não se aplica (0 tokens de saída) | Não se aplica (0 tokens de saída) |
| Solicitações por minuto | 200 | 1.500 |
| Tokens por minuto | 50.000 | 1.000.000 |
| Solicitações por dia | 10.000 | 50.000 |
| Conteúdo usado para melhorar produtos do Google | Sim | Não |
| Cache de contexto | Indisponível | Indisponível |
Três detalhes importam mais do que os números de destaque:
- Os limites são por projeto, não por chave de API. Criar cinco chaves em um único projeto não dá cinco cotas a você.
- O limite diário é reiniciado à meia-noite, horário do Pacífico. Um job em lote que começa às 23h do horário do Pacífico ganha uma hora da cota de um dia e outros 10.000 novos após a meia-noite.
- Os dados do nível gratuito podem ser usados pelo Google. A tabela de preços marca "Usados para melhorar nossos produtos" como Sim no nível gratuito e Não no pago. Não envie PII de clientes, contratos ou imagens médicas por uma chave gratuita.
Como obter uma chave gratuita da Gemini Decisions API
Você pode estar fazendo chamadas gratuitas em cerca de cinco minutos:
- Faça login no Google AI Studio e clique em Create API key. Um novo projeto começa no nível gratuito.
- Instale o SDK 3.2 ou posterior:
pip install -U google-genaiounpm install @google/genai@latest. - Exporte a chave como
GEMINI_API_KEYpara que o SDK a detecte. - Envie uma solicitação com
http_options={"api_version": "v1beta"}e leia o blocousagena resposta.
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    input="Order 8821 arrived with a cracked screen.",
    questions={
        "is_damaged": {"type": "noul", "instructions": "Did the item arrive damaged?"},
    },
)

print(result.answers["is_damaged"].noul)
print(result.usage.total_input_tokens)
Esse número em usage.total_input_tokens é o que você deve registrar. No nível gratuito, é o que consome seus 50.000 TPM; no plano pago, é a única coisa pela qual você é cobrado.
Para o restante das ofertas gratuitas do Google, consulte nosso guia do nível gratuito da Gemini API e como usar o Gemini gratuitamente.
Como funciona o preço da Gemini Decisions API
Você paga apenas pelos tokens de entrada, e a entrada compartilhada é contada uma vez por solicitação, não importa quantas perguntas você faça. Cada pergunta adiciona apenas os seus próprios tokens de instruções e critérios. A saída é sempre 0 tokens, porque o modelo retorna probabilidades, não texto.
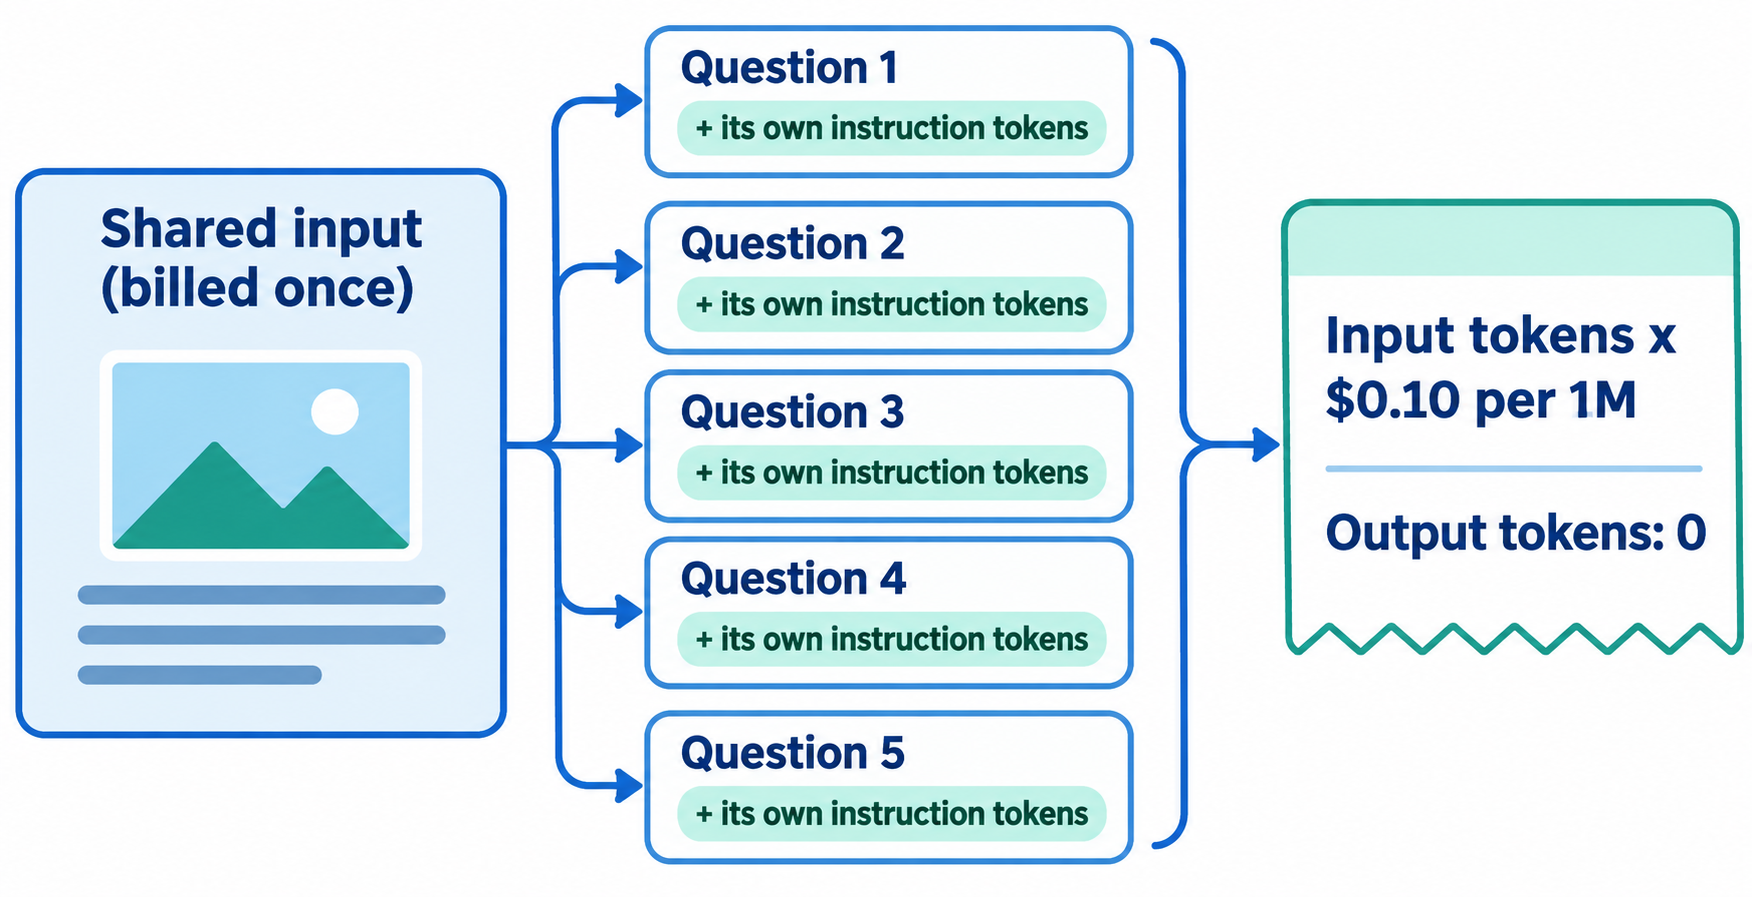
Assim, a fórmula para uma solicitação é simples:
input tokens = shared input + sum(each question's instructions + criteria)
paid cost    = input tokens / 1,000,000 x $0.10
A parte interessante é o que isso faz com o nível gratuito. Com texto, a contagem de solicitações (200 RPM, 10.000 RPD) costuma ser o limite primeiro. Com imagens, áudio ou documentos longos, o limite de 50.000 TPM costuma ser o que limita primeiro.
Exemplos práticos de custos: nível gratuito vs. pago
Os números de tokens por pergunta abaixo são estimativas (cerca de 30 tokens por pergunta curta). As contagens de imagem e áudio vêm da tabela de resolução de mídia do Google, que lista 280 tokens por imagem em low, 1.120 em high e 25 tokens por segundo de áudio para os modelos Gemini atuais. Execute uma solicitação real e substitua meus números pelos seus próprios valores de usage.
10.000 fotos de produtos x 16 perguntas
Suponha que você verifique fotos de entregas quanto a danos, posicionamento, legibilidade do rótulo e outras 13 coisas.
- Por solicitação em resolução
low: 280 (imagem) + 20 (contexto em texto) + 16 x 30 (perguntas) = 780 tokens - 10.000 fotos: 10.000 x 780 = 7,8M de tokens
- Custo pago: 7,8 x US$ 0,10 = US$ 0,78
- Em resolução
high: 1.120 + 20 + 480 = 1.620 tokens por foto, 16,2M de tokens, US$ 1,62
No nível gratuito, o TPM decide sua velocidade: 50.000 / 780 = cerca de 64 fotos por minuto. Todas as 10.000 terminam em aproximadamente 2 horas e 36 minutos e usam exatamente os 10.000 pedidos de um dia. Em high, são cerca de 30 por minuto e 5,5 horas.
Agora, o erro a evitar. Se você enviar as 16 verificações como 16 solicitações separadas, cada uma reenvia a imagem: 16 x 300 = 4.800 tokens de imagem e contexto mais os mesmos 480 tokens de perguntas, cerca de 5.280 por foto. Isso dá 52,8M de tokens (US$ 5,28 pagos) e 160.000 solicitações, ou seja, 16 dias de cota do nível gratuito. Agrupe as perguntas em lote.
10.000 tickets de suporte x 3 perguntas de roteamento
- Por solicitação: 250 (texto do ticket) + 3 x 40 (perguntas com critérios) = 370 tokens
- 10.000 tickets: 3,7M de tokens, US$ 0,37 pagos
- Nível gratuito: 50.000 / 370 = 135 solicitações por minuto, abaixo do limite de 200 RPM. Os 10.000 pedidos de um dia cobrem 10.000 tickets.
PDFs longos
A janela de contexto é de 262.144 tokens, mas o TPM gratuito é de 50.000, então um único contrato de 120.000 tokens excede um minuto inteiro do orçamento gratuito. A documentação do Google não diz como o nível gratuito trata uma única solicitação acima do limite de TPM, então teste uma primeiro. Documentos longos são onde o Tier 1 (1M de TPM) compensa o custo.
Outras formas de usar o Gemini Decision 1 por US$ 0
| Rota | Custo | Precisa de cartão ou faturamento | Para o que serve bem |
|---|---|---|---|
| Nível gratuito da Gemini API (chave do AI Studio) | US$ 0, 200 RPM / 50.000 TPM / 10.000 RPD | Não | Protótipos, ferramentas internas, lotes noturnos com menos de 10.000 solicitações |
| Decisions Playground no AI Studio | US$ 0 (nível sem custo, conforme a publicação de lançamento do Google) | Não | Testar a redação das perguntas antes de escrever código |
OpenRouter (google/gemini-decision-1) |
US$ 0,10 por 1M de entrada, US$ 0 de saída | Sim, créditos | Uma única chave entre provedores; não é gratuito |
A página do modelo no OpenRouter, consultada em 12 de novembro de 2026, lista um provedor (Google AI Studio) a US$ 0,10 por 1M de tokens de entrada, saída gratuita e nenhuma variante :free. Ele roda no endpoint de Decisions do OpenRouter, então SDKs de chat completions não conseguem chamá-lo.
Como se manter dentro do nível gratuito
Esses hábitos mantêm um protótipo em US$ 0 pelo maior tempo possível:
- Faça todas as perguntas em uma única solicitação. A entrada compartilhada é cobrada uma vez, e até 1.000 perguntas cabem em uma chamada.
- Reduza a resolução da mídia.
lowcusta um quarto dehighpor imagem. - Envie apenas os campos que as perguntas precisam. O Google diz que conteúdo não relacionado reduz a precisão, e ele consome TPM.
- Limite pela TPM, não pela RPM. Ritme os workers com 50.000 dividido pelos seus tokens medidos por solicitação.
- Faça cache das respostas por conta própria. A API não tem cache de contexto e conta entradas repetidas por completo, então faça um hash da entrada mais as perguntas e pule repetições.
- Comece grandes execuções após a meia-noite do horário do Pacífico para ter um dia inteiro de cota.
- Mantenha os testes e o CI longe da API real. Uma suíte que a chama a cada push pode gastar 10.000 solicitações antes do almoço. Em vez disso, use um mock.
Deixe seu agente de codificação criar mocks da Decisions API com o Apidog CLI
Testes de unidade não precisam de um modelo ativo. Eles precisam da estrutura certa: um mapa answers, noul entre 0,01 e 0,99, um confidence e usage.total_output_tokens: 0. Seu agente de codificação pode construir esse mock com a Apidog CLI, para que apenas um teste de fumaça toque no Google.
Configure uma vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Depois, dê ao Claude Code, Codex ou Cursor um único prompt:
In Apidog project <id>, add the Gemini Decisions endpoint POST /v1beta/decisions
with a request body of model, input and questions. Create mock expectations that
return a damaged answer (noul 0.97) and an undamaged one (noul 0.04), each with
usage.total_output_tokens = 0. Add a test case that asserts the answers map,
confidence between 0 and 1 and zero output tokens. Run it against the mock
environment, then once against the real API with my free-tier key.
O agente lê cada esquema de payload, valida-o e só então escreve:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file decisions-endpoint.json
apidog endpoint create --project <id> --file decisions-endpoint.json

apidog cli-schema get mock-create
apidog cli-schema validate mock-create --file mock-damaged.json
apidog mock create --project <id> --file mock-damaged.json

apidog cli-schema get test-case-create
apidog test-case create --project <id> --file decisions-case.json
apidog run --test-case <caseId> --project <id> -e <mockEnvId> -r cli,json
apidog run --test-case <caseId> --project <id> -e <freeTierEnvId> -r cli
No CI, execute apenas o ambiente de mock com -r junit (arquivo de pipeline no nosso guia de CI/CD da Apidog CLI); a configuração do agente está em Apidog CLI no Claude Code. O plano Free da Apidog cobre até 4 usuários, então uma equipe pequena compartilha os mocks sem custo. Também está avaliando a versão da OpenAI? Veja nosso explicador da OpenAI Decisions API.
FAQ
A Gemini Decisions API é gratuita? Sim, dentro dos limites. O nível gratuito não cobra nada pela entrada, e a saída é sempre 0 tokens. Você tem 200 solicitações por minuto, 50.000 tokens por minuto e 10.000 solicitações por dia por projeto. Acima disso, configure o faturamento e pague US$ 0,10 por 1M de tokens de entrada.
Preciso de cartão de crédito para o nível gratuito da Gemini Decisions API? Não. Uma chave de API do Google AI Studio já começa no nível gratuito. A página de limites de taxa do Google diz que você migra para um nível pago somente depois de configurar o faturamento no AI Studio.
O Google treina com os meus dados da Decisions API no nível gratuito? A página de preços do Google marca "Usados para melhorar nossos produtos" como Sim para o nível gratuito e Não para o pago. Trate as chaves do nível gratuito como inadequadas para dados sensíveis.
Por que estou recebendo erros 429 bem abaixo de 200 solicitações por minuto? Você provavelmente está passando de 50.000 tokens por minuto. Entradas de imagem, áudio e PDF consomem muitos tokens, então o TPM costuma ser o limite antes da RPM. Registre usage.total_input_tokens e ritme as solicitações com 50.000 dividido por esse número.
Existe um modelo Gemini Decision 1 gratuito no OpenRouter? Não, até 12 de novembro de 2026. O OpenRouter lista o google/gemini-decision-1 a US$ 0,10 por 1M de tokens de entrada e US$ 0 de saída, sem variante :free.
Posso usar a Batch API ou cache de contexto para estender o nível gratuito? Não. A página do modelo lista a Batch API e o cache como não suportados em nenhum nível. Agrupe as perguntas em uma única solicitação e faça cache das respostas no seu próprio código.