Gemini 4 Neon vs GPT-6.2 Astra vs Claude Fable 5.2, em uma linha: o Fable 5.2 tem a maior pontuação, o Neon custa menos por token e o Astra conclui uma tarefa de benchmark independente com o menor custo. O Neon tem preço de tabela de US$ 3 / US$ 15 por 1M de tokens de entrada/saída, enquanto Astra e Fable têm preço de US$ 8 / US$ 40. Os três oferecem cerca de 1M de tokens de contexto.
Três modelos de fronteira lançados em dez dias: Claude Fable 5.2 em 9 de novembro de 2026, GPT-6.2 Astra em 17 de novembro e Gemini 4 Neon em 18 de novembro. Abaixo: preço, especificações, pontuações independentes, custo por tarefa e uma forma de testar os três com o Apidog CLI.
Gemini 4 Neon vs GPT-6.2 Astra vs Claude Fable 5.2: o veredito rápido
Escolha pela carga de trabalho, não pela posição no ranking:
- Gemini 4 Neon para codificação e análise complexas que você executa o dia todo. É 62,5% mais barato por token que os outros dois e ocupa o segundo lugar no Vals Index.
- GPT-6.2 Astra se sua stack roda na OpenAI Responses API. Ele gera muito menos tokens por tarefa, o que o torna o mais barato dos três por tarefa do Artificial Analysis, apesar do preço de US$ 8 / US$ 40.
- Claude Fable 5.2 para o trabalho de longo horizonte mais difícil, onde uma execução malsucedida custa mais que os tokens. Ele lidera os dois índices independentes, com o maior custo por tarefa.
Se você vem do precedente de outubro, nossa comparação Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5 cobre a geração anterior.
Como os três modelos se comparam em preço e especificações?
O Neon é o ponto fora da curva no preço. Os números vêm do post de lançamento do Gemini 4 Neon e da página de preços do Google, da página do modelo GPT-6.2 Astra e da visão geral do Claude Fable 5.2 da Anthropic.
| Especificação | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| ID do modelo na API | gemini-4-neon |
gpt-6.2-astra |
claude-fable-5-2 |
| Lançamento | 18 de nov. de 2026 | 17 de nov. de 2026 | 9 de nov. de 2026 |
| Entrada / saída por 1M | US$ 3 / US$ 15 | US$ 8 / US$ 40 | US$ 8 / US$ 40 |
| Entrada em cache por 1M | US$ 0,15 (somente implícito) | US$ 0,40 | US$ 0,20 |
| Janela de contexto | 1.048.576 (compartilhada com a saída) | 1.050.000 (máx. de entrada de 922.000) | 1M |
| Saída máx. por requisição | 65.536 | 128.000 | 128K |
| Prompts longos | Taxa fixa em todo o 1M | Acima de 272K de entrada: entrada 2x, saída 1,5x | Taxa fixa em todo o 1M |
| Desconto em lote | 50% (Batch e Flex) | 50% | 50% |
| Controle de raciocínio | thinking_level: de low a xhigh, padrão high |
reasoning.effort, none é rejeitado |
effort, padrão high |
| Camada gratuita de API | Não | Não | Não |
Dois detalhes mudam a fatura real. O cache do Neon é implícito: você só obtém a tarifa de US$ 0,15 quando o Google identifica um prefixo de prompt repetido. E o Neon retorna no máximo 65.536 tokens por requisição, então saídas muito longas exigem o long decode do Google ou um loop de continuação.
Para as tabelas de preços completas, veja nossas análises de preços do Gemini 4 Neon, preços do GPT-6.2 Astra e preços do Claude Fable 5.2.
Qual modelo vence nos benchmarks independentes?
As tabelas de benchmark dos fornecedores raramente usam os mesmos testes. Dois rankings independentes avaliam os três em uma mesma suíte, e eles discordam quanto ao segundo lugar.
| Métrica | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| Artificial Analysis Intelligence Index | 61 (xhigh) | 62 (max) | 65 (max) |
| Vals Index | 70,87%, #2 | 67,66%, #8 | 71,31%, #1 |
| Custo por tarefa do índice AA | US$ 6,44 | US$ 4,00 | US$ 26,54 |
| Tempo por tarefa do índice AA | 21,5 min | 13,9 min | 41,8 min |
| Velocidade de saída AA | 110 tok/s | 49 tok/s | 109 tok/s |
| Tokens de saída no índice AA | 283M | 65,8M | 275M |
Fontes: as páginas de modelo do Artificial Analysis para cada modelo, consultadas em 19 de novembro de 2026, e o Vals Index em 18 de novembro de 2026.
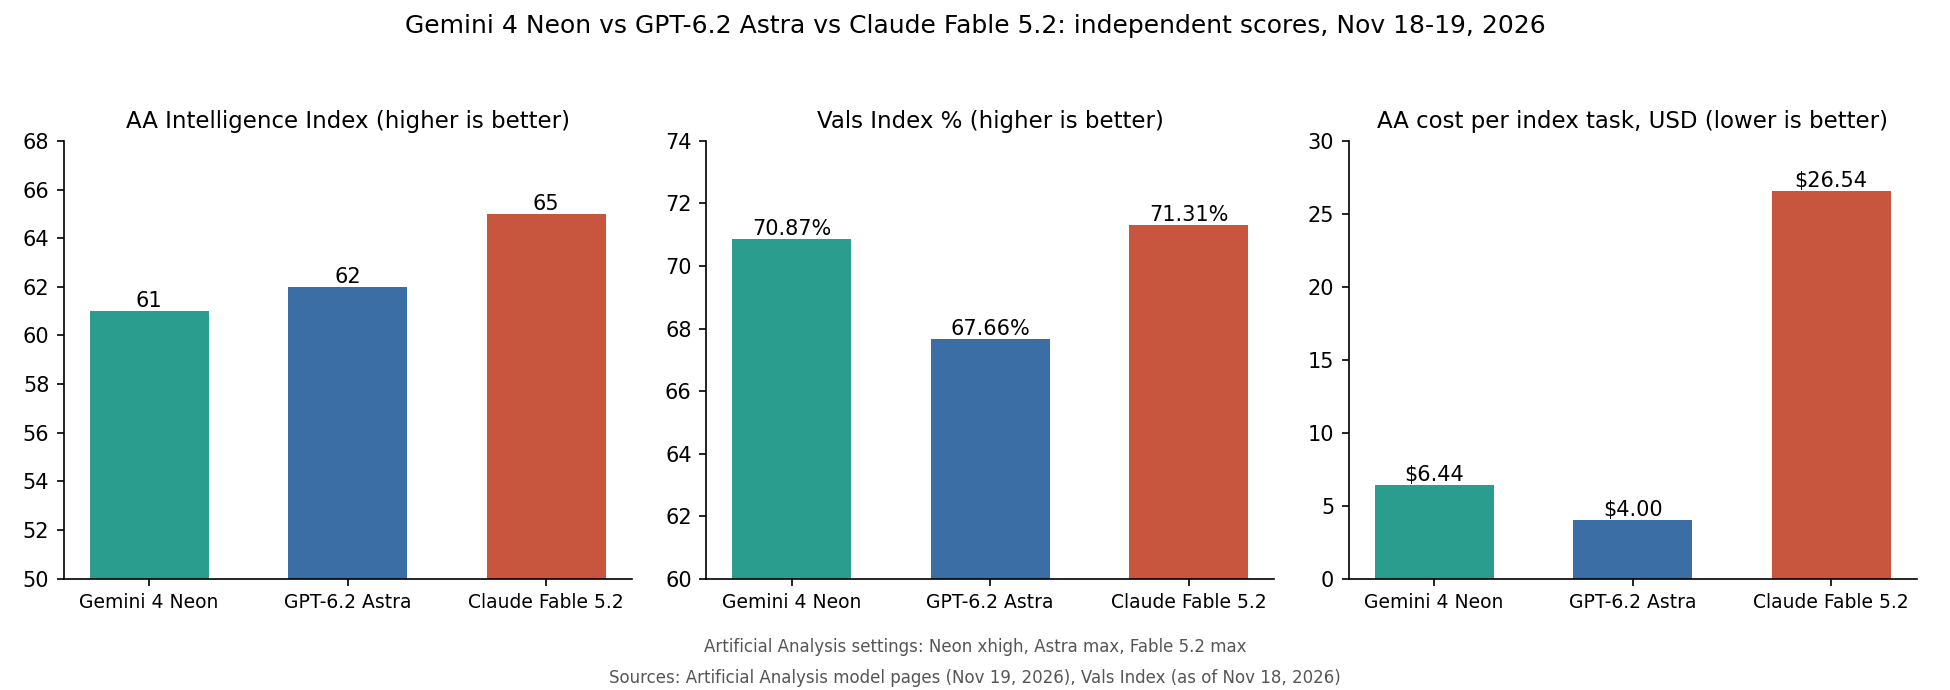
O Fable 5.2 lidera os dois rankings, e no Vals o Neon fica atrás dele por apenas 0,44 pontos. O Artificial Analysis coloca o Astra um ponto à frente do Neon; o Vals coloca o Neon mais de 3 pontos à frente do Astra.
O post de lançamento do Google classificou o Neon em #3 no Artificial Analysis; em 19 de novembro a mesma página o lista em #6 de 96. As posições do dia do lançamento mudam rápido, e uma diferença de um ponto é ruído. As linhas de custo e velocidade dizem mais sobre como cada modelo vai se comportar no seu agente.
Por que o mais caro por token custa menos por tarefa?
O preço por token é metade da conta; a outra metade é quantos tokens um modelo escreve antes de responder. Na suíte do Artificial Analysis, o Astra gerou 65,8M de tokens de saída. O Neon gerou 283M e o Fable 275M, mais de quatro vezes mais. A tarifa de saída de US$ 40 do Astra aplicada a um volume muito menor fez seu custo por tarefa ficar em US$ 4,00, abaixo dos US$ 6,44 do Neon, ainda que a tarifa de saída do Neon seja 62,5% menor.
As configurações importam. O Artificial Analysis rodou o Neon em xhigh; em high ele pontua 60 com 123M de tokens de saída em vez de 283M, um ponto por menos da metade dos tokens. Nosso guia dos níveis de raciocínio do Gemini 4 Neon mostra a curva completa.
Os US$ 26,54 do Fable combinam uma tarifa de saída alta com alta verbosidade: o preço da pontuação máxima.
Quanto custa uma carga de trabalho real de agente em cada modelo?
Duas cargas de trabalho com preços de tabela, assumindo contagens de tokens idênticas em cada modelo (o que não vai acontecer, então leia isto como comparação de preço, não como previsão).
| Carga de trabalho | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| Sessão de agente: 150K de entrada nova, 1,35M de leituras de cache, 150K de saída | US$ 0,45 + US$ 0,20 + US$ 2,25 = US$ 2,90 | US$ 1,50 + US$ 0,54 + US$ 6,00 = US$ 8,04 | US$ 1,50 + US$ 0,27 + US$ 6,00 = US$ 7,77 |
| Uma requisição longa: 400K de entrada, 8K de saída, sem cache | US$ 1,20 + US$ 0,12 = US$ 1,32 | US$ 6,40 + US$ 0,48 = US$ 6,88 | US$ 3,20 + US$ 0,32 = US$ 3,52 |
Astra e Fable cobram os primeiros 150K como escrita de cache a US$ 10 por 1M; o Neon não tem taxa de escrita. A requisição longa ilustra a regra dos 272K do Astra: acima dessa linha, a OpenAI cobra US$ 16 de entrada e US$ 60 de saída por 1M sobre a requisição inteira.
Se o Neon gerar 3x mais tokens que o Astra nos seus prompts, sua sessão de US$ 2,90 pode custar mais que a do Astra. Meça os tokens de saída antes de escolher pelo preço.
Quais diferenças de API vão quebrar seu harness de agente?
Cada API rejeita configurações que as outras aceitam:
- Gemini 4 Neon: o antigo parâmetro
thinking_budgetretorna HTTP 400, assim comofrequency_penaltyepresence_penalty. Valores personalizados detemperature,top_ketop_psão ignorados, segundo o guia para desenvolvedores do Google Cloud. - GPT-6.2 Astra:
reasoning.effortdefinido comononeretorna 400, e a página do modelo lista Realtime, Assistants e fine-tuning como não suportados. - Claude Fable 5.2: uso forçado de ferramentas (
tool_choicecomanyoutool) e parâmetros de amostragem comotemperatureretornam 400, e o raciocínio não pode ser desativado.
Nosso guia GPT-6.2 Astra vs Claude Fable 5.2 cobre as peculiaridades de Astra e Fable em detalhes, e o guia da API do Gemini 4 Neon cobre o formato de requisição do Neon.
Onde cada modelo se encaixa melhor?
Gemini 4 Neon foi feito para trabalho frequente e complexo. O Google afirma que ele reduz leituras redundantes de arquivos e consegue planejar enquanto subagentes mais baratos do Gemini 4 Hydrogen executam as etapas; no Google Antigravity, /swarm executa agentes em paralelo.
GPT-6.2 Astra traz a caixa de ferramentas da OpenAI: apply_patch, shell hospedado, computer use, MCP e um beta multiagente na Responses API. É o mais rápido dos três no Artificial Analysis, com 13,9 minutos por tarefa. Simon Willison observou no dia do lançamento que ele pontua um pouco abaixo do Fable 5.2 em vários benchmarks.
Claude Fable 5.2 é a escolha quando qualidade importa mais que custo: sessões longas de agente, refatorações difíceis, tarefas de pesquisa. Suas leituras de cache a US$ 0,20 e o preço fixo para 1M suavizam a tarifa de saída de US$ 40.
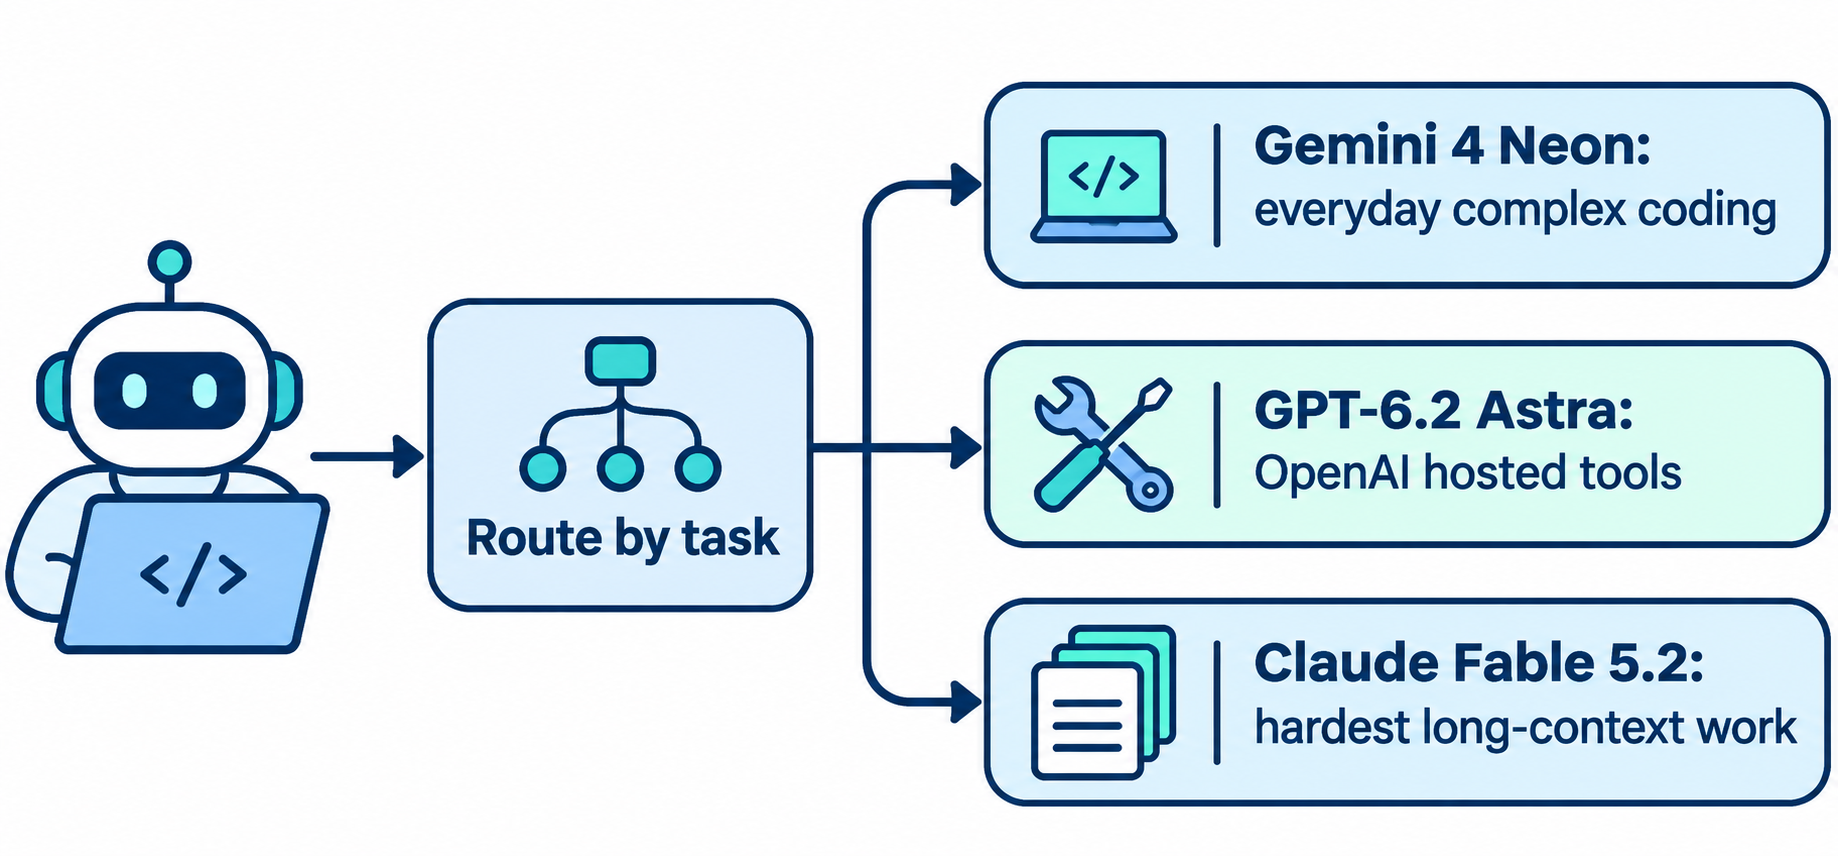
Você não precisa escolher só um. Envie a maior parte das etapas do agente para o Neon e as poucas tarefas que falham nele para o Fable ou o Astra; seu custo médio fica próximo ao do Neon.
Como testar os três modelos na sua própria carga de trabalho?
Os rankings medem as tarefas de outra pessoa. Envie de 5 a 10 prompts reais do histórico do seu agente para as três APIs e compare taxa de acerto, tokens e latência. Executar essas requisições manualmente cansa rápido, então deixe o Claude Code, o Codex ou o Cursor comandarem o Apidog CLI. A configuração leva três comandos:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Depois, passe um prompt para o seu agente:
In Apidog project <PROJECT_ID>, create three test cases that send the
same code-review prompt to gemini-4-neon (Gemini Interactions API,
thinking_level high), gpt-6.2-astra (OpenAI Responses API, effort high)
and claude-fable-5-2 (Claude Messages API, no temperature field).
Keep each API key in a private environment variable. Assert a 200
status and a non-empty answer, record token usage and response time,
run each case 5 times and summarize cost per run at list prices.
Validate every payload against its schema before you write it.
O agente verifica o schema de cada payload, cria os casos e os executa. Estas flags vêm de apidog run --help no CLI 2.2.12:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file neon-case.json
apidog test-case create --project <PROJECT_ID> --file neon-case.json
apidog test-case create --project <PROJECT_ID> --file astra-case.json
apidog test-case create --project <PROJECT_ID> --file fable-case.json
apidog run --test-case <NEON_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir abc-results
Repita o último comando com os IDs dos casos do Astra e do Fable. -n 5 executa cada caso cinco vezes, e --upload-report exibe as execuções no app do Apidog. Este é um modelo de fluxo de trabalho; não o executamos contra as três APIs a partir desta máquina.
Adicione casos negativos para os erros 400 acima, para que uma mudança nas regras de um provedor apareça primeiro na sua suíte. O guia do Apidog CLI no Claude Code cobre a configuração do agente, e o plano Free do Apidog cobre até 4 usuários.
Perguntas frequentes
O Gemini 4 Neon é melhor que o GPT-6.2 Astra? Depende do ranking: o Neon lidera no Vals Index (70,87% vs 67,66%), o Astra lidera por um ponto no Artificial Analysis Intelligence Index (62 vs 61). O Neon custa US$ 3 / US$ 15 por 1M de tokens, contra US$ 8 / US$ 40 do Astra.
Qual dos três é o mais barato? Por token, o Gemini 4 Neon, a US$ 3 de entrada e US$ 15 de saída por 1M. Por tarefa do Artificial Analysis, o GPT-6.2 Astra, a US$ 4,00, porque gera muito menos tokens que o Neon (US$ 6,44) ou o Fable 5.2 (US$ 26,54).
Qual modelo tem a maior pontuação? O Claude Fable 5.2 lidera tanto o Artificial Analysis Intelligence Index (65) quanto o Vals Index (71,31%) em 18 e 19 de novembro de 2026.
Algum deles tem uma camada gratuita de API? Não. O Google não lista camada gratuita para o Neon, e Astra e Fable 5.2 são modelos de API pagos. Assinantes do Google AI Pro e Ultra podem usar o Neon no app Gemini e no Antigravity. Veja nosso guia gratuito do Gemini 4 Neon para as opções de US$ 0.
Posso usar mais de um no mesmo agente? Sim. Roteie as etapas rotineiras para o Neon e as tarefas em que ele falha para o Fable 5.2 ou o Astra. Teste cada rota antes: as contagens de tokens por tarefa variam mais de 4x entre os modelos.