
Gemini 4 Neon vs Carbon agora é uma escolha real para todas as equipes que usam a API Gemini. O Google adicionou o Neon em novembro de 2026 como um modelo intermediário entre o Hydrogen e o Carbon, e os três compartilham um mesmo schema de requisição, uma janela de contexto de 1 milhão de tokens e as mesmas ferramentas integradas. O que os diferencia é a intensidade com que pensam, a velocidade com que concluem as tarefas e o custo de cada token.
Resposta rápida: Use o Gemini 4 Hydrogen ($1,50 de entrada / $7,50 de saída por 1 milhão de tokens, com tier gratuito disponível) como padrão para codificação do dia a dia e workers de agentes. Migre uma tarefa para o Gemini 4 Neon ($3 / $15, apenas no tier pago) quando ela for complexa e rodar com frequência, como refatorações multiarquivo ou análises densas de documentos. Reserve o Gemini 4 Carbon ($2 / $10 até 30 de novembro de 2026, depois $4 / $20) para os problemas mais difíceis de arquitetura, depuração e segurança.
Gemini 4 Neon vs Carbon vs Hydrogen em resumo
O Gemini 4 Neon é o modelo intermediário do Gemini 4 da Google, criado para tarefas complexas de engenharia de software, trabalho intelectual e ciência que você executa com alta frequência. Ele raciocina mais profundamente que o Hydrogen, conclui mais rápido com menos tokens de saída que o Carbon, e custa $3 por 1 milhão de tokens de entrada e $15 por 1 milhão de tokens de saída, apenas no tier pago.
Aqui está a comparação lado a lado, extraída do guia Choosing a model e da página de preços da API Gemini do Google, ambos verificados em 19 de novembro de 2026:
| Gemini 4 Hydrogen | Gemini 4 Neon | Gemini 4 Carbon | |
|---|---|---|---|
| ID do modelo | gemini-4-hydrogen |
gemini-4-neon |
gemini-4-carbon |
| Posicionamento | Padrão rápido | Trabalho complexo e de alta frequência | Raciocínio mais forte |
| Velocidade (classificação do Google) | Rápido | Moderado | Deliberado |
| Entrada / saída por 1M | $1,50 / $7,50 | $3,00 / $15,00 | $2,00 / $10,00 até 30 de novembro, depois $4,00 / $20,00 |
| Entrada em cache por 1M | $0,075 | $0,15 | $0,10, depois $0,20 |
| Níveis de raciocínio | low, medium, high (padrão), xhigh | low, medium, high (padrão), xhigh | low, medium (padrão), high |
| Tier gratuito da API | Sim | Não | Não |
| Janela de contexto | 1.048.576 tokens, unificada | 1.048.576 tokens, unificada | 1.048.576 tokens, unificada |
Os três aceitam entrada de texto, imagem, vídeo, áudio e PDF, e suportam chamadas de função, saídas estruturadas, execução de código, uso do computador e grounding com a Pesquisa Google. Cada um tem um limite de saída síncrona de 65.536 tokens e pode ultrapassá-lo até 1 milhão de tokens com long decode.
Qual modelo do Gemini 4 você deve usar?
A orientação do próprio Google é breve e vale a pena seguir como ponto de partida:
- Comece com o Hydrogen na maioria dos novos projetos: codificação do dia a dia, aplicativos interativos, agentes que usam ferramentas e pipelines de documentos multimodais. O Google afirma que ele reduz afirmações fabricadas em mais de 5x em comparação ao Gemini 3.8 Flash.
- Suba para o Neon quando o Hydrogen não for suficiente e você não precisar da verificação extra do Carbon: depuração em nível de repositório, refatorações multiarquivo e análises jurídicas, financeiras e científicas que rodam muitas vezes ao dia.
- Reserve o Carbon para arquitetura de sistemas, depuração multiarquivo, provas formais, auditorias de segurança ou qualquer tarefa em que um modelo mais rápido fique travado.
- Use o Gemini 3.5 Flash-Lite ($0,30 / $2,50) para trabalho textual de alto volume, como tradução, extração e resumo.
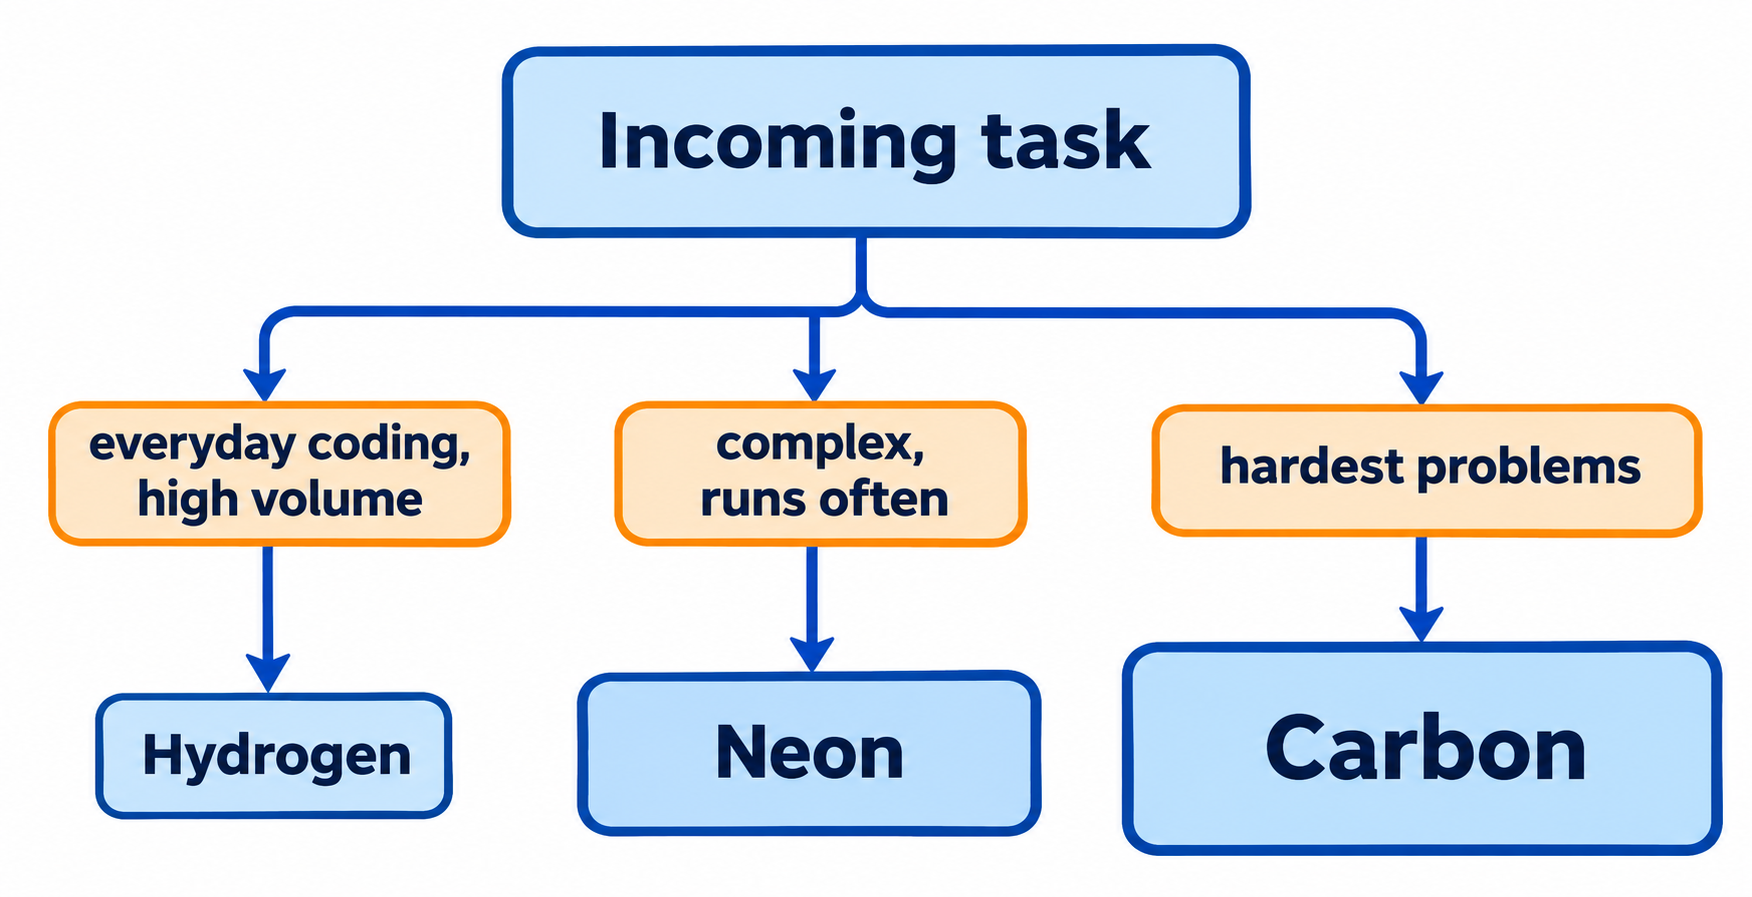
A palavra-chave para o Neon é "frequência". Uma auditoria de segurança trimestral pode arcar com o raciocínio mais lento do Carbon. Um agente de refatoração que toca 200 pull requests por semana precisa de algo que conclua rapidamente e ainda acerte as partes difíceis.
Gemini 4 Neon vs Carbon: preço e profundidade de raciocínio
Esta é a comparação que mais interessa às equipes, porque o Neon e o Carbon são voltados para trabalho pesado.
Estilo de raciocínio. O Carbon gasta mais tokens de raciocínio por turno para testar hipóteses, isolar causas raiz em repositórios e verificar correções contra testes. O Neon busca qualidade de fronteira com uso mais enxuto de tokens. Segundo a página What's new in Gemini 4 Neon do Google, ele conclui a depuração em nível de repositório em menos etapas, reduz leituras redundantes de arquivos em sessões longas de chamadas de ferramentas e lida com compactação de contexto de forma confiável.
Os padrões diferem. O Carbon usa medium como padrão de raciocínio e limita-se a high. O Neon tem high como padrão e adiciona xhigh para os problemas mais difíceis de múltiplas etapas. Se você trocar o Carbon pelo Neon sem definir o thinking_level, também mudará a intensidade com que o modelo pensa.
O preço se inverte em 1º de dezembro. Até 30 de novembro de 2026, a tarifa introdutória do Carbon ($2 / $10) é, na verdade, mais barata por token que a do Neon ($3 / $15). A partir de 1º de dezembro, o Carbon dobra para $4 / $20, e o Neon passa a ser 25% mais barato por token. O Neon não tem preço introdutório, então sua tarifa não muda.
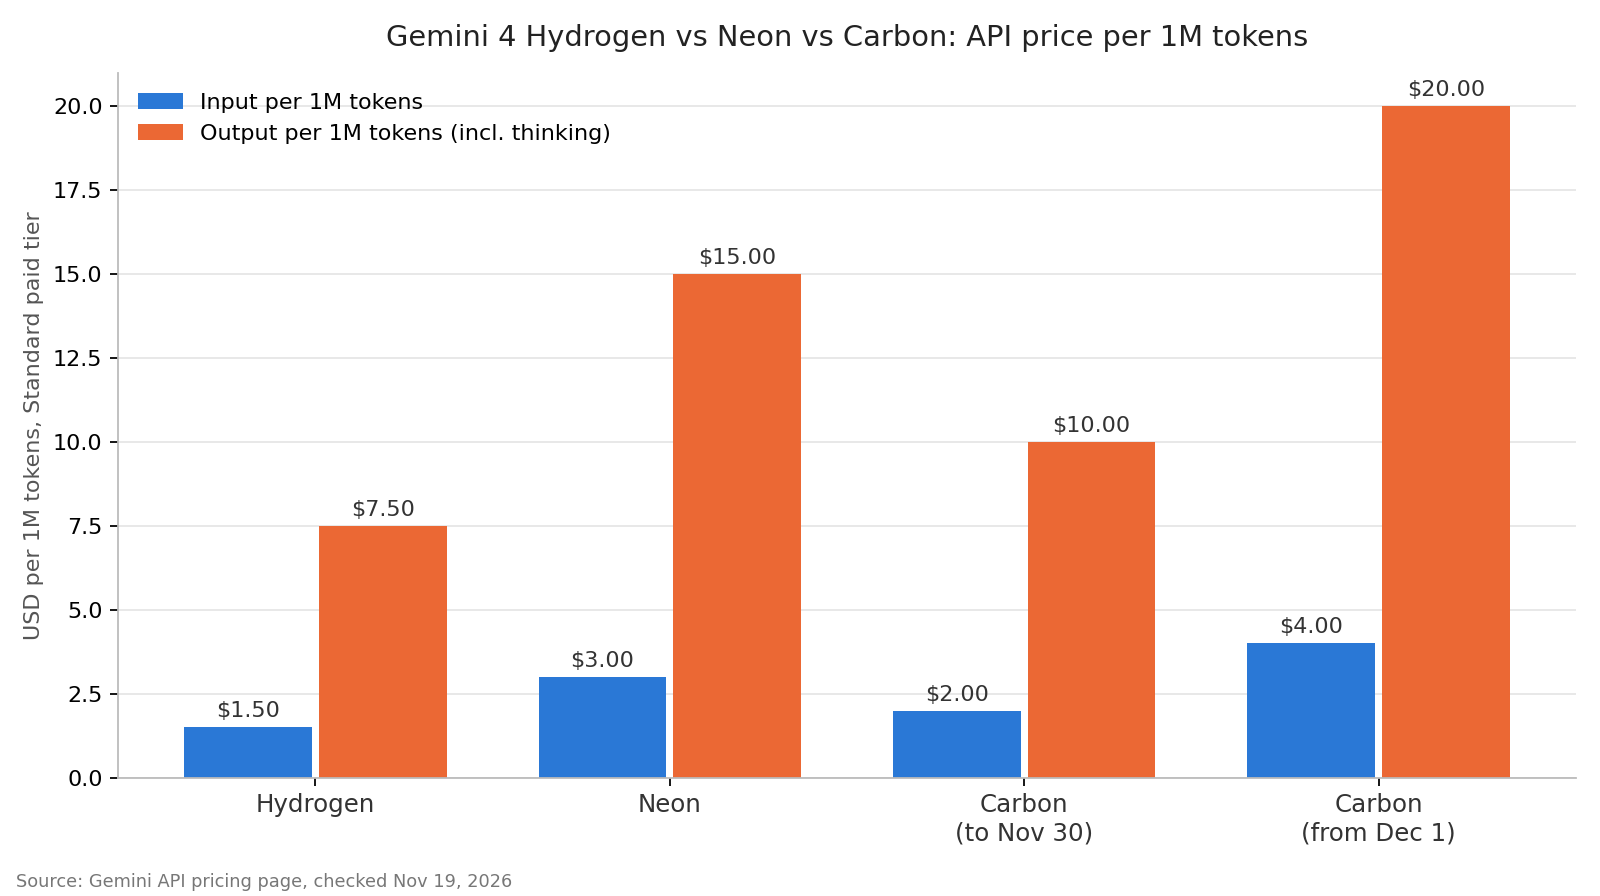
O preço por token é apenas metade da conta, porém: o preço de saída inclui tokens de raciocínio, e o Carbon foi projetado para pensar mais.
Gemini 4 Neon vs Hydrogen: quando a atualização compensa
Hydrogen e Neon parecem iguais no papel: mesmos níveis de raciocínio, mesmo padrão, mesma janela de contexto, mesmas ferramentas. O Neon custa exatamente o dobro por token.
A atualização compensa quando a resposta do Hydrogen força uma nova tentativa. Se o Hydrogen precisa de três tentativas para concluir uma refatoração multiarquivo que o Neon conclui em uma, o modelo mais barato é o caro.
Duas diferenças práticas:
- Tier gratuito. O Hydrogen tem um tier gratuito da API para prototipagem. O Neon não tem, então você precisa de um projeto no tier pago antes da primeira chamada. Nesse tier gratuito, o Google pode usar seus dados para melhorar seus produtos.
- Preço em lote. Ambos reduzem o preço pela metade no modo Batch: o Hydrogen cai para $0,75 / $3,75 e o Neon para $1,50 / $7,50. Um job noturno em lote com o Neon custa o mesmo por token que uma chamada em tempo real com o Hydrogen.
Se você já usa o Hydrogen como worker rápido sob o Carbon como planejador, confira nossa análise do padrão orquestrador do Gemini 4 Hydrogen. O Neon adiciona a esse arranjo uma terceira via para as etapas de dificuldade intermediária.
Custo por tarefa: um exemplo prático
Aqui está uma tarefa de agente com 40.000 tokens de entrada e 8.000 tokens de saída (raciocínio incluído), com preços nas tarifas Standard do tier pago:
| Modelo | Custo de entrada | Custo de saída | Por tarefa | Por 1.000 tarefas |
|---|---|---|---|---|
| Hydrogen | $0,060 | $0,060 | $0,12 | $120 |
| Neon | $0,120 | $0,120 | $0,24 | $240 |
| Carbon (até 30 de nov) | $0,080 | $0,080 | $0,16 | $160 |
| Carbon (a partir de 1º de dez) | $0,160 | $0,160 | $0,32 | $320 |
Esta tabela assume que cada modelo usa o mesmo número de tokens, o que não acontece. O Google afirma que o Carbon gasta mais tokens de raciocínio por turno e que o Neon conclui com menos tokens de saída que o Carbon. Se o Carbon precisar de 12.000 tokens de saída para essa mesma tarefa, seu custo em dezembro sobe para $0,40 por tarefa, e a diferença em relação ao Neon passa de $0,08 para $0,16. Esses contagens de tokens são ilustrativas; meça as suas antes de orçar.
Três alavancas reduzem a conta:
- Cache implícito. Ele roda por padrão em prompts de pelo menos 4.096 tokens e dá 95% de desconto na entrada em cache. Coloque os prompts de sistema e as definições de ferramentas estáveis no início para que alcancem o cache.
- Nível de raciocínio. O Google recomenda rodar seus evals nos quatro níveis e escolher o mais baixo que atenda ao seu padrão de qualidade. O
xhighcusta mais tokens e latência. - Modo Batch. Trabalho não urgente pertence ao modo Batch, pela metade do preço Standard.
Para a linha do tempo completa dos preços do Carbon, leia nosso guia de preços do Gemini 4 Carbon.
Alternando entre os três: o que muda no seu código
Alternar entre os modelos do Gemini 4 não exige mudanças no schema da requisição. Você muda a string model e, geralmente, o thinking_level:
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Find the race condition in this retry queue and propose a fix.",
    "generation_config": { "thinking_level": "high" }
  }'
Ao migrar uma carga de trabalho:
- Fixe o
thinking_levelexplicitamente. O padrão do Carbon émedium; o do Neon e do Hydrogen éhigh. Uma troca sem fixação muda custo e latência. - Use um projeto no tier pago para Neon e Carbon. Chaves do tier gratuito só alcançam o Hydrogen e o Flash-Lite.
- Remova os parâmetros de amostragem. O guia de migração do Neon diz que
temperature,top_petop_ksão ignorados dentro da faixa e retornam um erro400fora da faixa. - Encadeie modelos com
previous_interaction_id. Como os três compartilham o mesmo schema, você pode planejar com o Carbon, implementar com o Hydrogen e enviar as etapas intermediárias mais difíceis ao Neon em uma única conversa.
Deixe seu agente de codificação compará-los com a Apidog CLI
A forma mais rápida de decidir entre Neon, Carbon e Hydrogen é enviar o mesmo prompt aos três e comparar status, latência e uso de tokens. Seu agente de codificação pode criar e executar esse teste com a Apidog CLI enquanto você continua trabalhando.
Instale a CLI e dê a habilidade Apidog ao seu agente:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Depois, dê ao Claude Code, Codex ou Cursor um único prompt:
In Apidog project <id>, create a test scenario named "Gemini 4 model compare"
that POSTs to https://generativelanguage.googleapis.com/v1beta/interactions
with model {{model}}, thinking_level "high" and the prompt in {{prompt}}.
Assert status 200 and a non-empty output, and save the usage block to a variable.
Run it once each for gemini-4-hydrogen, gemini-4-neon and gemini-4-carbon,
then give me a table of latency and token usage per model.
O agente lê o schema do payload, valida seu arquivo, cria o cenário e o executa três vezes, trocando apenas o modelo:
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <id> --file scenario.json
apidog run -t <scenarioId> --project <id> -e <envId> --env-var "model=gemini-4-hydrogen" -r cli,json
apidog run -t <scenarioId> --project <id> -e <envId> --env-var "model=gemini-4-neon" -r cli,json
apidog run -t <scenarioId> --project <id> -e <envId> --env-var "model=gemini-4-carbon" -r cli,json
Mantenha o GEMINI_API_KEY no ambiente do Apidog. Adicione --upload-report para ver cada execução no app e coloque o mesmo comando no CI com -r junit para detectar regressões quando o Google atualizar um modelo. Nosso guia sobre a Apidog CLI no Claude Code cobre a configuração de ponta a ponta. O plano gratuito do Apidog cobre equipes de até 4 usuários.
Perguntas frequentes
O Gemini 4 Neon é melhor que o Gemini 4 Carbon? Não em todos os casos. O Carbon é o modelo de raciocínio mais forte do Google. O Neon troca um pouco de profundidade por conclusão mais rápida e menos tokens de saída, o que serve para trabalho complexo de alta frequência.
O Gemini 4 Neon é gratuito? Não. O Neon está disponível apenas no tier pago da API Gemini, e no Google AI Studio com os planos Google AI Pro e Ultra. O Hydrogen é o modelo do Gemini 4 com tier gratuito da API.
O Neon é mais barato que o Carbon? Por token, apenas a partir de 1º de dezembro de 2026. Até 30 de novembro, a tarifa introdutória do Carbon de $2 / $10 é mais baixa que os $3 / $15 do Neon. Depois disso, o Carbon custa $4 / $20 e o Neon fica 25% mais barato por token, sem contar o raciocínio mais pesado do Carbon.
O Gemini 4 Neon, Carbon e Hydrogen têm a mesma janela de contexto? Sim. Os três compartilham uma janela unificada de 1.048.576 tokens para entrada, raciocínio e saída, com limite de saída síncrona de 65.536 tokens e long decode de até 1 milhão de tokens.
Posso usar Neon, Carbon e Hydrogen no mesmo fluxo de trabalho? Sim. Eles compartilham o mesmo schema de requisição, então você pode passar o previous_interaction_id do turno de um modelo para o de outro. Planeje com o Carbon, implemente com o Hydrogen e dê ao Neon as etapas intermediárias.
Qual modelo do Gemini 4 é o mais rápido? O Hydrogen. O Google classifica o Hydrogen como rápido, o Neon como moderado e o Carbon como deliberado.