
Os níveis de raciocínio do Gemini 4 Neon oferecem quatro configurações para definir o quanto o modelo raciocina antes de responder: low, medium, high e xhigh. O Neon usa high por padrão. O Google recomenda manter high para a maioria dos trabalhos complexos e mudar para xhigh apenas quando high falhar em problemas difíceis e com várias etapas, porque xhigh consome mais tokens e leva mais tempo.
O que são os níveis de raciocínio do Gemini 4 Neon?
Os níveis de raciocínio são valores do parâmetro thinking_level que definem quanto raciocínio interno o gemini-4-neon realiza antes de escrever uma resposta. O Neon oferece quatro: low, medium, high (o padrão) e xhigh. Níveis mais altos usam mais tokens de raciocínio e aumentam a latência; níveis mais baixos respondem mais rápido e custam menos.
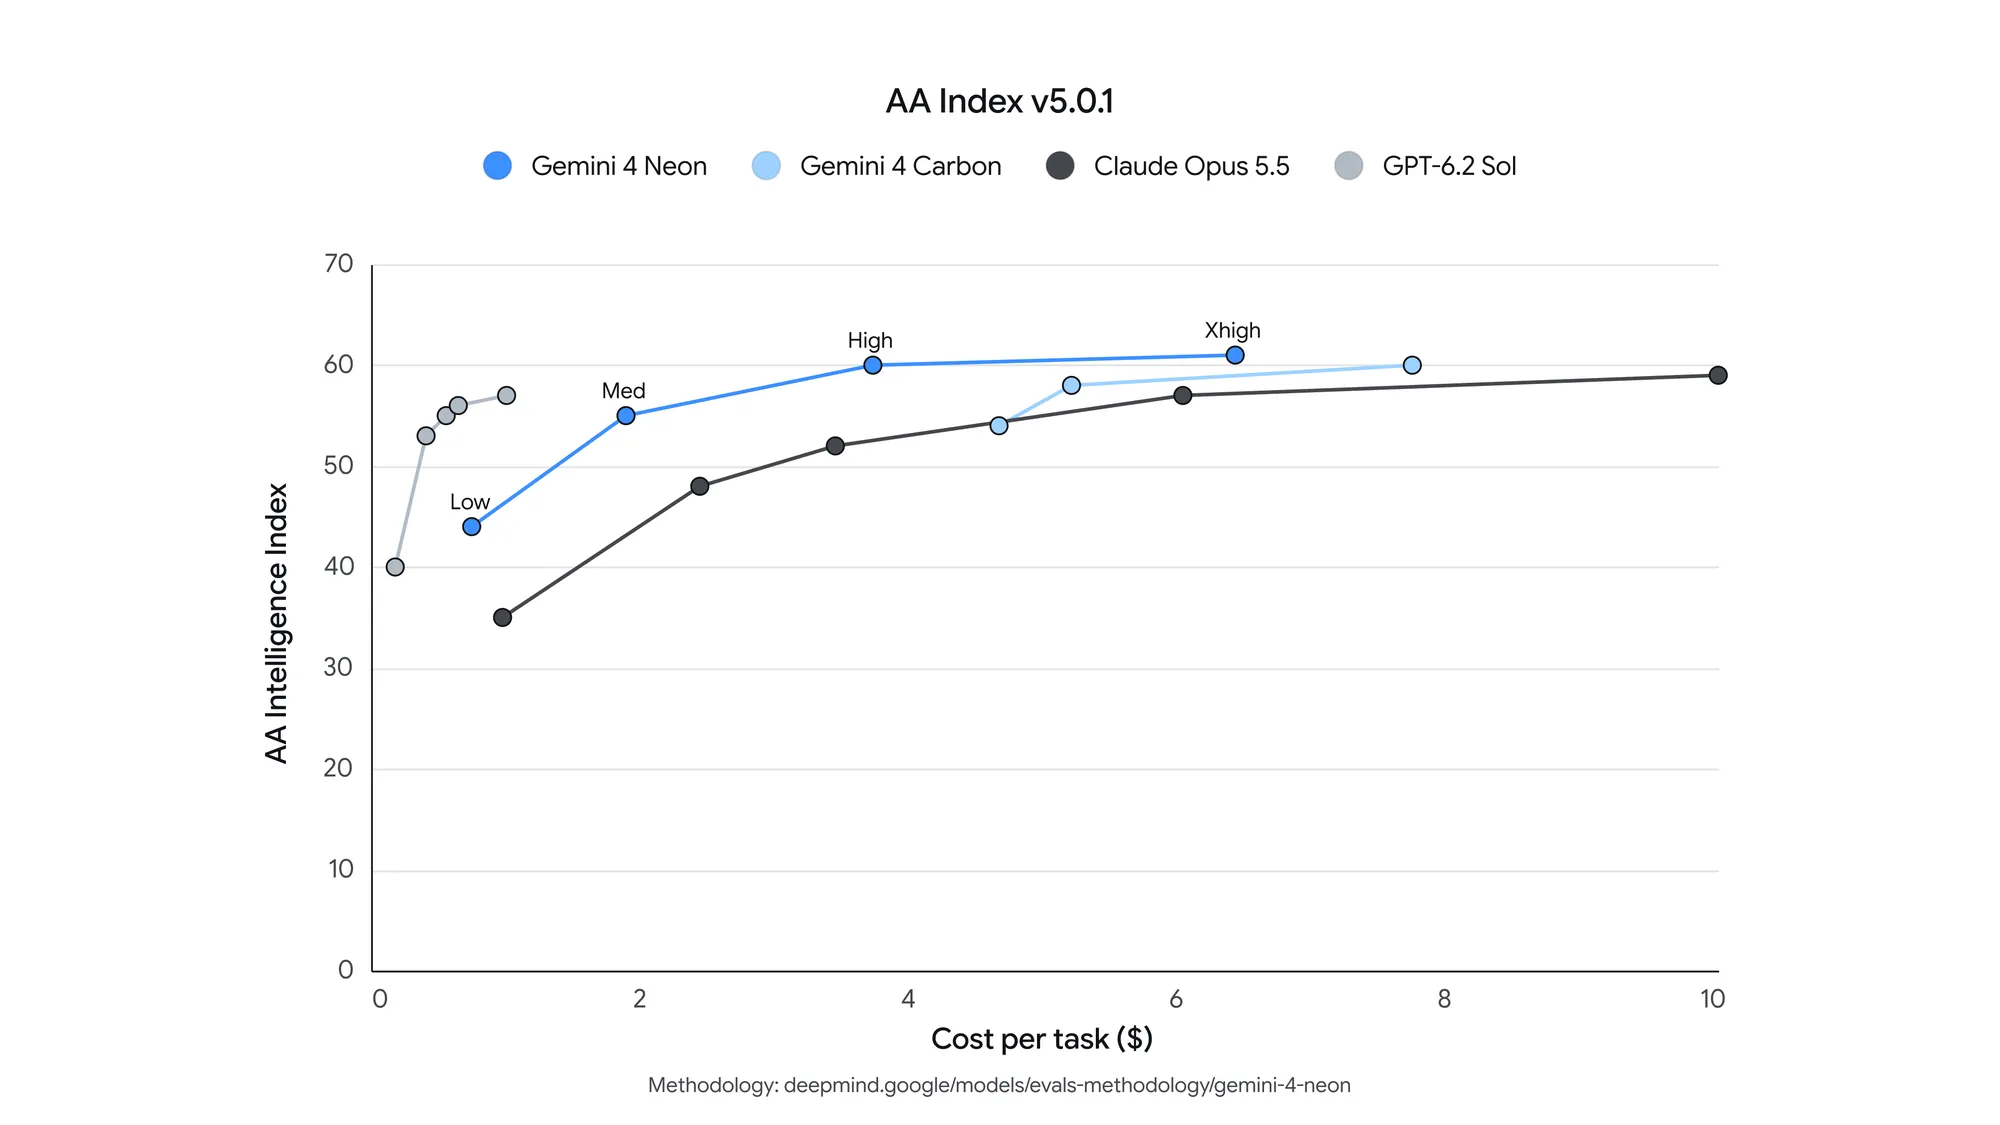
Veja como o guia de raciocínio do Google descreve cada nível para o Neon:
thinking_level |
Uso de tokens | Uso sugerido pelo Google |
|---|---|---|
low |
Menos tokens, menor latência | Chat rápido, processamento de alto volume; ainda competente em tarefas agênticas |
medium |
Menor uso de tokens, respostas mais rápidas | Programação interativa, prototipagem de UI ao vivo, chamadas de ferramentas sensíveis à latência |
high (padrão) |
Inteligência e velocidade equilibradas | Programação complexa, execução agêntica, chamada de ferramentas, trabalho de conhecimento multimodal |
xhigh |
Mais tokens, raciocínio mais profundo | Engenharia difícil com várias etapas, problemas analíticos e científicos em que high não é suficiente |
Faltam dois valores que você talvez esperasse. O Neon rejeita minimal com um erro, então códigos copiados de um app com Gemini 3 Flash quebram se enviarem esse valor. E a contagem de tokens antiga do thinkingBudget está obsoleta no Gemini 4: enviada sozinha, ela é mapeada para o nível mais próximo com um aviso; enviada junto com thinkingLevel, retorna um 400.
Como o padrão do Neon se compara aos outros modelos Gemini 4?
O Neon começa um nível acima dos modelos maiores da mesma família. Segundo as notas de lançamento do Gemini 4 Neon, Neon e Hydrogen usam high por padrão e suportam xhigh, enquanto Carbon e Argon usam medium por padrão e têm limite em high.
| Modelo | Nível padrão | Níveis suportados |
|---|---|---|
gemini-4-neon |
high |
low, medium, high, xhigh |
gemini-4-hydrogen |
high |
low, medium, high, xhigh |
gemini-4-carbon |
medium |
low, medium, high |
gemini-4-argon |
medium |
low, medium, high |
Isso importa quando você troca de modelo. Migre uma carga de trabalho do Carbon para o Neon sem definir thinking_level e cada requisição passa de raciocínio medium para high, o que altera sua contagem de tokens. Se você está avaliando os modelos maiores, nossa comparação Gemini 4 Carbon vs Argon cobre essa diferença.
Como definir thinking_level na Gemini API?
O Neon roda no nível pago tanto da Interactions API quanto do generateContent. O nome do campo difere entre elas.
Interactions API: coloque thinking_level dentro de generation_config.
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Audit this payment retry queue for race conditions.",
    "generation_config": {
      "thinking_level": "xhigh",
      "max_output_tokens": 65536
    }
  }'
generateContent: use thinkingLevel dentro de generationConfig.thinkingConfig.
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-4-neon:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "contents": [{"parts": [{"text": "Audit this payment retry queue for race conditions."}]}],
    "generationConfig": {
      "thinkingConfig": {"thinkingLevel": "medium"}
    }
  }'
No SDK Python, a chamada da Interactions recebe generation_config={"thinking_level": "high"}, e a chamada do generateContent recebe thinking_config=types.ThinkingConfig(thinking_level="low"). Deixe de fora temperature, top_p e top_k: o Google diz que o Neon ignora valores dentro do intervalo e rejeita os fora do intervalo com um 400. Para um passo a passo completo da primeira requisição com o mesmo design de API, veja nosso guia da Gemini 4 Hydrogen API.
Quando usar high ou xhigh?
Use high por padrão e promova uma tarefa para xhigh só depois que high não atingir seu padrão de qualidade nela. O post de lançamento do Google descreve xhigh como “raciocínio mais profundo e com várias etapas para as cargas de trabalho de engenharia, análise e ciência mais difíceis”.
Escolha xhigh quando:
- A tarefa tem muitas etapas dependentes e um erro no início arruína o resultado, como uma refatoração em vários arquivos ou uma auditoria de concorrência.
highdeu uma resposta confiante, mas errada, no seu conjunto de avaliação, não apenas mais lenta.- A latência não importa muito, como em jobs em segundo plano, revisões noturnas ou análise em lote.
- Uma resposta errada custa mais que os tokens, como em patches de segurança ou cálculos financeiros.
Fique em high (ou desça mais) quando:
- O prompt é de extração ou formatação. O Google avisa que
xhigh“pode causar raciocínio excessivo ou esgotarmax_output_tokensem prompts mais simples, como extração de texto ou JSON”. - Um usuário está esperando. Chat, autocomplete e chamadas de ferramentas ao vivo se encaixam em
mediumoulow. - Você opera em alto volume. Cada token de raciocínio extra é cobrado, e a diferença se multiplica entre requisições.
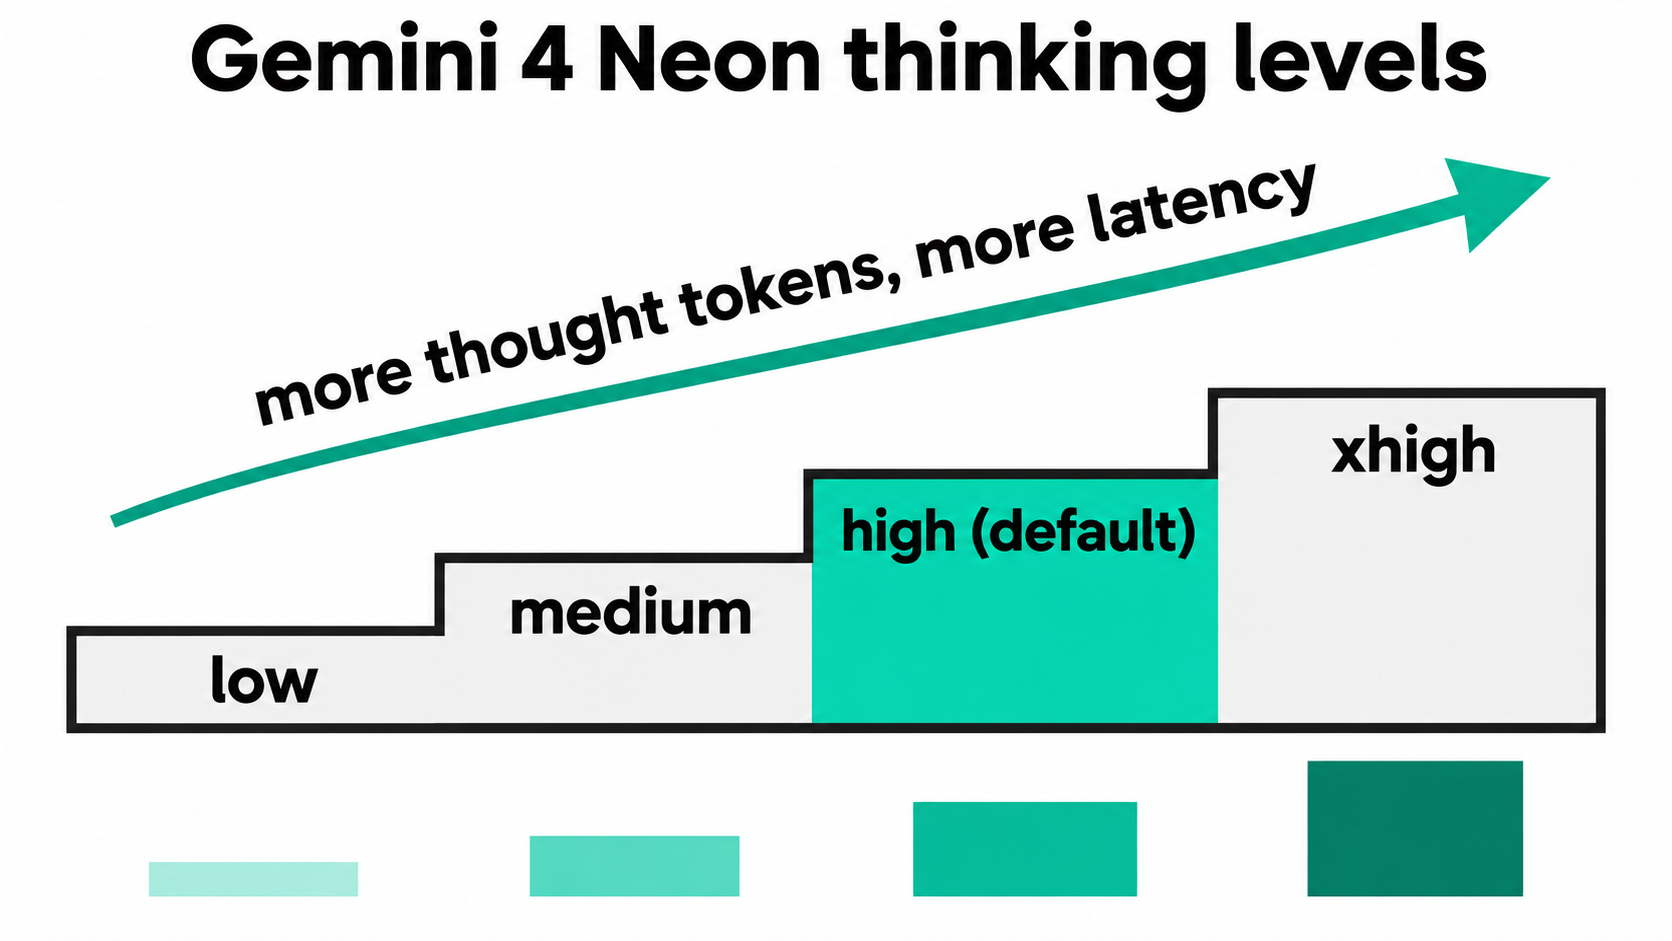
Os números de benchmark do Google confirmam essa divisão. No anúncio de lançamento, o Neon em xhigh marca 61 no Artificial Analysis Intelligence Index, ficando em terceiro lugar. No high padrão, o Google reporta um custo por tarefa 32% menor que o Carbon. Esses são os números do Google, não nossos testes, mas mostram a troca: xhigh entrega a pontuação mais alta do Neon, e high entrega eficiência.
Quanto custa cada nível de raciocínio?
Todos os níveis têm o mesmo preço por token; o que muda é quantos tokens você paga. O Neon custa US$ 3,00 por 1 milhão de tokens de entrada e US$ 15,00 por 1 milhão de tokens de saída, e a página de preços do Google informa que a tarifa de saída inclui os tokens de raciocínio. A entrada em cache cai para US$ 0,15 por 1 milhão via cache implícito (o cache explícito não é suportado no Neon). Não há nível gratuito para este modelo.
Assim, o custo de um nível é o número de tokens de raciocínio que ele adiciona, multiplicado por US$ 15 por milhão. Veja a aritmética para uma requisição com 2.000 tokens de entrada e uma resposta visível de 800 tokens. As contagens de tokens de raciocínio são hipotéticas, escolhidas para mostrar o cálculo, não medidas:
| Tokens de raciocínio (hipotéticos) | Custo de entrada | Custo de saída + raciocínio | Total por requisição | Por 10.000 requisições |
|---|---|---|---|---|
| 500 | $0,006 | $0,0195 | $0,0255 | $255 |
| 2.000 | $0,006 | $0,042 | $0,048 | $480 |
| 8.000 | $0,006 | $0,132 | $0,138 | $1.380 |
O raciocínio domina a conta rapidamente. Com 8.000 tokens de raciocínio, ele representa 87% do custo da requisição. Por isso o próprio Google recomenda rodar sua avaliação em todos os quatro níveis e “escolher o thinking_level mais baixo que atenda ao seu padrão de qualidade”. Nosso guia de níveis de raciocínio do Gemini 3.8 Flash cobre a mesma troca em um modelo mais barato, caso queira comparar.
Como medir tokens e latência por nível?
Rode o mesmo prompt em cada nível e leia o bloco de uso. Na Interactions API, o objeto usage da resposta reporta total_input_tokens, total_output_tokens e total_thought_tokens separadamente. No generateContent, os tokens de raciocínio aparecem como usageMetadata.thoughtsTokenCount.
Este loop envia um prompt nos quatro níveis e imprime os tokens de raciocínio mais o tempo de execução:
for level in low medium high xhigh; do
  start=$(date +%s)
  usage=$(curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
    -H "x-goog-api-key: $GEMINI_API_KEY" \
    -H 'Content-Type: application/json' \
    -d "{\"model\":\"gemini-4-neon\",
         \"input\":\"Find the race condition in this retry loop: ...\",
         \"generation_config\":{\"thinking_level\":\"$level\",\"max_output_tokens\":65536}}" \
    | jq -c '{status, thought: .usage.total_thought_tokens, out: .usage.total_output_tokens}')
  echo "$level $(( $(date +%s) - start ))s $usage"
done
Rode com 10 a 20 prompts da sua carga de trabalho real. Um único prompt diz pouco; um conjunto mostra onde high e xhigh começam a divergir em qualidade.
Configure um timeout alto no seu cliente HTTP durante os testes. As notas de migração do Google dizem que prompts difíceis podem levar vários minutos e sugerem um timeout de pelo menos 15 minutos, ou execução em segundo plano.
Por que xhigh às vezes retorna uma resposta vazia?
max_output_tokens limita o raciocínio e a saída visível juntos. Se o Neon gastar todo o orçamento raciocinando, a interação termina com status incomplete e retorna uma resposta truncada ou vazia, e você ainda paga pelos tokens de raciocínio gerados.
Três regras da documentação do Google evitam isso:
- Remova limites baixos antigos. Se seu app tem algo como 8.192 fixo no código, aumente para 65.536, o limite síncrono padrão.
- Baixe o nível, não o limite. Para reduzir custo ou latência, mude para
mediumoulowem vez de diminuirmax_output_tokens. - Use segundo plano para trabalhos longos. Para respostas acima de 65.536 tokens, defina
backgroundcomotrueemax_output_tokensaté 1.048.576 menos sua entrada. Entrada, raciocínio e saída compartilham uma única janela de 1M de tokens. Nosso guia de saída longa do Gemini 4 Argon explica o padrão de polling.
Deixe seu agente de programação testar os quatro níveis com o Apidog CLI
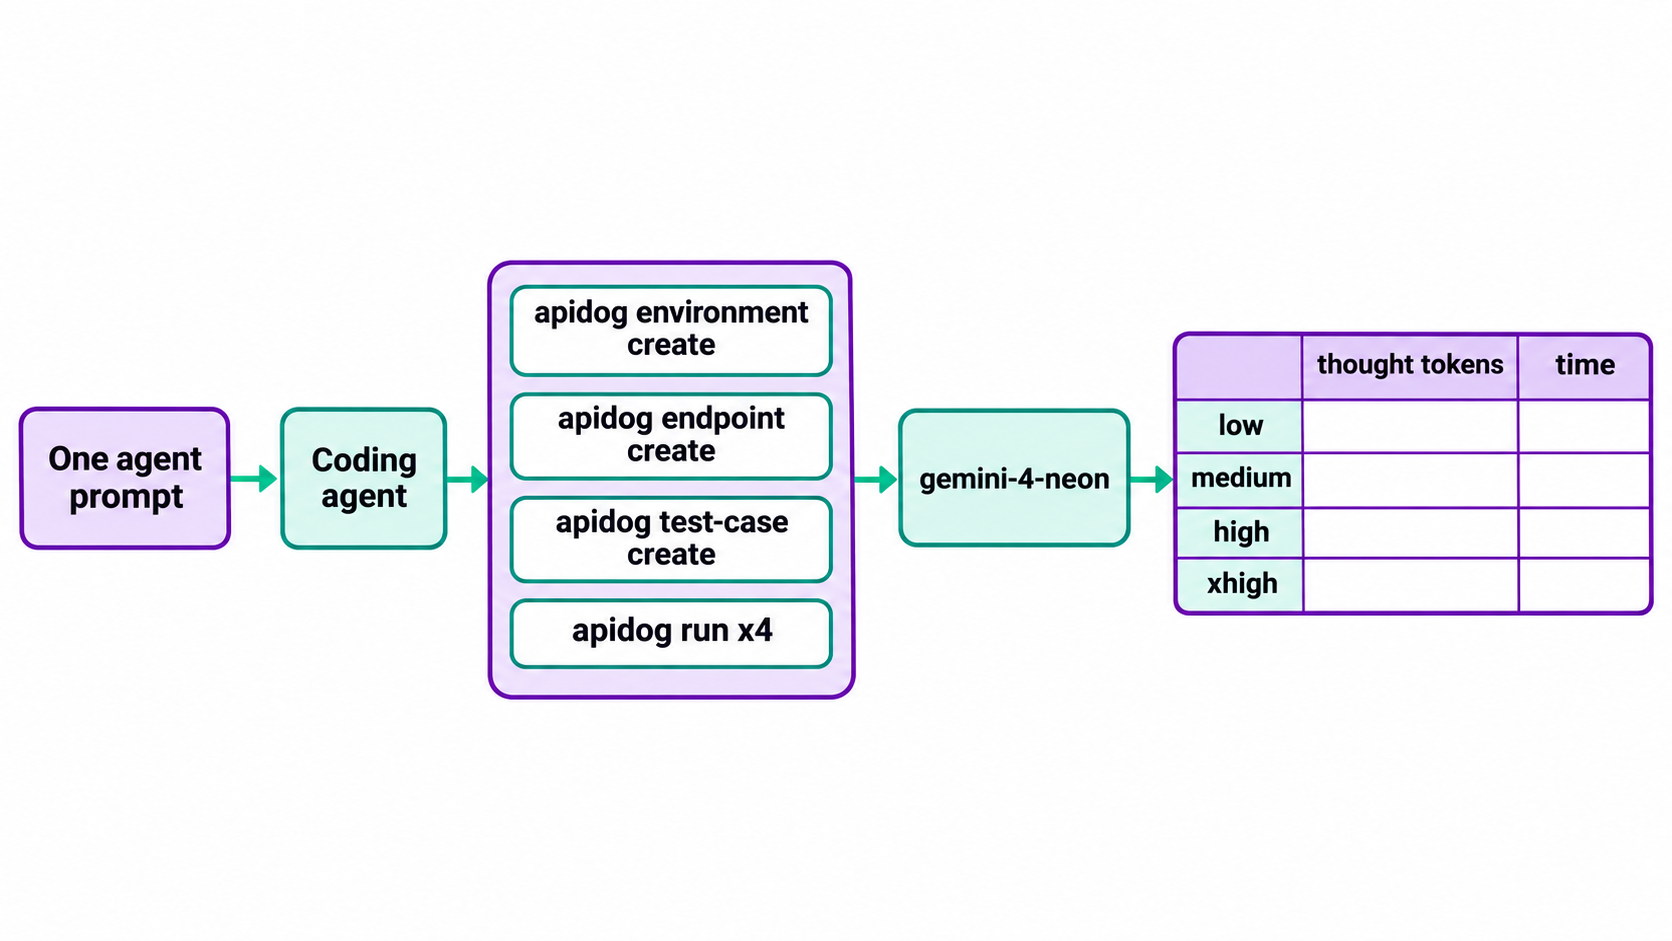
Repetir esse loop manualmente cansa. Em vez disso, deixe seu agente de programação (Claude Code, Codex, Cursor) montar um teste reutilizável com o Apidog CLI e rodá-lo em cada nível sempre que quiser números atualizados.
Configure uma vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Depois, dê um único prompt ao seu agente:
In Apidog project <projectId>, create an environment "gemini" with base URL
https://generativelanguage.googleapis.com and variables GEMINI_API_KEY and
THINKING. Add an endpoint for POST /v1beta/interactions that sends the
x-goog-api-key header from GEMINI_API_KEY. Create a test case that sends model
"gemini-4-neon", my audit prompt, generation_config.thinking_level {{THINKING}}
and max_output_tokens 65536, and asserts: HTTP 200, status is "completed",
and usage.total_thought_tokens exists. Run it once per level (low, medium,
high, xhigh) and give me a table of thought tokens and response time.
O agente lê o schema de cada payload, valida o JSON, cria os recursos e executa o loop:
apidog environment create gemini --project <projectId> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
for level in low medium high xhigh; do
  apidog run --test-case <caseId> --project <projectId> -e <envId> \
    --env-var "THINKING=$level" -r cli,json --out-file "neon-$level"
done
A asserção status is "completed" captura a armadilha do incomplete da seção anterior, de modo que um nível que fica sem orçamento falha de forma explícita em vez de retornar uma string vazia. Troque -r cli,json por -r junit e a mesma execução entra no CI; o guia de CI/CD do Apidog CLI mostra o pipeline, e o Apidog CLI no Claude Code cobre a configuração do agente. O plano Free do Apidog atende até 4 usuários.
Perguntas frequentes
Qual é o nível de raciocínio padrão do Gemini 4 Neon? high. Você não precisa enviar thinking_level para obtê-lo. Carbon e Argon usam medium por padrão, então defina o nível explicitamente ao migrar deles.
O Gemini 4 Neon suporta raciocínio mínimo (minimal)? Não. O Neon suporta low, medium, high e xhigh, e rejeita minimal com um erro. Use low para as respostas mais rápidas e baratas.
Os tokens de raciocínio são cobrados no Gemini 4 Neon? Sim. Os tokens de raciocínio são cobrados na tarifa de saída de US$ 15,00 por 1 milhão. O Google conta todos os tokens que o modelo processa, incluindo os tokens de raciocínio.
Ainda posso usar thinkingBudget com o Gemini 4 Neon? Está obsoleto nos modelos Gemini 4. Enviado sozinho, ele é mapeado para o thinkingLevel mais próximo e retorna um aviso. Enviado junto com thinkingLevel, a requisição falha com um 400.
xhigh é sempre mais preciso que high? Não sempre. O Google diz que xhigh pode raciocinar em excesso em prompts simples, como extração de texto ou JSON, e pode esgotar max_output_tokens. Teste ambos com seus próprios prompts e fique com o nível mais baixo que passar.
Posso usar os níveis de raciocínio do Gemini 4 Neon gratuitamente? Não. O Gemini 4 Neon não está disponível no nível gratuito da Gemini API. No Google AI Studio e no Google Antigravity, ele está vinculado aos planos pagos Google AI Pro e Ultra.