
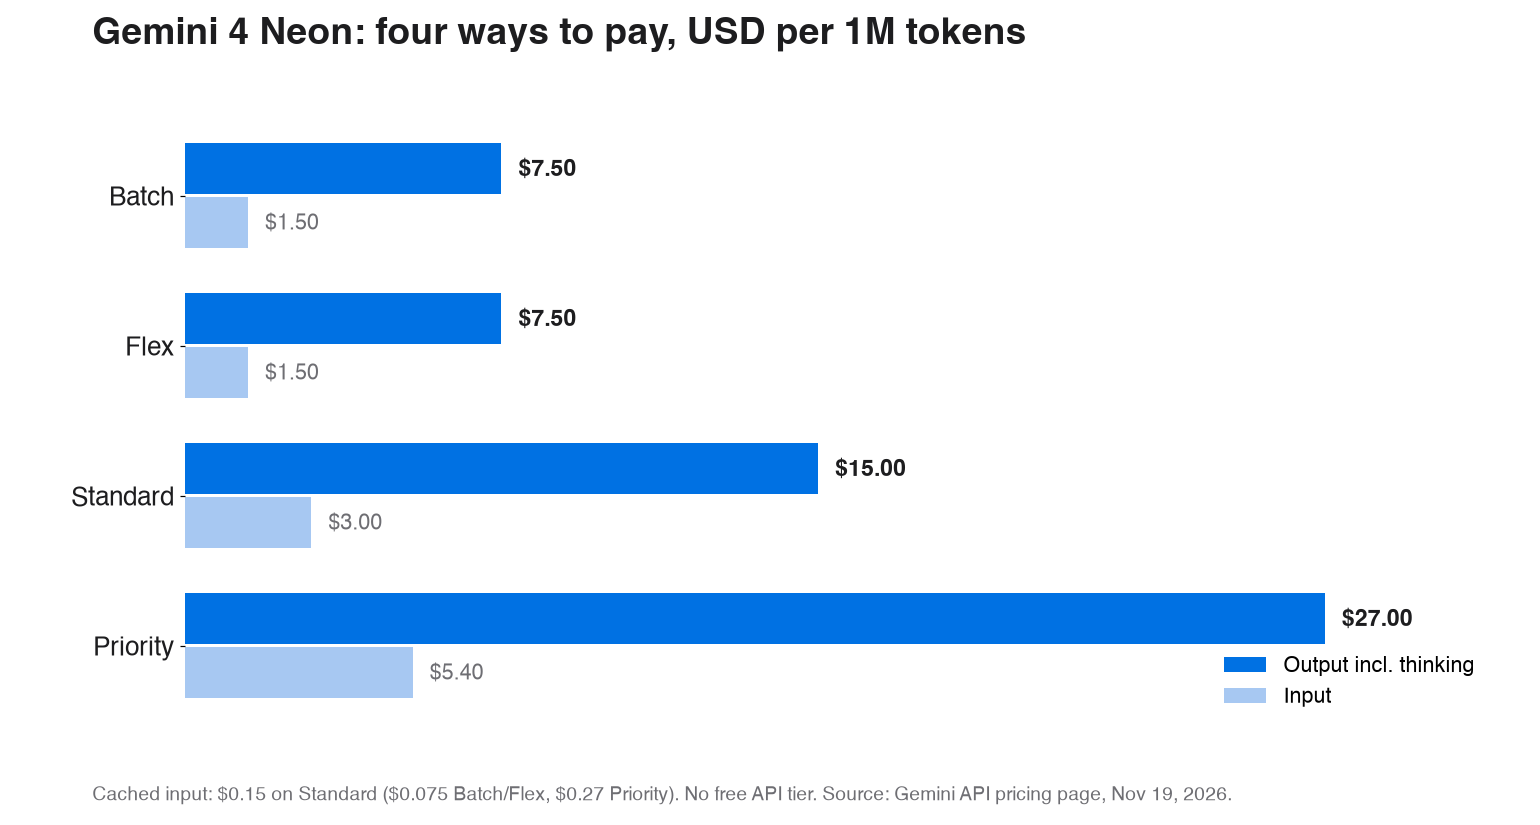
A precificação do Gemini 4 Neon é de US$ 3 por 1M de tokens de entrada e US$ 15 por 1M de tokens de saída na camada Standard paga da API Gemini, de forma fixa em toda a sua janela de contexto de 1M de tokens. Os tokens de pensamento são cobrados na taxa de saída, a entrada em cache custa US$ 0,15 por 1M, Batch e Flex reduzem todas as taxas pela metade e a Priority custa US$ 5,40 e US$ 27. Não há camada de API gratuita.
A Google lançou o Neon em 18 de novembro de 2026, como o modelo intermediário da família Gemini 4, entre o rápido Hydrogen e o robusto Carbon. Abaixo: a tabela de preços, o que as chamadas reais custam, como os níveis de pensamento afetam sua fatura e como o Neon se compara com seus irmãos antes e depois de 1º de dezembro.
Quanto custa o Gemini 4 Neon por 1M de tokens?
O Gemini 4 Neon (ID do modelo gemini-4-neon) tem quatro camadas pagas na página de preços da Google. Todos os preços estão em USD por 1M de tokens:
| Camada | Entrada | Saída incl. pensamento | Entrada em cache |
|---|---|---|---|
| Standard | $3.00 | $15.00 | $0.15 |
| Batch | $1.50 | $7.50 | $0.075 |
| Flex | $1.50 | $7.50 | $0.075 |
| Priority | $5.40 | $27.00 | $0.27 |
| Camada gratuita | Não disponível | Não disponível | Não disponível |
Três detalhes são os mais importantes:
- Pensamento é saída. A coluna de saída diz “incluindo tokens de pensamento”, então cada token que o Neon gasta raciocinando custa US$ 15 por 1M na camada Standard, mesmo que você nunca o veja na resposta.
- O cache é apenas implícito. Você obtém a taxa de US$ 0,15 quando o cache do Google corresponde a um prefixo de prompt repetido; você não pode criar um objeto de cache por conta própria.
- Não há camada gratuita. A página de preços do Google lista o Neon como não disponível na camada gratuita. O Hydrogen é o modelo Gemini 4 que você pode chamar por US$ 0 (veja nosso guia gratuito do Gemini 4 Hydrogen).
O que significam as quatro camadas do Gemini 4 Neon?
As quatro camadas vendem o mesmo modelo com garantias de velocidade diferentes. O Batch retorna resultados de forma assíncrona pela metade do preço, o Flex custa metade do preço para tráfego que tolera processamento mais lento, e o Priority custa 80% mais que o Standard para se manter rápido quando a capacidade está limitada. Escolha pelo prazo:
| Sua carga de trabalho | Camada | Por quê |
|---|---|---|
| Assistente de codificação interativo, chat | Standard | Um usuário está esperando; $3/$15 é a base |
| Revisão de código noturna, execuções de avaliação, preenchimento retroativo de documentos | Batch | Ninguém espera; você paga $1.50/$7.50 |
| Agentes em segundo plano que podem tentar novamente depois | Flex | A mesma metade do preço, sem montar um arquivo de lote |
| Agente voltado ao cliente com promessa de disponibilidade | Priority | $5.40/$27 compra capacidade sob carga |
O grounding tem seu próprio contador. Nas camadas Standard e Priority, o grounding com Google Search inclui 5.000 solicitações de pesquisa gratuitas por mês, compartilhadas entre os modelos Gemini 3 e mais recentes, e depois custa US$ 14 por 1.000. O grounding com Google Maps segue o mesmo padrão de 5.000 gratuitas e depois US$ 14 por 1.000. A página de preços não lista preço de grounding para Batch ou Flex.
Como os níveis de pensamento mudam sua fatura do Gemini 4 Neon?
O Neon suporta quatro níveis de pensamento: low, medium, high e xhigh. O nível não altera o preço por token; ele altera quantos tokens de saída o Neon consome antes de responder.
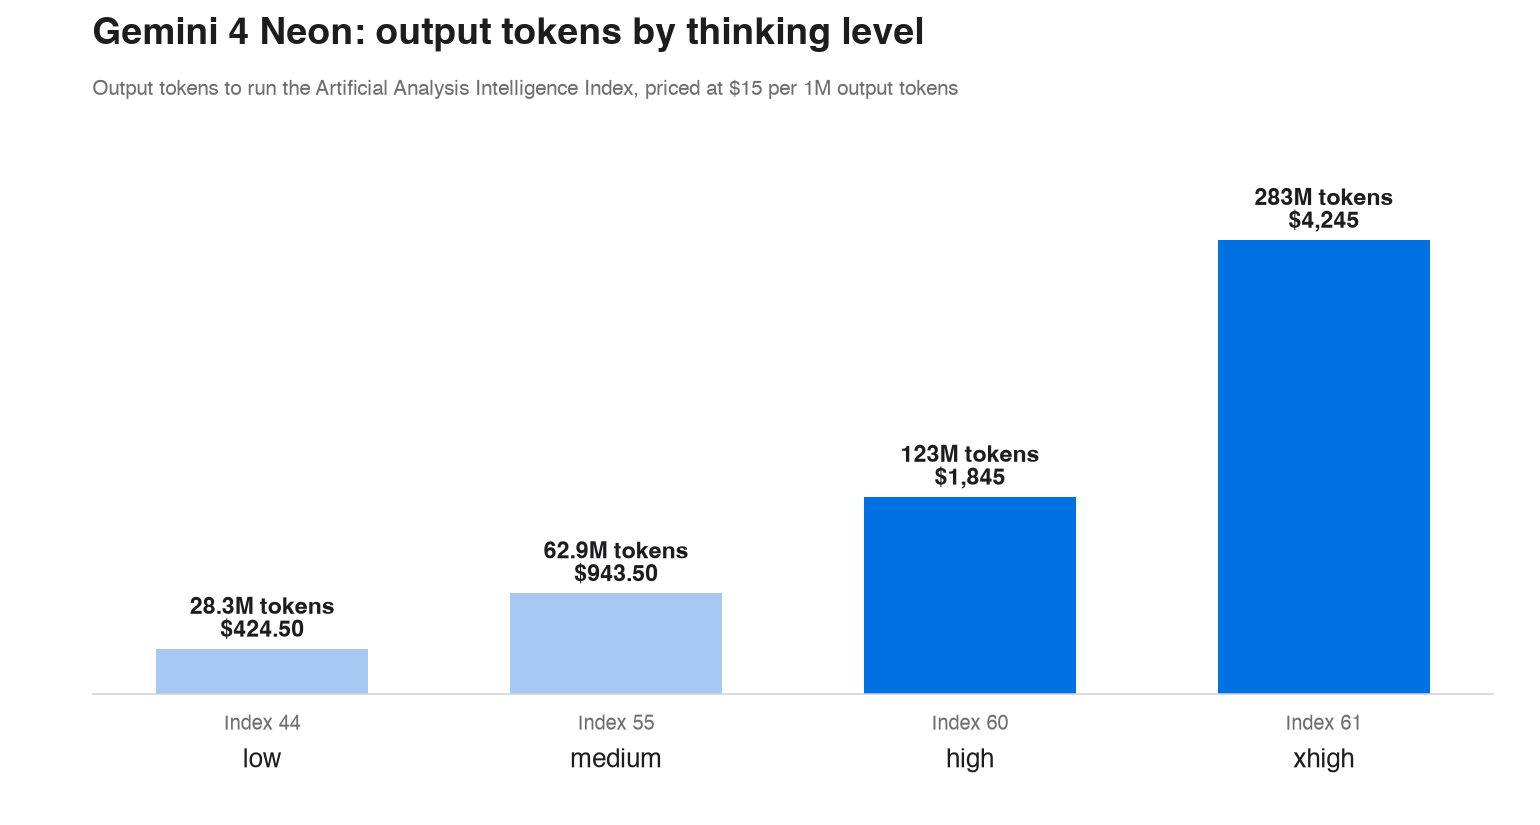
A Artificial Analysis executou seu Intelligence Index em todos os níveis e publicou os tokens de saída que cada execução usou. Multiplique pela taxa de saída Standard de US$ 15 e você obtém o custo de saída da execução completa:
| Nível de pensamento | Intelligence Index | Tokens de saída | Custo de saída a $15/1M | Tempo por tarefa |
|---|---|---|---|---|
| low | 44 | 28.3M | $424.50 | 3.7 min |
| medium | 55 | 62.9M | $943.50 | 8.3 min |
| high | 60 | 123M | $1,845 | 14.8 min |
| xhigh | 61 | 283M | $4,245 | 21.5 min |
Duas coisas chamam a atenção. Ir de high para xhigh compra um ponto no índice por 2,3x os tokens de saída. E o medium entrega a maior parte da pontuação do high por cerca da metade dos tokens. A Artificial Analysis coloca o custo de destaque do Neon em US$ 6,44 por tarefa de índice no xhigh.
A regra prática: comece seus testes no medium, mova uma tarefa para o high somente quando puder demonstrar que ela falha no medium, e reserve o xhigh para o problema raro em que um ponto extra de qualidade vale mais que o dobro do custo.
Quanto custa uma chamada do Gemini 4 Neon?
Aqui estão três formatos comuns de solicitação, precificados na camada Standard. Os números de saída incluem tokens de pensamento.
1. Uma chamada de revisão de código. 20.000 tokens de entrada (o diff mais o contexto), 3.000 tokens de saída:
- Entrada: 20.000 × $3 / 1M = $0.060
- Saída: 3.000 × $15 / 1M = $0.045
- Total: $0.105 por chamada, ou $0.0525 no Batch
Execute 1.000 delas por dia durante 30 dias e você gasta US$ 3.150 por mês na Standard, ou US$ 1.575 se as revisões puderem esperar pelo Batch.
2. Um loop de agente com um prefixo em cache. Dez turnos, cada um enviando o mesmo prompt de sistema de 50.000 tokens e lista de ferramentas, mais 5.000 novos tokens de entrada e 2.000 tokens de saída:
- Com um acerto de cache no prefixo: 50.000 × $0.15 / 1M + 5.000 × $3 / 1M + 2.000 × $15 / 1M = $0.0525 por turno, $0.53 pelo loop
- Sem acerto de cache: 55.000 × $3 / 1M + 2.000 × $15 / 1M = $0.195 por turno, $1.95 pelo loop
Essa é uma diferença de 73% só pelo cache. Como o cache do Neon é implícito, você não pode forçar o acerto; você aumenta as chances dele mantendo a parte estável do prompt no início e byte a byte idêntica entre os turnos.
3. Uma pergunta sobre documento longo. 800.000 tokens de entrada (uma base de código grande ou um conjunto de contratos) e 4.000 tokens de saída:
- Entrada: 800.000 × $3 / 1M = $2.40
- Saída: 4.000 × $15 / 1M = $0.06
- Total: $2.46, ou $1.23 no Batch
O Neon não tem sobretaxa de contexto longo na página de preços, então o token 900.000 custa o mesmo que o token 1. A janela de contexto é de 1.048.576 tokens compartilhados entre entrada e saída, e uma única solicitação síncrona retorna até 65.536 tokens de saída por padrão.
Como a precificação do Neon se compara com Hydrogen e Carbon?
O Neon custa exatamente o dobro do Hydrogen por token. A comparação com o Carbon muda em 1º de dezembro, quando a taxa introdutória do Carbon termina:
| Modelo | Entrada / 1M | Saída / 1M | Chamada de revisão de código (20K in, 3K out) | Camada gratuita |
|---|---|---|---|---|
| Gemini 4 Hydrogen | $1.50 | $7.50 | $0.0525 | Sim |
| Gemini 4 Neon | $3.00 | $15.00 | $0.105 | Não |
| Gemini 4 Carbon, até 30 de nov | $2.00 | $10.00 | $0.070 | Não |
| Gemini 4 Carbon, a partir de 1º de dez | $4.00 | $20.00 | $0.140 | Não |
Por mais onze dias, o Carbon é mais barato por token que o Neon. Se você constrói sobre os $2/$10 do Carbon hoje, orce $4/$20 em dezembro. Nosso detalhamento de preços do Gemini 4 Carbon cobre essa mudança em detalhes.
A partir de 1º de dezembro, o Neon fica no meio: 25% abaixo do Carbon, 2x o Hydrogen por token. Por tarefa, a diferença depende dos tokens de pensamento, então meça o custo por solicitação nos seus próprios prompts em vez de comparar tabelas de preços.
Roteie por dificuldade: Hydrogen para chamadas cotidianas de alto volume, Neon para codificação e análise complexas que você executa com frequência, e Carbon para os problemas únicos mais difíceis.
Como reduzir sua fatura do Gemini 4 Neon?
Cinco alavancas, na ordem em que costumam compensar:
- Abaixe o nível de pensamento. O
mediumusa cerca da metade dos tokens de saída dohighnas execuções da Artificial Analysis. - Envie o trabalho que pode esperar para o Batch ou Flex. Tudo que ninguém lê em tempo real custa metade.
- Molde os prompts para o cache implícito. Mantenha os prompts de sistema e as definições de ferramentas no topo e inalterados, para que prefixos repetidos sejam cobrados a $0.15 em vez de $3.
- Limite a saída. Defina uma contagem máxima de tokens de saída que caiba na tarefa.
- Roteie chamadas fáceis para o Hydrogen. Reserve o Neon para o trabalho que realmente precisa dele.
Consulte a página de limites de taxa da API Gemini da sua camada antes de planejar o throughput.
Meça seu custo real do Gemini 4 Neon com o Apidog CLI
Toda resposta da API Interactions do Google traz um objeto usage com contagens de tokens de entrada, cache, pensamento e saída. Esse bloco, vezes a tabela de preços acima, é o seu custo real por solicitação. Executar os mesmos prompts em cada nível de pensamento e compará-los é um trabalho repetitivo, então delegue-o ao seu agente de codificação.
O Apidog CLI dá ao Claude Code, Codex, Cursor ou OpenCode uma forma de linha de comando para criar e executar testes de API. Configure-o uma vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # escolha seu agente quando solicitado
Em seguida, dê ao seu agente um único prompt:
In Apidog project <id>, create an environment for the Gemini API with
GEMINI_API_KEY and THINKING_LEVEL variables. Add a test case for
POST /v1beta/interactions with model gemini-4-neon and
generation_config.thinking_level set from THINKING_LEVEL. Send our code review
prompt, assert HTTP 200 and non-empty output, and save usage.total_input_tokens,
total_cached_tokens, total_thought_tokens and total_output_tokens. Run it at
low, medium and high, then compute the Standard cost of each run at $3 input,
$0.15 cached and $15 per 1M for thought and output tokens.
O agente cria o ambiente, valida o payload do caso de teste contra o schema e então o executa uma vez por nível:
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> --env-var "THINKING_LEVEL=low" -r cli,json
apidog run --test-case <caseId> --project <id> -e <envId> --env-var "THINKING_LEVEL=medium" -r cli,json
apidog run --test-case <caseId> --project <id> -e <envId> --env-var "THINKING_LEVEL=high" -r cli,json
Os relatórios JSON dão ao seu agente as contagens de tokens para precificar, para que você obtenha uma tabela de custo por nível para os seus próprios prompts. Adicione apidog run ... -r junit ao CI com o guia de CI/CD do Apidog CLI para detectar uma mudança de prompt que dobre seus tokens de pensamento, ou comece pelo Apidog CLI no Claude Code. O plano gratuito do Apidog cobre até 4 usuários.
FAQ
O Gemini 4 Neon é gratuito? Não pela API. A página de preços do Google lista o Neon como não disponível na camada gratuita, então você precisa de um projeto pago da API Gemini. O Hydrogen é o modelo Gemini 4 com camada gratuita.
Os tokens de pensamento são cobrados separadamente? Não. São cobrados como tokens de saída, a US$ 15 por 1M na Standard. O objeto usage da API Interactions os reporta como total_thought_tokens, para que você possa ver quanto de cada fatura é raciocínio.
O Gemini 4 Neon custa mais acima de 200K tokens? Não. A página de preços mostra uma taxa de entrada e uma de saída para o Neon, sem camada de contexto longo, em toda a janela de 1.048.576 tokens.
Quanto mais barato é o Batch? Exatamente metade: US$ 1,50 por 1M de entrada e US$ 7,50 por 1M de saída, com entrada em cache a US$ 0,075. O Flex tem as mesmas taxas.
O Neon é mais barato que o Carbon? Não até 1º de dezembro. Os $2/$10 introdutórios do Carbon valem até 30 de novembro, depois sobem para $4/$20, o que coloca os $3/$15 do Neon cerca de 25% abaixo do Carbon por token.