
O cache de contexto do Gemini 4 Neon é apenas implícito. Você não cria um cache. O Google faz o cache de prefixos de prompt repetidos com pelo menos 4.096 tokens por conta própria e cobra esses tokens de entrada em cache a US$ 0,15 por 1 milhão em vez de US$ 3, um desconto de 95%. Você obtém esse benefício mantendo a parte estável de cada solicitação no início e idêntica byte a byte, e depois confirmando os acertos em usage.total_cached_tokens.
Abaixo: layout do prompt para acertos de cache, a regra do loop de agente, como ler a contagem de tokens em cache e um teste que seu agente de codificação executa para você.
Como funciona o cache de contexto do Gemini 4 Neon?
O cache de contexto do Gemini 4 Neon é um cache de prefixo automático. Quando uma nova solicitação começa com os mesmos tokens de uma recente, e esse prefixo compartilhado tem pelo menos 4.096 tokens, o Google serve a parte repetida do cache e a cobra pela taxa de cache. Não há nada para ativar, nem objeto de cache, TTL ou taxa de armazenamento para gerenciar.
O Google lançou o Neon em 18 de novembro de 2026 (ID do modelo gemini-4-neon, veja o post de lançamento). Os fatos sobre o cache dele cabem em uma tabela:
| Item | Gemini 4 Neon |
|---|---|
| Modo de cache | Apenas implícito, ativado por padrão |
Cache explícito (cachedContents, caches.create) |
Não suportado |
| Prefixo mínimo para um acerto de cache | 4.096 tokens |
| Entrada padrão | US$ 3,00 por 1 milhão de tokens |
| Entrada em cache (Padrão) | US$ 0,15 por 1 milhão de tokens |
| Entrada em cache (Batch e Flex) | US$ 0,075 por 1 milhão de tokens |
| Entrada em cache (Priority) | US$ 0,27 por 1 milhão de tokens |
| Onde ver os acertos | usage.total_cached_tokens |
| Camada gratuita | Nenhuma, apenas camada paga |
O desconto é de 95% em todas as camadas: US$ 0,15 é 5% de US$ 3, US$ 0,075 é 5% de US$ 1,50 e US$ 0,27 é 5% de US$ 5,40. Os tokens de saída, incluindo os tokens de raciocínio (thinking), permanecem a US$ 15 por 1 milhão na camada Standard. O cache afeta apenas a entrada.
Cache implícito vs. cache explícito no Gemini 4 Neon
Se você usava cache explícito no Gemini 2.5 ou 3, esta é a mudança que quebra o código. As notas de migração do Neon do Google dizem claramente: o Gemini 4 Neon “não suporta cache explícito (cachedContents e caches.create)”, e você deve “remover os campos cached_content das solicitações”.
A documentação de cache acrescenta que a Interactions API só suporta cache implícito, e o cache explícito não está disponível para nenhum modelo Gemini 4. Os caches explícitos ainda funcionam nos modelos Gemini 3 e 2.5 suportados por meio do generateContent.
O que isso significa para uma migração:
- Exclua o código que chama
caches.createe armazena um nome de cache. - Remova
cached_contentde todos os corpos de solicitação. - Pare de pagar pelo armazenamento de cache que você não usa mais.
- Reestruture os prompts para que o conteúdo que você costumava colocar em cache explicitamente fique no início de cada solicitação.
Você não pode fixar um documento nem escolher um TTL, e um acerto não é garantido. Mas você pode aumentar muito as chances.
Como estruturar prompts para acertar o cache do Gemini 4 Neon?
Um acerto de cache exige um prefixo longo e idêntico enviado novamente em breve. A documentação do Google dá duas dicas: coloque o conteúdo grande e comum no início do seu prompt e envie solicitações com um prefixo semelhante em um curto intervalo de tempo.
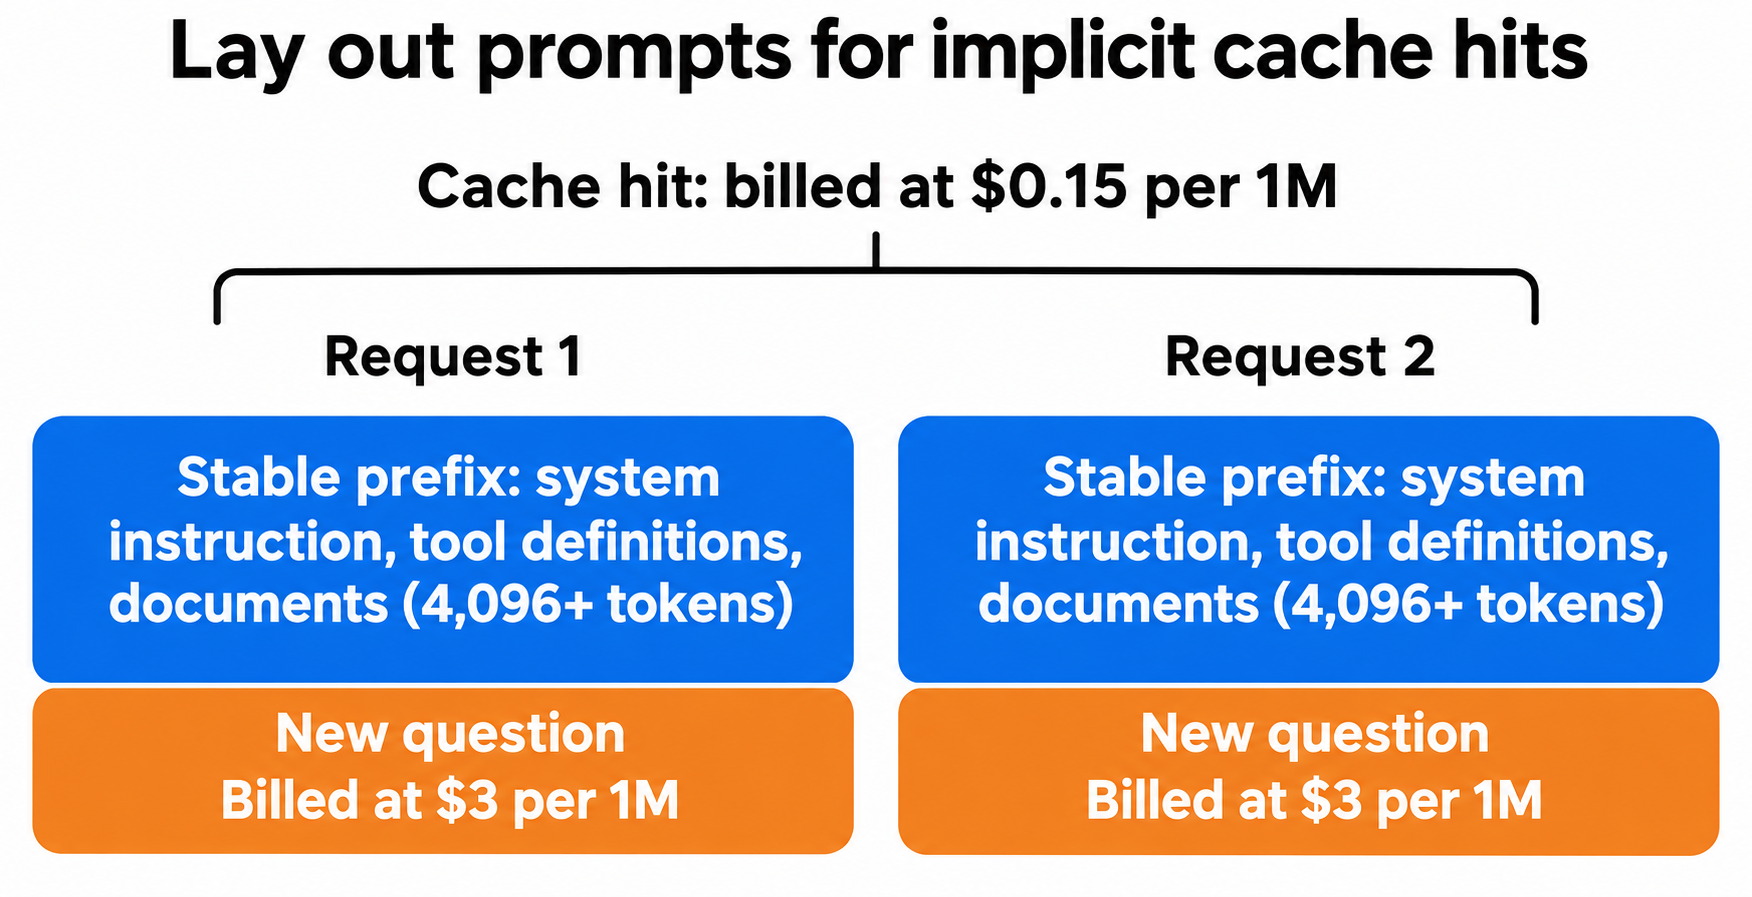
Organize cada solicitação assim:
- Instrução de sistema. Texto fixo, sem timestamps, sem nomes de usuário, sem IDs de solicitação.
- Declarações de ferramentas e funções. A mesma lista, na mesma ordem, com as mesmas descrições sempre.
- Documentos compartilhados. O código-base, o contrato, a especificação da API, o arquivo longo de políticas.
- A parte que muda. A pergunta do usuário, o resultado mais recente da ferramenta, a data de hoje.
A maneira mais comum de errar o cache é um pequeno valor dinâmico perto do topo. Uma linha como Current time: 2026-11-19T09:14:02Z na instrução de sistema muda o prefixo em cada chamada, então nada depois dela pode corresponder. Mova-a para o final, depois dos documentos.
Outros quebradores de prefixo: listas de ferramentas construídas em ordem aleatória, documentos re-serializados com espaços em branco diferentes e chunks recuperados retornados em uma ordem diferente.
Mantenha o prefixo acima de 4.096 tokens. Um prompt de sistema de 2.000 tokens sozinho não se qualifica. Se você enviar um documento compartilhado longo junto com ele, o prefixo combinado se qualifica.
Com a Interactions API, passe a instrução estável em system_instruction e coloque os documentos primeiro em input:
from google import genai

client = genai.Client()  # reads GEMINI_API_KEY

SYSTEM = open("review_rules.md").read()      # fixed text
CODEBASE = open("repo_snapshot.txt").read()  # ~200K tokens, unchanged

def ask(question: str):
    interaction = client.interactions.create(
        model="gemini-4-neon",
        system_instruction=SYSTEM,
        input=CODEBASE + "\n\nQuestion: " + question,
    )
    print("cached tokens:", interaction.usage.total_cached_tokens)
    return interaction

ask("Where do we validate JWT expiry?")
ask("Which handlers skip input validation?")
A primeira chamada preenche o cache. Se a segunda imprimir 0 tokens em cache, algo no prefixo mudou.
O cache implícito funciona nos dois modos de conversa. Chamadas sem estado, como a acima, se qualificam, e sessões com estado encadeadas com previous_interaction_id também. Para os formatos completos de solicitação, consulte nosso guia da API do Gemini 4 Neon.
Como o cache funciona em loops de agente: a regra dos 2.050 tokens
Os loops de agente são onde o cache compensa mais, porque cada turno reenvia todo o histórico. Os modelos Gemini 4 adicionam uma regra que você precisa conhecer. Da documentação de cache do Google: “O Gemini faz o cache da solicitação anterior completa apenas se a nova solicitação adicionar pelo menos 2.050 tokens”. A saída do modelo, os pensamentos e os resultados de funções contam para esse total.
Se um turno adiciona menos de 2.050 tokens, o Gemini reprocessa os últimos 2.050 tokens da solicitação anterior pela taxa de entrada padrão. A parte anterior do prefixo ainda pode ter acerto, mas essa parte final é cobrada a US$ 3 por 1 milhão.
O Google observa que a maioria dos turnos de agente excede o limite. Isso dói em loops muito comunicativos com etapas minúsculas, como uma verificação de status que retorna {"ok": true}. O custo é pequeno por turno (2.050 tokens a US$ 3 por 1 milhão são cerca de US$ 0,006), mas se acumula ao longo de milhares de turnos curtos. Se o seu loop faz muitas chamadas minúsculas, agrupe pequenos resultados de ferramentas em um único turno sempre que sua lógica permitir.
Quanto o cache de contexto do Gemini 4 Neon economiza?
Considere um assistente de revisão de código que responde a 20 perguntas sobre um código-base de 200.000 tokens. Cada pergunta adiciona 3.000 tokens e recebe uma resposta de 1.000 tokens, na camada Standard.
Sem acertos de cache, cada chamada custa:
- Entrada: 203.000 × US$ 3 / 1 milhão = US$ 0,609
- Saída: 1.000 × US$ 15 / 1 milhão = US$ 0,015
- Por chamada: US$ 0,624, ou seja, US$ 12,48 para 20 chamadas
Com acertos de cache após a primeira chamada, as chamadas de 2 a 20 custam:
- Prefixo em cache: 200.000 × US$ 0,15 / 1 milhão = US$ 0,030
- Entrada nova: 3.000 × US$ 3 / 1 milhão = US$ 0,009
- Saída: US$ 0,015
- Por chamada: US$ 0,054
Somando a primeira chamada, sem cache, de US$ 0,624, a sessão custa US$ 1,65, cerca de 87% menos.
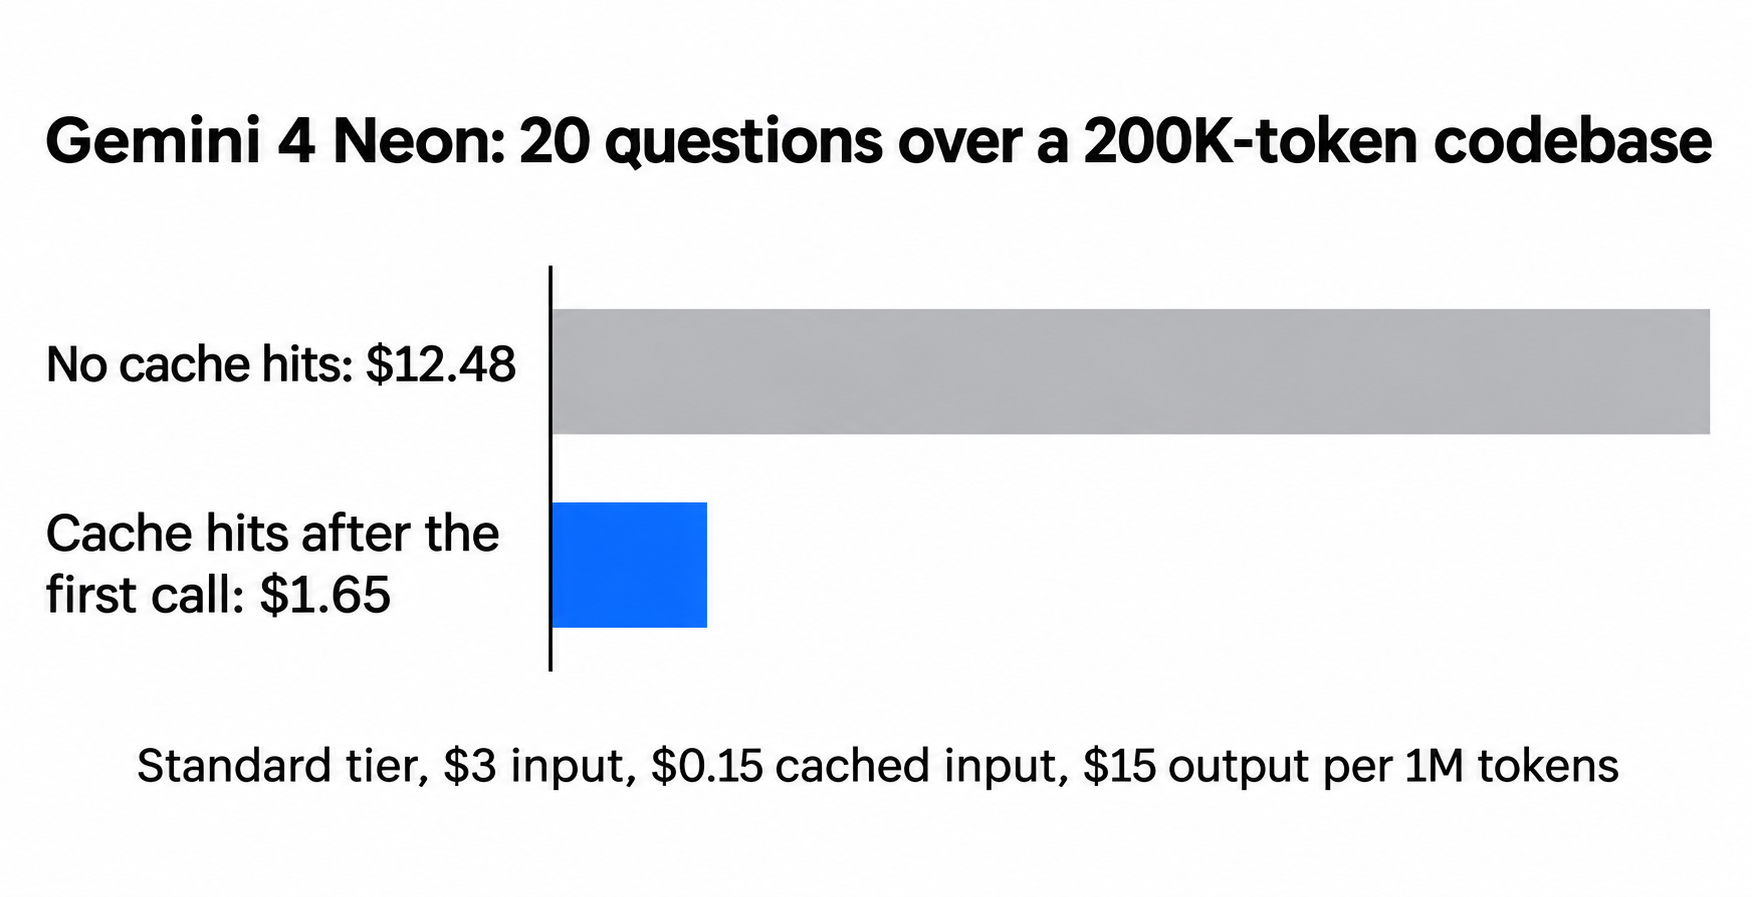
A economia fica abaixo de 95% porque a saída e a entrada nova nunca recebem o desconto. Quanto maior o prefixo compartilhado em relação ao resto, mais perto você chega de 95% na entrada. Execute o mesmo trabalho via Batch e a taxa de cache cai pela metade novamente, para US$ 0,075. Para a tabela completa de preços e os custos por nível de raciocínio, veja preços do Gemini 4 Neon.
Como verificar os tokens em cache do Gemini 4 Neon na resposta?
Leia usage.total_cached_tokens em cada resposta. O Google documenta esse campo como o que mostra quantos tokens foram acertos de cache, tanto no SDK Python quanto no JavaScript.
Com curl e jq:
curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d @request.json | jq '.usage'
Para precificar uma chamada, cobre os tokens em cache a US$ 0,15 por 1 milhão, o resto da sua entrada a US$ 3 e a saída mais raciocínio a US$ 15. Registre a contagem de cache junto com o ID da sua solicitação. Uma queda repentina para 0 em todo o tráfego geralmente significa que um deploy mudou o prefixo: uma nova ferramenta, uma regra reformulada ou um timestamp que entrou na instrução de sistema.
Deixe seu agente de codificação testar acertos de cache com o Apidog CLI
Os prefixos quebram durante refatorações comuns, e ninguém percebe até a conta chegar. Transforme a verificação de cache em um teste de API que seu agente de codificação mantém e o CI executa.
O Apidog CLI permite que Claude Code, Codex, Cursor ou OpenCode criem e executem testes de API no terminal. Configure-o uma vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Depois, dê ao seu agente um único prompt:
In Apidog project <id>, create an environment for the Gemini API with a
GEMINI_API_KEY variable. Build a test scenario called "Neon cache hit" with two
steps that POST to /v1beta/interactions with model gemini-4-neon, using our
production system_instruction and the docs/context.md file as the start of
input, then two different questions. Assert HTTP 200 on both, and assert that
usage.total_cached_tokens on step 2 is greater than 4096. Run it and tell me
the cached token count.
O agente cria o ambiente e o cenário, verifica seu payload contra o schema do CLI e executa:
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog test-scenario create --project <id> --name "Neon cache hit"
apidog cli-schema get test-scenario-update
apidog cli-schema validate test-scenario-update --file scenario.json
apidog test-scenario update <scenarioId> --project <id> --file scenario.json
apidog run -t <scenarioId> --project <id> -e <envId> -r cli,json
Se alguém adicionar um timestamp ao prompt de sistema no próximo mês, a asserção da etapa 2 falha antes da mudança ir para produção. Coloque apidog run -t <scenarioId> --project <id> -e <envId> -r junit no seu pipeline com o guia de CI/CD do Apidog CLI, ou comece pelo Apidog CLI no Claude Code. Cada execução faz duas chamadas reais ao Neon, então custa alguns centavos por execução nas taxas acima. O plano Free do Apidog cobre até 4 usuários.
Para entender como o cache de prefixo funciona entre provedores, veja o que é cache de prompt.
FAQ
O Gemini 4 Neon suporta cache de contexto explícito? Não. O guia do Neon do Google diz que ele não suporta cachedContents nem caches.create, e que você deve remover cached_content das solicitações. O Neon usa apenas cache implícito, que vem ativado por padrão.
Qual é o tamanho mínimo de prompt para um acerto de cache no Gemini 4 Neon? 4.096 tokens de prefixo compartilhado. É o mesmo mínimo do Gemini 4 Hydrogen, Argon e Carbon. O Gemini 2.5 Flash e Pro exigem 2.048.
Qual é o tamanho do desconto de cache do Gemini 4 Neon? 95% na entrada em cache. A camada Standard cai de US$ 3 para US$ 0,15 por 1 milhão de tokens, Batch e Flex de US$ 1,50 para US$ 0,075, e Priority de US$ 5,40 para US$ 0,27. Os tokens de saída e raciocínio não recebem desconto.
Posso forçar o Gemini 4 Neon a colocar um prompt em cache? Não. O cache implícito não tem nenhuma configuração para ativar, nenhum TTL para escolher e nenhum acerto garantido. Você aumenta as chances mantendo um prefixo longo e idêntico no início de cada solicitação e enviando solicitações semelhantes em sequência próxima.
Como sei se minha solicitação teve acerto de cache? Verifique usage.total_cached_tokens na resposta. Um valor acima de zero significa que aquela quantidade de tokens de entrada foi cobrada pela taxa de cache.
O cache funciona com previous_interaction_id? Sim. A documentação do Google diz que o cache implícito funciona tanto em conversas com estado encadeadas com previous_interaction_id quanto em conversas sem estado, em que você mesmo envia o histórico completo.