
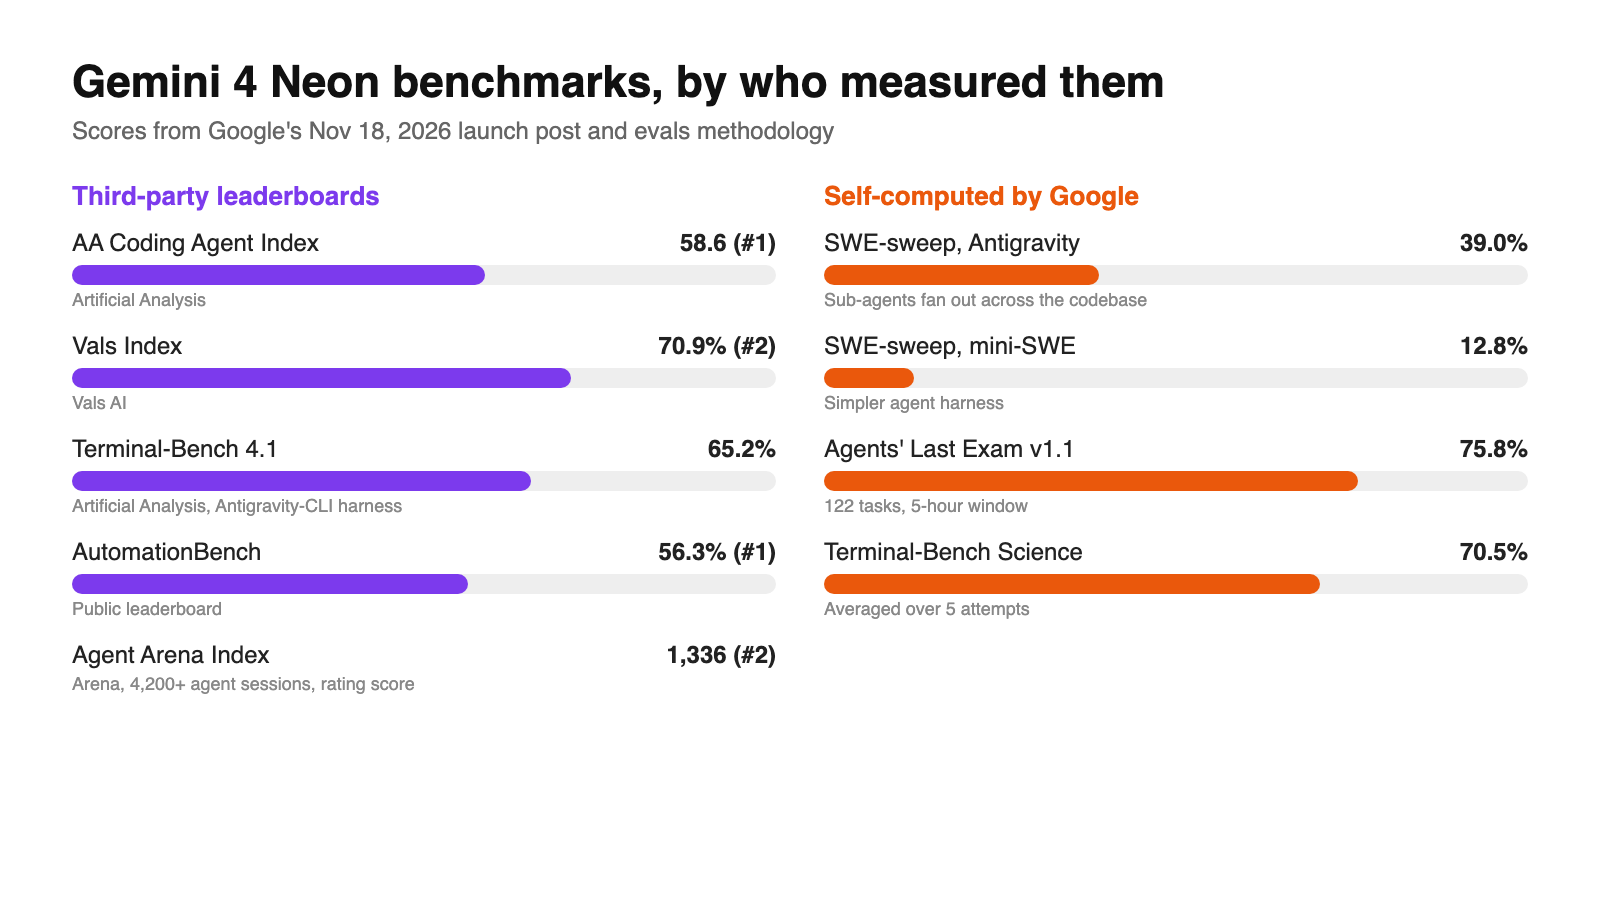
Os benchmarks do Gemini 4 Neon o colocam em #1 no Artificial Analysis Coding Agent Index (58,6), com 65,2% no Terminal-Bench 4.1 e #2 no Vals Index (70,9%). O Google também afirma que ele custa 32% menos por tarefa que o Gemini 4 Carbon em seu nível de raciocínio padrão high. A maioria das linhas, porém, foi executada em xhigh, e algumas no próprio harness do Google.
É esse último detalhe o ponto central deste post. Nossa visão geral do Gemini 4 Neon cobre especificações e preços. Aqui você encontra cada pontuação publicada, quem a mediu, em qual nível de raciocínio e como transformar “custo por tarefa” em um número que você possa conferir com sua própria fatura.
Benchmarks do Gemini 4 Neon em resumo
O Gemini 4 Neon é o modelo intermediário da linha Gemini 4 do Google, lançado em 18 de novembro de 2026, com preço de US$ 3 por milhão de tokens de entrada e US$ 15 por milhão de tokens de saída. Seus resultados publicados mais fortes estão em codificação agêntica e trabalho de conhecimento, onde ocupa o #1 ou #2 em quatro leaderboards independentes.
Estas são as linhas de destaque do post de lançamento do Google:
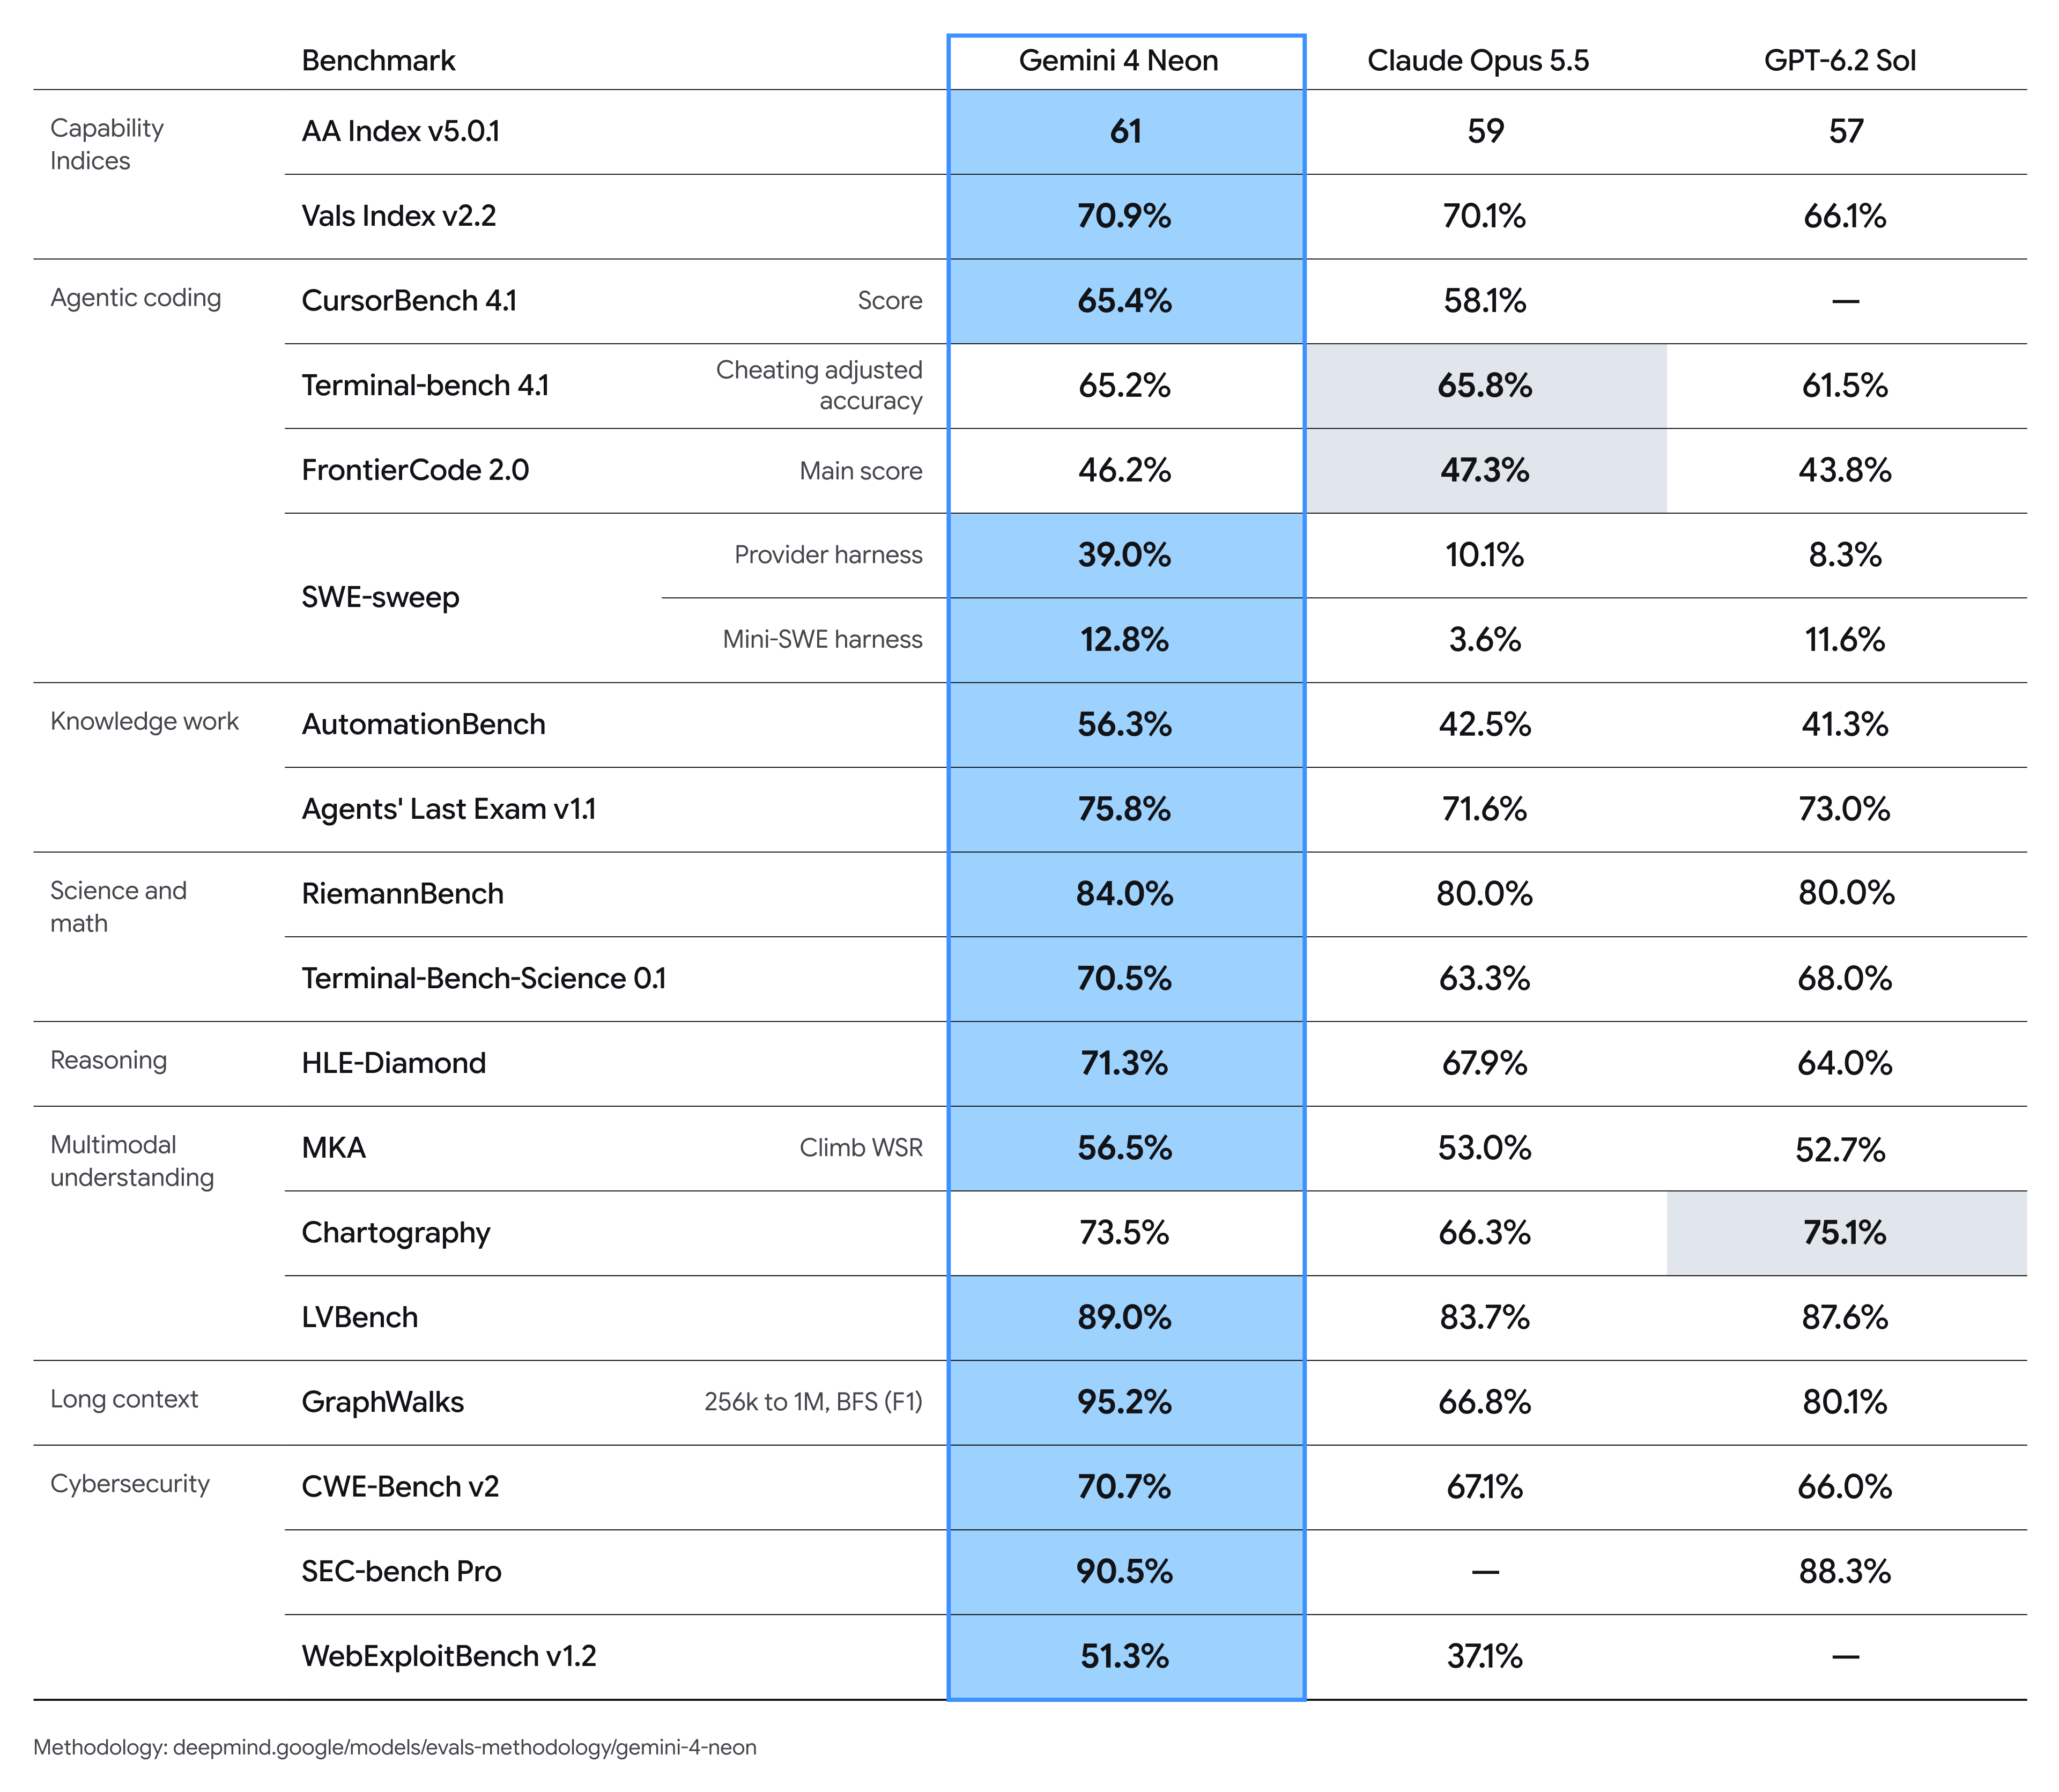
O Google também relata #1 no Legal Research Bench e no Tax Agent Bench da Vals AI.
Benchmarks de codificação do Gemini 4 Neon
A codificação é onde o argumento do Neon é mais forte, e também onde o harness mais importa. O PDF de metodologia de avaliação do Google explica como cada linha de codificação foi produzida.
Artificial Analysis Coding Agent Index: 58,6, #1. Trata-se de um composto independente, portanto é a linha menos influenciada pela configuração do Google. Você pode conferir a classificação atual no Artificial Analysis.
Terminal-Bench 4.1: 65,2%. A Artificial Analysis executou o Neon usando o harness público Antigravity-CLI, versão 1.5.9. As pontuações dos outros modelos vêm do leaderboard oficial, e todo resultado usa precisão ajustada para trapaça. É justo, mas o Neon rodou dentro do próprio ferramental de agente do Google.
FrontierCode 2.0: 46,2%. Este vem do leaderboard público e foi executado com high, o padrão que você obtém em produção. Se você só confiar em um número de codificação para o tráfego do dia a dia, confie neste.
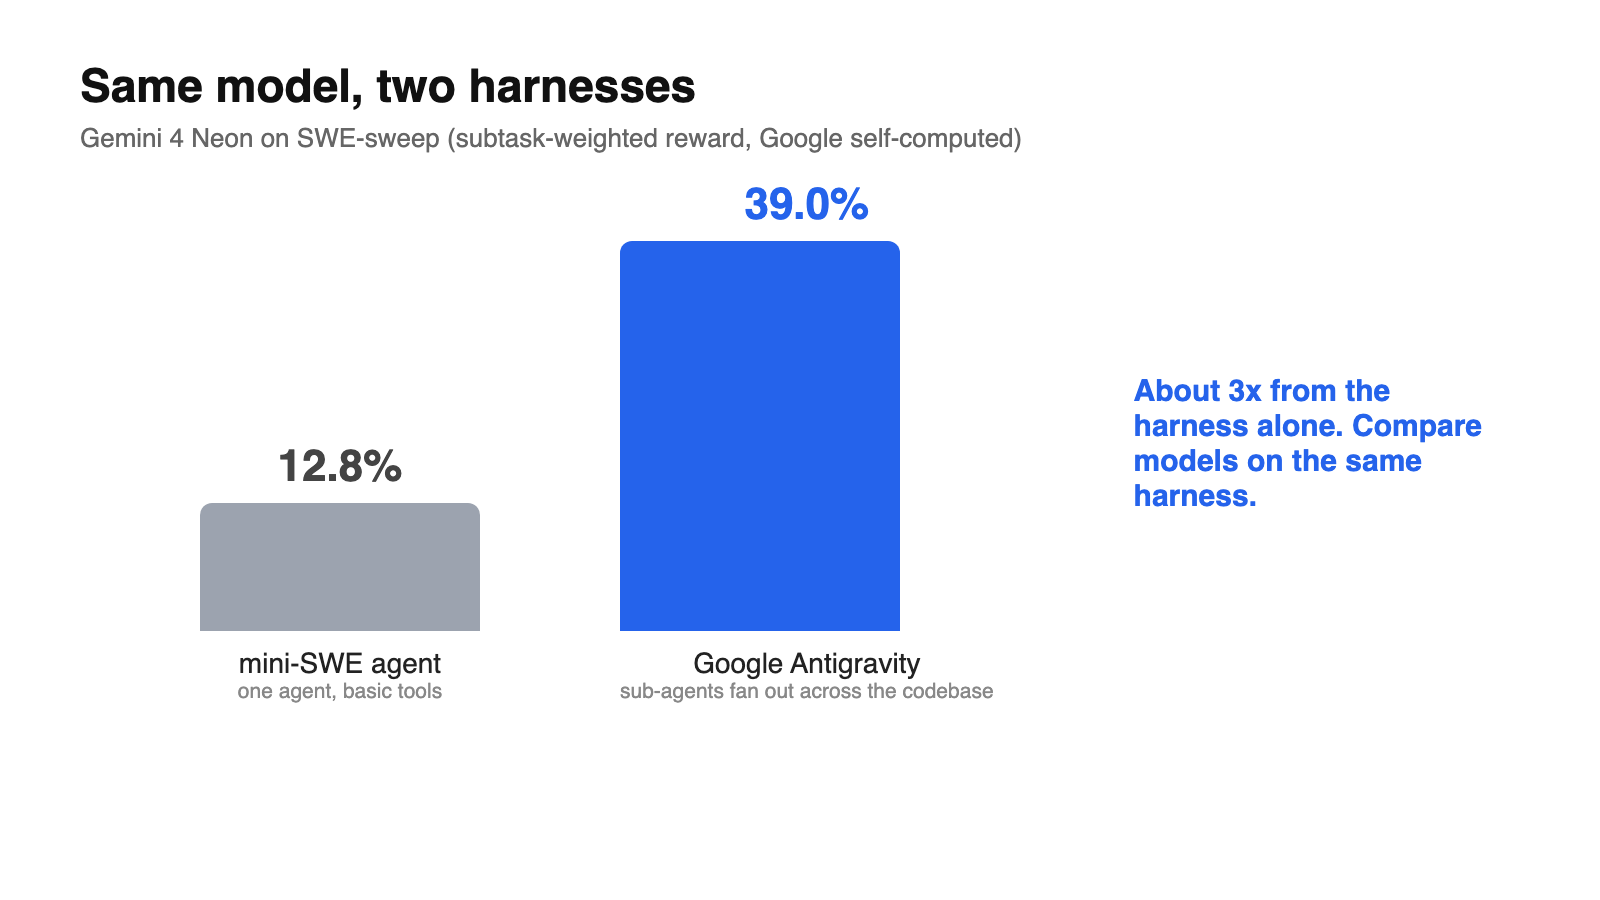
SWE-sweep: 39,0% no Antigravity, 12,8% no mini-SWE. Ambos são calculados internamente pelo Google. O salto de 3x vem do harness: o Google observa que o Antigravity-CLI inclui uma ferramenta padrão que distribui subagentes pelo código-fonte, o que favorece tarefas de busca de bugs. O Opus 5.5 rodou no Claude Code e o GPT-6.2 Sol no Codex para a mesma comparação. Leia 12,8% como o modelo e 39,0% como o modelo mais seu melhor ferramental.
Benchmarks de agente e trabalho de conhecimento
Essas linhas importam se você planeja executar o Neon sem supervisão em muitas etapas.
- Agent Arena Index: 1.336, #2. Construído a partir de mais de 4.200 sessões reais de agentes. O Google também afirma que o Neon ocupa o #2 ali em capacidade de direcionamento, o que significa que ele se adapta bem quando um usuário o corrige no meio da tarefa.
- AutomationBench: 56,3%, #1. O benchmark da Zapier para automação de negócios, proveniente do leaderboard público.
- Vending-Bench 2: US$ 16.843, #1. Simulação de longo horizonte do Andon Labs para administrar um negócio. A pontuação é dinheiro ganho, não uma porcentagem.
- Agents’ Last Exam v1.1: 75,8%. Calculado internamente no conjunto de 122 tarefas dentro do Antigravity-CLI 1.4.8, com uma janela de 5 horas por execução. A pontuação do Opus 5.5 vem do leaderboard público, e a do GPT-6.2 Sol vem do seu system card, então as configurações diferem.
- Chartography: 73,5%. Leitura de gráficos profissionais densos, calculado internamente sem ferramentas.
Em ciências e matemática, o Neon registra 70,5% no Terminal-Bench Science (calculado internamente, média de 5 tentativas), 84,0% no RiemannBench e 71,3% no HLE-Diamond (do leaderboard da Artificial Analysis).
Como o Google obteve os números
Quatro regras da metodologia mudam a forma como você deve ler a tabela:
- Nível de raciocínio mais alto por padrão. “Todos os resultados são executados com a Gemini API com as configurações de raciocínio mais altas, salvo indicação em contrário.” Isso é
xhigh. Apenas o FrontierCode 2.0 está explicitamente marcado comohigh. As chamadas de produção usamhighpor padrão, então espere menos tokens de raciocínio e possivelmente pontuações menores do que as mostradas na tabela. - Pass@1, tentativa única. Sem votação por maioria ou computação paralela em tempo de teste, exceto onde indicado (o Terminal-Bench Science faz média de 5 tentativas).
- Números dos concorrentes são autorrelatados. As pontuações de modelos não-Gemini vêm de cada fornecedor, salvo indicação contrária. Opus 5.5 e GPT-6.2 Sol usam sua configuração máxima de raciocínio quando disponível.
- Filtros de segurança ativados, exceto em cibersegurança. As linhas de cibersegurança foram executadas com os filtros desativados.
Nosso guia de níveis de raciocínio aborda quando o xhigh vale os tokens extras.
Custo por tarefa: o que significa a alegação de 32%
Custo por tarefa é o gasto total para concluir uma tarefa de benchmark, não o preço por token. Um modelo com preço por token mais alto ainda pode custar menos por tarefa se chegar à resposta em menos etapas e com menos tokens de raciocínio.
O Google faz três alegações de custo:
| Alegação | Nível de raciocínio | Comparado com |
|---|---|---|
| Custo por tarefa 32% menor, com pontuação alta no AA Intelligence Index | high |
Gemini 4 Carbon |
| Aproximadamente 50% a 80% menos custo por tarefa no Vals Index e no Agent Arena | high |
Principais modelos de fronteira concorrentes |
| Mais de 36% de redução no custo por tarefa | xhigh |
Modelos concorrentes em sua configuração máxima |
Note a disparidade: as linhas de precisão usam majoritariamente xhigh, enquanto a economia de 32% do título é com high. Ambas são verdadeiras, mas não ao mesmo tempo. Você obtém a economia de custo ou a pontuação máxima, e a diferença entre elas é sua para medir.
Veja como estimar seu próprio custo por tarefa. Os tokens de raciocínio são cobrados como saída.
$$\text{cost} = \frac{\text{input} \times 3 + \text{cached input} \times 0.15 + \text{output} \times 15}{1{,}000{,}000}$$
Uma tarefa de codificação com 20.000 tokens de entrada e 4.000 tokens de saída custa US$ 0,06 + US$ 0,06 = US$ 0,12. Se 15.000 desses tokens de entrada atingirem o cache, cai para US$ 0,015 + US$ 0,00225 + US$ 0,06 = cerca de US$ 0,077. Execute a mesma tarefa com xhigh e a contagem de saída é o que muda, então registre os tokens por nível, não apenas aprovação ou reprovação. Nosso detalhamento de preços do Gemini 4 Neon cobre as tarifas Batch, Flex e Priority.
Linhas de cibersegurança e segurança
As pontuações de cibersegurança vêm do “Gemini 4 Neon for cyber”, que é disponibilizado a defensores confiáveis por meio do Fairwind Program, e não pela API pública.
| Benchmark | Pontuação | Observação |
|---|---|---|
| SEC-bench Pro | 90,5% | Estado da arte, cerca de metade do custo por desafio |
| WebExploitBench v1.2 | 51,26% | Estado da arte, metade do custo dos modelos grandes |
| AutoBaxBench (nível hard) | 76% | Estado da arte, código mais seguro que o Carbon em todos os níveis |
| CWE-bench v2 | 70,7% | Ganho de 3,4% sobre o Carbon |
| ExploitGym | Não divulgado | Nível de fronteira usando metade dos tokens do Carbon |
Números de segurança do mesmo post: o Neon recusou 1,98% das tarefas do Terminal-Bench 4.0, obteve 0,0% de trapaça no Terminal-Bench 4.0, tomou atalhos em 2,45% da avaliação de trapaça em codificação do Google e passou em 99,2% de sua avaliação de honestidade de agente. Com salvaguardas em tempo real em seu nível de raciocínio mais alto, resistiu a todos os ataques no benchmark de injeção indireta de prompt do Gray Swan.
Onde o Neon não lidera
O Neon não é o primeiro em tudo, e o próprio Google admite:
- Artificial Analysis Intelligence Index: #3 no geral, “logo atrás de modelos maiores e mais lentos”.
- Vals Index: #2, não #1.
- Agent Arena Index: #2.
O Google também continua indicando o Carbon para seus projetos de longo horizonte mais difíceis. Se você está escolhendo entre os três modelos Gemini 4, nossa comparação Neon vs Carbon vs Hydrogen mapeia os trade-offs, e o post de benchmarks do Gemini 4 Argon mostra como a tabela do modelo anterior se lê.
Faça você mesmo o benchmark do Gemini 4 Neon com o Apidog CLI
Os leaderboards descrevem o harness do Google, não o seu produto. A maneira mais rápida de saber se o Neon vale o preço é deixar seu agente de codificação executar os mesmos prompts com high e xhigh e registrar tokens e latência para cada um.
Não há nível gratuito de API para o Neon, então você precisa de uma chave paga da Gemini API. Esta requisição segue o formato documentado da Interactions API do Google; não a executamos ao vivo para este post:
curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "gemini-4-neon", "input": "Find the race condition in this retry queue.", "generation_config": {"thinking_level": "high"}}'
O Apidog CLI permite que Claude Code, Codex, Cursor ou OpenCode criem e executem testes de API a partir do terminal. Configure-o uma vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Depois, passe um prompt para seu agente:
In Apidog project <id>, create a Gemini API environment with GEMINI_API_KEY
and THINKING variables. Add a test case for POST /v1beta/interactions on
gemini-4-neon that sends my 10 eval prompts from prompts.csv, asserts HTTP 200
and a non-empty output, and records token usage and response time. Run it at
THINKING=high and THINKING=xhigh and compare cost per task at $3/$15 per 1M.
O agente cria o ambiente, verifica o payload do caso de teste em relação ao seu schema e, em seguida, executa-o uma vez por nível de raciocínio:
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv --env-var "THINKING=high" -r cli,json
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv --env-var "THINKING=xhigh" -r cli,json
Adicione --timeout-request 900000 se seus prompts forem longos, já que execuções difíceis com xhigh podem levar minutos. Para repetir a comparação a cada alteração de prompt, coloque o mesmo apidog run ... -r junit no CI com o guia de CI/CD do Apidog CLI, ou comece pelo Apidog CLI no Claude Code. O plano Free do Apidog cobre até 4 usuários.
Perguntas frequentes
Qual é o melhor resultado de benchmark do Gemini 4 Neon? #1 no Artificial Analysis Coding Agent Index com 58,6, além de #1 no AutomationBench (56,3%) e no Vending-Bench 2 (US$ 16.843).
Em qual nível de raciocínio os benchmarks foram executados? Majoritariamente em xhigh, a configuração mais alta. A metodologia do Google diz que os resultados usam as configurações de raciocínio mais altas, salvo indicação contrária; o FrontierCode 2.0 (46,2%) está marcado como o padrão high.
O Gemini 4 Neon é mais barato que o Carbon por tarefa? O Google afirma 32% menos custo por tarefa com high. Esse é um número por tarefa proveniente de execuções de benchmark, então confirme com seus próprios prompts antes de migrar o tráfego.
Por que o Neon pontua 39,0% e 12,8% no SWE-sweep? Harnesses diferentes. 39,0% é dentro do Google Antigravity, que distribui subagentes pelo código-fonte; 12,8% é o agente mini-SWE, mais simples.
Os benchmarks do Gemini 4 Neon são independentes? Em parte. As linhas do Artificial Analysis, Vals, Arena, AutomationBench e FrontierCode vêm de terceiros. SWE-sweep, Agents’ Last Exam e Terminal-Bench Science são calculados internamente pelo Google.