A API do Gemini 4 Neon usa o ID de modelo gemini-4-neon. Você a chama com um POST para https://generativelanguage.googleapis.com/v1beta/interactions, com sua chave no cabeçalho x-goog-api-key e model mais input no corpo JSON. Ela funciona apenas na camada paga, a US$ 3 por milhão de tokens de entrada e US$ 15 por milhão de tokens de saída, e usa por padrão o nível de raciocínio high.
Este guia cobre o que há de diferente no Neon: a configuração da camada paga, a migração a partir de outro modelo Gemini 4, saídas com mais de 64K tokens, o uso do Neon em conjunto com o Hydrogen e o controle dos custos. Todos os nomes de campos vêm da documentação do Google.
O que você precisa antes da sua primeira chamada à API do Gemini 4 Neon?
Você precisa de uma chave da API Gemini em um projeto com faturamento ativo, do ID de modelo gemini-4-neon e do endpoint Interactions. O Google lançou o Neon em 18 de novembro de 2026, como o modelo intermediário da família Gemini 4, entre o Hydrogen e o Carbon.
| Item | Valor |
|---|---|
| ID de modelo | gemini-4-neon |
| Endpoint | POST /v1beta/interactions em generativelanguage.googleapis.com |
| Cabeçalho de autenticação | x-goog-api-key: $GEMINI_API_KEY |
| APIs | API Interactions e generateContent |
| Níveis de raciocínio | low, medium, high (padrão), xhigh |
| Janela de contexto | 1.048.576 tokens, compartilhados entre entrada, raciocínio e saída |
| Saída por etapa síncrona | 65.536 tokens |
| Decodificação longa | Até 1.048.576 tokens menos a sua entrada |
| Camada gratuita | Não |
| Preço na camada paga | US$ 3,00 / 1M de entrada, US$ 15,00 / 1M de saída (raciocínio incluído) |
| Entrada em cache | US$ 0,15 / 1M via cache implícito |
Para PDFs, chamadas de função e streaming, os formatos de requisição são os mesmos do nosso guia da API Gemini 4 Hydrogen; basta trocar o ID do modelo.
Como obter uma chave da API Gemini que funcione com o Neon?
O Neon não está disponível na camada gratuita, então a chave sozinha não basta. O projeto por trás dela precisa ter faturamento configurado.
- Abra a página de chaves de API no Google AI Studio e crie uma chave, ou reutilize uma que você já tenha.
- Verifique se o projeto da chave está na camada paga. O guia do Google diz claramente: “O Neon está disponível apenas na camada paga (não na camada gratuita).”
- Exporte a chave:
export GEMINI_API_KEY="YOUR_API_KEY". Os SDKs do Google GenAI leem-na automaticamente. - Confira seus limites de taxa da camada paga na página de limites de taxa antes de planejar um lote grande. [VERIFICAR: números de RPM e TPM do Neon por camada]
Como enviar sua primeira requisição à API do Gemini 4 Neon?
Envie model e input para o endpoint Interactions. Este é o formato do quickstart do Google:
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Review this Go handler for missing error checks and suggest fixes."
  }'
A mesma chamada com o SDK Python (pip install -U google-genai):
from google import genai

client = genai.Client()  # reads GEMINI_API_KEY

interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Review this Go handler for missing error checks and suggest fixes.",
)

print(interaction.output_text)
print(interaction.usage)
Leia o campo usage em todas as respostas enquanto você testa: os tokens de raciocínio são cobrados à taxa de saída de US$ 15, então a quantidade de raciocínio é onde seu custo se concentra.
Esses trechos seguem o guia do Google. Não os executamos para este post, então confira o formato da resposta na sua primeira chamada.
O que muda quando você migra do Hydrogen ou do Carbon?
Se você já usa outro modelo Gemini 4, a migração não exige mudanças no esquema da requisição. Altere a string model e verifique três coisas:
| Verificação | Neon | Hydrogen | Carbon e Argon |
|---|---|---|---|
| Nível de raciocínio padrão | high |
high |
medium |
| Nível máximo | xhigh |
xhigh |
high |
| Entrada / saída por 1M | US$ 3 / US$ 15 | US$ 1,50 / US$ 7,50 | Veja preços do Carbon |
Se você vem do Carbon ou do Argon, a mudança padrão de medium para high significa mais tokens de raciocínio no mesmo prompt. Defina thinking_level explicitamente se quiser manter o comportamento anterior:
interaction = client.interactions.create(
    model="gemini-4-neon",
    input="Audit this payment retry queue for race conditions.",
    generation_config={"thinking_level": "medium"},
)
Se você vem do Gemini 3.8 Flash ou mais antigo, a lista é mais longa. De acordo com o checklist de migração do Google:
- Aumente limites baixos de saída.
max_output_tokenscobre raciocínio e resposta juntos. Remova limites fixos como 8.192, ou eleve-os para 65.536, e reduza o nível de raciocínio se precisar gastar menos. - Remova
minimal. O Neon rejeita esse valor com um erro. - Remova parâmetros de amostragem. O servidor ignora valores dentro do intervalo de
temperature,top_petop_k; valores fora do intervalo retornam um400. - Abandone o cache explícito. O Neon não oferece suporte a
cachedContentsnem acaches.create, então remova os camposcached_content. - Declare ferramentas nativamente. Solicitar chamadas de ferramenta em JSON bruto sem ferramentas declaradas pode retornar
MALFORMED_FUNCTION_CALL. Use chamadas de função ou saídas estruturadas.
Como obter mais de 64K tokens do Neon?
Uma requisição síncrona para em 65.536 tokens, com streaming ou sem. Para saídas mais longas, como uma especificação completa de migração mais sua suíte de testes, defina background como true e aumente max_output_tokens acima de 65.536. Os servidores do Google continuam gerando em etapas de 64K tokens até atingirem seu limite.
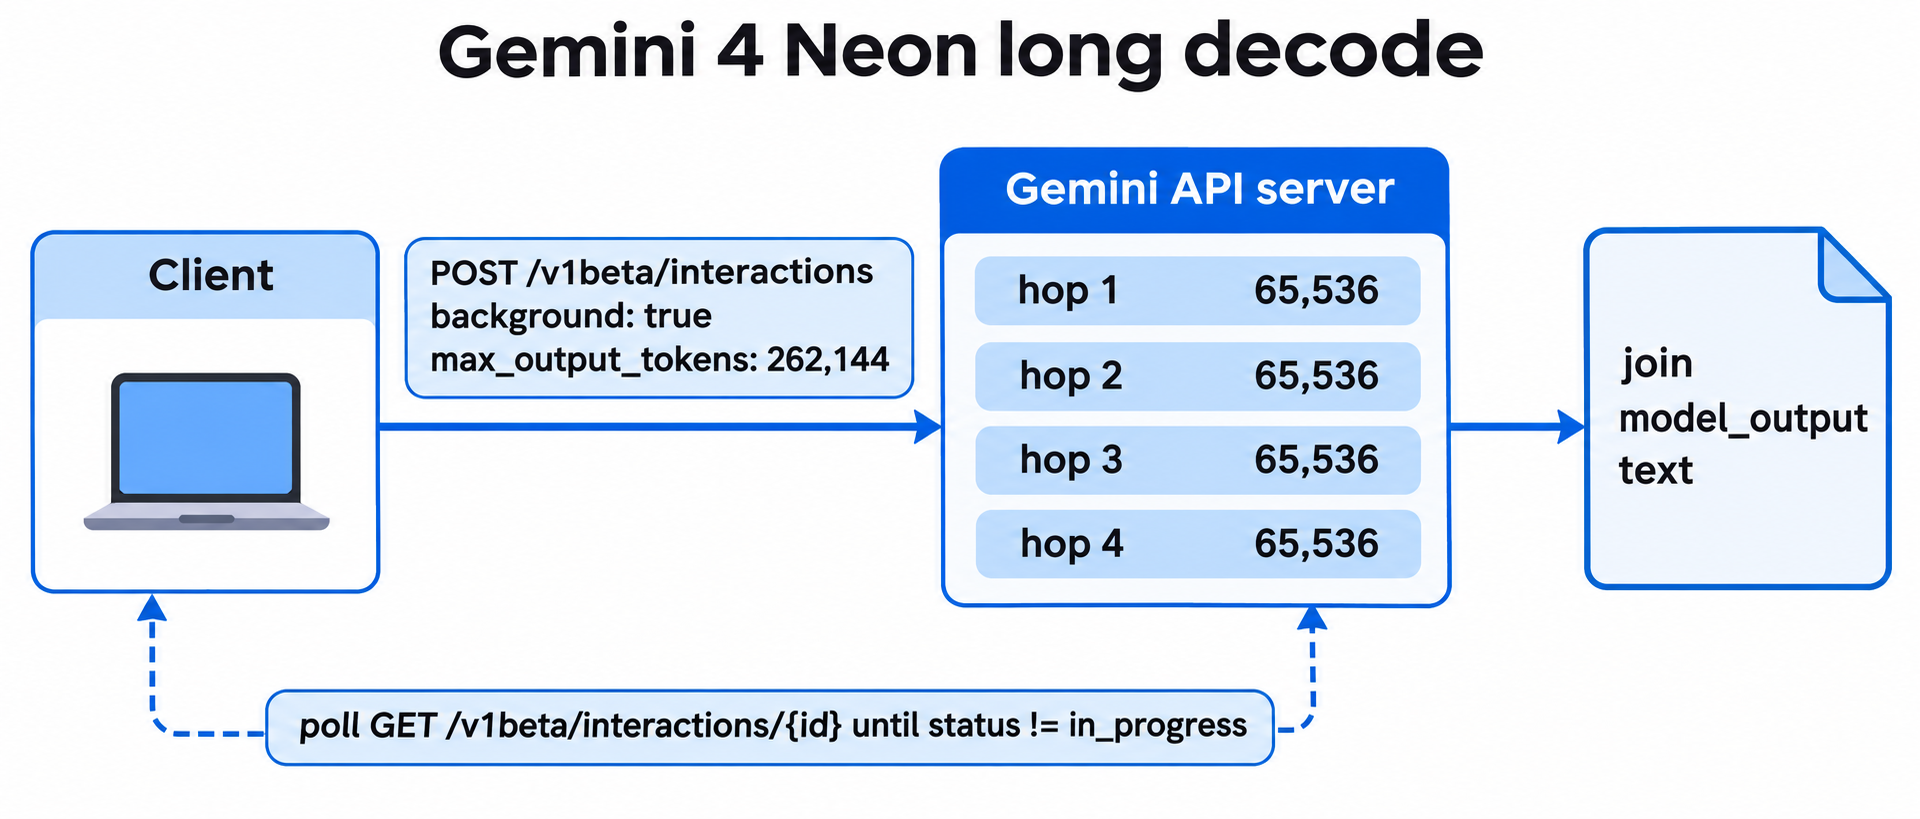
Inicie o trabalho e guarde seu id:
export ID=$(curl -s -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gemini-4-neon",
    "input": "Generate a complete multi-module migration specification and test suite for this service.",
    "background": true,
    "generation_config": {
      "max_output_tokens": 262144,
      "thinking_level": "high"
    }
  }' | jq -r '.id')
Depois, faça polling até que termine e junte o texto de cada etapa (Python, com o ID que você exportou):
import os, time

interaction = client.interactions.get(id=os.environ["ID"])
while interaction.status in ("in_progress", "queued"):
    time.sleep(5)
    interaction = client.interactions.get(id=interaction.id)

text = "".join(
    c.text
    for step in interaction.steps if step.type == "model_output"
    for c in step.content if c.type == "text"
)
Três regras do guia do Google evitam problemas:
- Se você definir
backgroundsemmax_output_tokens, o servidor para em 65.536 tokens. - O limite pode chegar a 1.048.576 menos seus tokens de entrada. O Google sugere 131.072 ou 262.144 para trabalhos longos e de várias etapas.
- Prompts complexos podem levar vários minutos. Use o modo em segundo plano, ou defina os timeouts do cliente HTTP para pelo menos 15 minutos.
Se preferir não armazenar interações do lado do Google, o guia de decodificação longa também documenta a continuação no lado do cliente nos SDKs mais recentes.
Como combinar o Neon com o Hydrogen?
Use o Neon para o julgamento e o Hydrogen para o volume. O Neon planeja ou revisa um fluxo de trabalho, e então você passa o id da sua interação como previous_interaction_id para uma chamada ao gemini-4-hydrogen que executa uma única etapa. O guia para desenvolvedores do Cloud do Google mostra o padrão:
plan = client.interactions.create(
    model="gemini-4-neon",
    input="Design a 3-step plan to migrate our REST order service to gRPC in Go.",
    store=True,
)

step = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Implement step 1 (.proto service definition) from the plan.",
    previous_interaction_id=plan.id,
)
print(step.output_text)
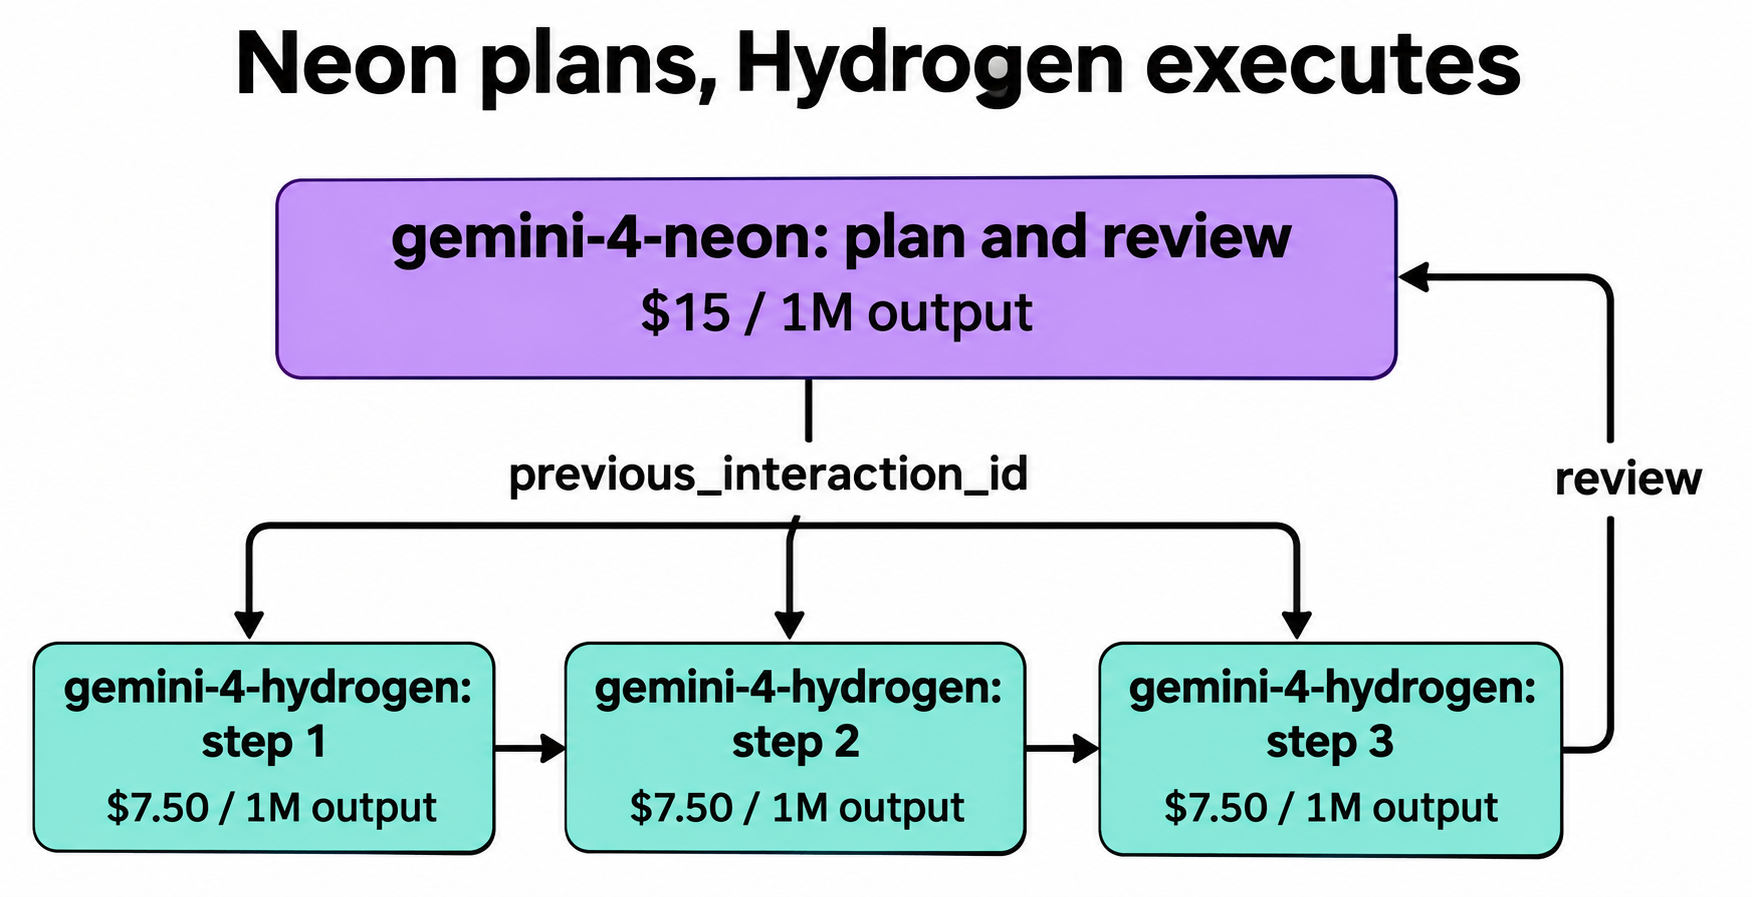
Cada token de saída que o Hydrogen escreve em vez do Neon custa metade do preço. Nosso guia do orquestrador Gemini 4 Hydrogen percorre o mesmo loop com o Carbon como planejador.
Como reduzir os custos da API do Gemini 4 Neon?
Quatro alavancas, na ordem em que costumam compensar:
- Escolha o menor nível de raciocínio que passe nos seus testes. A recomendação do Google é rodar suas avaliações nos quatro níveis com um
max_output_tokensalto e, depois, escolher o menorthinking_levelque atinja seu padrão de qualidade. - Reutilize prompts longos. O cache implícito funciona por padrão em prompts de pelo menos 4.096 tokens e reduz a entrada em cache em 95%, de US$ 3,00 para US$ 0,15 por milhão. Mantenha a parte longa e estável do seu prompt (texto de sistema, documentação, schemas) no início.
- Delegue a execução ao Hydrogen. Veja o padrão de combinação acima.
- Conte tudo. O Google cobra por cada token que o modelo processa, incluindo tokens de raciocínio e as instruções internas adicionadas quando você usa grounding. O grounding com o Google Search também é cobrado por consulta.
Uma verificação rápida: uma chamada com 20.000 tokens de entrada e 8.000 tokens de saída (raciocínio incluído) custa US$ 0,06 de entrada e US$ 0,12 de saída, ou seja, US$ 0,18 pelo preço de tabela.
Deixe seu agente de código comparar o Neon e o Hydrogen com o Apidog CLI
O Neon vale o dobro do preço do Hydrogen nos seus prompts? Deixe seu agente de código (Claude Code, Codex, Cursor) criar um caso de teste e executá-lo nos dois modelos com o Apidog CLI.
Configure uma vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Depois, dê ao seu agente um único prompt:
In Apidog project <projectId>, create an environment "gemini" with base URL
https://generativelanguage.googleapis.com and variables GEMINI_API_KEY,
MODEL (default "gemini-4-hydrogen") and THINKING (default "high"). Add an
endpoint for POST /v1beta/interactions with the x-goog-api-key header from
GEMINI_API_KEY. Create a test case that sends model {{MODEL}}, our code-review
prompt and generation_config.thinking_level {{THINKING}}, and asserts: HTTP 200,
status is "completed", a non-empty model_output step, and usage.total_tokens
exists. Run it for gemini-4-hydrogen and gemini-4-neon, then compare
usage.total_thought_tokens and usage.total_output_tokens.
O agente lê o schema de cada payload e valida o JSON antes de escrever qualquer coisa:
apidog environment create gemini --project <projectId> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> --env-var "MODEL=gemini-4-hydrogen" -r cli,json
apidog run --test-case <caseId> --project <projectId> -e <envId> --env-var "MODEL=gemini-4-neon" -r cli,json
Multiplique os tokens de cada execução pelo preço do modelo e você terá o custo real por tarefa do seu prompt, e não uma média de post de lançamento. Adicione --upload-report para visualizar a execução no app Apidog, ou troque -r cli,json por -r junit para colocar a mesma verificação no CI. O guia de CI/CD do Apidog CLI mostra o pipeline, e o Apidog CLI no Claude Code cobre a configuração do agente. O plano gratuito do Apidog cobre até 4 usuários.
FAQ
Qual é o ID de modelo do Gemini 4 Neon? gemini-4-neon. Funciona tanto com a API Interactions quanto com generateContent.
A API do Gemini 4 Neon é gratuita? Não. O Neon está disponível apenas na camada paga da API Gemini, a US$ 3 por milhão de tokens de entrada e US$ 15 por milhão de tokens de saída. Assinantes do Google AI Pro e Ultra podem experimentá-lo no chat do AI Studio.
Meu código do Hydrogen funciona com o Neon? Sim. O Google afirma que a troca entre modelos Gemini 4 não exige mudanças no esquema da requisição. Atualize a string model e decida se deseja o nível de raciocínio padrão high.
Qual é a saída máxima da API do Gemini 4 Neon? 65.536 tokens por requisição síncrona. Com background definido como true e um max_output_tokens maior, o Neon pode gerar até a janela de 1.048.576 tokens menos a sua entrada.
O Gemini 4 Neon suporta temperature? Não. O servidor ignora valores dentro do intervalo de temperature, top_p e top_k e retorna um 400 para valores fora dele. Use thinking_level para trocar qualidade por velocidade e custo.
O Neon suporta cache de contexto explícito? Não. Remova cached_content das suas requisições. O cache implícito ainda se aplica automaticamente a prompts de 4.096 tokens ou mais, com 95% de desconto na entrada em cache.