
O Gemini 4 Hydrogen custa US$ 1,50 por 1M de tokens de entrada e US$ 7,50 por 1M de tokens de saída no nível pago Standard da API Gemini, um preço fixo em toda a janela de contexto de 1M de tokens. Tokens de thinking são cobrados na tarifa de saída, a entrada em cache custa US$ 0,075 por 1M, e Batch ou Flex reduzem todas as tarifas pela metade.
O Hydrogen, lançado em 12 de novembro de 2026, é o membro rápido da família Gemini 4. Diferente do Carbon e do Argon, ele não tem um preço introdutório que dobra depois, e está disponível no nível Free. Abaixo: a tabela de preços, exemplos de custo calculados, como os níveis de thinking afetam sua fatura e como medir o seu próprio custo. Novo no modelo? Comece com o que é o Gemini 4 Hydrogen.
Quanto custa o Gemini 4 Hydrogen por 1M de tokens?
O Gemini 4 Hydrogen (ID do modelo gemini-4-hydrogen) tem quatro níveis pagos na página de preços do Google. Todos os preços são por 1M de tokens:
| Nível | Entrada | Saída incl. thinking | Entrada em cache | Nível gratuito |
|---|---|---|---|---|
| Standard | US$ 1,50 | US$ 7,50 | US$ 0,075 | Gratuito |
| Batch | US$ 0,75 | US$ 3,75 | US$ 0,0375 | Indisponível |
| Flex | US$ 0,75 | US$ 3,75 | US$ 0,0375 | Indisponível |
| Priority | US$ 2,70 | US$ 13,50 | US$ 0,135 | Consulte a página de preços |
Três detalhes na mesma página impactam seu orçamento:
- Thinking é cobrado. “Cada token processado pelo modelo é contabilizado e cobrado, incluindo os tokens de thinking.”
- Apenas cache implícito. O cache explícito não é suportado; você obtém a tarifa de cache quando o cache implícito do Google identifica um prefixo de prompt repetido.
- Grounding custa extra. O grounding com o Google Search inclui 5.000 solicitações gratuitas por mês; depois, US$ 14 por 1.000.
O uso no nível gratuito está marcado como “Usado para melhorar nossos produtos: Sim” na página. Nosso guia do Gemini 4 Hydrogen gratuito detalha todas as rotas com custo zero.
O que significa “preço fixo até 1M de tokens”?
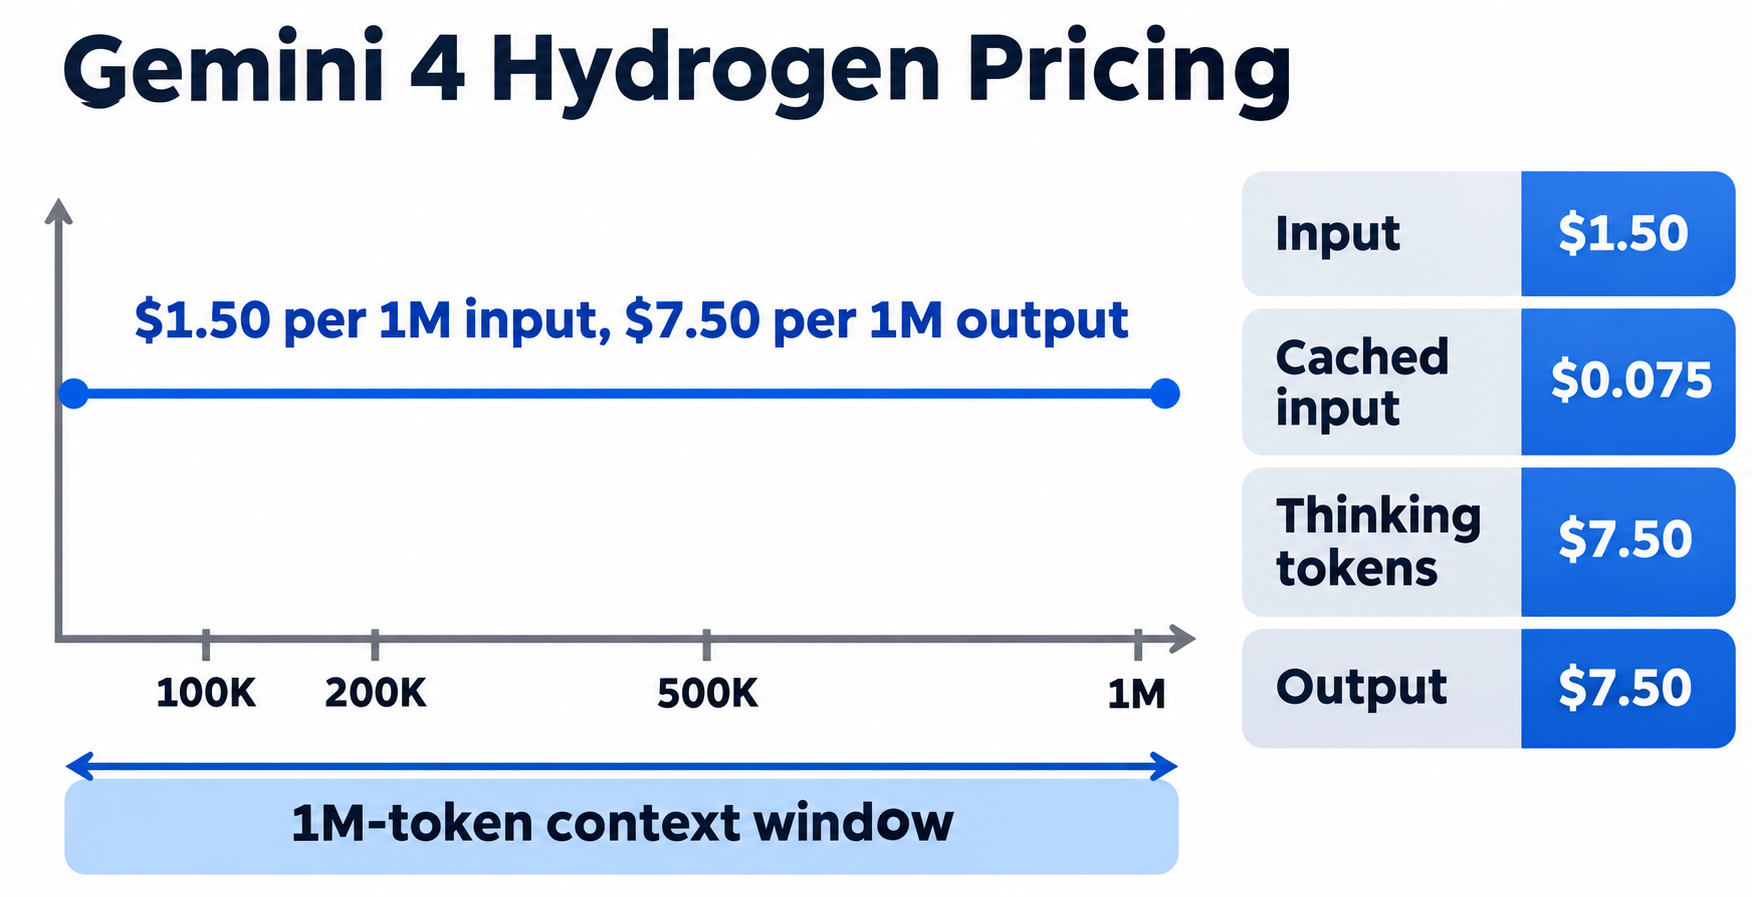
Significa um único preço para qualquer tamanho de prompt. O post de lançamento do Google afirma que o Hydrogen “é cobrado com preço fixo em toda a sua janela de contexto de 1 milhão de tokens, a US$ 1,50 por milhão de tokens de entrada e US$ 7,50 por milhão de tokens de saída”. Um prompt de 5K tokens e um de 900K tokens são cobrados pela mesma tarifa por token.
Nem todo modelo Gemini funciona assim: o Gemini 3.1 Pro Preview cobra US$ 2,00/US$ 12,00 por 1M até 200K tokens e US$ 4,00/US$ 18,00 acima disso.
Dois números deixam isso concreto:
- Um prompt de 900K tokens (uma base de código grande ou uma pilha de PDFs) custa US$ 1,35 de entrada no Standard, ou US$ 0,0675 quando o cache implícito é acionado.
- A janela de contexto é unificada: entrada, thinking e saída compartilham 1.048.576 tokens. Um prompt de 900K deixa cerca de 148K tokens para thinking e resposta combinados.
As respostas síncronas têm limite de 65.536 tokens. Saídas mais longas rodam via long decode, ainda a US$ 7,50 por 1M.
Como os níveis de thinking afetam sua fatura do Gemini 4 Hydrogen?
O Hydrogen oferece quatro níveis de thinking: low, medium, high (o padrão) e um novo xhigh. Você o define com generation_config.thinking_level. O preço por token nunca muda; o que muda é a quantidade de tokens de thinking, e eles são cobrados na tarifa de saída.
A Artificial Analysis executou seu Intelligence Index em cada nível. Veja o que ela relatou:
| Nível de thinking | Pontuação no índice | Tokens gerados no índice | Custo por tarefa do índice |
|---|---|---|---|
| low | 27 | 20,3M | US$ 0,29 |
| medium | 41 | 54,4M | US$ 0,80 |
| high (padrão) | 51 | 110M | US$ 1,87 |
| xhigh | 54 | 304M | US$ 3,16 |
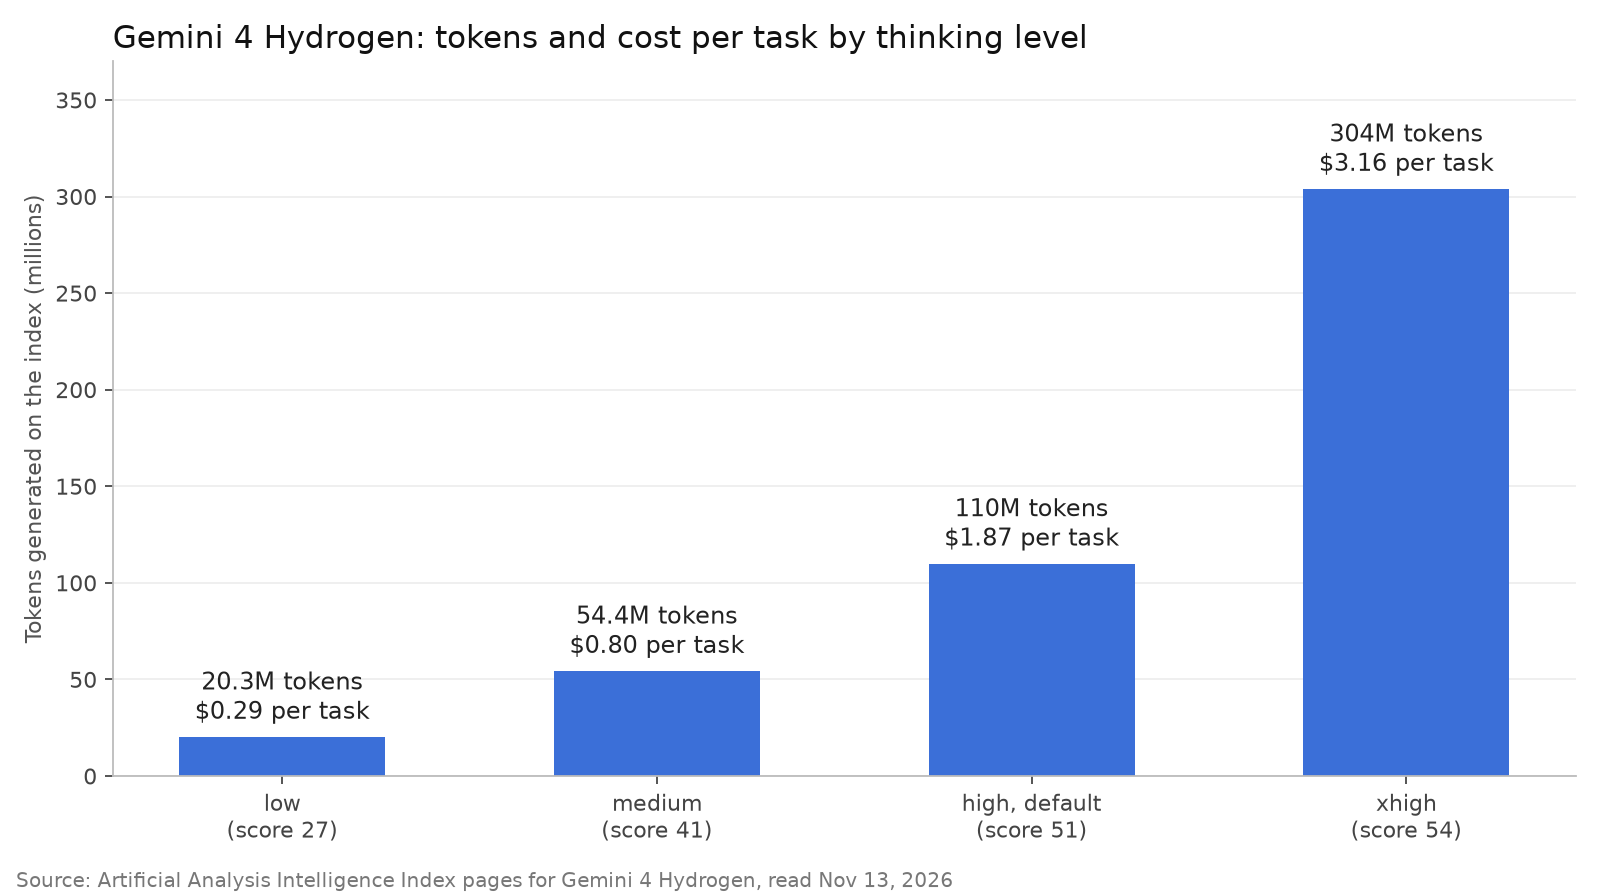
Leia a tabela como proporções. Ir de high para xhigh gerou cerca de 2,8x mais tokens e elevou o custo por tarefa em cerca de 1,7x, para ganhar 3 pontos a mais no índice. Reduzir de high para low cortou os tokens para menos de um quinto.
A página What’s new in Gemini 4 Hydrogen do Google adverte que o xhigh “pode causar overthinking em prompts mais simples” e recomenda escolher “o menor thinking_level que atenda ao seu padrão de qualidade”. Note que o max_output_tokens limita thinking e saída combinados.
Quanto custa uma chamada do Gemini 4 Hydrogen?
Cada solicitação segue uma única fórmula. Pegue as contagens de tokens no objeto usage da resposta (total_input_tokens, total_cached_tokens, total_thought_tokens, total_output_tokens):
cost = (uncached_input x $1.50 / 1M)
     + (cached_input   x $0.075 / 1M)
     + ((thought + output) x $7.50 / 1M)
Os dois exemplos abaixo usam contagens de tokens ilustrativas, não medições reais. Substitua pelos seus próprios valores.
Exemplo 1: uma chamada de chat em high. 2.000 tokens de entrada, 1.500 tokens de thinking, 600 tokens de saída.
| Linha | Standard | Batch ou Flex |
|---|---|---|
| Entrada (2.000) | US$ 0,0030 | US$ 0,0015 |
| Thinking + saída (2.100) | US$ 0,0158 | US$ 0,0079 |
| Total por chamada | US$ 0,0188 | US$ 0,0094 |
| 10.000 chamadas por mês | US$ 187,50 | US$ 93,75 |
Exemplo 2: um loop de agente. Um agente de código executa 40 turnos. Ele reenvia a conversa a cada turno, então lê 1,2M de tokens de entrada no total, sendo que 900K desses acionam o cache implícito. Ele usa 200K tokens de thinking e escreve 60K tokens de código e chamadas de ferramentas.
| Linha | Standard | Batch ou Flex | Priority |
|---|---|---|---|
| Entrada sem cache (300K) | US$ 0,45 | US$ 0,23 | US$ 0,81 |
| Entrada em cache (900K) | US$ 0,07 | US$ 0,03 | US$ 0,12 |
| Thinking + saída (260K) | US$ 1,95 | US$ 0,98 | US$ 3,51 |
| Total por execução | US$ 2,47 | US$ 1,23 | US$ 4,44 |
Cerca de 79% da fatura no Standard vem de thinking e saída, então o nível de thinking importa mais do que encurtar seu prompt. O código das solicitações de ambos os exemplos está no nosso guia da API do Gemini 4 Hydrogen.
Como o preço do Hydrogen se compara com Carbon, Argon e Gemini 3.8 Flash?
Aqui estão as tarifas do nível pago Standard por 1M de tokens da página de preços do Google, consultadas em 13 de novembro de 2026:
| Modelo | Entrada | Saída | Entrada em cache | Nível gratuito |
|---|---|---|---|---|
| Gemini 4 Hydrogen | US$ 1,50 | US$ 7,50 | US$ 0,075 | Sim |
| Gemini 4 Carbon (até 30/11) | US$ 2,00 | US$ 10,00 | US$ 0,10 | Não |
| Gemini 4 Carbon (a partir de 1º/12) | US$ 4,00 | US$ 20,00 | US$ 0,20 | Não |
| Gemini 4 Argon (até 30/11) | US$ 2,00 | US$ 10,00 | US$ 0,10 | Não |
| Gemini 4 Argon (a partir de 1º/12) | US$ 4,00 | US$ 20,00 | US$ 0,20 | Não |
| Gemini 3.8 Flash (até 31/12) | US$ 0,75 | US$ 3,75 | US$ 0,075 | Sim |
| Gemini 3.8 Flash (a partir de 1º/1/2027) | US$ 1,50 | US$ 7,50 | US$ 0,15 | Sim |
Aplicando as contagens de tokens do loop de agente do Exemplo 2 a cada preço, você obtém US$ 2,47 no Hydrogen, US$ 3,29 no Carbon ou Argon este mês e US$ 6,58 a partir de 1º de dezembro, e US$ 1,27 no Gemini 3.8 Flash até 31 de dezembro. Quando o preço do Flash sobe em 1º de janeiro de 2027, os mesmos tokens custam US$ 2,54 no Flash, um pouco mais que no Hydrogen, porque a tarifa de cache do Flash dobra para US$ 0,15. Para os detalhes sobre a mudança de preços dos modelos frontier, consulte nossos guias de preços do Gemini 4 Carbon e preços do Gemini 4 Argon.
Mesmos tokens não é a comparação real, porém, porque cada modelo gasta uma quantidade diferente de tokens por tarefa. As páginas do Intelligence Index da Artificial Analysis oferecem uma visão:
| Modelo (nível de thinking) | Pontuação no índice | Tokens gerados | Custo por tarefa do índice |
|---|---|---|---|
| Gemini 4 Hydrogen (high) | 51 | 110M | US$ 1,87 |
| Gemini 4 Hydrogen (xhigh) | 54 | 304M | US$ 3,16 |
| Gemini 4 Argon (high) | 50 | 113M | US$ 4,97 |
| Gemini 4 Carbon (high) | 60 | 205M | US$ 5,48 |
| Gemini 3.8 Flash (high) | 31 | 126M | não comparado aqui |
Nesse benchmark, o Hydrogen em seu nível padrão igualou a pontuação do Argon a cerca de 38% do custo por tarefa do Argon, enquanto o Carbon obteve a pontuação mais alta. Trate isso como a visão de um único benchmark. O Google também afirma que o Hydrogen conclui tarefas 2,5x mais rápido que o Gemini 3.8 Flash na configuração high.
A divisão prática: Hydrogen para codificação do dia a dia e agentes, Carbon para arquitetura complexa, depuração e revisões de segurança. No Antigravity, a opção Orchestrator alterna entre Carbon e Hydrogen dentro de uma mesma execução. Nossa comparação entre Gemini 4 Carbon e Argon cobre o lado dos modelos frontier.
Como reduzir sua fatura do Gemini 4 Hydrogen?
- Use Batch ou Flex para trabalhos que podem esperar. Ambos custam metade do preço.
- Escolha o menor nível de thinking que passe nos seus evals. O
mediumusou cerca de metade dos tokens dohigh. - Reserve o
xhighpara os turnos difíceis. - Mantenha um prefixo de prompt estável para que o cache implícito cobre a entrada repetida a US$ 0,075 por 1M, um desconto de 95%.
- Faça protótipos no nível Free.
Meça seu custo real do Gemini 4 Hydrogen com a Apidog CLI
Sua fatura vem dos seus próprios prompts. A forma mais rápida de obter números reais é deixar seu agente de código (Claude Code, Codex, Cursor) executar seus prompts em todos os níveis de thinking por meio da Apidog CLI e registrar o objeto usage de cada execução.
Configure uma vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Coloque de 5 a 10 dos seus prompts reais em levels.csv, uma linha por prompt e nível de thinking, com as colunas prompt e thinking_level (low, medium, high, xhigh). Depois, dê ao seu agente um único prompt:
In Apidog project <projectId>, create a test case for
POST https://generativelanguage.googleapis.com/v1beta/interactions
with the x-goog-api-key header read from GEMINI_API_KEY in environment
<envId>. Send model "gemini-4-hydrogen", input {{prompt}} and
generation_config.thinking_level {{thinking_level}}. Assert status 200,
status "completed", non-empty output, and a usage object that includes
total_input_tokens and total_output_tokens. In a post-processor, read
total_input_tokens, total_cached_tokens, total_thought_tokens and
total_output_tokens, compute cost at $1.50 input, $0.075 cached and
$7.50 output per 1M, and log it. Run every row of levels.csv and give me
a table of tokens and cost per prompt and thinking level.
O agente verifica o formato do payload antes de escrever qualquer coisa e, em seguida, executa todas as linhas:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> \
  -d levels.csv -r cli,json --out-file hydrogen-cost-{GENERATE_TIME}
O relatório JSON mostra quanto cada nível de thinking custa na sua carga de trabalho. Adicione -r junit e o mesmo comando roda em CI, onde uma asserção de orçamento de tokens pode falhar o build. O guia de CI/CD da Apidog CLI mostra o pipeline, e o Apidog CLI no Claude Code cobre a configuração do agente. O plano Free da Apidog cobre até 4 usuários.
Um atalho: diga ao seu agente “Leia https://apidog.com/apidog-cli-installation-guide.md e configure a Apidog CLI.”
FAQ
O Gemini 4 Hydrogen é gratuito? Na API, sim, dentro dos limites de taxa do nível Free: o Google lista entrada e saída Standard como “Gratuito” no nível Free. Batch, Flex e grounding com Search exigem uma chave paga. Consulte nosso guia do Gemini 4 Hydrogen gratuito.
O preço do Gemini 4 Hydrogen vai subir como o do Carbon? A página de preços do Google lista uma única tarifa de US$ 1,50/US$ 7,50 para o Hydrogen, sem período introdutório ou data de término. Carbon e Argon têm preços introdutórios com data marcada; o Hydrogen não.
Os tokens de thinking são cobrados no Gemini 4 Hydrogen? Sim, à tarifa de saída de US$ 7,50 por 1M no Standard. O objeto usage da resposta os reporta separadamente como total_thought_tokens.
O Gemini 4 Hydrogen é mais barato que o Gemini 3.8 Flash? Não neste ano: o Flash custa US$ 0,75/US$ 3,75 até 31 de dezembro de 2026. A partir de 1º de janeiro de 2027, o Flash sobe para US$ 1,50/US$ 7,50, a mesma tarifa por token do Hydrogen, e o Hydrogen marcou 51 contra 31 do Flash no índice da Artificial Analysis.