
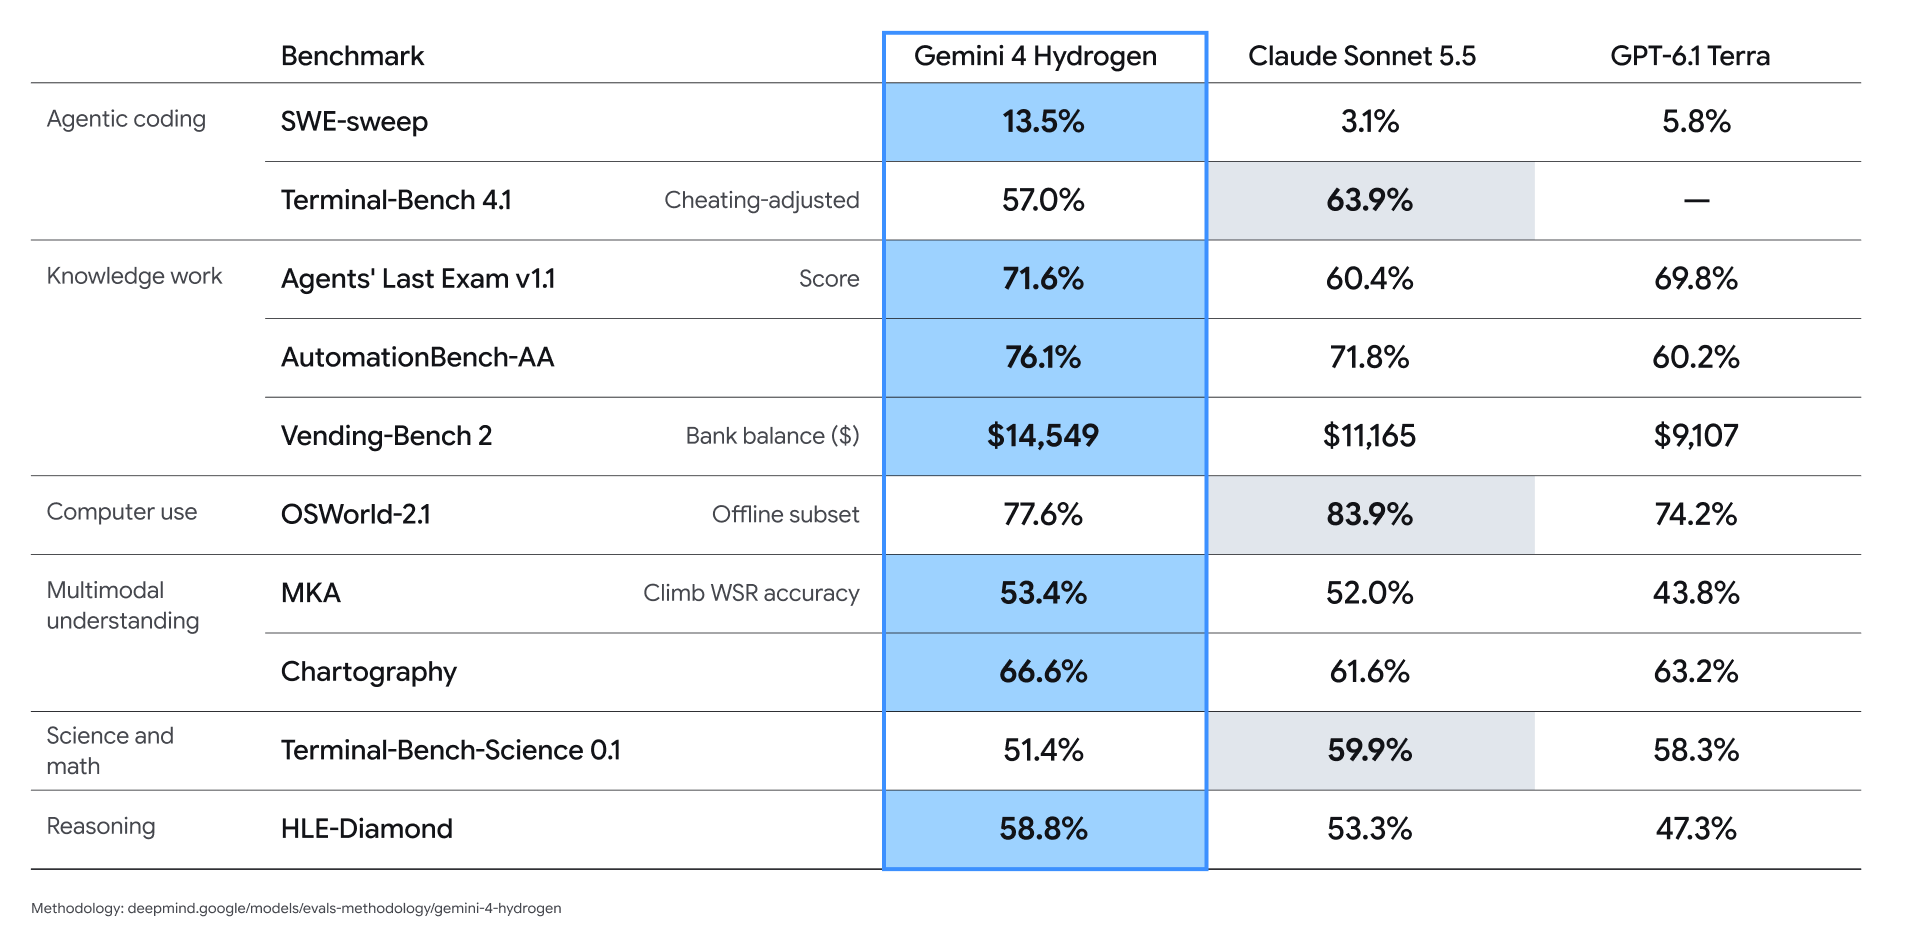
A API do Gemini 4 Hydrogen usa o ID de modelo gemini-4-hydrogen. Você a chama com um POST para https://generativelanguage.googleapis.com/v1beta/interactions, com sua chave no cabeçalho x-goog-api-key e model mais input no corpo JSON. Ela está disponível no nível gratuito e no nível pago (US$ 1,50 de entrada, US$ 7,50 de saída por 1M de tokens) e usa por padrão o nível de pensamento high.
Este guia percorre todo o caminho: chave, primeira requisição, nível de pensamento, um PDF, function calling, streaming e tratamento de erros. Todos os nomes de campos vêm da documentação do Google.
O que você precisa antes da sua primeira chamada à API do Gemini 4 Hydrogen?
Você precisa de uma chave da API Gemini, do ID de modelo gemini-4-hydrogen e do endpoint Interactions. O Google lançou o Hydrogen em 12 de novembro de 2026, como o modelo rápido da linha Gemini 4 ao lado de Carbon e Argon (o que é o Gemini 4 Hydrogen).
| Item | Valor |
|---|---|
| ID do modelo | gemini-4-hydrogen |
| Endpoint | POST /v1beta/interactions em generativelanguage.googleapis.com |
| Cabeçalho de autenticação | x-goog-api-key: $GEMINI_API_KEY |
| APIs | Interactions API e generateContent |
| Níveis de pensamento | low, medium, high (padrão), xhigh |
| Janela de contexto | 1.048.576 tokens, compartilhados entre entrada, pensamento e saída |
| Saída por ciclo síncrono | 65.536 tokens, com ou sem streaming |
| Nível gratuito | Sim, com limites de taxa |
| Preço pago | US$ 1,50 / 1M de entrada, US$ 7,50 / 1M de saída (pensamento incluído) |
| Entrada em cache | US$ 0,075 / 1M via cache implícito |
A documentação do Google considera o generateContent legado, por isso estes exemplos usam a API Interactions.
Como obter uma chave da API Gemini para o Hydrogen?
O Hydrogen está no nível gratuito, então você pode começar sem configurar faturamento:
- Abra a página de chaves de API no Google AI Studio.
- Clique em Create API key. Novas chaves criadas no AI Studio são chaves de autorização, vinculadas a uma conta de serviço.
- Exporte-a:
export GEMINI_API_KEY="YOUR_API_KEY". Os SDKs leemGEMINI_API_KEYouGOOGLE_API_KEY; se ambas estiverem definidas,GOOGLE_API_KEYtem precedência. - Um projeto do Cloud criado fora do AI Studio pode precisar de verificação do projeto antes que o nível gratuito funcione.
O Google publica os números do nível gratuito em sua página de limites de taxa, não no guia de lançamento. Nosso guia do Gemini 4 Hydrogen gratuito cobre o que você recebe por US$ 0.
Como enviar sua primeira requisição à API do Gemini 4 Hydrogen?
Envie model e input para o endpoint Interactions. Mantenha o modelo em uma variável para que trocar de modelo seja uma mudança de uma linha.
export GEMINI_MODEL="gemini-4-hydrogen"

curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "'"$GEMINI_MODEL"'",
    "input": "Write a Python function that retries an HTTP call with exponential backoff."
  }'
A mesma chamada com o SDK Python (pip install -U google-genai):
import os
from google import genai

client = genai.Client()  # reads GEMINI_API_KEY

interaction = client.interactions.create(
    model=os.environ.get("GEMINI_MODEL", "gemini-4-hydrogen"),
    input="Write a Python function that retries an HTTP call with exponential backoff.",
)

print(interaction.output_text)
print(interaction.usage)
A resposta traz um id, um status e um array steps. O texto fica nas etapas model_output, o raciocínio nas etapas thought, e o output_text do SDK junta o texto para você. O objeto usage contém total_input_tokens, total_thought_tokens, total_output_tokens e total_tokens.
Estes snippets seguem o quickstart do Google. Não os executamos para este post (não havia chave do Gemini na nossa máquina de testes), então confira o formato com a sua primeira resposta.
Como definir o nível de pensamento do Gemini 4 Hydrogen?
Defina thinking_level dentro de generation_config. O Hydrogen usa high por padrão, adiciona um novo nível xhigh e rejeita minimal com um erro.
thinking_level |
Uso de tokens | Uso recomendado pelo Google |
|---|---|---|
low |
Menos tokens, menor latência | Chat rápido, processamento de alto volume |
medium |
Menos tokens, mais rápido | Codificação interativa, prototipagem de UI ao vivo, chamadas rápidas de ferramentas |
high (padrão) |
Equilibrado | Codificação complexa, execução agêntica, trabalho com documentos multimodais |
xhigh |
Mais tokens, raciocínio mais profundo | Problemas difíceis de múltiplas etapas em que high não é suficiente |
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-hydrogen",
    "input": "Audit this payment retry queue for race conditions.",
    "generation_config": {
      "thinking_level": "medium",
      "max_output_tokens": 65536
    }
  }'
Duas regras importam. max_output_tokens limita pensamento e saída juntos, então um limite antigo baixo (digamos, 8.192) pode cortar as respostas; o Google recomenda aumentá-lo para 65.536 e, em vez disso, baixar o nível de pensamento. E os tokens de pensamento são cobrados à taxa de saída de US$ 7,50, então xhigh custa mais mesmo quando a resposta visível tem o mesmo tamanho. A análise de preços do Gemini 4 Hydrogen faz as contas por nível.
O Google também informa que o servidor ignora temperature, top_p e top_k no Hydrogen, então remova-os das suas requisições.
Como enviar um PDF para o Gemini 4 Hydrogen?
Adicione um item document ao array input, ao lado de um item text com sua instrução. Para arquivos pequenos, envie o PDF inline em base64:
PDF_PATH="invoice.pdf"
B64=$(base64 < "$PDF_PATH" | tr -d '\n')

curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gemini-4-hydrogen",
    "input": [
      {"type": "document", "data": "'"$B64"'", "mime_type": "application/pdf"},
      {"type": "text", "text": "Extract the line items as a table."}
    ]
  }'
Para arquivos maiores ou reutilização entre turnos, faça o upload uma vez com a API Files (gratuita, mantida por 48 horas) e passe {"type": "document", "uri": "<file uri>", "mime_type": "application/pdf"} em vez disso. Segundo o guia de processamento de documentos, PDFs podem ter até 50 MB ou 1.000 páginas, e o modelo lê os gráficos, tabelas e imagens neles, não apenas o texto.
Como funciona o function calling com o Gemini 4 Hydrogen?
Declare sua função em tools. O modelo não executa nada; ele retorna uma etapa function_call, seu código executa a função e você envia de volta um function_result. Aqui está o primeiro passo, do guia de function calling do Google:
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "gemini-4-hydrogen",
    "input": "What'\''s the temperature in London?",
    "tools": [{
      "type": "function",
      "name": "get_current_temperature",
      "description": "Gets the current temperature for a given location.",
      "parameters": {
        "type": "object",
        "properties": {
          "location": {"type": "string", "description": "The city name"}
        },
        "required": ["location"]
      }
    }]
  }'
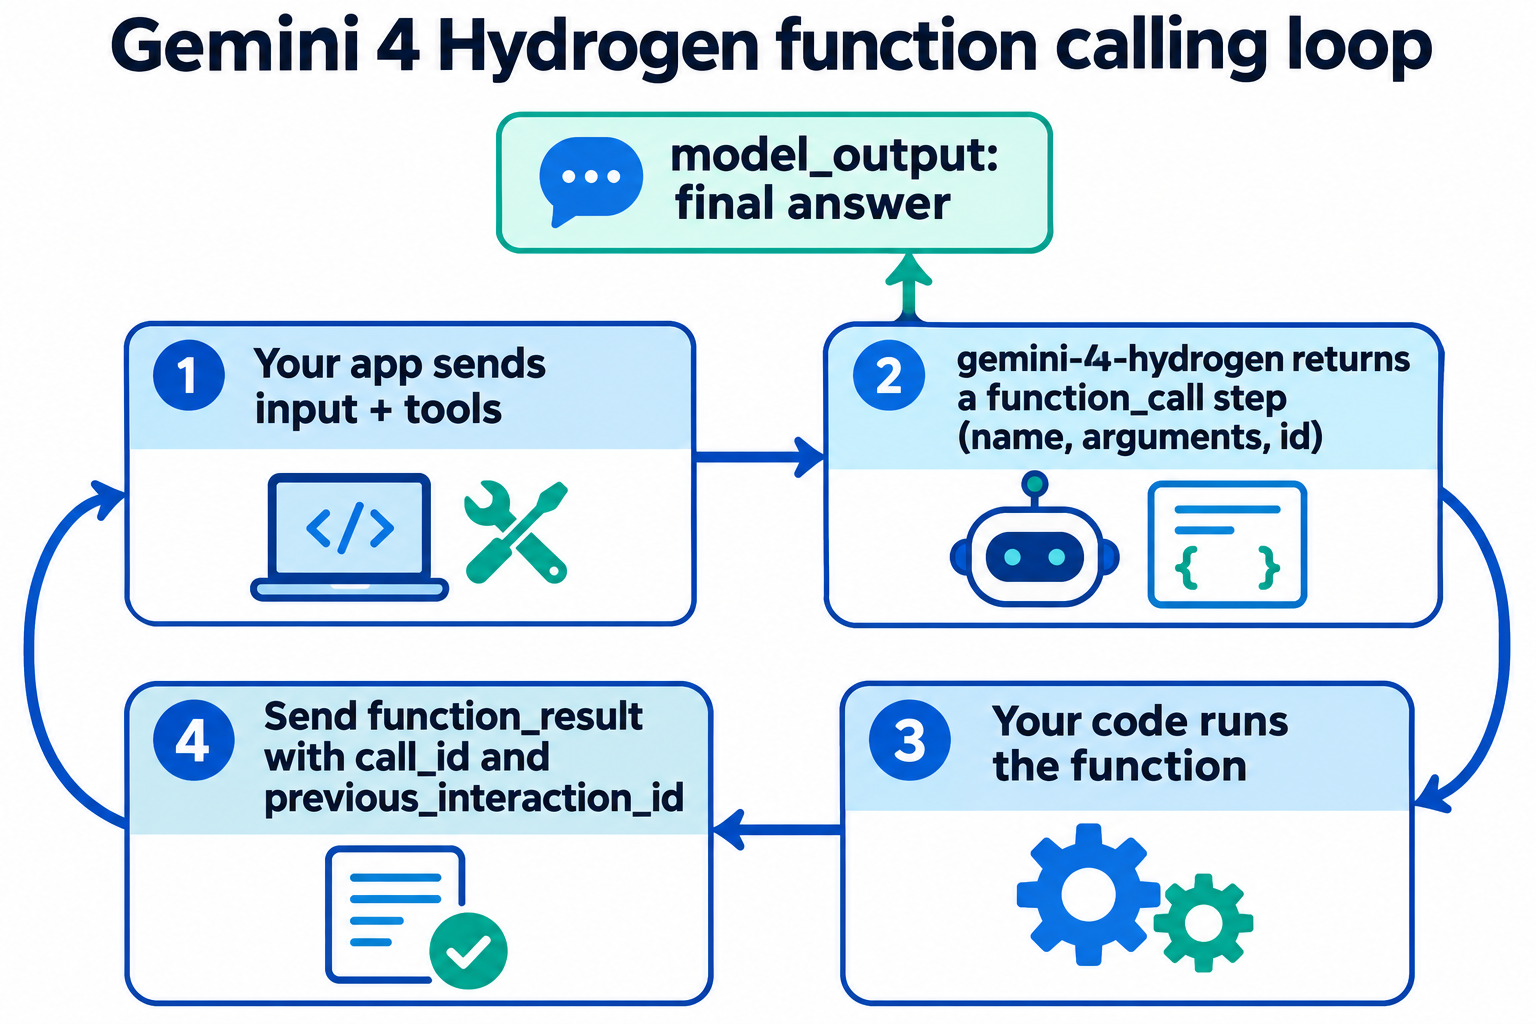
Encontre a etapa em que type é function_call e leia seus campos name, arguments e id. Execute sua função e envie o resultado de volta na mesma sessão:
fc = next(s for s in interaction.steps if s.type == "function_call")
result = get_current_temperature(**fc.arguments)

final = client.interactions.create(
    model="gemini-4-hydrogen",
    input=[{
        "type": "function_result",
        "name": fc.name,
        "call_id": fc.id,
        "result": [{"type": "text", "text": json.dumps(result)}],
    }],
    tools=[weather_function],
    previous_interaction_id=interaction.id,
)
print(final.output_text)
previous_interaction_id mantém o estado da conversa e do pensamento no lado do Google, então você não precisa reenviar o histórico. Um aviso das notas de migração do Google: pedir ao modelo, via prompt, para imprimir "chamadas de ferramenta" em JSON bruto sem nenhuma ferramenta declarada pode retornar MALFORMED_FUNCTION_CALL. Declare as ferramentas nativamente ou use saídas estruturadas.
Como fazer streaming das respostas do Gemini 4 Hydrogen?
Adicione "stream": true ao corpo. A API responde com Server-Sent Events:
curl -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  --no-buffer \
  -d '{
    "model": "gemini-4-hydrogen",
    "input": "Explain idempotency keys in three short paragraphs.",
    "stream": true
  }'
Segundo o guia de streaming do Google, você recebe interaction.created, depois step.start, step.delta e step.stop para cada etapa (thought, depois model_output) e, por fim, interaction.completed com o usage final. Concatene o delta.text das etapas model_output para montar a resposta. O streaming não aumenta o teto: cada ciclo ainda para em 65.536 tokens. Para saídas mais longas, defina "background": true com max_output_tokens acima de 65.536 e consulte GET /v1beta/interactions/{id} até que status saia de in_progress ou queued.
Como tratar erros da API do Gemini 4 Hydrogen?
Erros sem streaming retornam como um status HTTP mais um objeto error com code e message. Em um stream, você recebe um evento error com os mesmos campos. Os códigos que você verá com mais frequência, segundo a página de erros da API do Google:
| HTTP | code |
O que fazer |
|---|---|---|
| 400 | invalid_request |
Corrija o payload; confira os nomes dos campos na documentação |
| 403 | permission_denied |
Verifique permissões da chave, verificação ou faturamento |
| 404 | model_not_found |
Confira se a string do modelo é gemini-4-hydrogen |
| 429 | rate_limit_exceeded |
Espere e tente novamente |
| 429 | quota_exceeded |
Cota diária atingida; aguarde o reset |
| 503 | service_unavailable |
Espere e tente novamente |
O guia de solução de problemas do Google diz para repetir somente 429, 408 e 5xx, com backoff exponencial mais jitter e um limite de tentativas, e nunca repetir 400, 402 ou 403. O SDK Python já repete erros transitórios até quatro vezes.
Deixe seu agente de codificação testar a API do Hydrogen com o Apidog CLI
Em vez de ler JSON após cada prompt ou mudança de nível de pensamento, deixe seu agente de codificação (Claude Code, Codex, Cursor) criar um teste repetível e executá-lo com o Apidog CLI.
Configure uma vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Depois dê ao seu agente um único prompt:
In Apidog project <projectId>, create an environment "gemini" with base URL
https://generativelanguage.googleapis.com and variables GEMINI_API_KEY and
THINKING (default "low"). Add an endpoint for POST /v1beta/interactions with the
x-goog-api-key header from GEMINI_API_KEY. Create a test case that sends model
"gemini-4-hydrogen", a short prompt and generation_config.thinking_level
{{THINKING}}, and asserts: HTTP 200, status is "completed", steps contains a
non-empty model_output, and usage.total_tokens exists. Run it at low and at high,
then compare usage.total_thought_tokens.
O agente valida cada payload contra os schemas do CLI antes de escrever qualquer coisa:
apidog environment create gemini --project <projectId> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> --env-var "THINKING=low" -r cli,json
apidog run --test-case <caseId> --project <projectId> -e <envId> --env-var "THINKING=high" -r cli,json
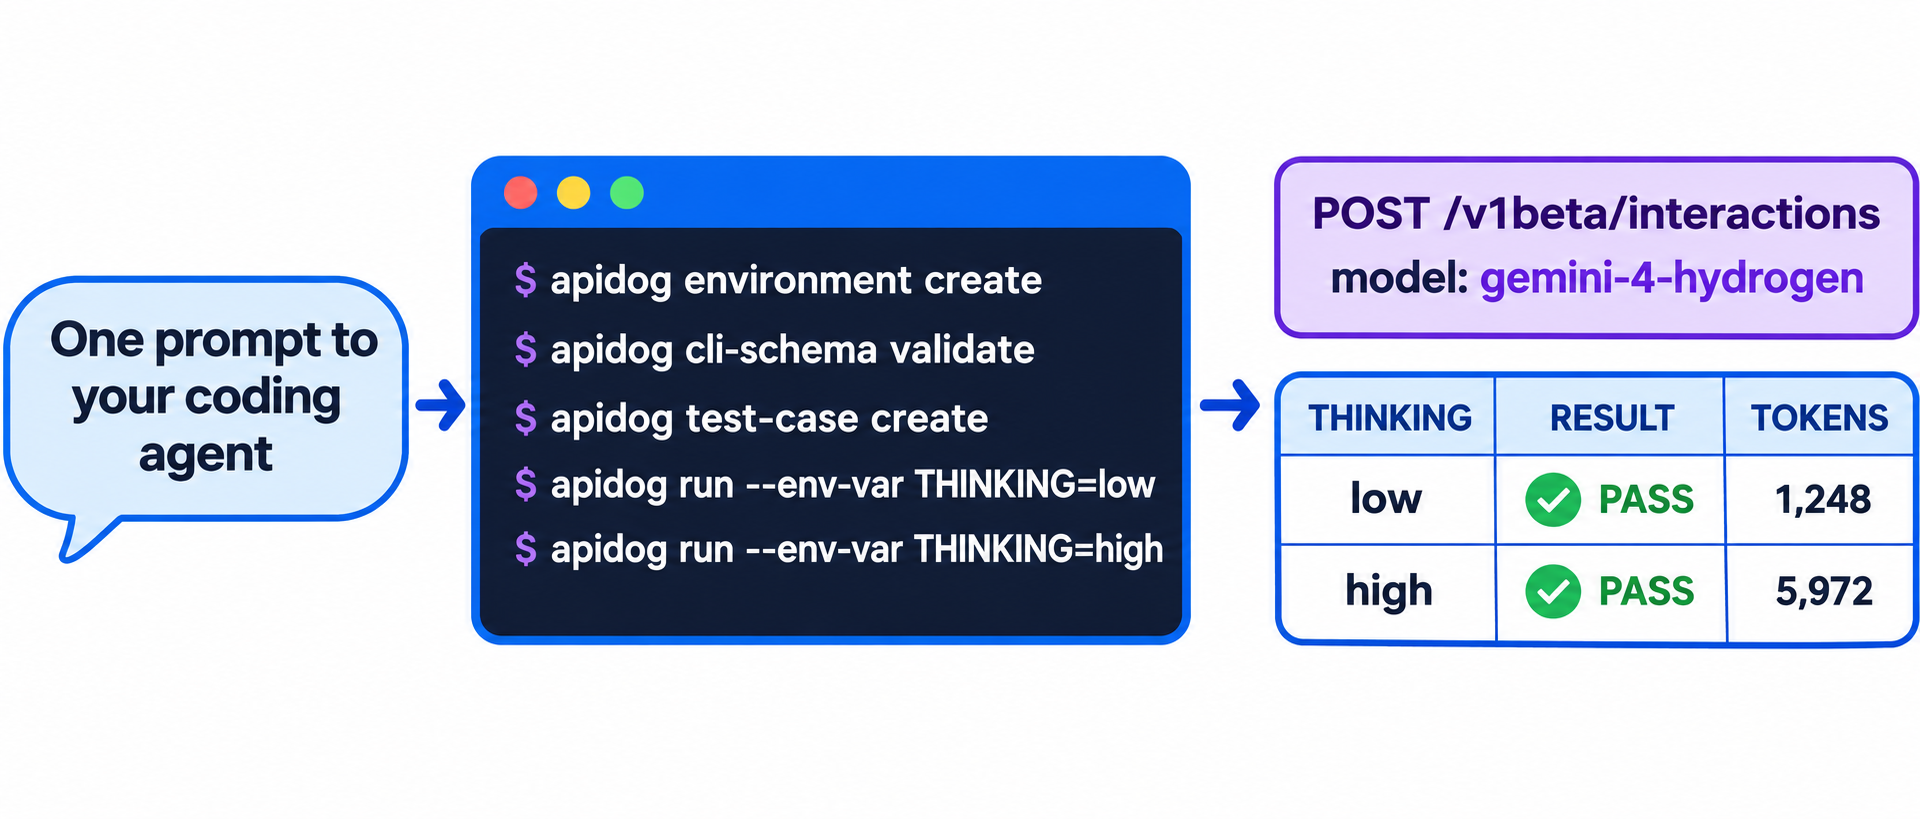
As duas execuções comparam tokens de pensamento para o mesmo prompt, o número que move sua fatura. Troque -r cli,json por -r junit e a mesma execução entra no CI; o guia de CI/CD do Apidog CLI mostra o pipeline e o Apidog CLI no Claude Code cobre a configuração do agente. O plano Free do Apidog cobre até 4 usuários.
FAQ
Qual é o ID de modelo do Gemini 4 Hydrogen? gemini-4-hydrogen. Funciona com a API Interactions e com o generateContent.
A API do Gemini 4 Hydrogen é gratuita? Sim, dentro dos limites. O Google lista o Hydrogen no nível gratuito da API Gemini e do AI Studio, com limites de taxa. O uso pago custa US$ 1,50 por 1M de tokens de entrada e US$ 7,50 por 1M de tokens de saída.
Como migrar do Gemini 3.8 Flash? Troque a string do modelo, aumente limites baixos de max_output_tokens, remova temperature, top_p, top_k e caching explícito (cachedContents), e substitua o pensamento minimal por low ou medium.
O Hydrogen suporta caching de contexto? Apenas caching implícito. Ele roda por padrão em prompts de pelo menos 4.096 tokens e dá 95% de desconto em acertos de cache. Caching explícito não é suportado.
Como o Hydrogen é diferente do Gemini 4 Argon na API? O mesmo schema de requisição. O Hydrogen usa high por padrão e adiciona xhigh, enquanto o Argon usa medium por padrão. Veja o guia da API do Gemini 4 Argon, o guia da API do Gemini 4 Carbon e o Gemini 4 Hydrogen Orchestrator para combinar modelos.