
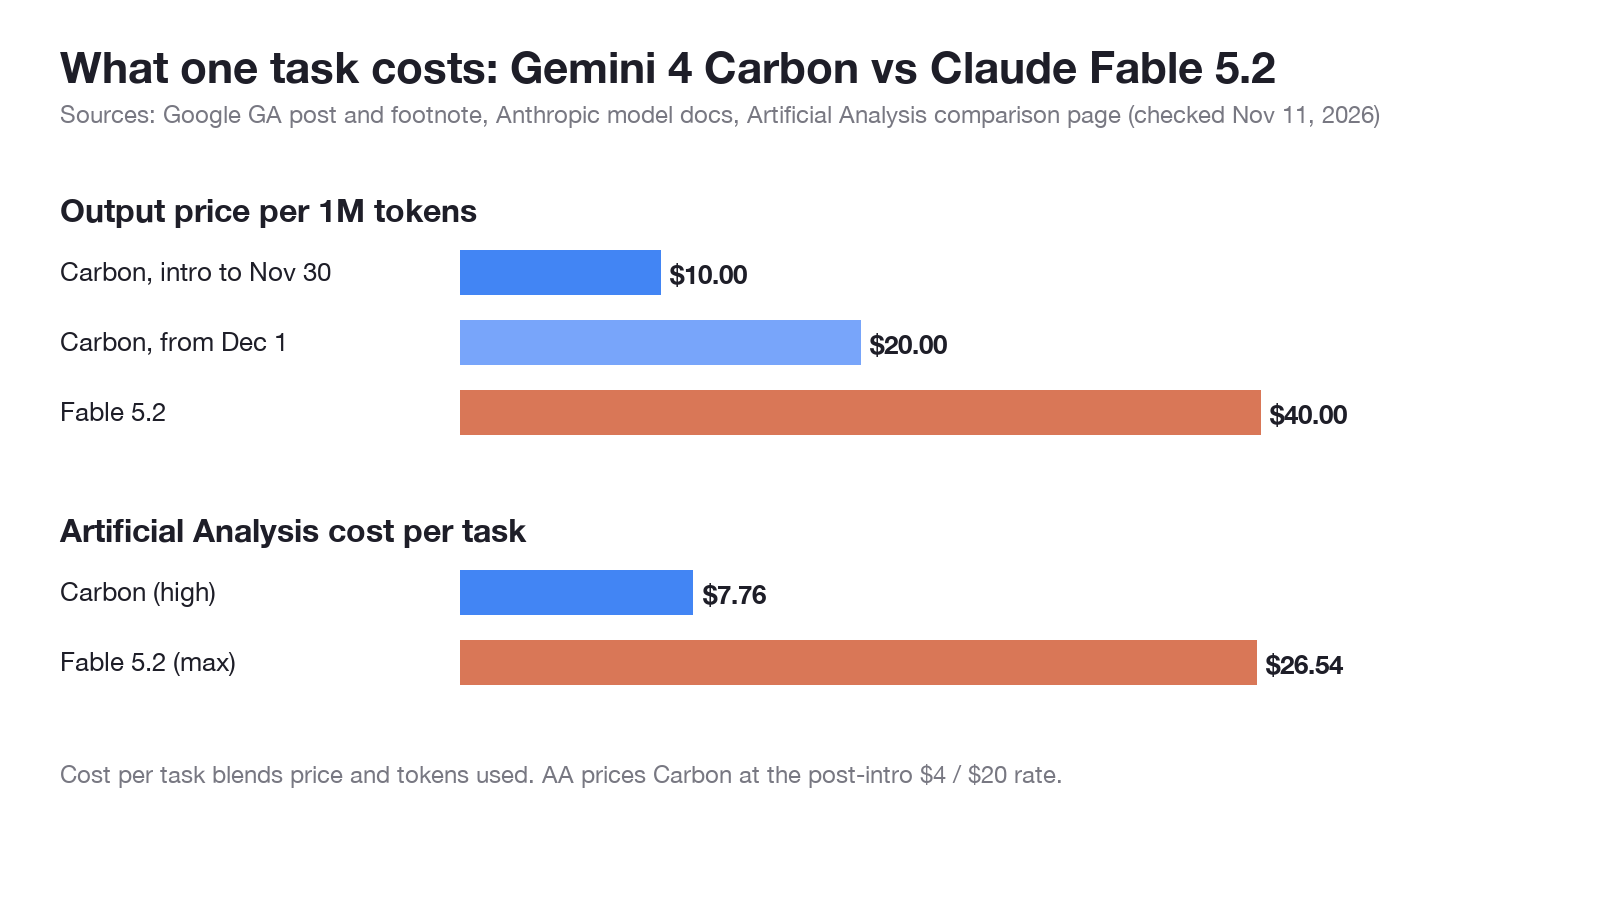
A partir de 11 de novembro de 2026, o Gemini 4 Carbon, da Google, é o modelo mais barato, e o Claude Fable 5.2 é o mais forte na maioria dos benchmarks publicados de programação e agentes. O Carbon custa $2 / $10 por 1M de tokens de entrada/saída até 30 de novembro (depois $4 / $20), o Fable 5.2 custa $8 / $40, e a Artificial Analysis estima o custo de uma tarefa em $7,76 contra $26,54.
Os dois foram lançados com um dia de diferença (Fable 5.2 em 9 de novembro, GA do Carbon em 10 de novembro), e a tabela de cada fornecedor favorece o próprio modelo. Este guia separa cada número conforme quem o mediu e, em seguida, mostra como fazer um teste A/B com os dois modelos nas suas próprias requisições.
Gemini 4 Carbon vs Claude Fable 5.2: o veredito rápido
Escolha o Gemini 4 Carbon quando o custo por tarefa for o mais importante, para fluxos de automação de negócios ou para trabalho de segurança. Escolha o Claude Fable 5.2 quando precisar da pontuação mais alta em tarefas difíceis de programação, terminal e uso de computador e puder pagar cerca de 3,4 vezes mais por tarefa. Para o engenharia do dia a dia, ambos os fornecedores apontam primeiro para um padrão mais barato.
A publicação de GA da Google diz que "o Argon continua sendo a escolha ideal para a maioria do trabalho de engenharia de software e conhecimento", e posiciona o Carbon para tarefas mais difíceis, nas quais ele gasta mais tokens explorando e verificando. A documentação da Anthropic diz a mesma coisa com outras palavras: comece com o Claude Opus 5.5 para a maioria das cargas de trabalho e migre para o Fable 5.2 para raciocínio exigente e trabalho agêntico de longo prazo.
Ou seja, você recorre a um dos dois quando o seu modelo padrão não dá conta. Ainda escolhendo um padrão? Leia primeiro Gemini 4 Carbon vs Argon.
Como o Gemini 4 Carbon e o Claude Fable 5.2 se comparam em preço e especificações?
Aqui estão os fatos publicados por cada fornecedor, com a fonte de cada linha.
| Especificação | Gemini 4 Carbon | Claude Fable 5.2 | Fonte |
|---|---|---|---|
| ID do modelo | gemini-4-carbon |
claude-fable-5-2 |
Google, Anthropic |
| Lançamento | GA em 10/11/2026 | 09/11/2026 | Google, Anthropic |
| Preço de entrada por 1M de tokens | $2 até 30/11, depois $4 | $8 ($16 em modo rápido) | Nota de rodapé da Google, Anthropic |
| Preço de saída por 1M de tokens | $10 até 30/11, depois $20 | $40 ($80 em modo rápido) | Nota de rodapé da Google, Anthropic |
| Janela de contexto | 1M de tokens | 1M de tokens | Model card do AI Studio, docs da Anthropic |
| Saída máxima | 65K / 1M listados [VERIFY] | 128K tokens | Model card do AI Studio, docs da Anthropic |
| Raciocínio (thinking) | Nível de thinking configurável | Adaptativo, sempre ativo, esforço padrão high |
Quickstart da Google, docs da Anthropic |
| Onde obter | Camada paga da Gemini API, AI Studio, Android Studio, Gemini for business, Antigravity, CodeMender, Google AI Ultra | Claude Platform, Amazon Web Services, Google Cloud, Microsoft Azure | Google, Anthropic |
| Camada gratuita da API | Nenhuma informada | Nenhuma informada | Google, Anthropic |
A publicação de GA da Google não menciona Vertex AI, Gemini CLI ou GitHub Copilot, então não planeje com base neles por enquanto. O preço de introdução do Carbon é igual ao do Argon, o que torna novembro o mês mais barato para rodar sua avaliação.
Para as tabelas de preços completas, consulte preços do Claude Fable 5.2 e o anúncio do Gemini 4 Carbon da Google.
Qual modelo ganha nos benchmarks?
Depende de qual tabela você lê, então aqui estão três tabelas mantidas separadas.
Tabela da Anthropic (publicada com o Fable 5.2)
A publicação de lançamento do Fable 5.2 da Anthropic inclui uma coluna para o Gemini 4 Carbon. A página não diz quem executou os números do Carbon, então trate-os como reportados pelo fornecedor.
| Benchmark (tabela da Anthropic) | Fable 5.2 | Gemini 4 Carbon |
|---|---|---|
| FrontierSWE v2 | 69,9% | 61,2% |
| FrontierCode 2.0 | 49,1% (esforço xhigh) | 41,1% (esforço medium) |
| Terminal-Bench-Science 0.1 | 74,6% | 64,8% |
| OSWorld 2.1 (conjunto offline, parcial) | 89,3% | 81,5% |
| AA-Briefcase v1.1 (rubrica) | 66,1% | 61,8% |
| Chartography (sem ferramentas) | 73,4% | 72,5% |
| AutomationBench | 51,4% | 53,9% |
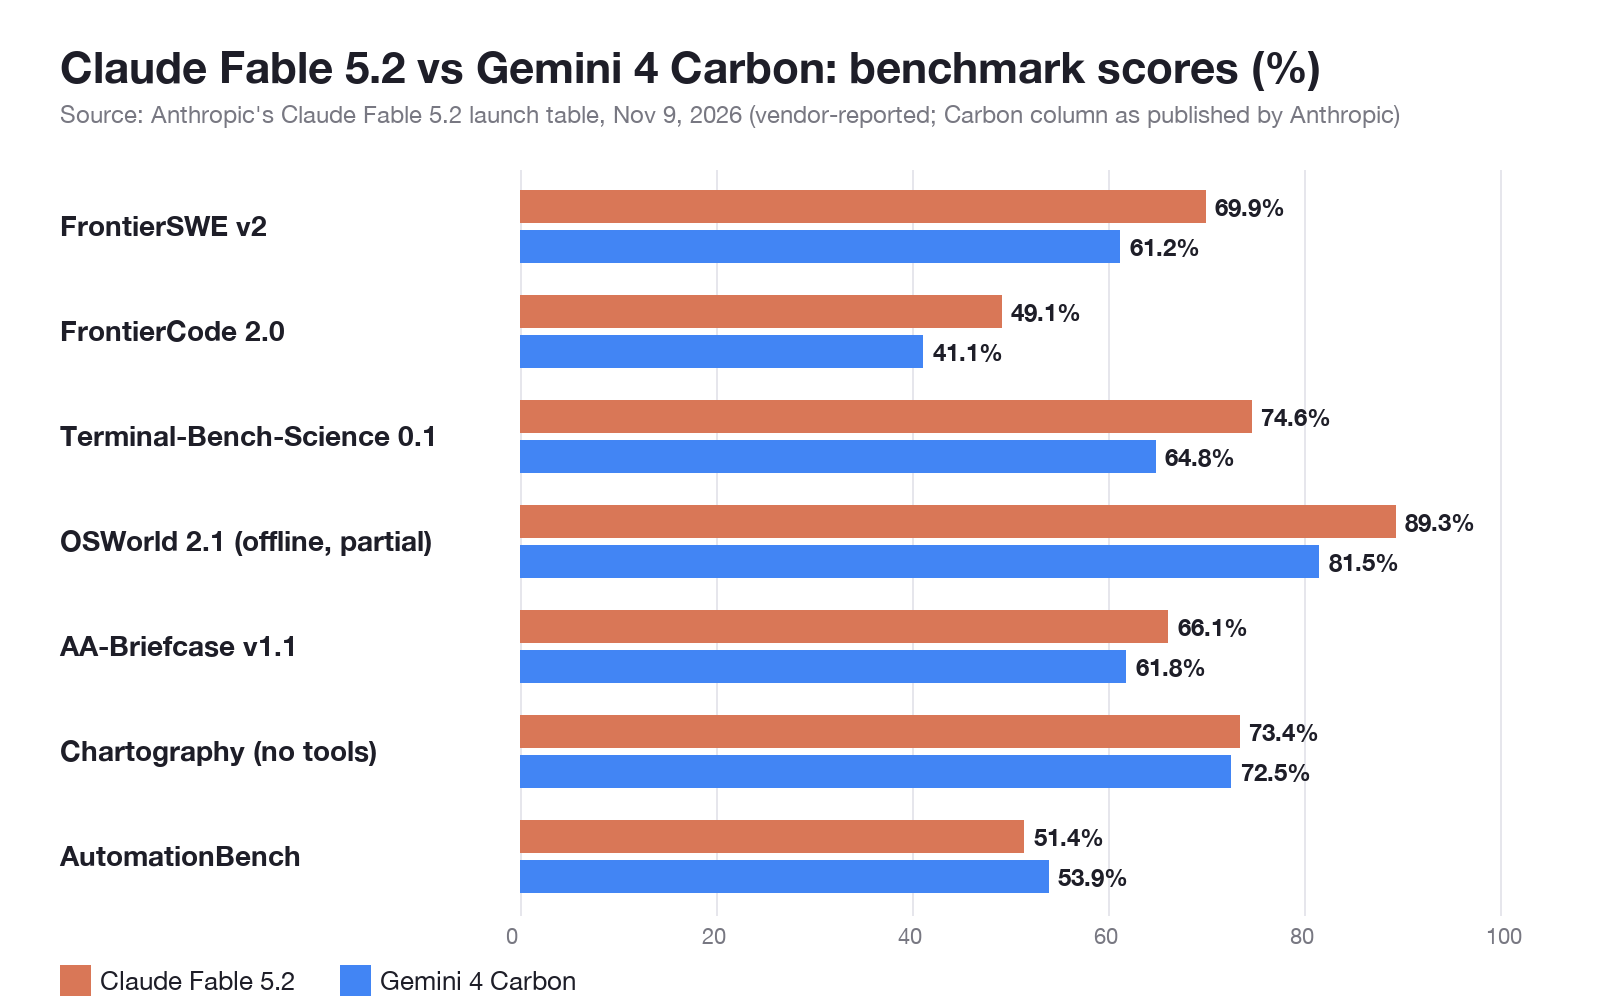
Repare na linha do FrontierCode: o Fable rodou com esforço xhigh e o Carbon com medium. Essa diferença de configurações importa tanto quanto a diferença de pontuações.
Tabela da Google (publicada com o GA do Carbon)
A Google não publica um confronto direto com o Fable 5.2. Em vez disso, reporta leaderboards de parceiros: o Carbon fica em primeiro no CursorBench 4.0, no WANDR da Perplexity e no AutomationBench da Zapier "com mais de 2X menos custo por tarefa em comparação ao melhor modelo externo seguinte". Fica em segundo no benchmark Multimodal Knowledge Agent, com mais de 6x menos custo médio por tarefa que o modelo líder. A Google não nomeia os modelos rivais nessas alegações.
Artificial Analysis (independente)
A página de comparação da Artificial Analysis executa os dois modelos pelo mesmo Intelligence Index v5.0.1:
| Métrica (Artificial Analysis) | Fable 5.2 (max) | Gemini 4 Carbon (high) |
|---|---|---|
| Intelligence Index | 65 | 60 |
| Custo por tarefa | $26,54 | $7,76 |
| Custo para rodar o índice completo | $22.191 | $8.240 |
| Velocidade de saída | 103 tokens/s | 82 tokens/s |
O Fable 5.2 (max) ocupa hoje o topo desse índice. O Carbon pontua 5 pontos menos, a cerca de 29% do custo por tarefa. A Artificial Analysis precifica o Carbon a $4 / $20, o valor pós-novembro, então seus números de custo já refletem o preço de dezembro.
Onde o Claude Fable 5.2 vence?
O Fable 5.2 vence nas tarefas mais difíceis de programação e uso de computador, segundo os números da Anthropic:
- Programação em escala de repositório: 69,9% vs 61,2% no FrontierSWE v2.
- Trabalho em terminal e pesquisa: 74,6% vs 64,8% no Terminal-Bench-Science 0.1.
- Uso de computador: 89,3% vs 81,5% no OSWorld 2.1.
- Índice independente: 65 vs 60 na Artificial Analysis, a única pontuação que nenhum dos fornecedores executou.
- Comprimento de saída: máximo documentado de 128K tokens por requisição.
Se uma tarefa que falha custa a tarde de um engenheiro, um ganho de 8 pontos no FrontierSWE pode superar a conta de tokens. Para configuração, consulte o guia da API do Claude Fable 5.2.
Onde o Gemini 4 Carbon vence?
O Carbon vence em custo por tarefa e nas cargas de trabalho para as quais a Google o criou:
- Custo por tarefa: $7,76 vs $26,54 na Artificial Analysis, cerca de 3,4 vezes mais barato.
- Automação de negócios: 53,9% vs 51,4% no AutomationBench, na própria tabela da Anthropic.
- Segurança: lidera no SEC-bench Pro, ExploitGym e CWE-bench v1 segundo a Google, além de um modelo Carbon para cyber restrito a defensores, por meio do Fairwind Program.
- Preço em novembro: $2 / $10 até 30 de novembro, um quarto do preço do Fable tanto na entrada quanto na saída.
- Equipes de agentes: o preview do /swarm no Google Antigravity transforma um prompt em uma equipe coordenada, com o Carbon planejando e auditando enquanto modelos mais leves trabalham em paralelo.
Primeiro contato com o modelo? Comece por o que é o Gemini 4 Carbon.
Quanto custa, na prática, uma tarefa?
O preço de tabela indica a tarifa, não a conta. O custo de uma tarefa é o preço multiplicado pelos tokens que o modelo escolhe gastar, e a Google diz que o Carbon gasta mais tokens explorando e verificando.
Considere uma requisição com 50.000 tokens de entrada e 10.000 de saída:
- Carbon, tarifa de introdução: (0,05 x $2) + (0,01 x $10) = $0,20
- Carbon, a partir de 1º de dezembro: (0,05 x $4) + (0,01 x $20) = $0,40
- Fable 5.2: (0,05 x $8) + (0,01 x $40) = $0,80
Isso assume que ambos emitem 10.000 tokens. Não vão. Se o Carbon escrever 30.000 tokens de raciocínio onde o Fable escreve 10.000, o custo do Carbon em dezembro sobe para $0,80 e a diferença desaparece. A Artificial Analysis mediu a situação real em toda a sua suíte e ainda encontrou o Carbon cerca de 3,4 vezes mais barato por tarefa, que é o melhor sinal de que você dispõe até medir por conta própria.
Como fazer um teste A/B do Gemini 4 Carbon e do Claude Fable 5.2 nas suas próprias requisições?
Benchmarks são as tarefas de outra pessoa. O teste justo envia o mesmo prompt para as duas APIs e registra tokens e latência lado a lado.
As duas chamadas são HTTP puro. Aqui está a requisição do Carbon, construída a partir do quickstart da Google para a Interactions API, com o nome do modelo em uma variável:
MODEL="gemini-4-carbon"
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Api-Revision: 2026-05-20" \
  -d "{\"model\": \"$MODEL\", \"input\": \"Review this diff and list the bugs.\"}"
O Fable 5.2 passa pela API Messages da Anthropic, com claude-fable-5-2 como modelo.
Deixe seu agente de programação rodar o A/B com o Apidog CLI
Executar pares de requisições manualmente cansa rápido. Em vez disso, deixe o Claude Code, o Codex ou o Cursor comandar o Apidog CLI. A configuração leva três comandos:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Depois, dê ao seu agente um único prompt:
In Apidog project <PROJECT_ID>, create two test cases: one that sends
our code-review prompt to gemini-4-carbon through the Gemini API, and
one that sends the same prompt to claude-fable-5-2 through the Claude
Messages API. Keep both API keys in private environment variables.
Assert a 200 status and a non-empty answer, record token usage and
response time, run each case 5 times and summarize cost per run.
Validate every payload before you write it.
O agente verifica o esquema, escreve os casos e os executa. As flags abaixo vêm de apidog run --help na CLI 2.2.12:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file carbon-case.json
apidog test-case create --project <PROJECT_ID> --file carbon-case.json
apidog test-case create --project <PROJECT_ID> --file fable-case.json
apidog run --test-case <CARBON_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
apidog run --test-case <FABLE_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
O -n 5 repete cada caso cinco vezes, para que uma resposta lenta não decida o resultado. Adicione --upload-report para visualizar as execuções no app do Apidog. Este é um modelo de fluxo de trabalho; não o executamos contra o Carbon a partir desta máquina. O guia do Apidog CLI no Claude Code cobre a configuração do agente, e o guia da API do Gemini 4 Argon cobre o lado das requisições Gemini.
O plano gratuito do Apidog cobre até 4 usuários, o suficiente para rodar esta comparação.
FAQ
O Gemini 4 Carbon é melhor que o Claude Fable 5.2?
Não em tudo. O Fable 5.2 pontua mais alto na maioria dos benchmarks da Anthropic e no índice da Artificial Analysis (65 vs 60). O Carbon vence em custo por tarefa ($7,76 vs $26,54) e no AutomationBench.
Quanto mais barato é o Gemini 4 Carbon que o Claude Fable 5.2?
Pelo preço de tabela, o Carbon é 4 vezes mais barato até 30 de novembro de 2026 ($2 / $10 vs $8 / $40 por 1M de tokens) e 2 vezes mais barato a partir de 1º de dezembro ($4 / $20). Medido por tarefa pela Artificial Analysis, é cerca de 3,4 vezes mais barato.
Os dois modelos têm janela de contexto de 1M de tokens?
Sim. O model card do AI Studio da Google lista 1M de tokens para o Carbon, e a documentação da Anthropic lista 1M de tokens para o Fable 5.2. A saída máxima do Fable é de 128K tokens; consulte o guia de desenvolvedores da Google para o limite exato de saída do Carbon.
Existe camada gratuita para o Gemini 4 Carbon ou o Claude Fable 5.2 na API?
Nenhum dos fornecedores informa uma. O Carbon está na camada paga da Gemini API e nos apps do Google AI Ultra; o Fable 5.2 é cobrado por token.
Devo mudar meu modelo padrão para um dos dois?
Provavelmente não. A Google diz que o Argon continua sendo a escolha certa para a maioria do trabalho de engenharia de software e conhecimento, e a Anthropic recomenda o Opus 5.5 para a maioria das cargas de trabalho. Direcione ao Carbon ou ao Fable apenas as tarefas em que seu padrão falha e compare os resultados nas suas próprias requisições.