A partir de 11 de novembro de 2026, a API do Gemini 4 Carbon do Google usa o ID de modelo gemini-4-carbon e custa US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída até 30 de novembro de 2026, e depois US$ 4 e US$ 20. O Google o disponibilizou de forma geral em 10 de novembro de 2026, apenas no nível pago da API Gemini.
Este guia leva você de uma chave recém-criada até sua primeira requisição, mostra quais números de uso determinam sua fatura e delega os testes ao seu agente de programação.
Qual é o ID de modelo do Gemini 4 Carbon?
O ID de modelo do Gemini 4 Carbon é gemini-4-carbon. Você o passa como campo model em uma requisição ao endpoint Interactions da API Gemini, no SDK Python ou JavaScript, ou em um prompt no Google AI Studio. O Google chama o Carbon de seu modelo de raciocínio mais forte e o recomenda para tarefas difíceis, enquanto o Gemini 4 Argon continua sendo o padrão para o trabalho do dia a dia.
Para saber mais sobre o modelo em si, comece por o que é o Gemini 4 Carbon.
| Item | Valor | Fonte |
|---|---|---|
| ID de modelo | gemini-4-carbon |
Documentação do Google AI Studio |
| Disponível desde | 10 de novembro de 2026 | Post de lançamento do Google |
| Onde | Nível pago da API Gemini, Google AI Studio, Android Studio | Post de lançamento do Google |
| Nível gratuito | Não disponível | Documentação do Google AI Studio |
| Janela de contexto | 1.048.576 tokens, compartilhados entre entrada, raciocínio e saída | Documentação do Google AI Studio |
| Saída máxima por resposta síncrona | 65.536 tokens | Documentação do Google AI Studio |
| Decodificação longa | Até 1M de tokens menos sua entrada, com background: true |
Documentação do Google AI Studio |
| Níveis de raciocínio | low, medium (padrão), high |
Documentação do Google AI Studio |
| Preço até 30 de novembro de 2026 | US$ 2 na entrada, US$ 10 na saída por 1M de tokens | Post de lançamento do Google |
| Preço a partir de 1º de dezembro de 2026 | US$ 4 na entrada, US$ 20 na saída por 1M de tokens | Post de lançamento do Google |
| Entrada em cache (cache implícito) | US$ 0,10 por 1M, depois US$ 0,20 a partir de 1º de dezembro | Documentação do Google AI Studio |
Como obter uma chave da API Gemini para o Gemini 4 Carbon?
O Carbon roda apenas no nível pago, então a chave sozinha não basta. Você precisa de uma chave em um projeto com faturamento do Cloud vinculado:
- Abra a página de chaves de API no Google AI Studio. Novos usuários recebem um projeto e uma chave criados automaticamente; caso contrário, clique em Create API key.
- Clique em Set up billing na página de chaves de API ou de projetos.
- Crie ou vincule uma conta do Cloud Billing, adicione uma forma de pagamento e pré-pague pelo menos US$ 5 em créditos, conforme o guia rápido do Google.
- Exporte a chave no seu shell:
export GEMINI_API_KEY="YOUR_API_KEY".
O post sobre as opções gratuitas do Gemini 4 Carbon cobre os caminhos que não exigem nenhuma chave de API.
Como enviar sua primeira requisição à API do Gemini 4 Carbon?
O guia rápido do Google para o Carbon usa a API Interactions: um POST para /v1beta/interactions com model e input no corpo. Coloque o nome do modelo em uma variável para que alternar entre Carbon e Argon depois seja uma mudança de uma linha.
Com curl:
export GEMINI_MODEL="gemini-4-carbon"

curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "'"$GEMINI_MODEL"'",
    "input": "Find the race condition in this retry loop and rewrite the lock safely.",
    "generation_config": {
      "thinking_level": "medium"
    }
  }'
Com o SDK Python (pip install -U google-genai):
import os
from google import genai

MODEL = os.environ.get("GEMINI_MODEL", "gemini-4-carbon")

client = genai.Client()  # reads GEMINI_API_KEY from the environment

interaction = client.interactions.create(
    model=MODEL,
    input="Find the race condition in this retry loop and rewrite the lock safely.",
    generation_config={"thinking_level": "medium"},
)

print(interaction.output_text)
print(interaction.usage)
Os dois trechos seguem os exemplos da documentação do Google. Não os executamos para este artigo, pois não temos uma chave paga do Carbon nesta máquina, então verifique o formato da resposta na sua própria primeira chamada.
Três detalhes das notas de migração do Google economizam uma sessão de depuração:
- Remova os parâmetros de amostragem.
temperature,top_petop_ksão ignorados pelo Carbon, então retire-os. - Aumente os timeouts. Prompts difíceis podem levar vários minutos. O Google sugere execução em segundo plano ou timeouts HTTP de pelo menos 15 minutos.
- Mantenha o estado no servidor. Passe
previous_interaction_idpara chats com múltiplas interações e function calling em vez de reenviar o histórico.
Já usa o Argon? Nosso guia da API Gemini 4 Argon usa a mesma estrutura de requisição.
Como ler os tokens de uso e de raciocínio na resposta?
Cada interação retorna um objeto usage. Estes são os campos que importam para o custo:
total_input_tokens: o que você enviou, incluindo instruções de sistema e declarações de ferramentas.total_thought_tokens: tokens que o modelo gastou raciocinando antes de responder.total_output_tokens: a resposta visível.total_tokens: a soma.
O campo a ficar de olho é total_thought_tokens. O guia de raciocínio do Google diz que o preço da resposta é a soma dos tokens de saída e dos tokens de raciocínio, então o raciocínio é cobrado na tarifa de saída de US$ 10. O Google também afirma que o Carbon “gasta mais tokens de raciocínio” por turno do que o Argon para explorar e verificar seu trabalho. Em um prompt difícil, o raciocínio pode ser a maior parte da fatura.
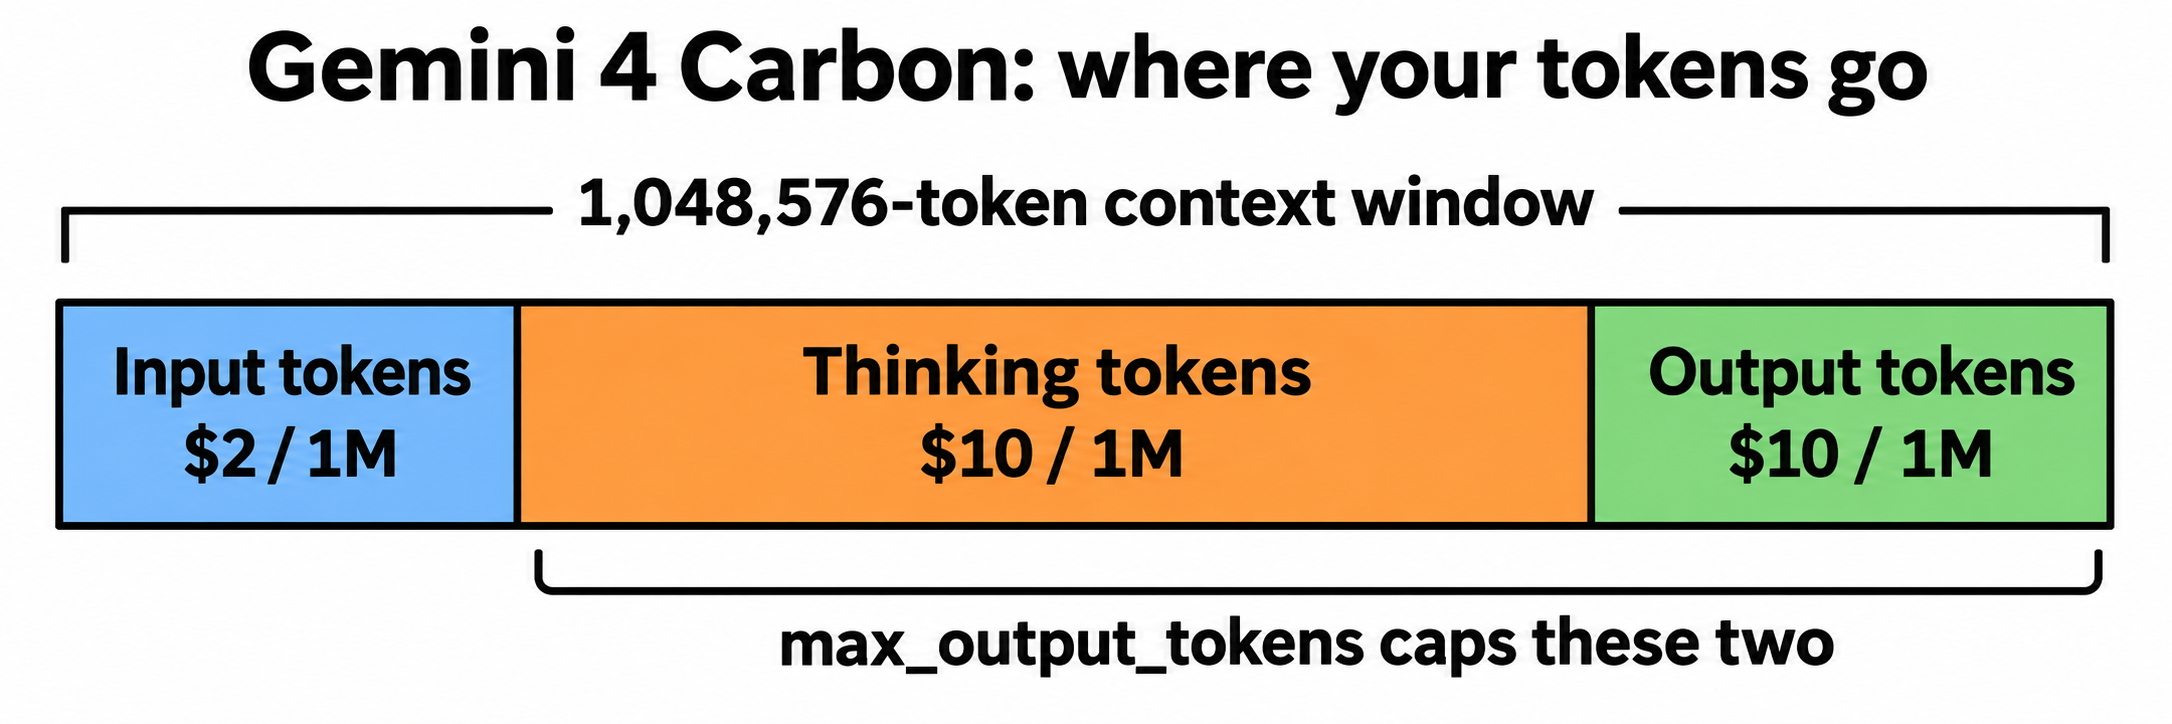
O max_output_tokens limita raciocínio e saída combinados. Se você defini-lo muito baixo, o Carbon pode usar o orçamento raciocinando e cortar a resposta. Os pontos de partida do Google:
- Tarefas padrão: mantenha o padrão de 65.536.
- Aplicativos com limite abaixo de 32K: aumente para pelo menos 32.768.
- Raciocínio complexo e programação: defina
background: truee 131.072 ou 262.144 tokens.
Com background: true, os servidores do Google continuam a resposta em saltos de 64K tokens. Você faz polling da interação até que seu status saia de in_progress ou queued, e então junta o texto de cada etapa model_output.
Qual nível de raciocínio do Gemini 4 Carbon você deve usar?
O nível de raciocínio é seu principal controle sobre qualidade, latência e gasto. A orientação do Google, do guia de raciocínio e da documentação do Carbon:
| Nível de raciocínio | Uso de tokens | Use para |
|---|---|---|
low |
Menos tokens, menor latência | Tarefas simples e sensíveis a custo, análises leves e escrita |
medium (padrão) |
Equilibrado | A maioria das tarefas, incluindo código complexo e trabalho com agentes |
high |
Mais tokens, primeiro token mais lento | Matemática difícil, ciências e as tarefas de código ou agentes mais difíceis |
O Google recomenda executar suas avaliações nos três níveis e manter o mais baixo que atenda ao seu padrão de qualidade. No Carbon, a diferença entre low e high é onde seu orçamento vai embora.
Quando enviar uma tarefa ao Gemini 4 Carbon em vez do Argon?
O Google é direto sobre isso: “O Argon continua sendo a escolha ideal para a maioria do trabalho de engenharia de software e de conhecimento.” Os dois modelos compartilham a janela de contexto de 1M, as ferramentas integradas e o mesmo preço introdutório por token, então a diferença está em quantos tokens cada um gasta por turno. Use o Carbon para depuração complexa de causa raiz, design de arquitetura, síntese multimodal densa, provas e auditorias de segurança. Mantenha o Argon para programação interativa, recursos do dia a dia e ciclos rápidos de produção. Nossa comparação entre Gemini 4 Carbon e Argon vai mais a fundo, e se você está ponderando o Carbon contra o modelo mais recente da Anthropic, veja Gemini 4 Carbon vs Claude Fable 5.2 e o guia da API Claude Fable 5.2.
Quanto custa uma chamada à API do Gemini 4 Carbon?
O Gemini 4 Carbon custa US$ 2 por 1M de tokens de entrada e US$ 10 por 1M de tokens de saída (raciocínio incluído) até 30 de novembro de 2026, e depois US$ 4 e US$ 20, segundo o Google.
Para colocar isso em uma chamada, tome uma requisição ilustrativa com 2.000 tokens de entrada, 6.000 tokens de raciocínio e 1.500 tokens de saída. Estes são números de exemplo, não uma medição:
- Entrada: 2.000 x US$ 2 / 1M = US$ 0,004
- Raciocínio mais saída: 7.500 x US$ 10 / 1M = US$ 0,075
- Total: cerca de US$ 0,079 hoje, cerca de US$ 0,158 a partir de 1º de dezembro
O raciocínio varia muito conforme o prompt, então leia seu próprio objeto usage. Para a matemática completa de preços, o salto de dezembro e o custo por tarefa, veja preços do Gemini 4 Carbon.
Deixe seu agente de programação testar a API do Carbon com o Apidog CLI
Você vai alterar níveis de raciocínio, limites de saída e prompts muitas vezes. Em vez de inspecionar JSON manualmente a cada mudança, deixe seu agente de programação (Claude Code, Codex, Cursor) escrever um teste repetível e executá-lo com o Apidog CLI.
Configure uma vez:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Depois dê ao seu agente um único prompt:
In Apidog project <projectId>, add an endpoint for
POST https://generativelanguage.googleapis.com/v1beta/interactions
with the x-goog-api-key header read from the GEMINI_API_KEY variable in
environment <envId>. Create a test case that sends model "gemini-4-carbon",
a short prompt and thinking_level "low", and asserts: HTTP 200, status is
"completed", usage.total_thought_tokens exists, and usage.total_tokens is
below 20000. Run it and summarize any failures.
Usar low no teste mantém cada execução barata. O agente lê os esquemas, valida seus payloads e executa o caso:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog test-case category --project <projectId>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
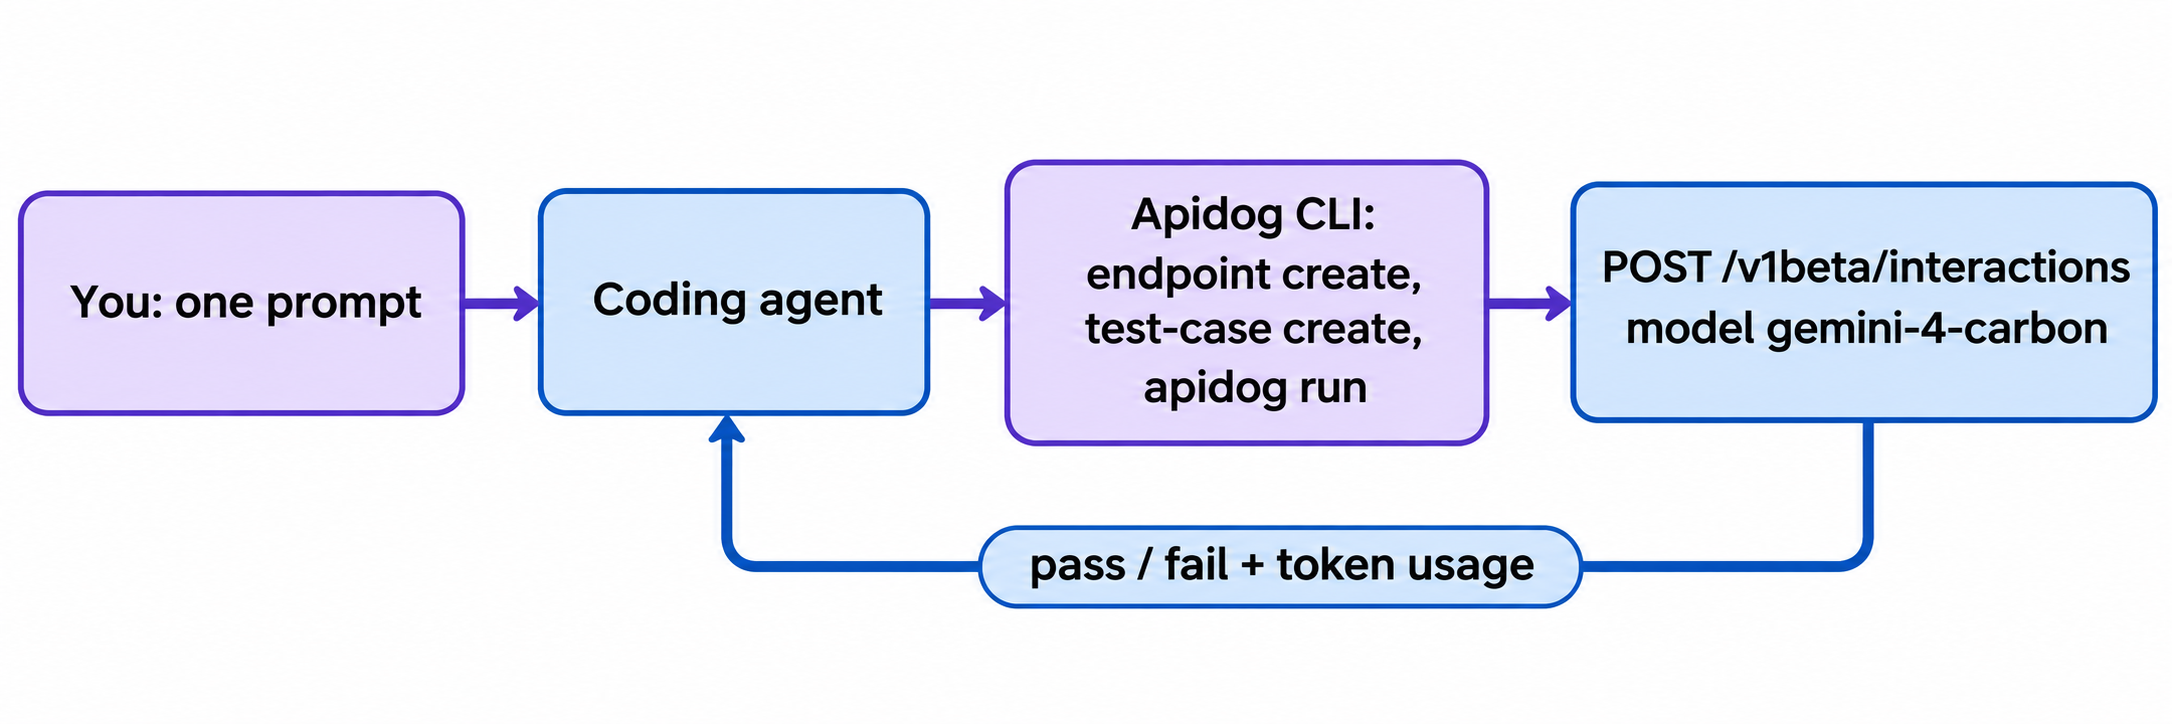
A asserção de orçamento de tokens é a mais útil. Se uma mudança de prompt fizer o raciocínio passar do seu limite, o teste falha antes que a conta cresça. Troque -r cli,json por -r junit e o mesmo comando roda em CI; o guia de CI/CD do Apidog CLI mostra o pipeline, e o Apidog CLI no Claude Code explica a configuração do agente. O plano gratuito do Apidog cobre até 4 usuários.
Se quiser que o agente configure tudo do zero, diga a ele: “Leia https://apidog.com/apidog-cli-installation-guide.md e configure o Apidog CLI.”
Perguntas frequentes
A API do Gemini 4 Carbon é gratuita? Não. A documentação do Google diz que o Gemini 4 Carbon não está disponível no nível gratuito da API Gemini. Você precisa de um projeto no nível pago com Cloud Billing e pelo menos US$ 5 em créditos pré-pagos. No lado do consumidor, o Google está disponibilizando o Carbon aos assinantes do Google AI Ultra no app Gemini, no AI Mode e no Antigravity.
O Gemini 4 Carbon está no Vertex AI? O post de lançamento do Google menciona a API Gemini, o Google AI Studio, o Android Studio, o Gemini para empresas, o Antigravity e o CodeMender. Ele não menciona o Vertex AI, então verifique a lista de modelos do Google Cloud antes de planejar com base nele.
Qual é a janela de contexto do Gemini 4 Carbon? 1.048.576 tokens, compartilhados entre entrada, raciocínio e saída. Uma resposta síncrona para em 65.536 tokens; com execução em segundo plano, uma resposta pode chegar a 1M de tokens menos sua entrada.
Posso usar generateContent em vez da API Interactions? O guia rápido do Carbon usa a API Interactions, e a documentação menciona a API GenerateContent para continuação de decodificação longa no lado do cliente. Se seu aplicativo já usa generateContent, teste a troca do ID de modelo lá antes de migrar.
Como mudar do Gemini 4 Argon para o Carbon? Altere a string do modelo de gemini-4-argon para gemini-4-carbon. O Google diz que não são necessárias mudanças no esquema da requisição. Aumente o max_output_tokens e seus timeouts HTTP, já que o Carbon raciocina por mais tempo, e mantenha o thinking_level em medium a menos que uma tarefa exija high.