
Ainda não há uma API pública do Gemini 4 Argon, e o Google não publicou um ID de modelo. O Google anunciou o Argon em 30 de setembro de 2026, e ele está disponível hoje apenas para os defensores do Programa Fairwind: um conjunto de parceiros Fairwind o utiliza como um modelo gerenciado no Gemini Enterprise. A Artificial Analysis lista o Google AI Studio como o único provedor de API do Argon, mas sem dados de velocidade ou latência, o que se encaixa mais em um acesso pré-lançamento permitido do que em um endpoint ao qual você pode se inscrever. Quando a distribuição mais ampla começar, o Google afirma que ela se inicia "com clientes de API pagos e assinantes do Google AI Ultra", então uma chave de API Gemini paga o coloca em primeiro lugar na fila.
Essa lacuna entre o anúncio e o acesso é um tempo que você pode aproveitar. Este guia separa o que o Google confirmou sobre a API Argon do que não confirmou, e então percorre o código que você pode executar hoje no Gemini 3.8 Flash para que a mudança para o Argon se torne uma alteração de uma única variável. Você construirá a solicitação, configurará um alerta de entrada em produção, simulará a resposta no Apidog e adicionará um teto de custo com base nos preços do Argon. Para o modelo em si, comece com o que é o Gemini 4 Argon; para os estágios de lançamento, consulte o guia de data de lançamento do Gemini 4 Argon.
O que está confirmado sobre a API Gemini 4 Argon e o que não está
A publicação de lançamento do Google fornece preços e um limite de saída. Quase todo o resto que uma integração precisa ainda não foi publicado.
| Item | Status | Detalhe |
|---|---|---|
| Preço de entrada | Confirmado | US$ 2 por 1M tokens (intro), US$ 4 após o período introdutório |
| Preço de saída | Confirmado | US$ 10 por 1M tokens (intro), US$ 20 depois |
| Entrada em cache | Confirmado | 95% de desconto na entrada: US$ 0,10 intro, US$ 0,20 padrão |
| Limite de saída | Confirmado | 1M tokens, um aumento de 64K |
| Superfície da API | Sinalizado | Os documentos do Google dizem que todos os novos modelos são lançados na API de Interações |
| ID do modelo | Não publicado | Ausente da página de modelos, página de preços e changelog |
| Janela de contexto de entrada | Não publicado | A avaliação de contexto longo do Google usou prompts de até 1M tokens, mas isso não é uma especificação |
| Níveis de pensamento | Não publicado | As avaliações foram executadas nas "configurações de pensamento mais altas"; nomes e padrão desconhecidos |
| Limites de taxa | Não publicado | Nenhum nível anunciado |
| Suporte a lote | Não publicado | Nenhum preço de lote ou Flex |
| Nível de prompt longo | Não publicado | O 3.1 Pro cobra mais acima de 200K; a regra do Argon não foi declarada |
| Duração do período introdutório | Não publicado | Nenhuma data final para US$ 2/US$ 10 |
Duas linhas merecem um olhar mais atento. A linha da superfície da API vem dos documentos da API de Interações, que afirmam que novos modelos "serão lançados na API de Interações". O Argon é um novo modelo, então espere-o lá primeiro; o Google não disse se `generateContent` o servirá. A linha de saída é o limite declarado do Google para o modelo, mas o Vals AI lista um máximo de 262K de saída para a configuração que testou, então não presuma que todo endpoint servirá o milhão completo no primeiro dia. Nosso guia de 1M de tokens de saída cobre o que esse limite faz com streaming, timeouts e armazenamento.
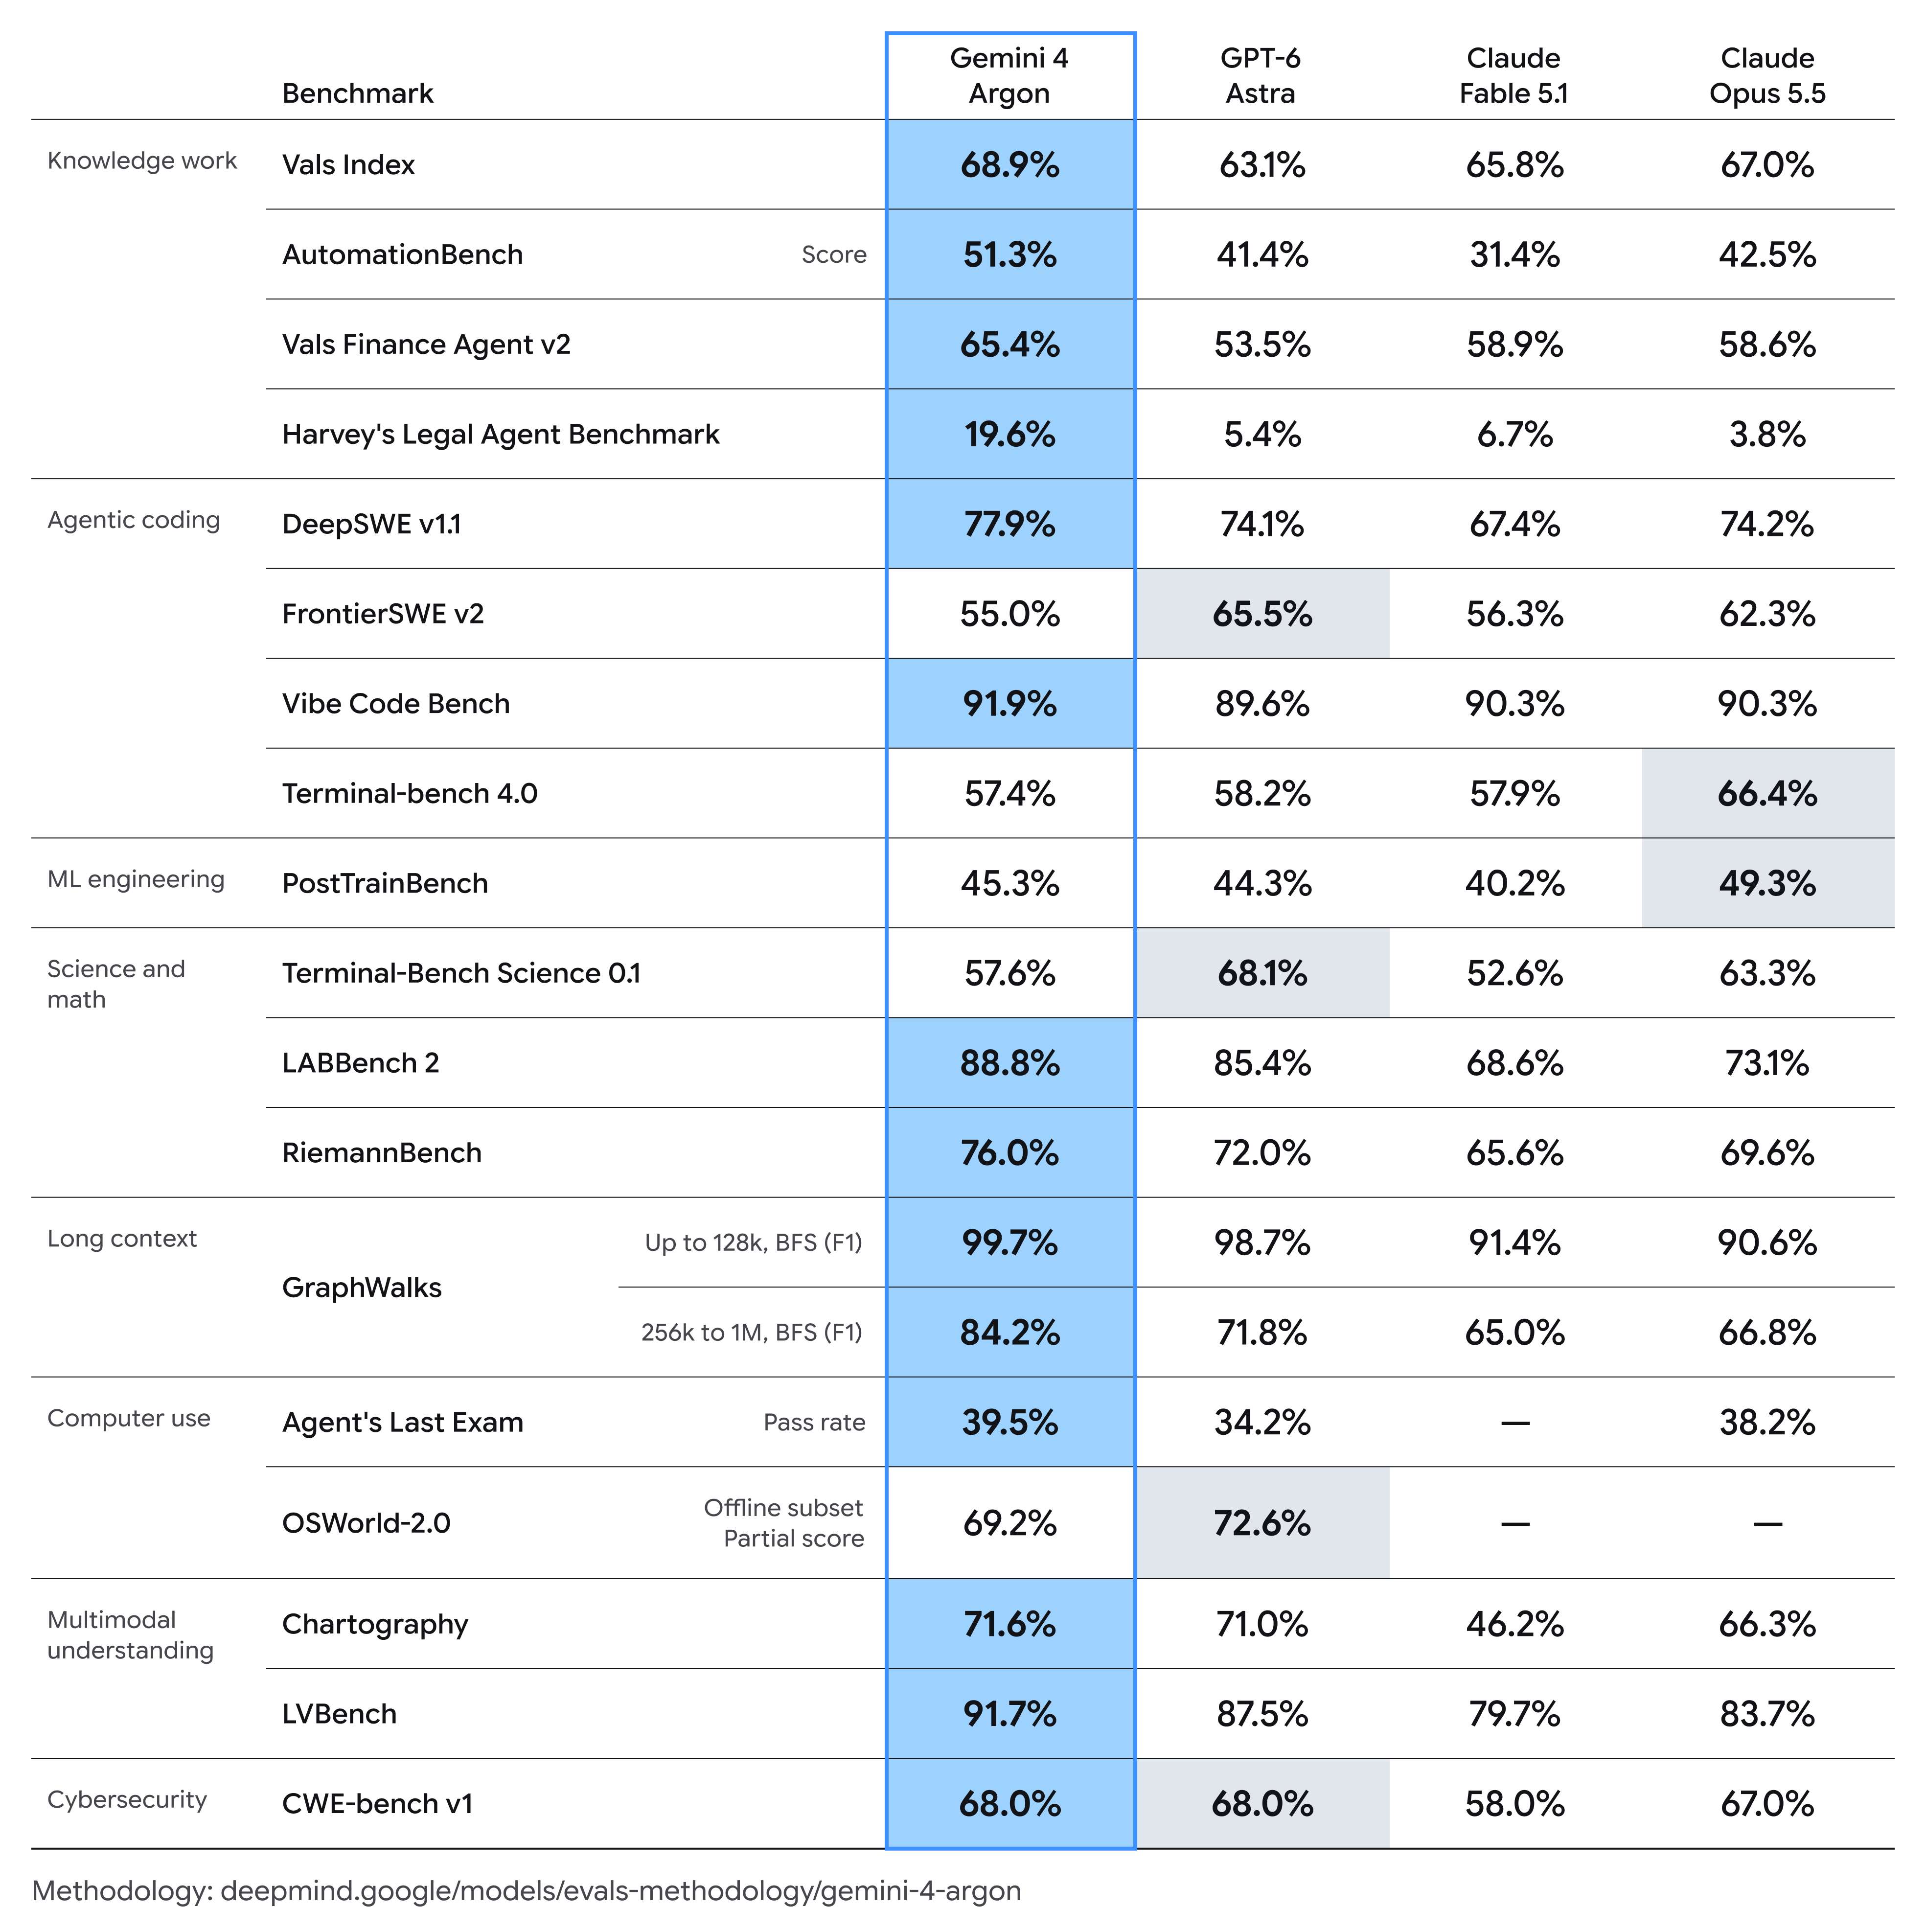
Sobre o preço, um parágrafo é suficiente aqui. Uma solicitação com um prompt de 20.000 tokens e 5.000 tokens de saída custa 20.000 x US$ 2/1M + 5.000 x US$ 10/1M = US$ 0,04 + US$ 0,05 = US$ 0,09 nas taxas introdutórias, e US$ 0,18 nas taxas padrão de US$ 4/US$ 20. O preço de saída introdutório do Argon (US$ 10) está abaixo dos US$ 12 do Gemini 3.1 Pro Preview, e seu preço padrão corresponde exatamente ao Claude Opus 5.5. A análise de preços do Gemini 4 Argon detalha todos os cenários, incluindo entrada em cache e uma resposta máxima de 1M de tokens.
Não codifique um ID de modelo que você encontrou online
Procure pelo ID do modelo Argon e você encontrará strings em sites de benchmark, agregadores e pull requests de código aberto. São placeholders. O Vals AI usa seu próprio slug para sua página de modelo, um pull request do GitHub adiciona um ID "provisoriamente", e o caminho estilo OpenRouter leva a uma página não encontrada. O Google não confirmou nenhum deles, e várias fontes alertam explicitamente contra codificar uma suposição.
Um ID adivinhado falha da maneira menos útil: um 404 em produção no dia da implantação, ou um fallback silencioso se seu wrapper capturar erros de forma muito ampla. Mantenha o nome do modelo na configuração. Em cada exemplo abaixo, o modelo vem de uma variável de ambiente `GEMINI_MODEL` que padroniza para `gemini-3.8-flash`, um modelo estável que você pode chamar hoje. Quando o Google publicar o ID do Argon, você mudará um único valor.
Prepare seu código no Gemini 3.8 Flash
O Gemini 3.8 Flash (`gemini-3.8-flash`) roda nos mesmos endpoints, cabeçalhos e formatos de resposta que o Argon deve usar, a US$ 0,75/US$ 3,75 por 1M tokens até 31 de dezembro de 2026. Sua chave reside em `GEMINI_API_KEY`; nunca a cole no código. A configuração completa está em nosso guia da API Gemini 3.8 Flash.
Passo 1: Envie uma solicitação da API de Interações
A API de Interações é a API principal do Google, Geralmente Disponível desde junho de 2026. Mantenha tanto o modelo quanto o nível de pensamento em variáveis, porque os nomes dos níveis do Argon não foram publicados.
MODEL="${GEMINI_MODEL:-gemini-3.8-flash}"
THINKING="${GEMINI_THINKING:-medium}"

curl -s -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{
    \"model\": \"${MODEL}\",
    \"input\": \"List the retry rules a REST client should follow for HTTP 429.\",
    \"generation_config\": {\"thinking_level\": \"${THINKING}\"}
  }"
O SDK Python precisa do `google-genai` 2.3.0 ou posterior para a API de Interações:
# pip install "google-genai>=2.3.0"
import os
from google import genai

MODEL = os.environ.get("GEMINI_MODEL", "gemini-3.8-flash")
THINKING = os.environ.get("GEMINI_THINKING", "medium")

client = genai.Client()  # lê GEMINI_API_KEY do ambiente
interaction = client.interactions.create(
    model=MODEL,
    input="List the retry rules a REST client should follow for HTTP 429.",
    generation_config={"thinking_level": THINKING},
)
print(interaction.output_text)
No 3.8 Flash, os níveis válidos são `low` (baixo), `medium` (médio) (o padrão) e `high` (alto); `minimal` (mínimo) retorna HTTP 400. Nosso guia de níveis de pensamento explica as compensações. Para trabalho multi-turn, passe o ID da resposta anterior como `previous_interaction_id` e envie `store: false` para desabilitar o armazenamento do lado do servidor.
Passo 2: Mantenha o caminho de generateContent funcionando
A maioria dos códigos existentes chama o endpoint legado `generateContent`, que o Google afirma que continua totalmente suportado. Aqui está a mesma solicitação:
curl -s "https://generativelanguage.googleapis.com/v1beta/models/${MODEL}:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{
    \"contents\": [{\"parts\": [{\"text\": \"List the retry rules a REST client should follow for HTTP 429.\"}]}],
    \"generationConfig\": {\"thinkingConfig\": {\"thinkingLevel\": \"${THINKING}\"}}
  }"
Observe onde o pensamento reside: `generation_config.thinking_level` nas Interações, `generationConfig.thinkingConfig.thinkingLevel` aqui. Se o seu cliente envolver ambos, direcione novos modelos para Interações por padrão. As definições de ferramentas precisam do mesmo cuidado; veja chamada de função do Gemini 3.8 Flash.
Passo 3: Agende uma verificação de entrada em produção com models.list
Não atualize o changelog. Pergunte à API. O endpoint de modelos retorna os modelos disponíveis com seus limites de tokens e métodos suportados:
import os, sys, requests

resp = requests.get(
    "https://generativelanguage.googleapis.com/v1beta/models",
    params={"pageSize": 1000},
    headers={"x-goog-api-key": os.environ["GEMINI_API_KEY"]},
    timeout=30,
)
resp.raise_for_status()
hits = [m for m in resp.json().get("models", []) if "argon" in m["name"].lower()]
for m in hits:
    print(m["name"], "in:", m.get("inputTokenLimit"),
          "out:", m.get("outputTokenLimit"), m.get("supportedGenerationMethods"))
sys.exit(1 if hits else 0)  # uma execução falha é o alerta
Execute-o de hora em hora do cron ou de um agendador de CI, usando a chave que seu aplicativo de produção utiliza. Quando executamos esta chamada em 1º de outubro de 2026, com uma chave de projeto paga, ela retornou 61 modelos, nenhum `nextPageToken` e nenhum nome contendo "argon". No dia em que corresponder, a entrada informará três coisas de uma vez: o nome real do modelo, se `outputTokenLimit` é o 1M completo e quais métodos estão listados.
Passo 4: Simule a resposta para que o cliente seja construído antes do acesso
Você não precisa do Argon para construir o código que consome o Argon. Salve a solicitação do Passo 2 no Apidog com `GEMINI_API_KEY` e `GEMINI_MODEL` como variáveis de ambiente, envie-a uma vez contra o 3.8 Flash e extraia a resposta real para o endpoint como um exemplo de resposta. O Smart Mock padrão do Apidog gera dados a partir do esquema, então defina o método de mock padrão do projeto para "Exemplo de resposta primeiro" (Configurações do Projeto, Configurações de Recursos, Configurações de Mock). A URL de mock então retorna sua resposta salva, para que seu front-end, workers de fila e parsers possam rodar contra ela sem gastar tokens.
Seja claro sobre o que é este mock: o esquema de resposta atual do Gemini, não um esquema específico do Argon, porque o Google não publicou um. Ainda é a aposta certa, já que o Argon deve estar na mesma API. Para ensaiar uma resposta pesada do Argon, edite o `usageMetadata` do exemplo para contagens grandes e confirme que seu código de faturamento e alerta reage.
Passo 5: Afirme em usageMetadata e um teto de custo
Toda resposta de `generateContent` inclui `usageMetadata`. Adicione um script de pós-processamento no Apidog que precifique cada resposta com as taxas padrão do Argon, para que um teste falhe antes que uma conta o faça:
// Pós-processador do Apidog: precifique esta resposta com as taxas padrão do Gemini 4 Argon
const u = pm.response.json().usageMetadata;
const IN = 4 / 1e6;   // USD por token de entrada após o período introdutório
const OUT = 20 / 1e6; // USD por token de saída; o pensamento é cobrado como saída nos modelos Gemini atuais
const out = (u.candidatesTokenCount || 0) + (u.thoughtsTokenCount || 0);
const cost = u.promptTokenCount * IN + out * OUT;
pm.test("usageMetadata está presente", () => pm.expect(u).to.be.an("object"));
pm.test("custo abaixo de US$ 0,10 nas taxas do Argon", () => pm.expect(cost).to.be.below(0.10));
Escolha o teto por solicitação; US$ 0,10 é adequado para um prompt curto como este. O Google não declarou como o Argon cobra os tokens de pensamento, então o script assume a regra atual do Gemini. Mantenha a mesma solicitação salva e execute-a contra o 3.8 Flash agora e o Argon depois: a diferença nas contagens de tokens e no custo é a sua comparação de regressão.
FAQ
A API Gemini 4 Argon está disponível? Não publicamente. O Argon está sendo lançado apenas para um conjunto de parceiros do Programa Fairwind, que o utilizam através do Gemini Enterprise. Clientes de API pagos e assinantes do Google AI Ultra vêm em seguida, sem data definida.
Qual é o ID do modelo Gemini 4 Argon? O Google não publicou um. Strings em sites de terceiros são placeholders, então mantenha o modelo em uma variável de ambiente e monitore `models.list`.
Quanto custará a API Gemini 4 Argon? US$ 2 de entrada e US$ 10 de saída por 1M de tokens durante um período introdutório de duração não especificada, depois US$ 4 e US$ 20. A entrada em cache tem 95% de desconto. Veja preços do Gemini 4 Argon.
O Argon funcionará com generateContent? O Google não disse. Seus documentos afirmam que todos os novos modelos são lançados na API de Interações, então construa em Interações e trate `generateContent` como um fallback.
O Google AI Ultra me dá acesso à API? Não. O AI Ultra é uma assinatura de consumidor, não uma chave de API. O Google diz que o acesso à API começa com clientes de API pagos.
Seu próximo passo
Defina `GEMINI_MODEL` em todos os ambientes, agende a verificação de `models.list` e salve as solicitações de Interações e `generateContent` com a asserção de custo anexada. Baixe o Apidog para manter essas solicitações, mocks e testes em um único espaço de trabalho, e então altere uma variável quando o Google publicar o ID.