
O Google lançou dois novos modelos de fala para fala em 15 de setembro de 2026, e a discussão no Hacker News atingiu 337 pontos em um dia. Essa é uma grande reação para o lançamento de uma API de voz, e a maior parte da discussão não foi sobre o vídeo de demonstração. Foram desenvolvedores fazendo a mesma pergunta: quanto custa construir com isso, e como você realmente se conecta a ele?
Este é esse guia. gemini-3.8-live e gemini-3.8-live-extended-thinking estão sendo lançados agora na API Gemini e no Google AI Studio, com acesso ao Gemini Enterprise e Search Live em prévia privada. Ambos os modelos aceitam tokens de entrada e saída gratuitos, além de um nível pago com taxas por token e por minuto, o que é incomum o suficiente para um modelo de áudio ao vivo que vale a pena detalhar a própria sessão WebSocket, e não apenas a página de preços. Já comparamos os assistentes de voz de consumo em GPT-Live vs Gemini Live; este artigo é o caminho do desenvolvedor para a API por trás de um lado dessa comparação.
O que foi lançado de fato em 15 de setembro
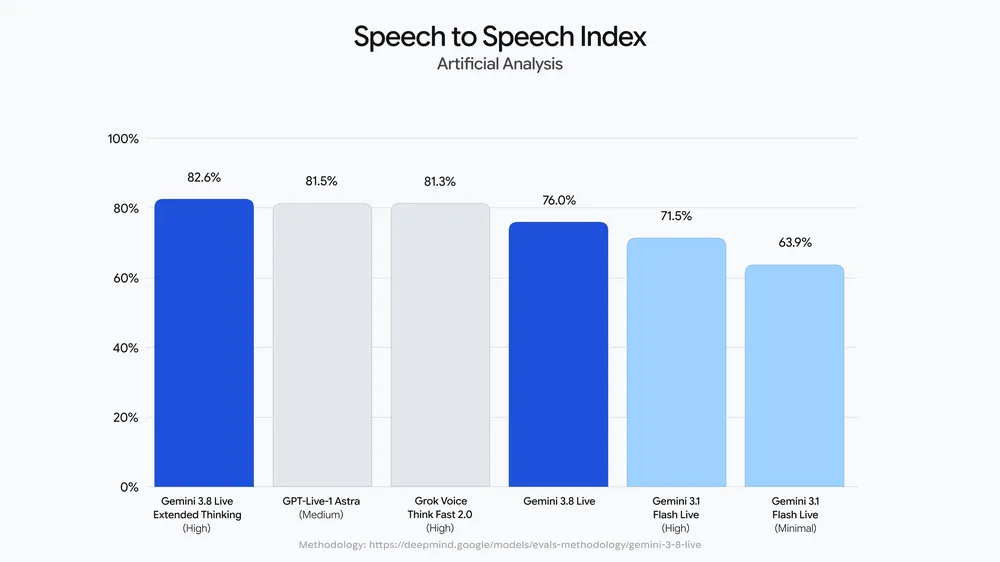
O anúncio do Google cobre dois modelos. gemini-3.8-live é o modelo padrão de fala para fala. gemini-3.8-live-extended-thinking adiciona uma camada de raciocínio que é executada enquanto o modelo fala, descrita abaixo. Ambos suportam 97 idiomas com troca automática durante a conversa, o que significa que um chamador pode começar uma frase em inglês e terminá-la em espanhol sem uma sinalização manual de idioma.
Disponibilidade no lançamento: a API Gemini e o Google AI Studio (acesso geral), além do Gemini Enterprise e Search Live (prévia privada, então a maioria dos desenvolvedores lendo isso começará na API ou no AI Studio). Tokens gratuitos se aplicam a ambos os modelos, tanto na entrada quanto na saída, o que coloca um protótipo real ao alcance antes de você tocar em um cartão de crédito.
Um detalhe que o Google não publicou: limites de taxa da camada gratuita para os dois modelos Live. A página de limites de taxa é a fonte da verdade assim que os lista; trate qualquer número que você veja em outro lugar como não confirmado até que você mesmo o verifique lá.
O acesso ao Search Live e Gemini Enterprise ser apenas em prévia privada, em vez de aberto como a API, é um sinal que vale a pena ler: o Google está confortável em permitir que desenvolvedores construam sobre isso de maneiras próximas à produção antes de comprometer o mesmo modelo com a busca do consumidor ou assentos empresariais pagos. Isso é normal para o lançamento de um modelo de fala, e significa que a superfície da API é o ponto de partida estável agora, não uma prévia simplificada de uma melhor experiência para o consumidor que chegará mais tarde.
Obtenha uma chave de API gratuita e abra uma sessão
Uma chave da API Gemini vem do Google AI Studio, vinculada a uma conta Google, e funciona com os modelos Live no mesmo dia em que são lançados, já que não há uma etapa de aprovação separada para o nível gratuito. Uma vez que você tenha a chave, o ponto de conexão é um WebSocket, não um endpoint REST, o que é o primeiro ajuste se você está acostumado com chamadas generateContent:
wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent
Essa URL vem do artigo prático de Simon Willison do dia do lançamento, publicado junto com sua análise detalhada usual de uma nova API. Ele também sinalizou algo que vale a pena saber antes de construir uma UI em torno disso: você pode interromper o modelo no meio da resposta da mesma forma que interromperia uma pessoa falando, e a transcrição que retorna pode incluir fala que o modelo começou a gerar, mas nunca terminou de reproduzir, porque a reprodução foi cortada pela sua interrupção. Lide com isso como um estado distinto em seu cliente, em vez de assumir que cada linha da transcrição foi ouvida na íntegra.
Uma sessão bidirecional sobre esse socket segue o formato que toda API de streaming baseada em WebSocket usa: uma mensagem de configuração primeiro, identificando o modelo e sua configuração de geração, depois um fluxo de mensagens de conteúdo transportando pedaços de áudio ou texto em qualquer direção, com o servidor enviando segmentos de resposta parciais e finais conforme estão prontos. O esquema exato da mensagem cabe ao Google documentar com precisão, e ele pode mudar entre a prévia e a disponibilidade geral, então verifique os nomes dos campos em relação à documentação da API Gemini ao vivo e à referência do seu SDK antes de se comprometer com um cliente de produção. O que é estável é o padrão: conectar, enviar configuração, transmitir conteúdo, ler respostas transmitidas e esperar que a interrupção seja um evento normal, e não um caso de erro.
Na prática, isso significa que sua primeira sessão de trabalho deve almejar o menor loop possível: abra o socket, envie uma mensagem de configuração nomeando o modelo desejado (gemini-3.8-live ou gemini-3.8-live-extended-thinking), envie uma única e curta entrada de áudio ou texto, e confirme que você recebe uma resposta transmitida de volta antes de adicionar lógica de nova tentativa, tratamento de reconexão ou uma UI. Construa o caminho de interrupção em segundo lugar, depois que o caminho feliz funcionar, já que testá-lo bem significa falar deliberadamente sobre o modelo no meio da resposta e verificar se seu cliente marca corretamente a transcrição cortada, em vez de tratá-la como uma interação completa.
Pensamento estendido: quando o raciocínio acontece em voz alta
O modelo gemini-3.8-live padrão responde diretamente. gemini-3.8-live-extended-thinking faz algo diferente: o Google diz que ele “raciocina e fala simultaneamente”, mantendo o que chama de “fluxo conversacional ininterrupto” preenchendo o tempo de raciocínio com sinais verbais, frases como “Deixe-me verificar isso” em vez de silêncio enquanto o modelo trabalha.
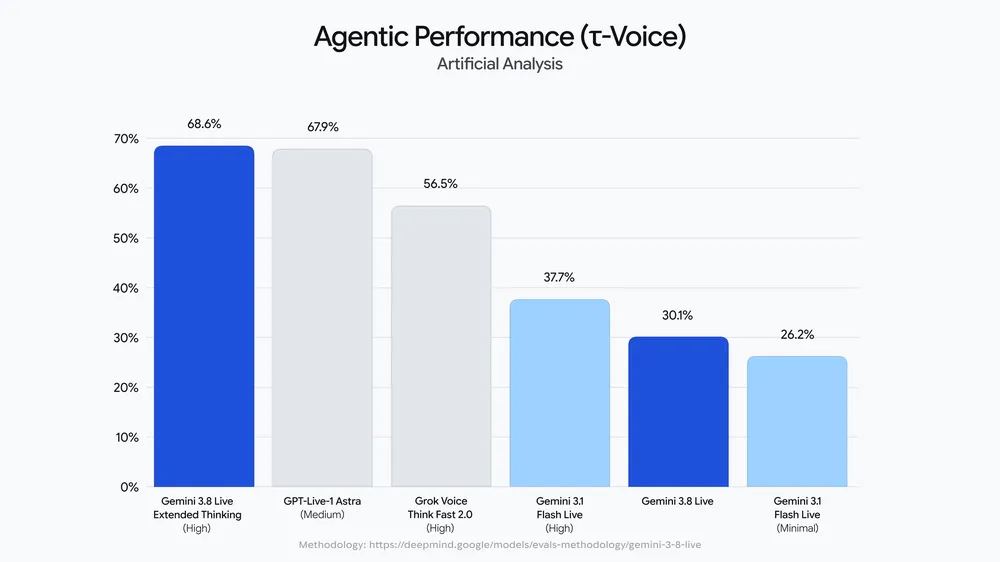
Isso importa para uma classe específica de aplicativo: agentes de voz que chamam ferramentas ou acessam APIs externas no meio da conversa. O modelo de pensamento estendido “executa ferramentas e chamadas de API em segundo plano enquanto continua a conversa”, e a chamada de função é suportada em ambos os modelos. Imagine um agente de reservas que precisa verificar a disponibilidade em uma API de calendário: em vez de ficar em silêncio por dois segundos enquanto a consulta é executada, o modelo pode reconhecer a solicitação em voz alta e manter a troca acontecendo enquanto a chamada é concluída em segundo plano.
Escolha o pensamento estendido quando sua sessão incluir chamadas de ferramentas, consultas de várias etapas ou respostas que exigem muito raciocínio, onde uma pausa silenciosa pareceria quebrada. Escolha o modelo simples para trocas mais curtas e de baixa latência, onde a sobrecarga de raciocínio não é necessária. Ambos custam o mesmo por token, então a escolha é sobre comportamento, não orçamento. Se seu agente se baseia especificamente na chamada de função, nosso guia de chamada de função para Gemini 3.8 Flash cobre o formato de solicitação que o Google usa em toda a família Gemini 3.8 atual, embora você deva confirmar o payload de chamada de função específico do Live com a documentação da API Live antes do lançamento, já que as APIs de texto e fala não são garantidas de compartilhar um esquema.
Quanto custa, calculado
Ambos os modelos Live compartilham os mesmos preços padrão:
| Tipo | Taxa |
|---|---|
| Entrada de texto | US$ 0,75 por 1M de tokens |
| Entrada de áudio | US$ 3,00 por 1M de tokens, ou US$ 0,005 por minuto |
| Entrada de imagem/vídeo | US$ 1,00 por 1M de tokens, ou US$ 0,002 por minuto |
| Saída de texto | US$ 4,50 por 1M de tokens |
| Saída de áudio | US$ 12,00 por 1M de tokens, ou US$ 0,018 por minuto |
Tokens de raciocínio são cobrados como saída, o mesmo que qualquer outro modelo Gemini 3.x, então o raciocínio em segundo plano do pensamento estendido aparece na linha de saída, e não como uma cobrança separada.
Exemplo prático: uma chamada de voz de 10 minutos, áudio de entrada e saída o tempo todo, na camada padrão paga. Entrada de áudio: 10 minutos x US$ 0,005 = US$ 0,05. Saída de áudio: 10 minutos x US$ 0,018 = US$ 0,18. Total: US$ 0,23 para uma conversa completa de 10 minutos de ida e volta, antes que quaisquer tokens de texto ou chamada de ferramenta sejam adicionados. Execute essa mesma chamada na camada gratuita durante a prototipagem e o custo do token será zero, sujeito ao limite de taxa que o Google eventualmente publicar para ela.
O modelo gemini-3.1-flash-live-preview na mesma página de preços tem taxas idênticas aos dois novos modelos Live, o que vale a pena verificar se você já tem uma integração Live naquele modelo mais antigo; a decisão de preços não é um motivo para adiar a migração.
O que os desenvolvedores estão dizendo, até agora
A discussão no Hacker News não é uniformemente positiva. Uma reclamação recorrente: assinantes pagos do Google Workspace e Google AI Plus ainda não têm acesso ao consumidor à nova experiência Live, mesmo sendo clientes pagantes, enquanto o acesso à API e ao AI Studio é aberto. Um relato do tópico descreveu um loop agêntico onde o modelo inventou requisitos extras que não faziam parte da tarefa original, um modo de falha que vale a pena testar especificamente se você está conectando o Live a um agente autônomo em vez de um assistente de voz com humano no circuito. Se você está construindo algo mais próximo de um loop autônomo do que um assistente supervisionado, adicione uma verificação explícita que compare o que o modelo afirma precisar com a definição da tarefa que você forneceu, em vez de confiar nas exigências declaradas do modelo ao pé da letra. Trate ambos os pontos como um sinal do primeiro dia de um único tópico, não um relatório de defeito verificado, e reteste em relação ao seu próprio caso de uso antes de generalizar a partir deles.
Veja o protocolo bruto antes de escrever o código do cliente
Antes de se comprometer com uma biblioteca cliente, ajuda observar os quadros reais passando pela rede. O Apidog pode abrir uma conexão WebSocket com o endpoint `BidiGenerateContent`, enviar a mensagem de configuração JSON e as mensagens de conteúdo subsequentes manualmente, e mostrar os quadros transmitidos retornando em tempo real, que é a maneira mais rápida de entender o padrão de configuração-depois-fluxo antes de escrever uma única linha de código SDK em torno dele. O Apidog não captura áudio do microfone para você; você fornece os payloads de áudio ou texto e usa a conexão para inspecionar o que o servidor envia de volta, confirmar se sua mensagem de configuração é aceita e observar como a interrupção se comporta antes de construir o tratamento de erros para ela em produção. A referência completa do protocolo para construir e testar APIs WebSocket dessa forma está em docs.apidog.com. Baixe o Apidog para testar a conexão você mesmo antes da sua primeira construção de cliente.
Para comparação, nossa análise WebSocket vs WebRTC aborda por que o Google escolheu um WebSocket para este fluxo bidirecional em vez do caminho WebRTC que algumas APIs de voz concorrentes usam, e o que essa troca significa especificamente para clientes de navegador.
FAQ
A API Gemini 3.8 Live é gratuita? Sim, para ambos os modelos, os tokens de entrada e saída são gratuitos na camada gratuita. As taxas padrão pagas se aplicam assim que você ultrapassa o limite de taxa que o Google definir, e esse limite da camada gratuita ainda não foi publicado, então verifique a página de limites de taxa diretamente.
Qual a diferença entre os dois novos modelos? gemini-3.8-live responde diretamente. gemini-3.8-live-extended-thinking raciocina enquanto fala, usando preenchimento verbal para cobrir chamadas de ferramentas em segundo plano e consultas em várias etapas, pelo mesmo preço por token.
Preciso de WebRTC para usar isso? Não. A API é baseada em WebSocket, conectando-se a um endpoint `BidiGenerateContent` em vez de uma conexão ponto a ponto WebRTC.
Posso testar isso sem escrever um cliente? Sim. Abra o WebSocket no Apidog, envie as mensagens de configuração e conteúdo manualmente e leia a resposta transmitida antes de construir um cliente real em torno dela.