
O Firecrawl auto-hospedado costumava significar uma coisa: clonar o repositório, rodar o Docker Compose e manter uma API, um serviço Playwright, Redis, RabbitMQ e Postgres ativos na sua máquina. Em 18 de novembro de 2026, o Firecrawl lançou uma segunda opção. O Firecrawl Local é um único binário em Rust que faz scraping, crawling e map de sites para markdown e responde à mesma API v2 em localhost:3002, sem banco de dados, fila ou contêiner.
Resposta rápida: escolha o Firecrawl Local se quiser scrape, crawl, map e batch scrape em um notebook ou no arsenal de ferramentas de um agente, com zero infraestrutura. Mantenha a stack Docker auto-hospedada se precisar de jobs persistentes, dos formatos json e summary, de extração via LLM com o seu próprio modelo, ou de uma rota de busca que nunca toque o Firecrawl Cloud.
O que é o Firecrawl auto-hospedado e o que é o Firecrawl Local?
O Firecrawl auto-hospedado é o servidor Firecrawl completo do apps/api, executado na sua própria infraestrutura com Docker Compose. O Firecrawl Local é uma build separada e mais leve em apps/local: um único binário que busca e limpa páginas na sua máquina usando o mesmo código de limpeza de HTML, e delega busca, páginas bloqueadas e Alexandria ao Firecrawl Cloud.
Ambos residem no repositório do Firecrawl no GitHub, ambos servem a API v2 na porta 3002 e ambos são de código aberto sob AGPL-3.0. O Firecrawl Local não substitui o servidor. O README do Firecrawl Local diz isso diretamente: o guia de auto-hospedagem "vive em apps/api e não é alterado pelo Firecrawl Local".
Novo no Firecrawl? Comece pelo nosso guia de web scraping do Firecrawl.
Firecrawl Local vs Firecrawl auto-hospedado em resumo
Aqui está a versão curta, montada a partir do guia de auto-hospedagem, da página de código aberto vs cloud e do README do Local, todos lidos em 19 de novembro de 2026.
| Firecrawl auto-hospedado | Firecrawl Local | |
|---|---|---|
| O que você executa | Stack Docker Compose: api, playwright-service, redis, rabbitmq, nuq-postgres | Um binário, firecrawl-local |
| Instalação | git clone, escrever .env, docker compose up --build -d |
cargo install firecrawl-local |
| Pré-requisitos | Git, Docker Engine, Compose v2 | Rust e um compilador C; Chrome e Node 22+ opcionais |
| API | v2 na porta 3002 | v2 na porta 3002 (scrape, map, crawl, batch scrape, health) |
| Rota de busca | Incluída na stack padrão | Encaminhada ao Firecrawl Cloud |
Formatos de LLM (json, summary) |
Conecte um provedor compatível com OpenAI ou Ollama | Ignorados com um aviso |
| Capturas de tela | Exigem Fire-engine, que não está na stack padrão | Funcionam se o Chrome estiver instalado |
actions de navegador |
Exigem Fire-engine | Ignoradas |
| Armazenamento de jobs | Fila apoiada em Postgres | Em memória, expira após 1 hora |
| Alexandria | Não listada na tabela de recursos da auto-hospedagem | Via Firecrawl Cloud com uma conta gratuita |
| Configuração de MCP | Aponte o servidor MCP para a sua URL | firecrawl-local init grava a configuração |
| Licença | AGPL-3.0 | AGPL-3.0 |
O Local troca profundidade por leveza: mantém as rotas que os agentes mais chamam e abandona o que exige fila, modelo ou um parque de navegadores.
O que mudou: de cinco serviços a um único binário
O caminho auto-hospedado fixa a release v2.11.162 em seu guia. Você clona o repositório, escreve um pequeno .env com as credenciais do Postgres e USE_DB_AUTHENTICATION=false, e então compila e inicia a stack:
git clone https://github.com/firecrawl/firecrawl.git
cd firecrawl
git checkout v2.11.162
docker compose up --build -d
docker compose ps --all
Esse arquivo compose inicia um contêiner api (que também executa os workers), um playwright-service para renderização, redis, rabbitmq e nuq-postgres para a fila de jobs. O arquivo compose limita a API a 4 CPUs e 8 GB de memória, e o serviço Playwright a 2 CPUs e 4 GB, e o guia observa que esses limites "não são requisitos mínimos verificados".
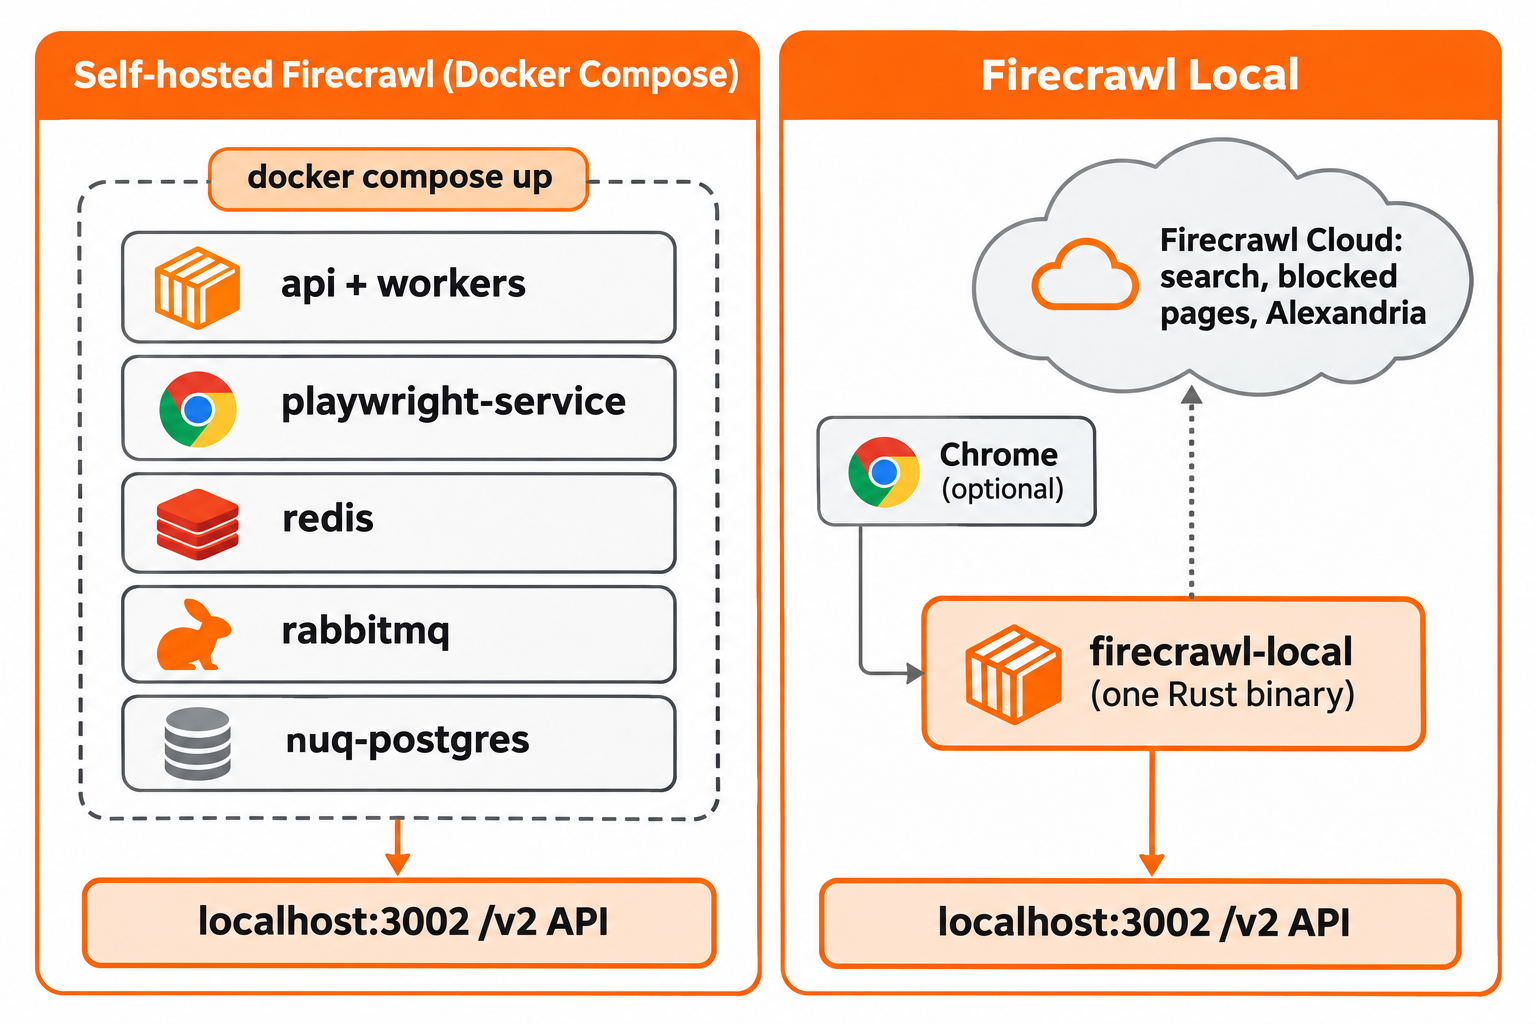
O Firecrawl Local reduz tudo isso a um único comando:
cargo install firecrawl-local
firecrawl-local scrape https://example.com --markdown
firecrawl-local crawl https://docs.firecrawl.dev --limit 50 --out ./pages
firecrawl-local map https://firecrawl.dev
firecrawl-local serve
Não há .env nem contêineres. Páginas JavaScript são renderizadas no Chrome ou Chromium que você já tem; sem um deles, as páginas estáticas ainda funcionam e o restante retorna um aviso.
Os comandos search, find-tools, data e login acessam o Firecrawl Cloud. O firecrawl-local login reutiliza as credenciais da CLI hospedada do nosso guia de instalação da Firecrawl CLI.
Cobertura de endpoints: o que cada um serve
É aqui que as migrações quebram, então verifique antes de trocar a URL base de um SDK.
O Firecrawl Local serve estas rotas na sua máquina:
POST /v2/scrapefaz scrape de uma URLPOST /v2/maplista as URLs de um sitePOST /v2/crawl, além deGETeDELETE /v2/crawl/{id}POST /v2/batch/scrape, além deGETeDELETE /v2/batch/scrape/{id}GET /health
Todas as outras rotas /v2, como /v2/search, são encaminhadas ao Firecrawl Cloud, a menos que FIRECRAWL_CLOUD diga o contrário. As rotas v0 e v1 não são servidas de forma alguma.
O Firecrawl auto-hospedado cobre scrape, crawl, map e busca essenciais na sua stack padrão, segundo a página de código aberto vs cloud. A extração com LLM exige um provedor que você conecta. Agent, Browser, Interact e o dashboard não estão incluídos.
Dois problemas práticos:
- Os health checks são diferentes. O guia de auto-hospedagem verifica a prontidão em
/v0/health/readiness. O Firecrawl Local não serve v0, então useGET /health. Atualize seus monitores e os healthchecks do compose. - A busca muda de onde é executada. Na stack Docker, a busca permanece na sua infraestrutura. No Local, ela vai para o Firecrawl Cloud, e a busca sem chave tem limite de requisições. Defina
FIRECRAWL_CLOUD=offse nada puder sair da máquina; a busca então para de funcionar.
Velocidade e memória: leia as alegações com atenção
O post de lançamento no X do Firecrawl diz que o Firecrawl Local é uma "primitiva de scrape em Rust 37x mais rápida (vs auto-hospedado)" e usa "230x menos memória (11 MB ocioso)". O post teve cerca de 324 mil visualizações e 3,2 mil curtidas no primeiro dia.
Trate esses números como alegações do Firecrawl. O README não publica método de benchmark, conjunto de páginas nem hardware, então não podemos dizer o que o "37x" mediu. O que a arquitetura sustenta é a direção: um processo ocioso deve pesar muito menos do que cinco contêineres cujos limites do compose permitem até 12 GB somente entre os serviços API e Playwright.
Se a velocidade decidir sua escolha, meça nas suas próprias URLs. Execute o mesmo scrape nos dois servidores, compare os tempos e verifique se o markdown coincide. A seção sobre a Apidog CLI abaixo mostra uma forma de transformar isso em um teste repetível.
Segurança, transferência para a nuvem e fluxo de dados
A auto-hospedagem lhe dá controle total e responsabilidade total. O quickstart do guia desativa a autenticação e avisa que ela "não é uma arquitetura de produção", então volumes duráveis, autenticação, TLS e monitoramento ficam por sua conta.
O Firecrawl Local vem com padrões mais restritivos para uma única máquina:
servese vincula a127.0.0.1e recusa localhost e endereços privados, a menos que você passe--allow-private.- Endereços link-local e de metadados da nuvem são bloqueados em todos os modos, inclusive após redirecionamentos.
scrape,crawlemcpaceitam--public-only, que o README recomenda quando um agente navega em sites nos quais você não confia.- Crawls respeitam o
robots.txt.
O trade-off é a transferência para a nuvem. Com o padrão FIRECRAWL_CLOUD=auto, busca, páginas que bloqueiam sua máquina e Alexandria vão para o Firecrawl Cloud. Esses resultados carregam "source": "firecrawl-cloud". Defina FIRECRAWL_CLOUD=search para permitir apenas busca, ou off para não enviar nada.
Alexandria, o catálogo de provedores de dados do Firecrawl, exige uma conta gratuita e firecrawl-local login. Nosso explicador sobre o Firecrawl Alexandria cobre o que ele retorna.
Qual escolher?
Escolha o Firecrawl Local se:
- Você quer que um agente de IA faça scrape e crawl no seu notebook. O
firecrawl-local initadiciona o servidor MCP ao Claude Code, Claude Desktop, Cursor, Windsurf, Gemini CLI e Codex, fazendo backup de cada configuração antes. - Você executa jobs curtos que terminam em até uma hora.
- Você só precisa de markdown, HTML, HTML bruto e links.
- Você não quer administrar Postgres, Redis e RabbitMQ.
Mantenha o Firecrawl auto-hospedado se:
- Jobs de crawl precisam sobreviver a um reinício ou durar mais de uma hora.
- Você precisa de saída
jsonousummaryatravés do seu próprio modelo. - A busca precisa permanecer na sua infraestrutura.
- Vários serviços ou usuários compartilham um único backend de scraping atrás da sua autenticação.
Muitas equipes vão usar os dois: o Local em notebooks e agentes, a stack Docker ou o Firecrawl Cloud em produção. Para configurações de agentes que só precisam de busca, nossa compilação de busca na web open-source para o Claude lista outras opções, e o guia do Firecrawl MCP e llms.txt cobre o servidor MCP hospedado.
Migrando o código do SDK do auto-hospedado para o Local
O código do seu SDK não muda, apenas a URL: defina a URL da API do SDK Python ou Node para http://localhost:3002, sem chave de API para rotas locais. Antes de trocar, confirme que seu código não faz chamadas v0 ou v1, nunca pede json, summary ou actions, e nunca consulta um ID de crawl com mais de uma hora ou entre reinícios do serve.
Deixe seu agente de código executar um teste de paridade com a Apidog CLI
Trocar de backend é uma questão de contrato: o /v2/scrape no Local retorna a mesma estrutura que seu código já trata? Não compare as respostas manualmente. Execute os dois servidores lado a lado (Docker na 3002, firecrawl-local serve --port 3012) e deixe seu agente de código testar ambos com a Apidog CLI.
Configure uma vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Então dê ao seu agente um único prompt:
Self-hosted Firecrawl runs on http://localhost:3002 and Firecrawl Local on
http://localhost:3012. In Apidog project <id>, create two environments,
"self-hosted" and "local". Add test cases for POST /v2/scrape on
https://example.com (assert 200, success: true, non-empty data.markdown) and
POST /v2/map (assert 200 and a non-empty links array). Run the cases against
both environments and tell me every assertion that differs.
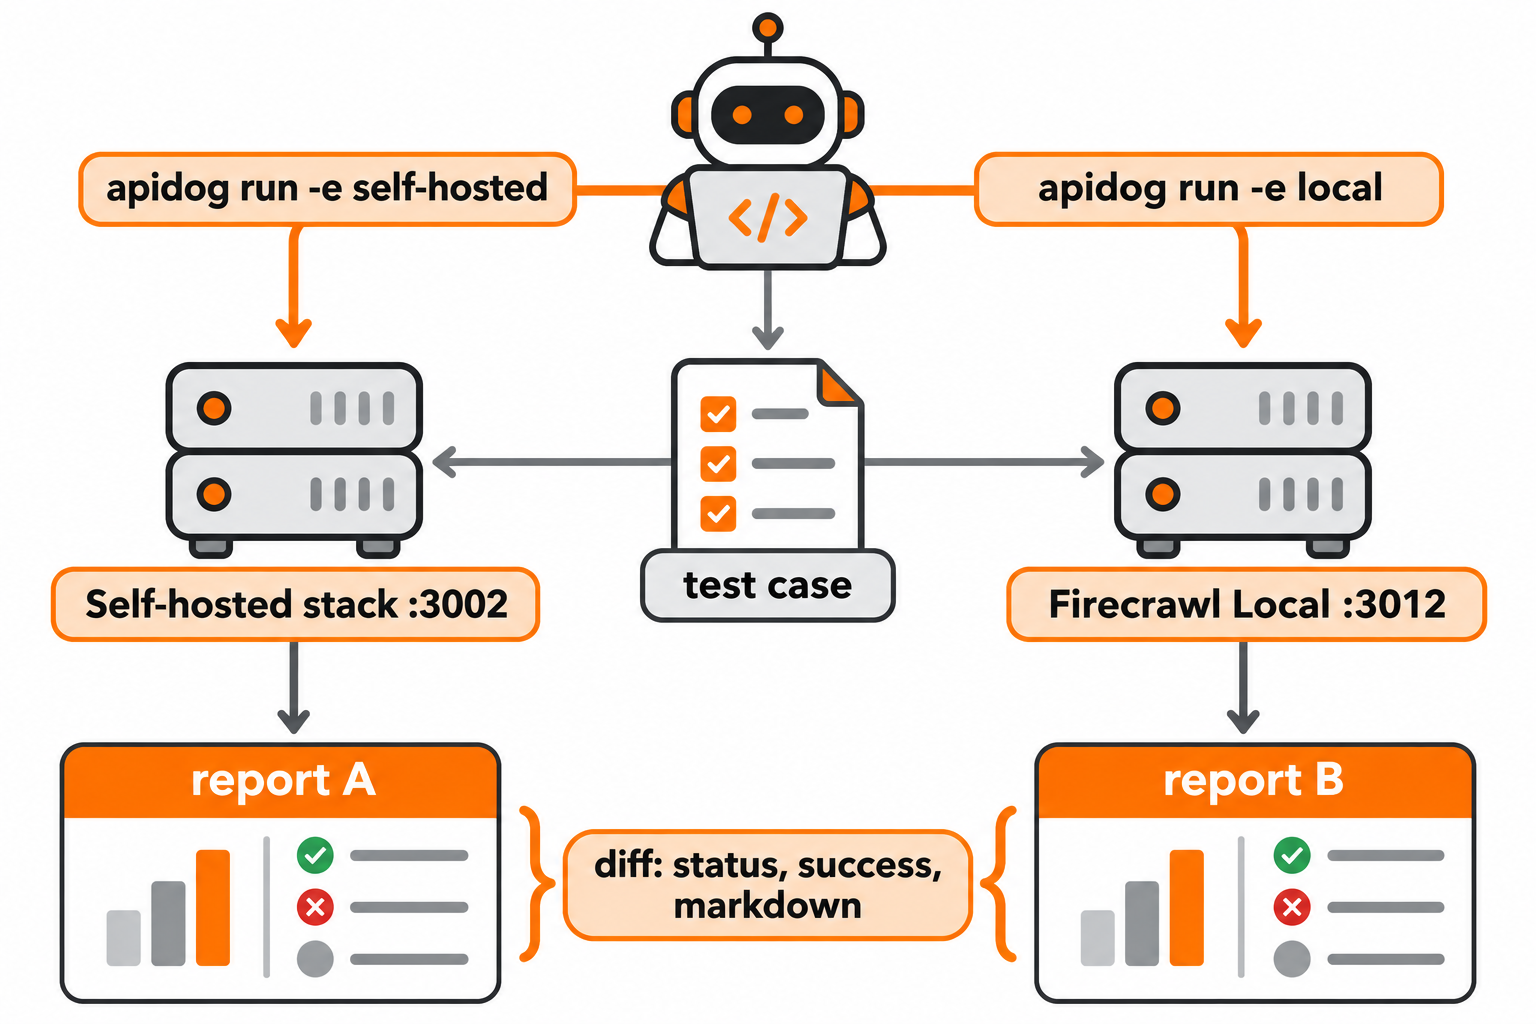
O agente lê o schema do payload, valida e executa o mesmo caso duas vezes:
firecrawl-local serve --port 3012 &
apidog environment create self-hosted --project <id> --base-url http://localhost:3002
apidog environment create local --project <id> --base-url http://localhost:3012
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file scrape-case.json
apidog test-case create --project <id> --file scrape-case.json
apidog run --test-case <caseId> --project <id> -e <selfHostedEnvId> -r cli,json --out-file self-hosted
apidog run --test-case <caseId> --project <id> -e <localEnvId> -r cli,json --out-file local
A Apidog CLI envia requisições da sua máquina, então ambas as portas localhost são acessíveis. Troque -r cli,json por -r junit e a mesma verificação roda no CI a cada atualização do Firecrawl; nosso guia de CI/CD da Apidog CLI mostra a configuração, e Apidog CLI no Claude Code cobre o lado do agente. O plano Free da Apidog atende equipes de até 4 usuários.
Perguntas frequentes
O Firecrawl Local substitui o Firecrawl auto-hospedado? Não. É uma build separada em apps/local. O servidor completo em apps/api e seu guia de auto-hospedagem permanecem inalterados, e você ainda precisa dele para jobs persistentes e formatos de LLM.
O Firecrawl Local é realmente 37x mais rápido que o Firecrawl auto-hospedado? Essa é a alegação do Firecrawl em seu post de lançamento, junto com 230x menos memória e 11 MB ocioso. O README não publica método de benchmark, então teste com suas próprias URLs.
O Firecrawl Local funciona sem a nuvem? Sim. Defina FIRECRAWL_CLOUD=off e scraping, crawling e mapping permanecem na sua máquina. A busca, o fallback de páginas bloqueadas e Alexandria param de funcionar.
O Firecrawl auto-hospedado é gratuito? O código é gratuito sob AGPL-3.0, tanto para o servidor quanto para o Local. Você paga pelas máquinas e pelo tempo de administrar Postgres, Redis e RabbitMQ por conta própria.
Qual deles um agente de IA deve usar? O Firecrawl Local, na maioria dos casos. O firecrawl-local init o registra como servidor MCP em seis ferramentas de agente, e --public-only impede que um agente alcance sua rede privada.