ERNIE 5.5 Flash vs DeepSeek V4.1 Flash vs GPT-6 Luna se resume a três barganhas diferentes. O ERNIE 5.5 Flash Preview pode ser chamado gratuitamente hoje no OpenRouter. O DeepSeek V4.1 Flash oferece pesos abertos sob licença MIT e preços de $0,30/$1,20 por 1M de tokens em horário de pico, metade disso fora do pico. O GPT-6 Luna tem o menor preço oficial pago: $0,10 de entrada e $0,50 de saída.
Todos os três aceitam cerca de 1M de tokens de contexto e chamam ferramentas. Eles diferem na estrutura de preços, nos pesos e na maturidade. Todos os preços abaixo foram coletados nas páginas oficiais em 12 de novembro de 2026, e a última seção mostra o seu agente de codificação testando os três com um único prompt.
ERNIE 5.5 Flash vs DeepSeek V4.1 Flash vs GPT-6 Luna em resumo
| ERNIE 5.5 Flash Preview | DeepSeek V4.1 Flash | GPT-6 Luna | |
|---|---|---|---|
| ID do modelo na API | baidu/ernie-5.5-flash-preview:free (OpenRouter) |
deepseek-flash |
gpt-6-luna |
| Entrada por 1M | Grátis no OpenRouter; preço pago [VERIFICAR] | $0,30 em horário de pico, $0,15 fora do pico | $0,10 |
| Entrada em cache por 1M | n/d no endpoint gratuito | $0,006 em pico, $0,003 fora do pico | $0,01 |
| Saída por 1M | Grátis no OpenRouter; preço pago [VERIFICAR] | $1,20 em pico, $0,60 fora do pico | $0,50 |
| Janela de contexto | 1.024.000 tokens | 1M tokens | 1.050.000 tokens |
| Saída máxima | 1.024.000 (listagem do OpenRouter) | 384K | 128.000 |
| Parâmetros | 280B no total, 14B ativos (MoE) | Backbone de 552B, 8B ativos no prefill / 16B no decode | Não publicado |
| Tipos de entrada | Texto | Texto, imagem | Texto, imagem |
| Pesos abertos | Modelo base sim; Preview “em breve” sob Apache 2.0 | Sim, MIT | Não |
| Status | Checkpoint de preview | Produção (versão 1017) | Produção |
Fontes: post de lançamento da Baidu, OpenRouter, preços da DeepSeek e página da Luna da OpenAI.
O que é cada modelo barato
O ERNIE 5.5 Flash Preview é o primeiro modelo pós-treinado da Baidu sobre o ERNIE 5.5 Flash Base, que ela lançou no Hugging Face no início de novembro. É um modelo esparso de mistura de especialistas (MoE) com 280B de parâmetros, sendo 14B ativos, e um contexto de 1M de tokens. A Baidu o chama de checkpoint intermediário: o pós-treinamento ainda não está concluído. Contexto adicional: o que é o ERNIE 5.5 Flash e o ERNIE 5.1 anterior.
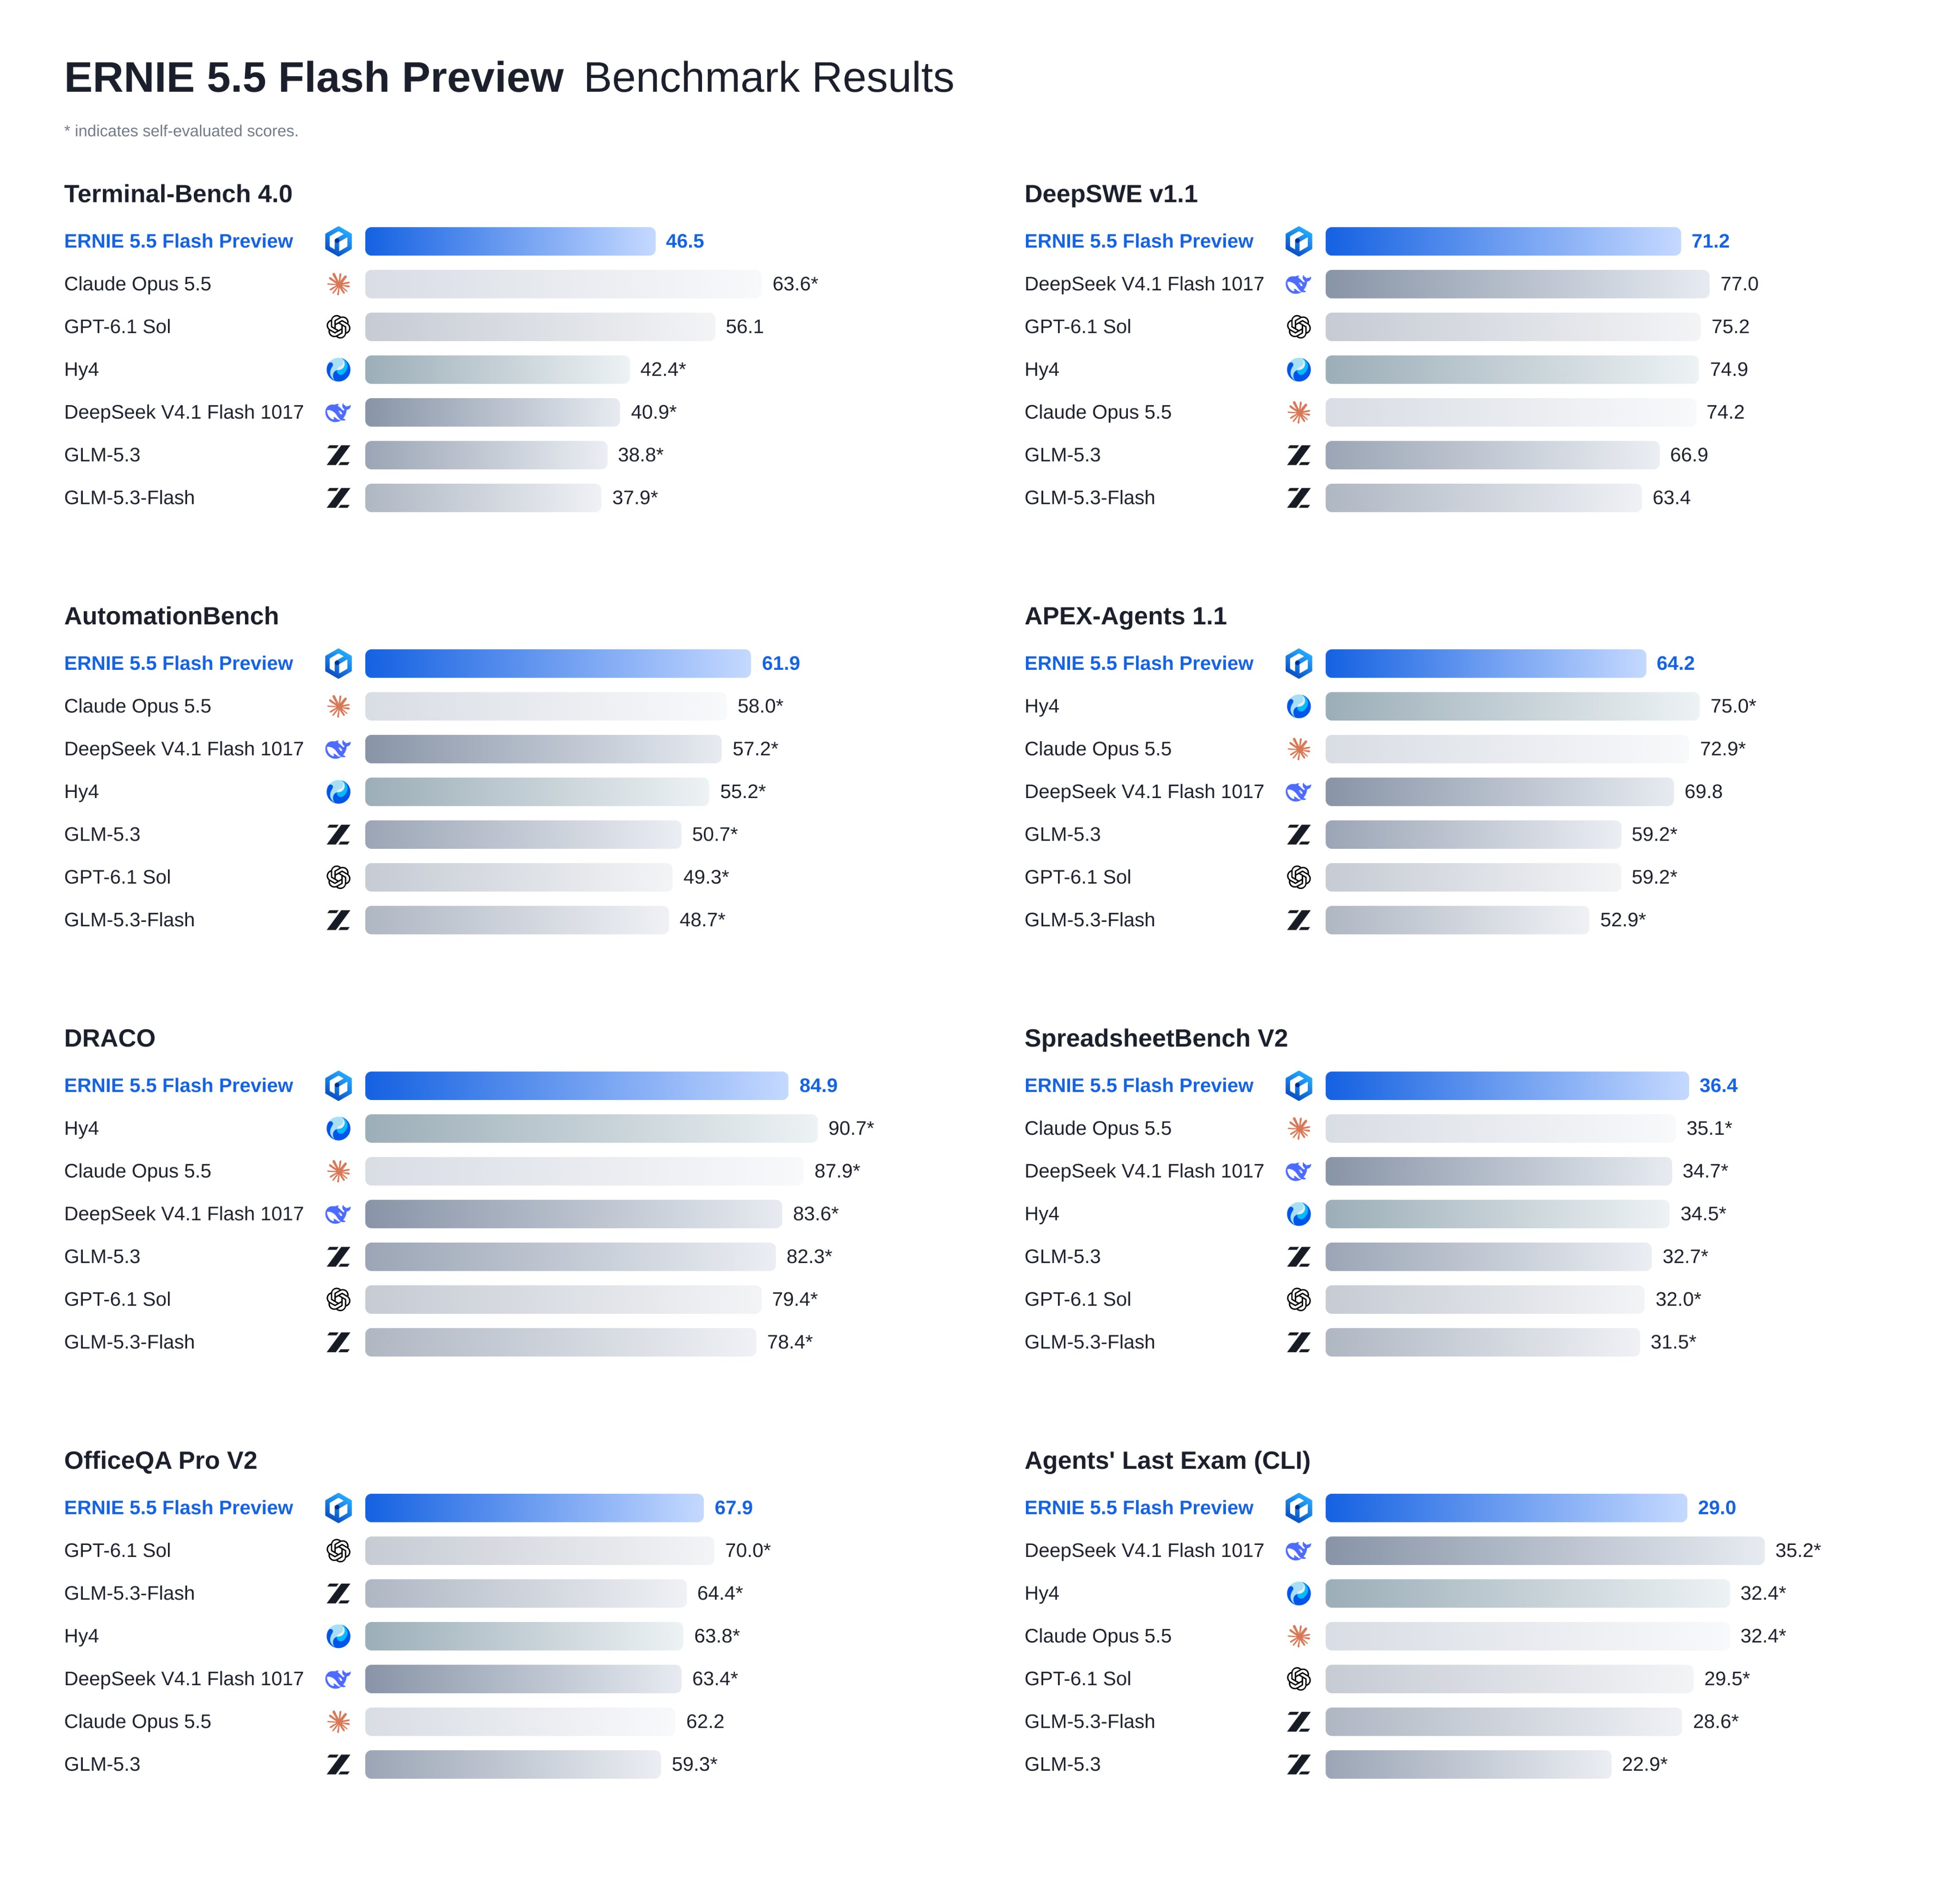
O DeepSeek V4.1 Flash é um MoE multimodal com 552B de parâmetros no backbone. Ele ativa 8B de parâmetros por token durante o prefill e 16B durante o decode, o que mantém baixo o custo de tarefas de agentes com muita entrada. Os pesos estão sob licença MIT no Hugging Face. Veja o explicativo sobre o DeepSeek V4.1 Flash.
O GPT-6 Luna é o “modelo mais eficiente da OpenAI para tarefas focadas e de alto volume”. Ele aceita texto e imagens, oferece esforço de raciocínio de none a max e funciona com as ferramentas da Responses API. Veja o que é o GPT-6 Luna.
Preço por 1M de tokens e quanto custa uma chamada real de agente
Os loops de agente reenviam o mesmo contexto longo a cada passo, então o cache e as regras de horário importam tanto quanto a taxa anunciada.
- GPT-6 Luna: $0,10 de entrada, $0,01 de entrada em cache, $0,125 de escrita em cache, $0,50 de saída. Prompts acima de 272K tokens de entrada custam 2x a entrada e 1,5x a saída para toda a requisição. Batch e Flex rodam a 50% do preço padrão.
- DeepSeek V4.1 Flash: $0,30 de entrada (fora do cache), $0,006 com acerto de cache, $1,20 de saída em horário de pico. As tarifas fora do pico são metade. O pico vai de 01:00 a 04:00 e de 06:00 a 10:00 UTC, de segunda a sexta; todo o resto, incluindo fins de semana, é fora do pico.
- ERNIE 5.5 Flash Preview: $0 de entrada e saída no endpoint
:freedo OpenRouter, que, segundo o OpenRouter, tem limite de taxa. A Baidu não publicou um preço pago por token em página que pudéssemos consultar hoje, então trate qualquer número visto em outros lugares como [VERIFICAR].
Considere um passo de agente com 50.000 tokens de entrada e 2.000 de saída, sem cache:
| Modelo | Custo por chamada | Custo por 1.000 chamadas |
|---|---|---|
| GPT-6 Luna | $0,0060 | $6,00 |
| DeepSeek V4.1 Flash, pico | $0,0174 | $17,40 |
| DeepSeek V4.1 Flash, fora do pico | $0,0087 | $8,70 |
ERNIE 5.5 Flash Preview, :free |
$0 | $0 (dentro dos limites de taxa) |
Agora suponha que 90% dessa entrada seja acerto de cache, o que é normal para um agente que relê o mesmo repositório. A Luna cai para cerca de $0,0020 por chamada (mais uma escrita única em cache). A DeepSeek cai para cerca de $0,0042 em horário de pico e $0,0021 fora do pico. A diferença entre os dois modelos pagos praticamente desaparece fora do pico.
Duas ressalvas: cada provedor tem seu próprio tokenizador, então as contagens de tokens diferem para o mesmo prompt, e os tokens de raciocínio são cobrados como saída, portanto um esforço de raciocínio alto inflaciona a linha de saída. Nosso detalhamento de preços do DeepSeek V4.1 Flash e a comparação do nível de APIs abaixo de $1 aprofundam os cálculos de cache.
Janela de contexto, tamanho da saída e velocidade
O contexto não decidirá essa disputa. Os limites de saída diferem mais: 384K para a DeepSeek, 128.000 para a Luna e 1.024.000 listados para o endpoint gratuito do ERNIE. As alegações de velocidade exigem cuidado:
- ERNIE 5.5 Flash Preview: a descrição do modelo no OpenRouter diz mais de 200 tokens por segundo. O throughput P50 medido pelo próprio OpenRouter nos últimos 3 dias foi de 79 tokens por segundo, com latência P50 de 2,53 segundos, em um único provedor (Baidu Qianfan).
- DeepSeek V4.1 Flash: nenhum número de tokens por segundo na página de preços; ela lista um limite de concorrência de 2.500.
- GPT-6 Luna: a OpenAI a classifica como “Rápida”, com limites do nível Build de 5.000 requisições e 2.000.000 de tokens por minuto.
Meça a partir da sua própria região com seus próprios prompts; a seção sobre Apidog abaixo mostra como fazer isso.
Pesos abertos, acesso gratuito e licenciamento
- O DeepSeek V4.1 Flash é o único com pesos de produção que você pode baixar hoje, sob a licença MIT. Hospede-o você mesmo ou escolha um provedor hospedado no card do Hugging Face.
- O ERNIE 5.5 Flash tem dois artefatos. O modelo Base (apenas pré-treinamento, 33,5T tokens) já está no Hugging Face. O Preview, o modelo de chat e agentes, ainda não tem pesos públicos; a Baidu diz que serão abertos sob Apache 2.0 “em breve”. Uma data que talvez você veja online não está confirmada [VERIFICAR].
- O GPT-6 Luna é fechado. Você o acessa pela API da OpenAI ou pelo Amazon Bedrock, e o nível gratuito da API está listado como “Não suportado”.
Para testes a $0, o endpoint :free do ERNIE é a porta mais fácil. A DeepSeek e a Luna têm suas próprias rotas gratuitas, cobertas em como usar o DeepSeek V4.1 Flash gratuitamente e como usar o GPT-6 Luna gratuitamente.
Melhor opção para agentes e codificação
Cada fornecedor faz benchmark em seu próprio ambiente, então não compare esses números como se fossem um único teste. Compare o que cada um enfatiza.
O DeepSeek V4.1 Flash relata 90,6 no Terminal-Bench 2.1 e 74,2 no DeepSWE v1.1 com esforço máximo de raciocínio, ambos medidos pela DeepSeek em seu próprio ambiente. O esforço de raciocínio é um dial de 1 a 100, e o endpoint fala os formatos OpenAI, Anthropic e Responses, então ele se integra ao Claude Code, Codex ou OpenCode.
O ERNIE 5.5 Flash Preview aparece na página de lançamento da Baidu construindo um jogo na Unreal Engine 5.8 em uma única tarefa de codificação de 11 horas e quase 100 minijogos mobile a partir de documentos de design. Ele é somente de texto, então loops de agentes baseados em screenshots ficam de fora por enquanto. O painel do OpenRouter também mostrou uma taxa de erro de saída estruturada de 21,70% e uma taxa de erro de chamadas de ferramentas de 1,01% ao longo de 3 dias, então valide as saídas JSON antes de confiar nelas em um pipeline.
O GPT-6 Luna vence em amplitude de ferramentas. A Responses API lhe dá shell hospedado, aplicação de patches, uso de computador e MCP. Uma limitação: no Chat Completions, a chamada de funções só funciona com reasoning_effort definido como none; use a Responses API para ferramentas com raciocínio ativado.
Qual modelo barato você deve escolher?
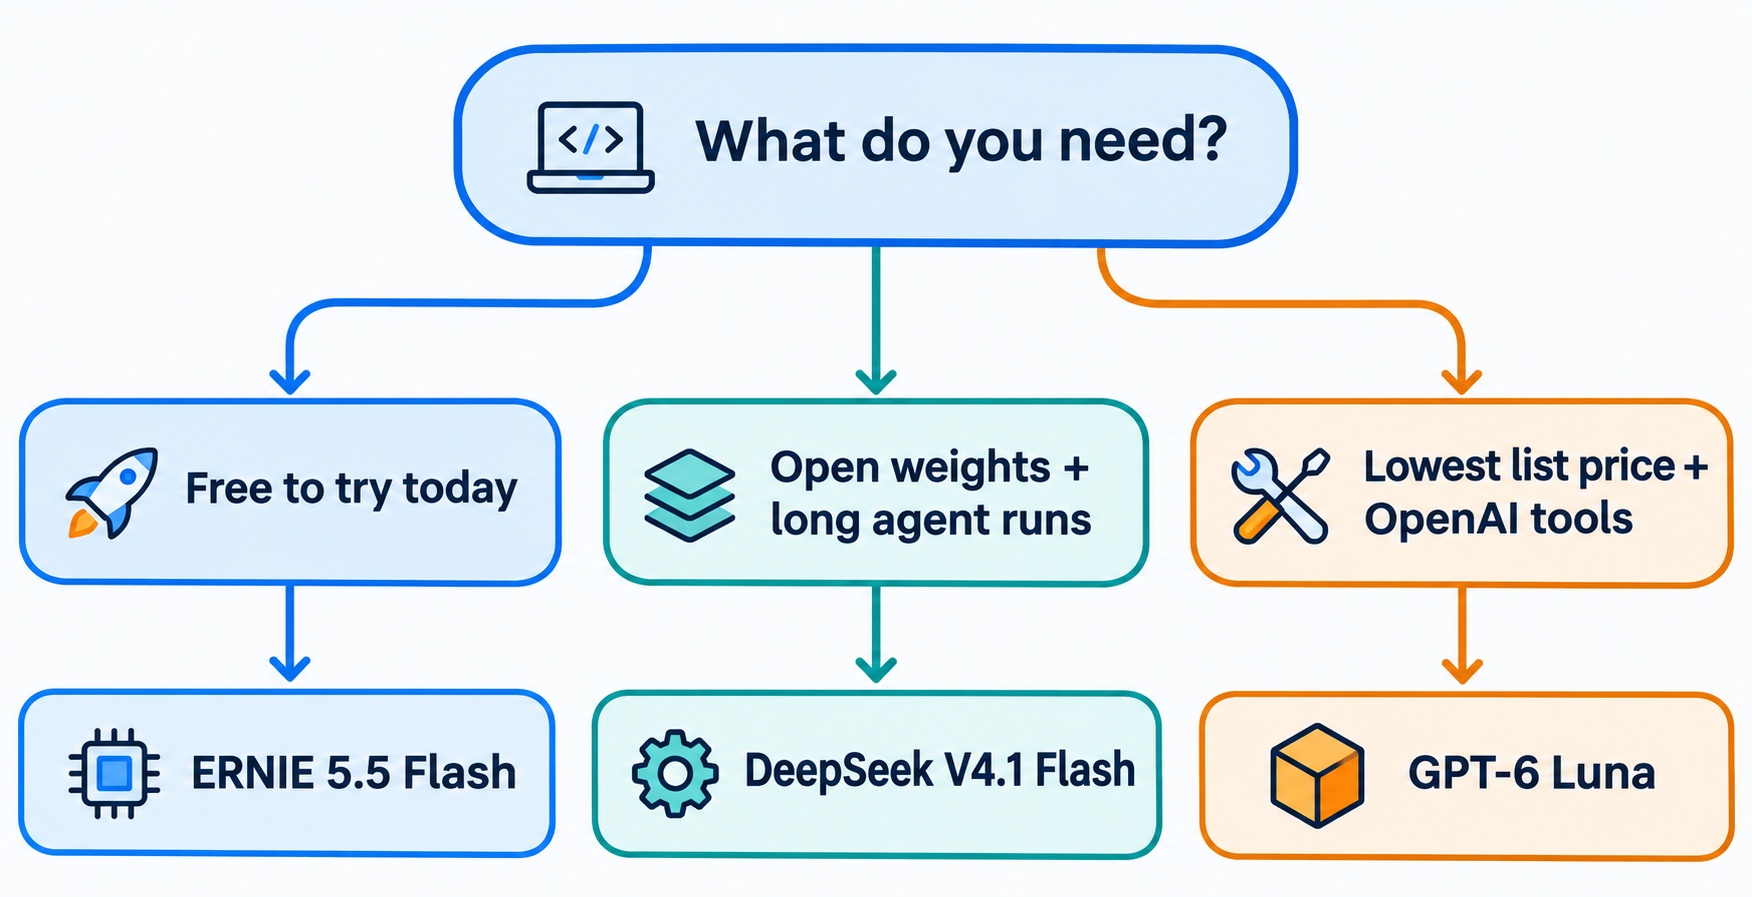
Escolha pela restrição, não pelo leaderboard:
- Você quer experimentar um modelo novo a $0 hoje: ERNIE 5.5 Flash Preview no OpenRouter. Espere comportamento de preview e limites de taxa.
- Você precisa de pesos abertos ou planeja hospedar por conta própria: DeepSeek V4.1 Flash.
- Seu agente roda sessões longas com muita entrada e você pode agendar fora do pico: DeepSeek V4.1 Flash, onde acertos de cache fora do pico custam $0,003 por 1M.
- Você quer o menor preço oficial pago e as ferramentas hospedadas da OpenAI: GPT-6 Luna.
- Você precisa de entrada de imagem: DeepSeek V4.1 Flash ou GPT-6 Luna, não o ERNIE.
Deixe seu agente de codificação comparar os três com o Apidog CLI
Não fique clicando manualmente em três chamadas de API a cada atualização de modelo. Deixe o Claude Code, Codex ou Cursor construir um cenário e executá-lo contra cada provedor com o Apidog CLI. Os três falam OpenAI Chat Completions, então só mudam a URL base, o ID do modelo e a chave.
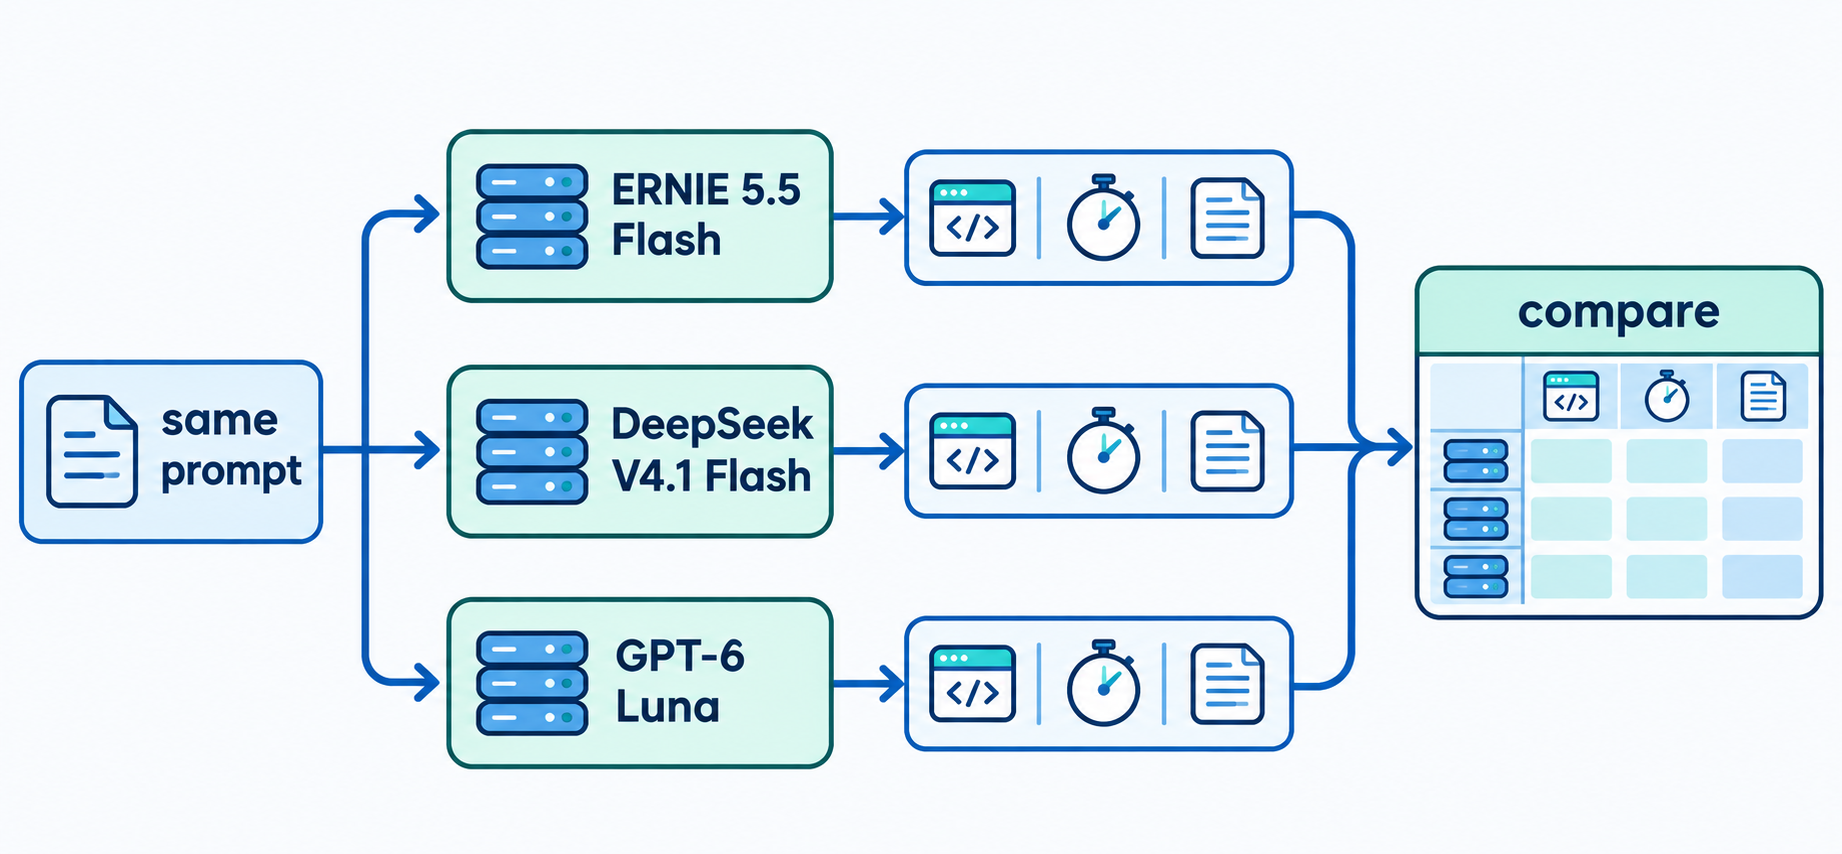
Configure o CLI uma vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Depois dê ao seu agente um único prompt:
In Apidog project <projectId>, create three environments: ernie-flash
(base URL https://openrouter.ai/api/v1, model baidu/ernie-5.5-flash-preview:free),
deepseek-flash (https://api.deepseek.com, model deepseek-flash) and gpt-6-luna
(https://api.openai.com/v1, model gpt-6-luna). Create one test scenario that POSTs
the same prompt to {{baseUrl}}/chat/completions with model {{model}}, asserts
status 200 and a non-empty choices[0].message.content, and records
usage.completion_tokens. Run it 5 times per environment and give me a table of
pass rate, average response time and output tokens.
O agente cria os ambientes, valida o payload do cenário contra o schema, grava e executa:
apidog environment create ernie-flash --project <projectId> --base-url https://openrouter.ai/api/v1 --variables '<json>'
apidog environment create deepseek-flash --project <projectId> --base-url https://api.deepseek.com --variables '<json>'
apidog environment create gpt-6-luna --project <projectId> --base-url https://api.openai.com/v1 --variables '<json>'
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <projectId> --file scenario.json
apidog test-scenario run <scenarioId> --project <projectId> -e <envId> -n 5 -r cli,json --env-var "apiKey=$OPENROUTER_API_KEY"
Passar chaves com --env-var as mantém fora do ambiente compartilhado. Repita a execução por ambiente com a chave daquele provedor; os relatórios JSON alimentam sua tabela. O mesmo comando de execução com -r junit se integra ao CI; consulte o guia de CI/CD do Apidog CLI e o passo a passo de configuração no Claude Code. O plano gratuito do Apidog cobre até 4 usuários, então uma equipe pequena pode fazer isso sem um assento pago.
FAQ
O ERNIE 5.5 Flash é mais barato que o DeepSeek V4.1 Flash? Neste momento, sim: o endpoint :free do OpenRouter custa $0 dentro dos seus limites de taxa. A Baidu não publicou um preço pago que pudéssemos verificar, então uma comparação pago a pago ainda não é possível.
Qual tem a maior janela de contexto? Elas são parecidas. O GPT-6 Luna lista 1.050.000 tokens, o ERNIE 5.5 Flash Preview 1.024.000 no OpenRouter, e o DeepSeek V4.1 Flash 1M. O preço da Luna dobra na entrada acima de 272K tokens.
Posso rodar algum desses modelos localmente? O DeepSeek V4.1 Flash, sim: pesos MIT no Hugging Face. Os pesos do ERNIE 5.5 Flash Base são públicos, mas o modelo de chat Preview ainda não foi lançado. O GPT-6 Luna não tem pesos públicos.
Qual é o melhor para agentes de codificação? Depende do seu ambiente. O DeepSeek V4.1 Flash relata pontuações fortes de agente em seus próprios testes e suporta os formatos OpenAI e Anthropic. O GPT-6 Luna tem o maior conjunto de ferramentas hospedadas. O ERNIE 5.5 Flash Preview é gratuito para experimentar, mas somente de texto e ainda em preview.
O GPT-6 Luna tem um nível gratuito de API? Não. A página do modelo da OpenAI lista o nível gratuito como “Não suportado”. O uso pago começa em $0,10 por 1M de tokens de entrada.