
A API do ERNIE 5.5 Flash está disponível em dois lugares: na Baidu Qianfan, onde você chama ernie-5.5-flash-preview em https://qianfan.baidubce.com/v2/chat/completions, e na OpenRouter, onde baidu/ernie-5.5-flash-preview:free custa $0 por token. Ambos falam o formato OpenAI Chat Completions, então você pode apontar o SDK oficial da OpenAI para qualquer um deles apenas mudando a URL base, a chave e o nome do modelo.
Abaixo: chaves, primeiras requisições em curl, Python e JavaScript, streaming, tokens de raciocínio, a janela de 1M e erros. Todos os campos e limites vêm das páginas oficiais da Qianfan e da OpenRouter, verificados em 12 de novembro de 2026.
Para contextualizar, leia o que é o ERNIE 5.5 Flash ou o guia da API do ERNIE 5.1 para a geração anterior.
O que é a API do ERNIE 5.5 Flash?
A API do ERNIE 5.5 Flash é o endpoint hospedado pela Baidu para o ERNIE 5.5 Flash Preview, um modelo esparso mixture-of-experts com 280B de parâmetros totais, 14B ativos por token e contexto de 1M de tokens. A Baidu o lançou em 11 de novembro de 2026, como o primeiro modelo pós-treinado construído sobre o ERNIE 5.5 Flash Base, e o disponibiliza por meio da Qianfan e da OpenRouter.
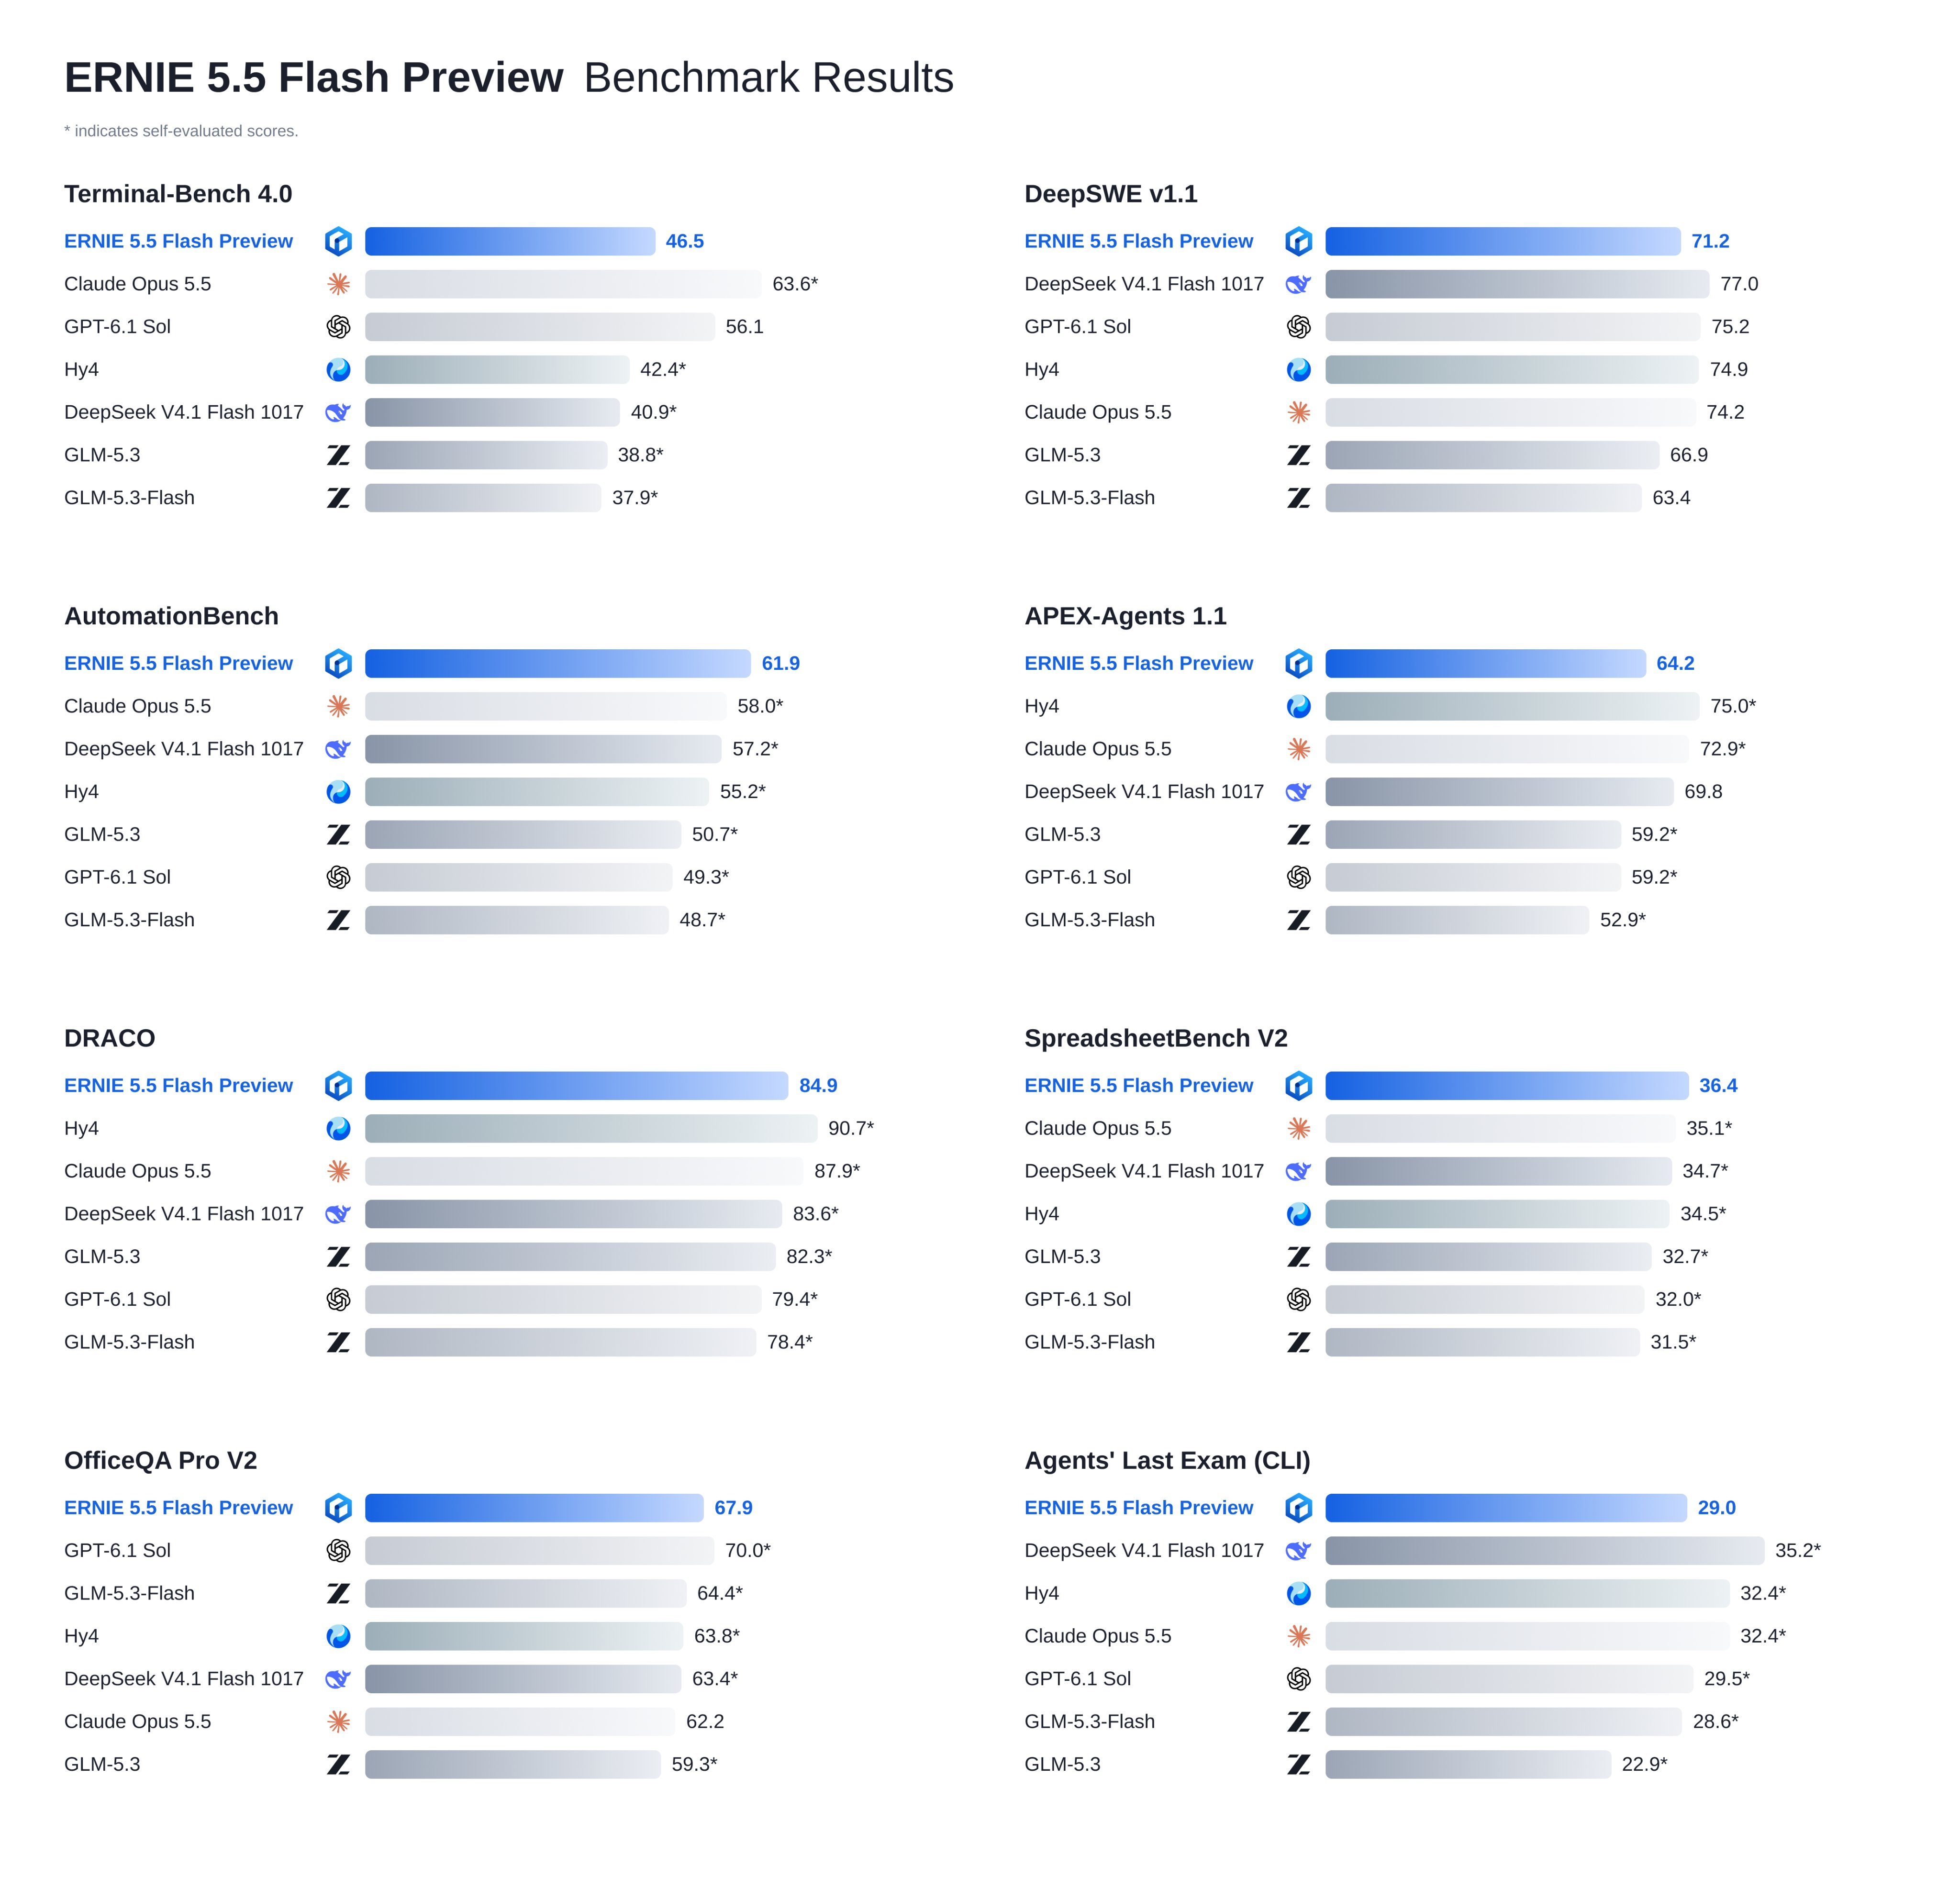
A publicação de lançamento da Baidu o posiciona para programação, trabalho com agentes, modelagem 3D, trabalho com conhecimento e criação de conteúdo. Ela descreve o modelo como um checkpoint intermediário, portanto espere mudanças de comportamento, e diz que os pesos serão abertos sob Apache 2.0 “em breve”, sem data definida.
Qianfan vs OpenRouter: qual endpoint você deve usar?
Veja como as duas rotas se comparam, usando o que cada plataforma publica hoje.
| Baidu Qianfan | OpenRouter | |
|---|---|---|
| URL base | https://qianfan.baidubce.com/v2 |
https://openrouter.ai/api/v1 |
| ID do modelo | ernie-5.5-flash-preview |
baidu/ernie-5.5-flash-preview:free |
| Cabeçalho de autenticação | Authorization: Bearer <chave da API Qianfan> |
Authorization: Bearer <chave OpenRouter> |
| Contexto | 1M de entrada, 1M de saída | 1.024.000 tokens |
| Preço | Cobrado do seu saldo da Baidu AI Cloud; o console mostra a tarifa | $0 na variante :free |
| Limites padrão | 300 requisições/min, 3.000.000 tokens/min | 20 requisições/min; 50/dia, ou 1.000/dia após $10 em créditos |
| Raciocínio | Sempre ativo, esforço fixo em high |
Controlado pelo objeto reasoning |
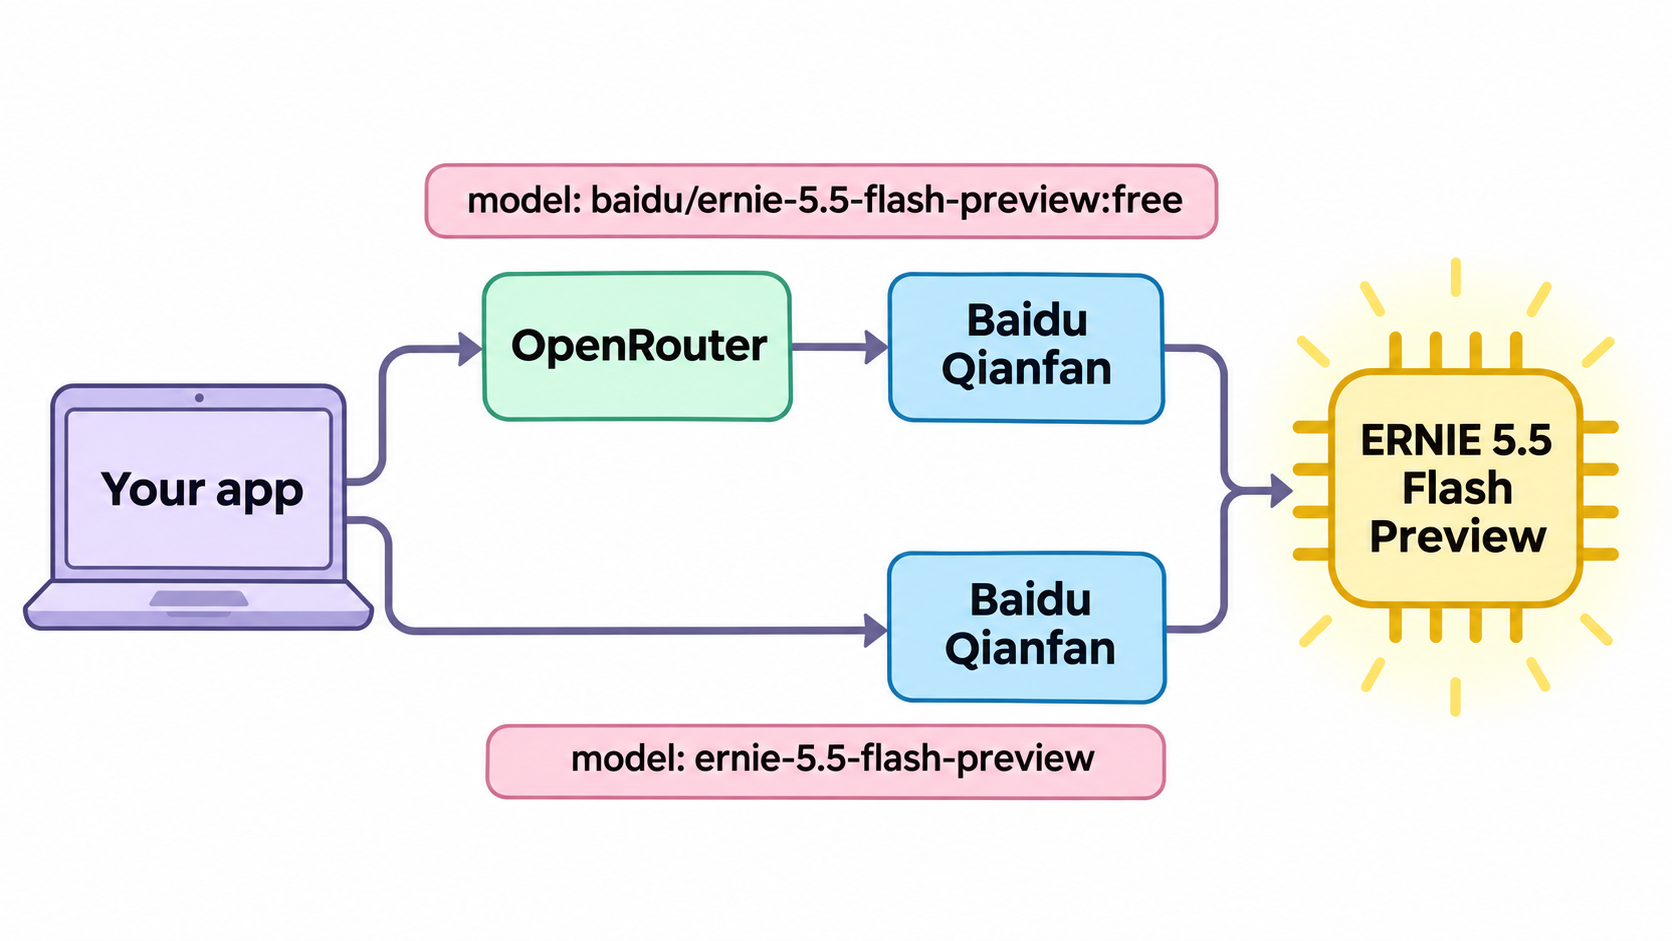
A OpenRouter lista um único provedor, a Baidu Qianfan, então ambas as rotas atingem o mesmo backend. A diferença real está nos limites: o tier gratuito da OpenRouter serve para prototipagem e avaliações, enquanto o padrão de 300 RPM da Qianfan serve para produção. O guia gratuito do ERNIE 5.5 Flash aborda as rotas de $0 em mais profundidade.
Como obter uma chave de API do ERNIE 5.5 Flash?
Qianfan
- Faça login no console da Qianfan com uma conta da Baidu AI Cloud.
- Abra API Key em gerenciamento do sistema e crie uma chave. Ela tem o formato
bce-v3/ALTAK-.... - Exporte-a:
export QIANFAN_API_KEY="bce-v3/ALTAK-...".
A Qianfan cobra as chamadas do seu saldo da Baidu AI Cloud. Um saldo negativo retorna 403 account_overdue, então recarregue antes de fazer testes de carga.
OpenRouter
- Crie uma conta e uma chave na OpenRouter.
- Exporte-a:
export OPENROUTER_API_KEY="sk-or-v1-...". - Use o ID do modelo
baidu/ernie-5.5-flash-preview:free.
Envie sua primeira requisição ao ERNIE 5.5 Flash
curl
Qianfan:
curl https://qianfan.baidubce.com/v2/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $QIANFAN_API_KEY" \
  -d '{
    "model": "ernie-5.5-flash-preview",
    "messages": [
      {"role": "system", "content": "You are a concise senior engineer."},
      {"role": "user", "content": "Write a Python function that validates an ISO 8601 date."}
    ]
  }'
OpenRouter:
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -d '{
    "model": "baidu/ernie-5.5-flash-preview:free",
    "messages": [
      {"role": "user", "content": "Write a Python function that validates an ISO 8601 date."}
    ]
  }'
Python
Instale o SDK com pip install openai e troque a URL base conforme o provedor:
import os
from openai import OpenAI

PROVIDERS = {
    "qianfan": ("https://qianfan.baidubce.com/v2", "QIANFAN_API_KEY", "ernie-5.5-flash-preview"),
    "openrouter": ("https://openrouter.ai/api/v1", "OPENROUTER_API_KEY", "baidu/ernie-5.5-flash-preview:free"),
}

base_url, key_env, model = PROVIDERS["qianfan"]
client = OpenAI(base_url=base_url, api_key=os.environ[key_env])

resp = client.chat.completions.create(
    model=model,
    messages=[{"role": "user", "content": "Explain idempotency keys in two sentences."}],
    max_completion_tokens=4096,
)
print(resp.choices[0].message.content)
print(resp.usage)
JavaScript
import OpenAI from "openai";

const client = new OpenAI({
  baseURL: "https://openrouter.ai/api/v1",
  apiKey: process.env.OPENROUTER_API_KEY,
});

const resp = await client.chat.completions.create({
  model: "baidu/ernie-5.5-flash-preview:free",
  messages: [{ role: "user", content: "List three causes of HTTP 499 errors." }],
});
console.log(resp.choices[0].message.content);
Como fazer streaming das respostas do ERNIE 5.5 Flash?
Adicione "stream": true e ambos os provedores retornam eventos server-sent que terminam com data: [DONE]. Na Qianfan, adicione "stream_options": {"include_usage": true} para receber as contagens de tokens no último chunk. Se você não conhece o formato, o guia de streaming SSE explica o formato de transmissão.
stream = client.chat.completions.create(
    model=model,
    messages=[{"role": "user", "content": "Draft a README for a CLI tool."}],
    stream=True,
    stream_options={"include_usage": True},
)
for chunk in stream:
    if chunk.choices:
        delta = chunk.choices[0].delta
        thinking = getattr(delta, "reasoning_content", None)
        if thinking:
            print(f"[thinking] {thinking}", end="", flush=True)
        if delta.content:
            print(delta.content, end="", flush=True)
    if chunk.usage:
        print("\n", chunk.usage)
Use streaming por padrão: o modelo raciocina antes de responder, então uma chamada bloqueante pode ficar em silêncio por um tempo.
Como funcionam os tokens de raciocínio em cada provedor?
O ERNIE 5.5 Flash Preview é um modelo de raciocínio, e as duas plataformas o expõem de maneiras diferentes.
Na Qianfan, a documentação de deep-thinking lista ernie-5.5-flash-preview como “apenas habilitável, não pode ser desabilitado” para o parâmetro thinking, e seu padrão reasoning_effort de high “não pode ser ajustado”. Ou seja, você não pode desligar o raciocínio nem reduzi-lo aqui. A cadeia de raciocínio vem em reasoning_content, separada de content. A Qianfan conta esses tokens dentro de max_completion_tokens, então um limite apertado pode cortar a resposta final e deixar você com finish_reason: "length".
Na OpenRouter, você controla o raciocínio com o objeto reasoning e lê o trace em reasoning_details. Para ocultar o trace da resposta:
{
  "model": "baidu/ernie-5.5-flash-preview:free",
  "reasoning": { "exclude": true },
  "messages": [{ "role": "user", "content": "Is 2^61 - 1 prime?" }]
}
Em conversas de múltiplos turnos, a OpenRouter pede que você passe todo o reasoning_details de volta junto com a mensagem do assistente, para que o modelo possa continuar de onde parou. A contagem de tokens de raciocínio aparece em usage.completion_tokens_details.reasoning_tokens.
Dicas para a janela de contexto de 1M de tokens
Um milhão de tokens comporta uma base de código de tamanho médio. Quatro hábitos mantêm chamadas longas previsíveis:
- Faça orçamento com base em tokens por minuto, não só em requisições. O padrão da Qianfan é 3.000.000 de TPM, então três prompts completos de 1M de tokens em um minuto consomem toda a cota. Monitore
X-Ratelimit-Remaining-Input-Tokensem cada resposta. - Coloque o conteúdo estável primeiro. Mantenha o prompt de sistema e os documentos de referência no início e a pergunta variável no final, para que prefixos repetidos possam aproveitar o cache. A OpenRouter registrou uma taxa de acerto de cache de 90,83% para este modelo em 12 de novembro.
- Deixe espaço para o raciocínio. Defina
max_completion_tokensalto o suficiente para cobrir o pensamento mais a resposta. - Meça antes de confiar nas promessas de velocidade. A Baidu diz que o modelo gera mais de 200 tokens por segundo. No endpoint gratuito da OpenRouter, o throughput P50 em 12 de novembro foi de 79 tokens por segundo, com latência P50 de 2,53 segundos.
Para saída estruturada, teste rigorosamente antes de colocar em produção. A OpenRouter aceita response_format com um schema JSON, mas sua página reportou uma taxa de erro de saída estruturada de 21,70% para este modelo em três dias, contra 1,01% de erro em chamadas de ferramentas. Valide toda resposta JSON e faça retry em falhas de parse.
Erros e limites de taxa da API do ERNIE 5.5 Flash
Estes são os códigos que você verá com mais frequência, da tabela de códigos de erro da Qianfan e da página de limites da OpenRouter:
| Status | Provedor | Código ou causa | Correção |
|---|---|---|---|
| 400 | Qianfan | tokens_too_long |
Reduza o prompt para abaixo do limite de entrada de 1M |
| 401 | Qianfan | invalid_iam_token |
Chave errada ou expirada, ou o prefixo Bearer está ausente |
| 401 | Qianfan | invalid_model |
Confirme que o ID do modelo é exatamente ernie-5.5-flash-preview |
| 403 | Qianfan | account_overdue |
Saldo abaixo de zero; recarregue |
| 429 | Qianfan | rpm_rate_limit_exceeded, tpm_rate_limit_exceeded |
Espere; a cota é renovada em até 60 segundos |
| 402 | OpenRouter | Saldo de créditos negativo | Adicione créditos, mesmo para :free |
| 429 | OpenRouter | Limite de modelos gratuitos (20/min, 50 ou 1.000/dia) | Leia X-RateLimit-Reset ou verifique GET /api/v1/key |
Na OpenRouter, GET https://openrouter.ai/api/v1/key retorna free_model_daily_requests.remaining. Faça retry de erros 429 com backoff exponencial e jitter; nunca faça retry de um 400 ou 401.
Deixe seu agente de programação testar ambos os endpoints com o Apidog CLI
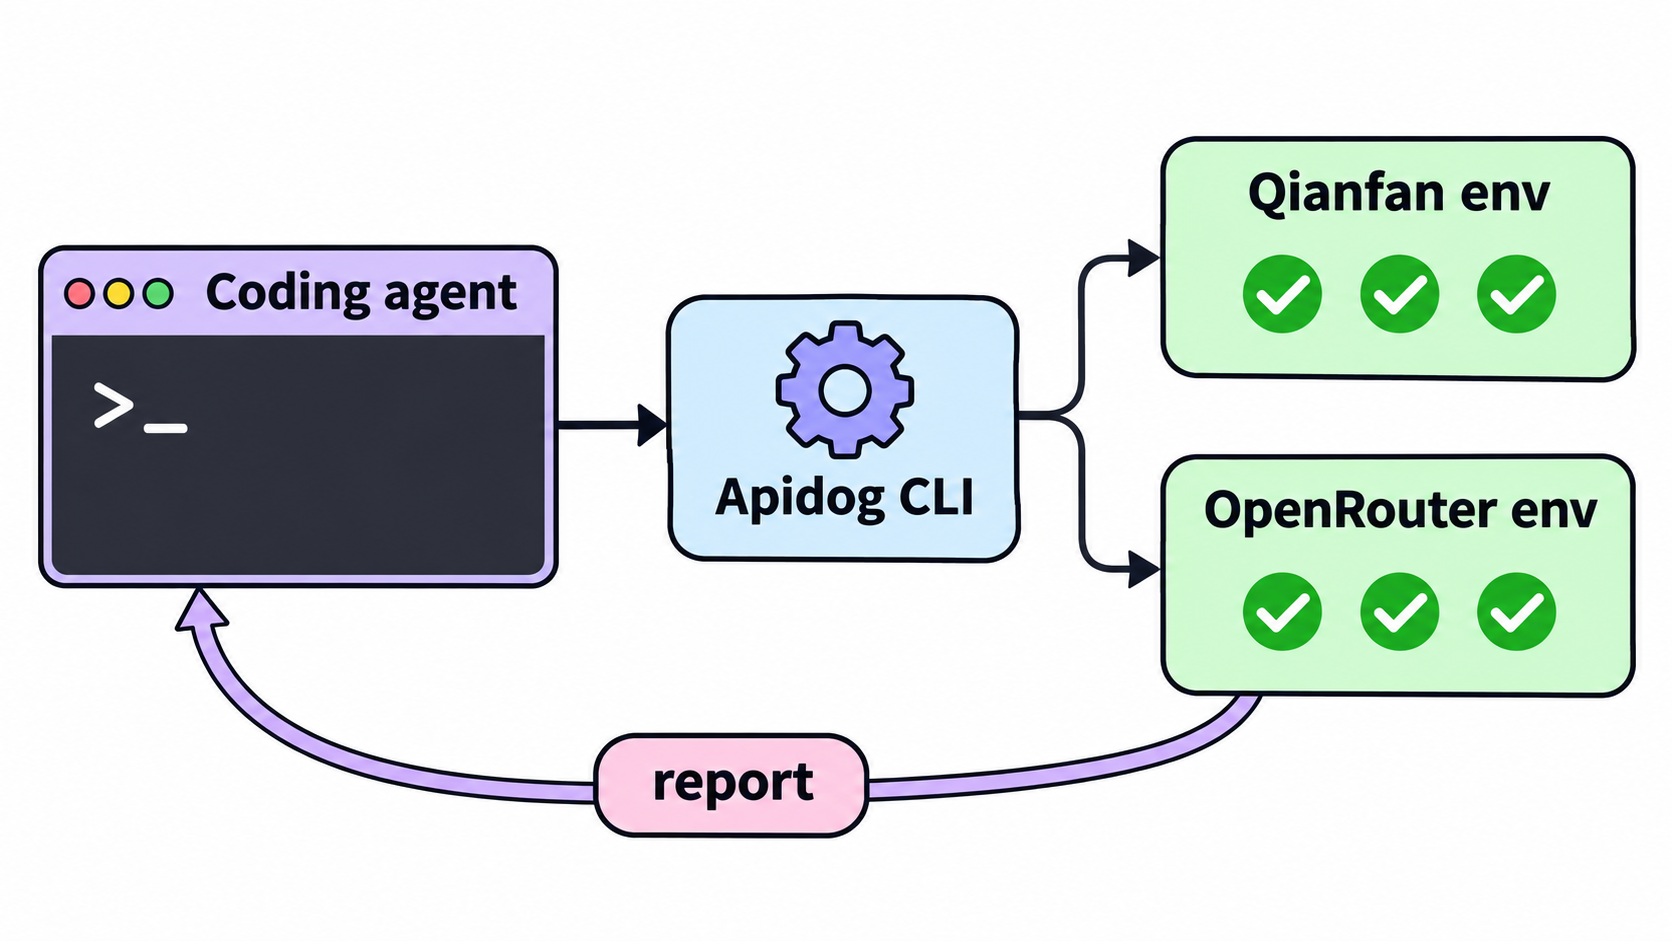
Depois que ambos os provedores responderem, você quer prova de que continuam respondendo corretamente: status certo, formato certo, latência aceitável. Deixe isso para o seu agente de programação. O Apidog CLI dá ao Claude Code, Codex, Cursor ou OpenCode os comandos para importar o endpoint, salvar um ambiente por provedor e executar um cenário de teste contra cada um.
Configure uma vez:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
Depois dê um único prompt ao seu agente:
Write an OpenAPI 3 file for POST /chat/completions that matches the ERNIE 5.5 Flash
request and response shape (model, messages, stream; choices[0].message.content, usage).
Import it into Apidog project <projectId>. Create two environments: "qianfan" with base
URL https://qianfan.baidubce.com/v2 and "openrouter" with https://openrouter.ai/api/v1,
each with a "model" variable. Build one test scenario that sends a short prompt and
asserts status 200, the response schema, and a response time under 30 seconds. Run it
against both environments, passing the API keys as environment variables, and summarize
any failures.
O agente verifica cada schema, valida seus payloads e executa comandos como estes:
apidog import --project <projectId> --format openapi --file ./ernie-5-5-flash.openapi.yaml
apidog environment create qianfan --project <projectId> --base-url https://qianfan.baidubce.com/v2
apidog environment create openrouter --project <projectId> --base-url https://openrouter.ai/api/v1
apidog cli-schema get test-scenario-create
apidog test-scenario create --project <projectId> --name "ERNIE 5.5 Flash smoke" --folder-id <folderId> --priority <priority>
apidog test-scenario import-steps <scenarioId> --project <projectId> --source endpoint --ids <endpointId> --sync manual
apidog run -t <scenarioId> --project <projectId> -e <qianfanEnvId> --env-var "apiKey=$QIANFAN_API_KEY" -r cli,json
apidog run -t <scenarioId> --project <projectId> -e <openrouterEnvId> --env-var "apiKey=$OPENROUTER_API_KEY" -r cli,json
Passar as chaves com --env-var as mantém fora do projeto salvo, e um único cenário lhe dá uma visão lado a lado de ambas as rotas. O mesmo apidog run com -r junit se encaixa em um pipeline; o guia de CI/CD do Apidog CLI mostra a configuração, e Apidog CLI no Claude Code cobre o lado do agente. O plano Free da Apidog cobre até 4 usuários.
FAQ
A API do ERNIE 5.5 Flash é gratuita? Na OpenRouter, sim: baidu/ernie-5.5-flash-preview:free custa $0 por token, com limites de 20 requisições por minuto e 50 por dia, ou 1.000 por dia depois que você comprar $10 em créditos. A Qianfan cobra as chamadas do seu saldo da Baidu AI Cloud.
Qual é o ID do modelo do ERNIE 5.5 Flash? Use ernie-5.5-flash-preview na Qianfan e baidu/ernie-5.5-flash-preview:free na OpenRouter.
Posso desativar o thinking na Qianfan? Não. A documentação da Qianfan diz que o thinking só pode ser habilitado para este modelo e que o reasoning_effort permanece em high. Reserve tokens de saída para o trace de raciocínio.
A API do ERNIE 5.5 Flash suporta chamadas de ferramentas? Sim. A Qianfan lista Function Call e saída estruturada como suportados, e a OpenRouter aceita tools, tool_choice e response_format. Valide a saída estruturada, já que a OpenRouter reportou uma alta taxa de erro para ela.
Posso executar o ERNIE 5.5 Flash eu mesmo? A Baidu publicou o ERNIE 5.5 Flash Base no Hugging Face, e os pesos do Preview são prometidos sob Apache 2.0. Veja como executar o ERNIE 5.5 Flash localmente com vLLM.
Como ele se compara ao DeepSeek V4.1 Flash? Veja ERNIE 5.5 Flash vs DeepSeek V4.1 Flash e o guia da API do DeepSeek V4.1 Flash.