A DeepSeek publicou o cartão do modelo para o DeepSeek-V4.1-Flash em 10 de setembro de 2026, e os números são constrangedores para os clientes do V4-Pro. O modelo menor e mais barato pontua mais alto do que o carro-chefe em todos os benchmarks de codificação e agente listados pela DeepSeek, custa de 70 a 77% menos por token no pico, e em 14 de setembro ele absorve o V4-Pro completamente: cada solicitação de deepseek-v4-pro é roteada para o V4.1-Flash e cobrada pelas taxas Flash.
Esta não é a habitual troca entre pequeno e grande. É uma comparação com um prazo. Se você executa o V4-Pro em produção, você tem quatro dias para aprender o que muda quando o redirecionamento for efetivado. Se você executa o V4-Flash, a mudança já aconteceu: o nome deepseek-v4-flash é atendido pelo V4.1-Flash hoje.
Abaixo: todos os três modelos em arquitetura, benchmarks relatados pela DeepSeek, preços em USD e taxa de transferência, em seguida, um fluxo de trabalho para executar um conjunto de prompts através de ambos deepseek-v4-pro e deepseek-flash no Apidog antes da transição para comparar saídas, latência e contagens de uso. Para aprofundar na arquitetura, leia primeiro o que é o DeepSeek-V4.1-Flash; para a lista de verificação de migração, consulte o guia de desativação do V4-Pro.
TL;DR
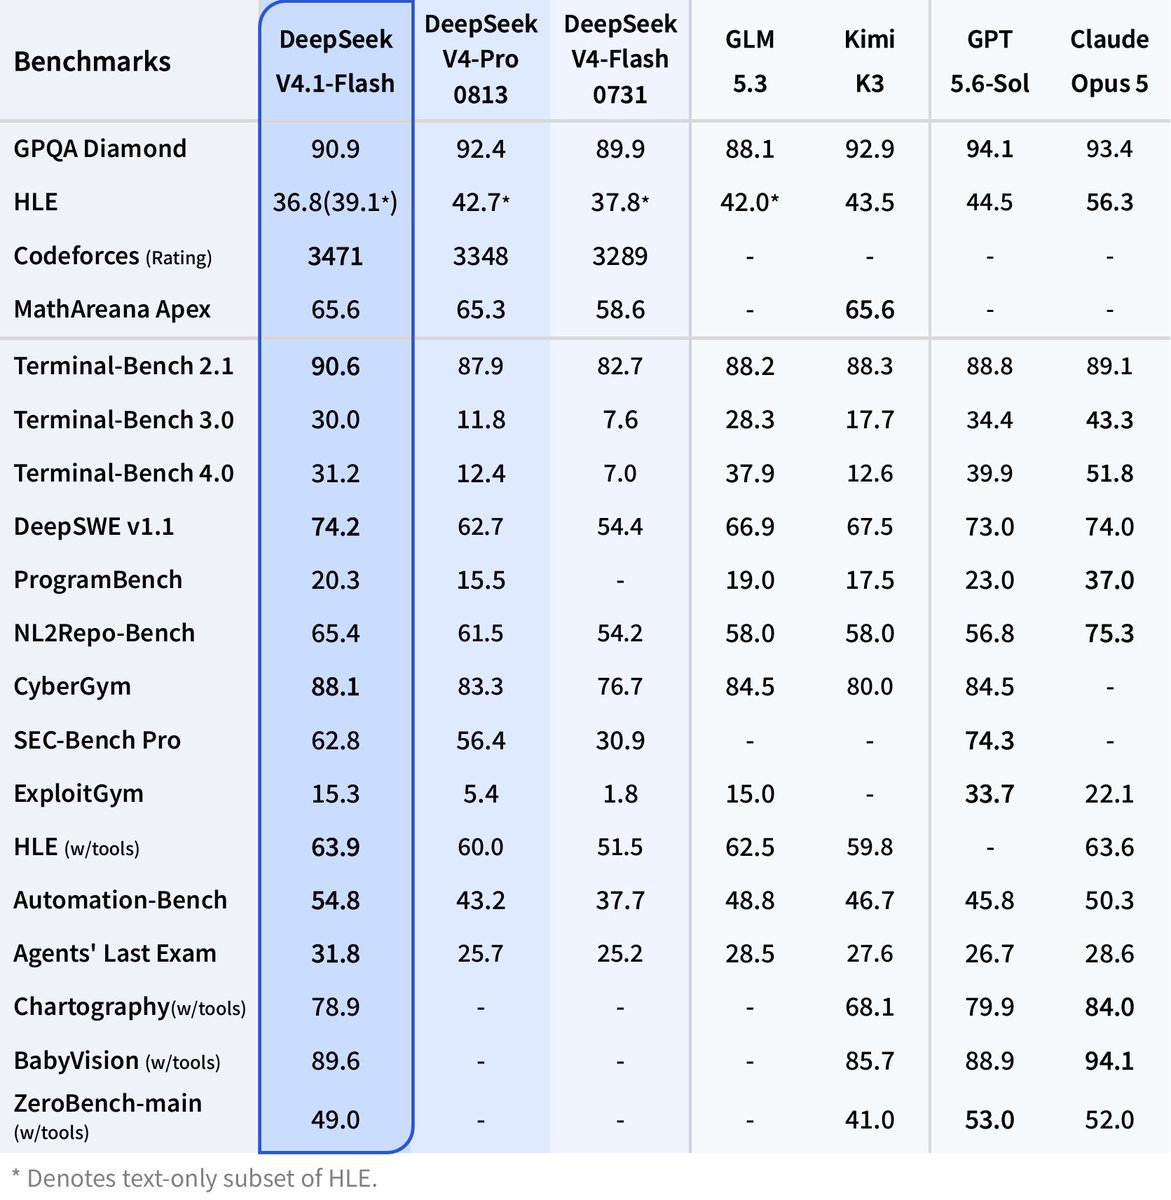
- O V4.1-Flash vence nos próprios benchmarks da DeepSeek. DeepSWE v1.1 é o destaque: 74.2 contra 62.7 para V4-Pro e 54.4 para V4-Flash.
- É o mais barato dos três. A entrada de cache-miss no pico custa $0.30 por 1M de tokens contra $1.32 para V4-Pro e $0.44 para o antigo V4-Flash.
- É construído para alta taxa de transferência. 8B de parâmetros ativos no preenchimento, um cache KV de 890 bytes por token e um limite de concorrência de 2.500.
- Após 14 de setembro, há uma única escolha. O tráfego do V4-Pro é redirecionado para o V4.1-Flash. A questão é o que você ganha e perde, não qual escolher.
Especificações lado a lado
A geração V4.1 é uma nova arquitetura, não um retreinamento pós-lançamento. A DeepSeek a chama de Causal Encoder-Decoder (CED): 40 camadas divididas em 20 codificadores e 20 decodificadores, com 384 especialistas roteados mais um especialista compartilhado por camada. O cartão do modelo indica que a espinha dorsal possui 552B de parâmetros (763B com o codificador de visão).
| V4-Flash | V4-Pro | V4.1-Flash | |
|---|---|---|---|
| Geração da arquitetura | V4 MoE | V4 MoE | V4.1 Causal Encoder-Decoder, 40 camadas |
| Parâmetros totais | 284B (listagem do OpenRouter da versão de visão) | Não divulgado aqui | Espinha dorsal de 552B, 763B com codificador de visão |
| Parâmetros ativos | 13B | Não divulgado aqui | 8B pré-preenchimento, 16B decodificação |
| Janela de contexto | 1M tokens | 1M tokens | 1M tokens |
| Saída máxima | 384K tokens | 384K tokens | 384K tokens |
| Visão | Build Vision-Exp separado | Não divulgado aqui | Nativo, codificador DeepSeek-ViT |
| Licença | Não abordado aqui | Não abordado aqui | MIT, pesos no Hugging Face |
| Limite de concorrência | 2.500 | 500 | 2.500 |
| Status da API | Descontinuado, alias atendido por V4.1-Flash | Redireciona para V4.1-Flash em 14 de Set | GA desde 10 de Set, id do modelo deepseek-flash |
A contagem dividida de parâmetros ativos é o detalhe a ser observado: o V4-Flash usava 13B para cada token, enquanto o V4.1-Flash gasta 8B na entrada e 16B na saída, onde reside a qualidade.
Benchmarks: de onde vêm os 11.5 pontos
Todos os números abaixo são relatados pela DeepSeek a partir do cartão do modelo. Nenhuma execução independente foi publicada, e a frase do aviso de desativação "testes por múltiplas partes" não as nomeia. Trate-os como alegações do fornecedor e verifique com seus próprios prompts.
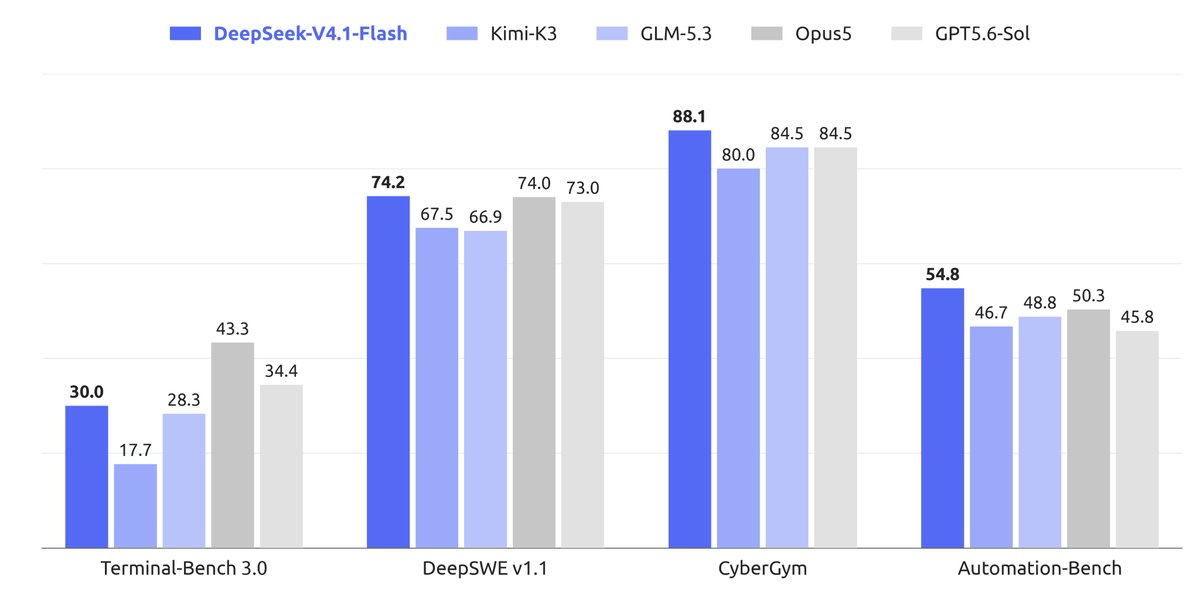
DeepSWE v1.1 (+11.5 sobre o Pro, +19.8 sobre o V4-Flash). O destaque, e a única diferença grande o suficiente para mudar decisões. O DeepSWE mede tarefas de engenharia de software multifile, a carga de trabalho que os agentes de codificação executam o dia todo. Se isso se mantiver em seus repositórios, o V4.1-Flash supera em código o modelo que custava quatro vezes mais.
Terminal-Bench 2.1 (+2.7). Tarefas de agente baseadas em shell. O V4-Flash-0731 já havia superado o V4-Pro-Preview aqui em julho; o V4.1 estende a liderança por menos de três pontos. Real, não decisivo.
HumanEval (+2.6) e GSM8K (+0.4). Ambos estão perto da saturação: todo modelo ultrapassa 90 no GSM8K, e o HumanEval diz pouco sobre código de produção. Não dê peso a essas linhas.
MiniMax M3 vs DeepSeek V4 vs Qwen 3.7 apresenta os números da geração V4 contra outros modelos abertos; nenhum inclui o V4.1 ainda.
Custo: três modelos, seis níveis de preço
O pico é de segunda a sexta-feira, das 01:00 às 04:00 e das 06:00 às 10:00 UTC; todo o resto é fora do pico pela metade do preço. As taxas são por 1M de tokens da página de preços, válidas a partir de 10 de setembro. As linhas V4-Flash usam suas taxas em USD de 21 de agosto de 2026 como a coluna "antes".
| Modelo e nível | Entrada, acerto de cache | Entrada, erro de cache | Saída |
|---|---|---|---|
| V4-Flash, fora do pico (taxas de 21 de Ago) | $0.007 | $0.22 | $0.66 |
| V4-Flash, pico (taxas de 21 de Ago) | $0.014 | $0.44 | $1.32 |
| V4-Pro, fora do pico | $0.022 | $0.66 | $1.98 |
| V4-Pro, pico | $0.044 | $1.32 | $3.96 |
| V4.1-Flash, fora do pico | $0.003 | $0.15 | $0.60 |
| V4.1-Flash, pico | $0.006 | $0.30 | $1.20 |
Em comparação com o V4-Flash, o V4.1 reduz a entrada de acerto de cache em cerca de 57%, a entrada de erro de cache em cerca de 32% e a saída em cerca de 9%. Em comparação com o V4-Pro, os cortes são de 77% na entrada de erro de cache e 70% na saída no pico.
Um mês de trabalho. Um agente de codificação processa 2B de tokens de entrada por mês com uma taxa de acerto de cache de 70% (prompt do sistema e contexto do repositório reutilizados entre as interações) e emite 300M de tokens de saída, tudo no pico.
| V4-Pro, pico | V4-Flash, pico | V4.1-Flash, pico | V4.1-Flash, fora do pico | |
|---|---|---|---|---|
| Entrada 1.4B acerto de cache | $61.60 | $19.60 | $8.40 | $4.20 |
| Entrada 600M erro de cache | $792.00 | $264.00 | $180.00 | $90.00 |
| Saída 300M | $1,188.00 | $396.00 | $360.00 | $180.00 |
| Total mensal | $2,041.60 | $679.60 | $548.40 | $274.20 |
Isso é 73% menos do que o V4-Pro, e mover trabalhos em lote para fora do pico o reduz pela metade novamente. Os tokens de saída dominam todas as colunas, então o corte de 70% na saída importa mais do que o destaque do acerto de cache. A análise de preços do V4.1-Flash cobre o cálculo do acerto de cache.
Velocidade e taxa de transferência
A DeepSeek não publica o número de tokens por segundo, então a história da taxa de transferência baseia-se em três fatos arquitetônicos e uma anedota.
- Cache KV de 890 bytes por token. O cache KV principal em FP4 coloca o cache global em aproximadamente um quarto da pegada do V4-Flash. A nota de lançamento afirma que é 1/4 da HBM e 1/8 do armazenamento SSD da geração anterior. Um contexto completo de 1M de tokens precisa de cerca de 0.9 GB de cache.
- 8B de parâmetros ativos no pré-preenchimento. Menos computação por token de entrada do que os 13B do V4-Flash, então o tempo para o primeiro token em grandes contextos deve diminuir.
- Concorrência 2.500 vs 500. O tráfego do V4-Pro redirecionado herda o limite do Flash, um ganho de 5x para frotas de agentes.
- Relato de um usuário: “quase 400 t/s”. Um usuário do X publicou isso a partir de testes em vídeo durante a fase beta; é uma anedota, não um benchmark. O tópico beta no HN é em grande parte o mesmo entusiasmo.
Meça seus próprios p50 e p95 antes de confiar em qualquer coisa.
O que você perde e ganha depois de 14 de setembro
Não há "qual modelo devo escolher" após a transição. deepseek-v4-pro se torna um alias, então a abordagem honesta é um registro.
Você ganha: pontuações mais altas em todos os benchmarks listados, preços de pico 70 a 77% mais baixos, concorrência 5x maior, entrada de imagem nativa sem um ID de modelo de visão separado, e um seletor de esforço de raciocínio que a DeepSeek descreve como continuamente controlável em uma escala de 1 a 100.
Você perde: a capacidade de fixar um checkpoint da geração V4. Prompts ajustados para o estilo, verbosidade ou formatação de chamadas de ferramentas do V4-Pro podem ter desvios. O comprimento da saída e as contagens de tokens de raciocínio podem mudar, o que altera sua fatura de maneiras que a tabela de preços não mostra. E o redirecionamento acontece no cronograma da DeepSeek, não no seu.
Essa segunda lista é o motivo pelo qual você deve comparar antes do dia 14, não depois.
Compare V4-Pro com V4.1-Flash no Apidog antes da transição
O Apidog testa a camada da API, então é o lugar certo para executar um conjunto de prompts através de ambos os IDs de modelo e comparar o que retorna.
- Adicione o endpoint. Crie um projeto e adicione
POST https://api.deepseek.com/chat/completions, ou importe uma especificação OpenAPI. - Coloque a chave e o ID do modelo nos ambientes. Armazene
DEEPSEEK_API_KEYe uma variávelMODEL. Crie dois ambientes,v4-procomMODEL=deepseek-v4-proev41-flashcomMODEL=deepseek-flash, e referencie-os comoBearer {{DEEPSEEK_API_KEY}}no cabeçalho e"model": "{{MODEL}}"no corpo. - Salve seus prompts reais como requisições. Escolha de 20 a 30 prompts que representem a produção: seu prompt de sistema, uma rodada de chamada de ferramenta, um resumo de contexto longo, uma edição de código multifile. Salve cada um com
stream: falsepara que o objetousageapareça no corpo da resposta. - Afirme sobre os campos que alteram sua fatura. Construa um cenário de teste a partir das requisições salvas e adicione afirmações sobre
usage.prompt_tokens,usage.completion_tokenseusage.prompt_cache_hit_tokens. Registre o tempo de resposta por etapa e adicione um script pré-requisição que insira o nome do ambiente em um cabeçalho para que as execuções sejam rotuladas. - Execute uma vez por ambiente, então compare. Execute o cenário em
v4-pro, depois emv41-flash. Compare as contagens de tokens de conclusão (o redirecionamento altera sua fatura de saída), a latência por etapa e o próprio conteúdo para desvios de formatação. - Reexecute em CI no dia 14. Execute o mesmo cenário com
apidog-cliem sua pipeline na transição. Qualquer coisa que o redirecionamento quebrar aparecerá como uma asserção falha em vez de um ticket de suporte.
A mesma comparação como um script:
import os, time
from openai import OpenAI

client = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"],
                base_url="https://api.deepseek.com")

prompt = "Make payment retries in the checkout service idempotent. Return a unified diff."

for model in ("deepseek-v4-pro", "deepseek-flash"):
    start = time.perf_counter()
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, f"{time.perf_counter() - start:.2f}s",
          r.usage.prompt_tokens, r.usage.completion_tokens)
Execute no pico e fora do pico e guarde as saídas. Baixe o Apidog para manter as diferenças, afirmações e histórico de execuções em um só lugar.
FAQ
- O V4.1-Flash é melhor que o V4-Pro em codificação? Pelos números relatados pela DeepSeek, sim: 74.2 contra 62.7 no DeepSWE v1.1 e 90.6 contra 87.9 no Terminal-Bench 2.1. Para saber como a geração V4 se comparou com o Claude em codificação, consulte DeepSeek V4 vs Claude Opus para codificação.
- O que acontece com minha integração V4-Pro em 14 de setembro? A partir das 04:00 UTC, toda solicitação de
deepseek-v4-proé atendida pelo V4.1-Flash e cobrada pelas taxas Flash. Seu código continua funcionando; o modelo por trás dele muda. O guia de migração contém a lista de verificação completa. - Preciso renomear deepseek-v4-flash para deepseek-flash? Não hoje.
deepseek-v4-flashedeepseek-v4-flash-vision-expainda são aceitos e atendidos pelo V4.1-Flash. A DeepSeek não forneceu uma data de remoção, então mude paradeepseek-flashna próxima vez que você mexer na configuração. - O V4.1-Flash é mais rápido que o V4-Pro? A DeepSeek diz que sim e não publica números. A arquitetura suporta a afirmação: 8B de parâmetros ativos no pré-preenchimento e um cache KV com um quarto do tamanho do V4-Flash. Meça o seu próprio.
- Ainda posso executar o V4-Pro em algum lugar? Não na API da DeepSeek após o dia 14. O histórico da geração V4 está em O Que É DeepSeek V4; os pesos do V4.1-Flash estão no Hugging Face sob licença MIT.
A versão resumida
O V4.1-Flash é menor, mais barato e com pontuação mais alta ao mesmo tempo, pelo menos na tabela do fornecedor, e essa tabela não pode dizer se é melhor para seus prompts. Execute ambos os IDs de modelo através do mesmo conjunto de prompts no Apidog esta semana, guarde as diferenças, e você saberá o que muda em 14 de setembro antes que seus usuários saibam.