Claude Sonnet 5.5 (claude-sonnet-5-5, lançado em 28 de setembro de 2026) custa o mesmo que o Sonnet 5, US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída, e usa o mesmo tokenizador. Ele é muito mais potente, e a Anthropic afirma que é 30%+ mais rápido. Na tabela de lançamento, o Terminal-Bench 4.0 sobe de 10,3% para 70,6%, o CursorBench 4.0 de 34,1% para 55,5%, e o OSWorld 2.1 de 57,0% para 80,1%. O problema é a API. Cinco formatos de requisição que funcionavam no Sonnet 5 agora retornam um 400, e uma alteração muda o formato da resposta sem erro. Veredito: atualize, mas corrija essas seis coisas primeiro.
Abaixo: cada mudança disruptiva com seu erro exato e JSON antes/depois, seguido por uma lista de verificação. Para especificações, veja o que é Claude Sonnet 5.5; para o salto anterior, Claude Sonnet 5 vs Sonnet 4.6. Apidog mantém requisições antigas e novas lado a lado enquanto você testa.
Sonnet 5 vs Sonnet 5.5 em um relance
| Claude Sonnet 5 | Claude Sonnet 5.5 | |
|---|---|---|
| Preço por MTok (entrada / saída / leitura de cache) | $2 / $10 / $0.20 | $2 / $10 / $0.20 |
| Contexto e saída | 1M de contexto | 1M de contexto, 128K de saída |
thinking.type aceito |
adaptive, disabled |
adaptive, between_tools |
display padrão |
omitted |
omitted |
| Esforço | low a max |
Mesmos níveis, recalibrado; padrão da API high |
| Prompt mínimo armazenável em cache | 1.024 tokens | 512 tokens |
| Esforço por mensagem, mensagens de sistema no meio da conversa | Não | Sim |
tool_choice forçado |
Suportado | Erro 400 |
| Salvaguardas cibernéticas estilo Opus | Não | Sim; ciber de alto risco retorna ao Sonnet 5 |
| Blocos de pensamento | Sem verificação de conversa | Vinculado ao modelo, conversa e conta |
| Terminal-Bench 4.0 | 10.3% | 70.6% |
| CursorBench 4.0 | 34.1% | 55.5% |
| FrontierCode 1.1 (Principal) | 42.4% | 46.2% (máx), 52.1% (xalto) |
| GDPval-AA v2.1 (Elo) | 1449 | 1844 |
| OSWorld 2.1 (parcial) | 57.0% | 80.1% |
| HLE (com ferramentas) | 54.9% | 64.5% |
| Retirada | Ainda servido como fallback cibernético | Não antes de 28 de setembro de 2027 |
A Anthropic executou Terminal-Bench, HLE e OSWorld; a Cursor executou CursorBench, Cognition FrontierCode e Artificial Analysis GDPval-AA. A própria execução do Terminal-Bench da Artificial Analysis dá 63,6% vs 14,1%, então a diferença se mantém. FrontierCode tem dois números para 5.5 porque no máximo ele frequentemente expandia subagentes de revisão, e o benchmark penaliza edições fora do escopo. Veja benchmarks do Claude Sonnet 5.5.
As cinco mudanças disruptivas
Cada uma retorna um erro 400 invalid_request_error para código que funciona bem no Sonnet 5.
1. thinking: disabled se foi; envie between_tools
O Sonnet 5.5 rejeita thinking: {"type": "disabled"}:
"thinking.type.disabled" não é suportado para este modelo. Use "thinking.type.between_tools" para a configuração de pensamento mais baixa, ou "thinking.type.adaptive" e "output_config.effort" para controlar o comportamento do pensamento.
Envie between_tools, a configuração mais baixa. Ele pula o pensamento inicial; notas de progresso entre as chamadas de ferramentas ainda chegam como blocos thinking, que você passa de volta inalterados. Funciona apenas com esforço low, medium ou high, não aceita nenhum outro campo (display, budget_tokens ou block_binding retornam um 400), e trava o esforço para a conversa.
// Antes (claude-sonnet-5)
{"model": "claude-sonnet-5", "max_tokens": 16000,
 "thinking": {"type": "disabled"},
 "output_config": {"effort": "xhigh"}}

// Depois (claude-sonnet-5-5)
{"model": "claude-sonnet-5-5", "max_tokens": 16000,
 "thinking": {"type": "between_tools"},
 "output_config": {"effort": "high"}}
Se você precisar de xhigh ou max, omita thinking para que o pensamento adaptativo seja executado.
2. tool_choice forçado retorna um 400
Um tool_choice de any ou tool falha, inclusive no endpoint de contagem de tokens:
tool_choice: os tipos "tool" e "any" não são suportados para este modelo.
Envie auto, marque a ferramenta strict: true (todo objeto precisa de additionalProperties: false), e diga no prompt quando usá-la. O modelo agora pode responder em texto, então lide com turnos sem chamada de ferramenta.
// Antes (claude-sonnet-5)
"tool_choice": {"type": "tool", "name": "get_weather"}

// Depois (claude-sonnet-5-5)
"tools": [{"name": "get_weather",
  "input_schema": {"type": "object",
    "properties": {"location": {"type": "string"}},
    "required": ["location"], "additionalProperties": false},
  "strict": true}],
"tool_choice": {"type": "auto"},
"messages": [{"role": "user",
  "content": "Qual a previsão do tempo em Paris? Use a ferramenta get_weather."}]
O limite é de 20 ferramentas estritas por requisição. No Amazon Bedrock, ferramentas estritas não estão disponíveis para o Sonnet 5.5: envie auto sem strict e valide a entrada em seu código.
3. Blocos de pensamento são vinculados ao modelo, conversa e conta
Cada bloco de pensamento do Sonnet 5.5 é assinado sobre tudo o que o precede: system, tools e mensagens anteriores. Para contas criadas em ou após 31 de agosto de 2026 (00:00 UTC), reproduzir um bloco após uma edição retorna um 400 na Claude API, Bedrock e Google Cloud:
messages.1.content.0: `signature` inválida no bloco `thinking`. O bloco está vinculado a uma conversa diferente. Remova o bloco, ou defina `thinking.block_binding.prefix_mismatch_behavior` para "drop_block".
Contas mais antigas não impõem isso por padrão, então uma execução limpa em uma chave antiga não prova nada. Mantenha as conversas apenas com anexos e altere instruções ou ferramentas com mensagens de sistema no meio da conversa. Se precisar editar, envie anthropic-beta: thinking-binding-controls-2026-08-01 e descarte blocos incompatíveis:
"thinking": {"type": "adaptive",
  "block_binding": {"prefix_mismatch_behavior": "drop_block"}}
Isso funciona apenas com pensamento adaptativo; com between_tools, remova os blocos de pensamento do turno editado em diante. O Sonnet 5.5 lê blocos do Sonnet 5, Opus 4.8, Haiku 4.5 e anteriores; ele descarta blocos do Opus 5, Opus 5.5, Fable e Mythos, e blocos do Sonnet 5.5 de outra conta, sem falhar na requisição. Nenhum outro modelo lê seus blocos. Veja pensamento preservado no Claude Fable 5.1.
4. computer_20251124 falha na Claude API e Google Cloud
Nesses ambientes, o uso do computador requer o novo conjunto de ferramentas. O erro começa assim:
'claude-sonnet-5-5' não suporta os tipos de ferramenta: computer_20251124.
// Antes (claude-sonnet-5)
"tools": [{"type": "computer_20251124", ...}]

// Depois (claude-sonnet-5-5, Claude API e Google Cloud)
"tools": [{"type": "computer_toolset_20260801"}]
Remova o cabeçalho beta antigo de uso de computador e atualize seu loop para blocos tool_use de membros, ações em lote e toolset_name nos resultados. O Bedrock ainda aceita computer_20251124; computer_20250124 falha em todos os lugares.
5. Alguns pares de conselheiros são rejeitados
Com a ferramenta de conselheiro (beta), um executor do Sonnet 5.5 aceita apenas Opus 5, Opus 5.5, Sonnet 5.5, Fable 5, Fable 5.1, Mythos 5 ou Mythos 5.1 como conselheiro. Conselheiros Sonnet 5, Opus 4.8 e Opus 4.7 agora retornam um 400. O conselho também chega criptografado como um bloco advisor_redacted_result, então o código que analisa o texto do conselho não obtém nada.
A mudança silenciosa: texto entre chamadas de ferramentas move-se para blocos de pensamento
Esta não falha em nada. No Sonnet 5, as notas entre as chamadas de ferramentas voltavam como text. No Sonnet 5.5, qualquer coisa mais longa que uma ou duas frases chega como um bloco thinking de atualização de progresso, vazio sob o display: "omitted" padrão. Uma interface de agente que transmite essas notas fica silenciosa, sem erro. Três soluções:
display: "updates"(pensamento adaptativo, cabeçalho betathinking-display-updates-2026-08-18) retorna apenas as atualizações. Sem o cabeçalho, é rejeitado.display: "summarized"mistura as atualizações com resumos de raciocínio.between_toolsretorna o texto sem a necessidade dedisplay.
// Cabeçalho: anthropic-beta: thinking-display-updates-2026-08-18
"thinking": {"type": "adaptive", "display": "updates"}
Mudanças de comportamento sem alteração de código
Estas não falham requisições, mas alteram a saída e o custo. O guia de prompting tem as soluções.
- O esforço é recalibrado. Mesmos nomes, diferentes quantidades de pensamento. Refaça sua varredura: comece em
high,mediumpara codificação agêntica bem especificada,mediumoulowpara chat; guardexhighemaxpara ganhos medidos. - Alterar o
effortde nível superior entre requisições invalida o cache de prompt. Use o esforço por mensagem beta em vez disso. - Ele pensa antes de quase toda resposta de
mediumpara cima. Diminua o esforço; pedir para pensar menos não é confiável. - Ele verifica cedo em
lowemediumem tarefas agênticas longas. - Ele adiciona testes, documentos e arquivos não solicitados, além de subagentes revisores em
xhighemax. O prompt sugerido da Anthropic reduziu o custo da sessão emmaxem cerca de um terço. - Mais recusas. É o primeiro Sonnet com salvaguardas cibernéticas estilo Opus. Uma recusa é HTTP 200 com
stop_reason: "refusal"e uma categoriastop_details; o fallback beta no lado do servidor na Claude API (fallbacks: "default") tenta novamente recusascyberefrontier_llmno Sonnet 5. - Parâmetros de amostragem.
temperature,top_poutop_knão padrão retornam um 400. A Anthropic lista isso sob mudanças do Sonnet 4.6 e anteriores, então você provavelmente já os removeu.
Custo por tarefa: mesmo preço, menos dólares por resultado
A postagem de lançamento da Anthropic afirma que o Sonnet 5.5 "custa até 30% menos por tarefa do que seu predecessor" em seus testes. Os preços são idênticos, então a economia vem de menos tokens e etapas. Seus gráficos por esforço mostram que um esforço menor no 5.5 supera o melhor desempenho do Sonnet 5:
| Benchmark (gráficos da Anthropic) | Sonnet 5.5 | Sonnet 5, melhor desempenho |
|---|---|---|
| Terminal-Bench 4.0 | 28.8% no médio, $0.83 | 10.3% no máximo, $11.62 |
| FrontierCode 1.1 | 49.4% no alto, $0.42 | 42.7% no xalto, $10.07 |
| CursorBench 4.0 | 35.8% no baixo, $0.50 | 34.1% no máximo, $7.17 |
Os custos do CursorBench são estimativas da Anthropic a preços de tabela. O outro lado é o max: de acordo com o artigo do OfficeChai sobre dados da Artificial Analysis, o Sonnet 5.5 no máximo usa cerca de 193.000 tokens de saída por tarefa de índice, e o custo por tarefa é cerca de 50% superior ao do Sonnet 5. As economias residem em high e abaixo; veja preços do Claude Sonnet 5.5.
Lista de verificação de migração
Troque claude-sonnet-5 por claude-sonnet-5-5, depois execute as seis verificações do guia de migração da Anthropic:
- Substitua
disabledporbetween_tools, com esforçohighou inferior. - Substitua
tool_choiceforçado porauto,strict: truee uma linha de prompt (no Bedrock, valide no código). - Mantenha o histórico apenas com anexos; use mensagens de sistema no meio da conversa para alterações.
- Mova o uso do computador para
computer_toolset_20260801na Claude API e Google Cloud. - Escolha um conselheiro suportado e pare de analisar o texto do conselho.
- Defina
thinking.displayse sua interface de usuário exibir texto entre as chamadas de ferramentas.
Em seguida, refaça sua varredura de esforço. O Claude Code pode automatizar a migração:
/claude-api migre este projeto para claude-sonnet-5-5
O equivalente para Opus é migração de Claude Opus 5.5 vs Opus 5.
Transforme a migração em um teste de regressão no Apidog
No Apidog, salve três requisições para https://api.anthropic.com/v1/messages em um projeto, todas no mesmo ambiente:
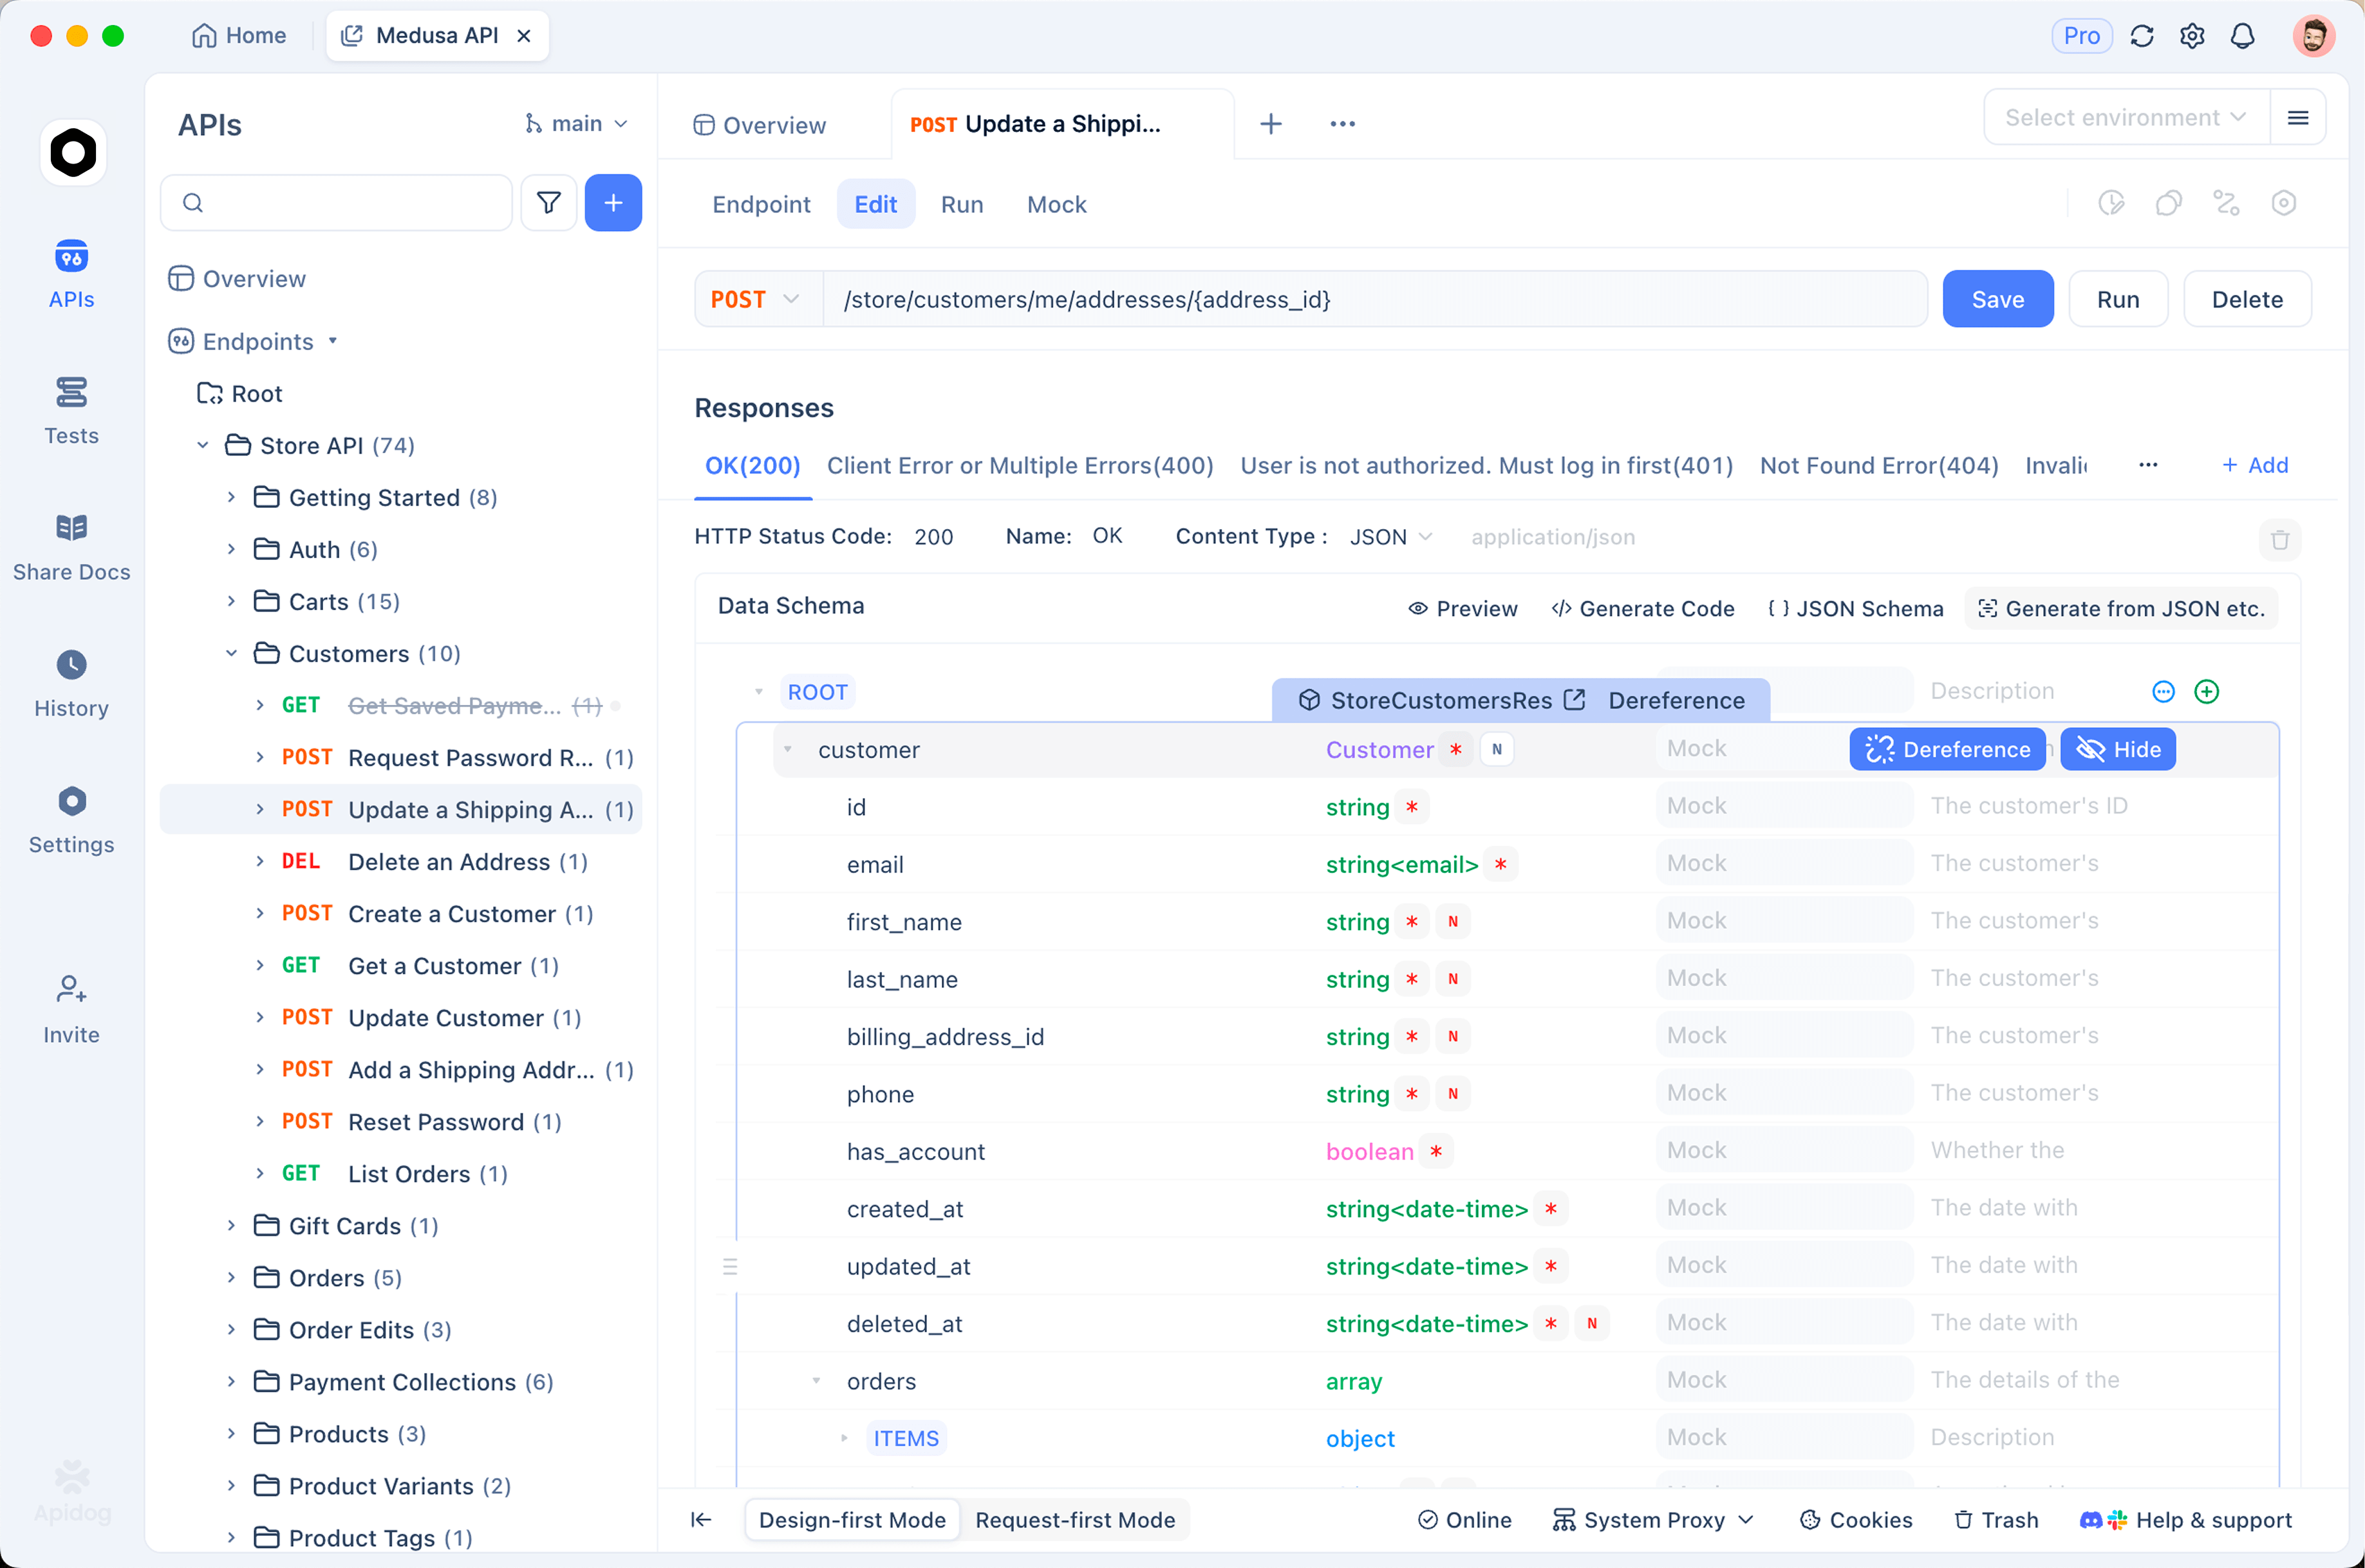
- Linha de base: seu corpo atual do Sonnet 5.
- Corpo antigo, novo modelo: apenas o
modelalterado paraclaude-sonnet-5-5. Afirme o status 400 e uma mensagem de erro mencionandobetween_toolsoutool_choice. - Migrado: o corpo corrigido. Afirme o status 200, um
stop_reasonque não sejarefusaloumax_tokens, e um blocotool_usepara requisições de ferramenta.
Mantenha ANTHROPIC_API_KEY no ambiente e referencie-o como {{ANTHROPIC_API_KEY}} no cabeçalho x-api-key. Compare usage.output_tokens entre os níveis de esforço para obter seu próprio número de custo por tarefa. Salvo como um cenário de teste, uma regressão para disabled falha na execução em vez da produção. Noções básicas de requisição: como usar a API do Claude Sonnet 5.5.
FAQ
O Claude Sonnet 5.5 é mais caro que o Sonnet 5? Não. Ambos custam US$ 2/US$ 10 por milhão de tokens com leituras de cache de US$ 0,20, e o tokenizador é o mesmo.
Por que recebo "thinking.type.disabled is not supported" no Sonnet 5.5? disabled foi removido. Envie thinking: {"type": "between_tools"} com esforço low, medium ou high, sem outros campos de pensamento.
As conversas do Sonnet 5 se transferem para o Sonnet 5.5? Sim. O Sonnet 5.5 lê blocos de pensamento do Sonnet 5. Voltar para o Sonnet 5 os perde: nenhum outro modelo lê blocos do Sonnet 5.5.
Devo mover tudo para o Sonnet 5.5? Para a maioria das cargas de trabalho, sim. Fique atento a trabalhos relacionados a cibersegurança, que podem retornar ao Sonnet 5, e chamadas de ferramentas do Bedrock, que perdem o modo estrito. Nosso guia do Claude Sonnet 5 abrange o modelo que você está deixando.
Seu próximo passo
Salve sua requisição do Sonnet 5 e seu equivalente do 5.5 lado a lado, confirme o erro 400, corrija-o e mova o tráfego assim que a correção for aprovada. Baixe o Apidog para construir esse teste.