
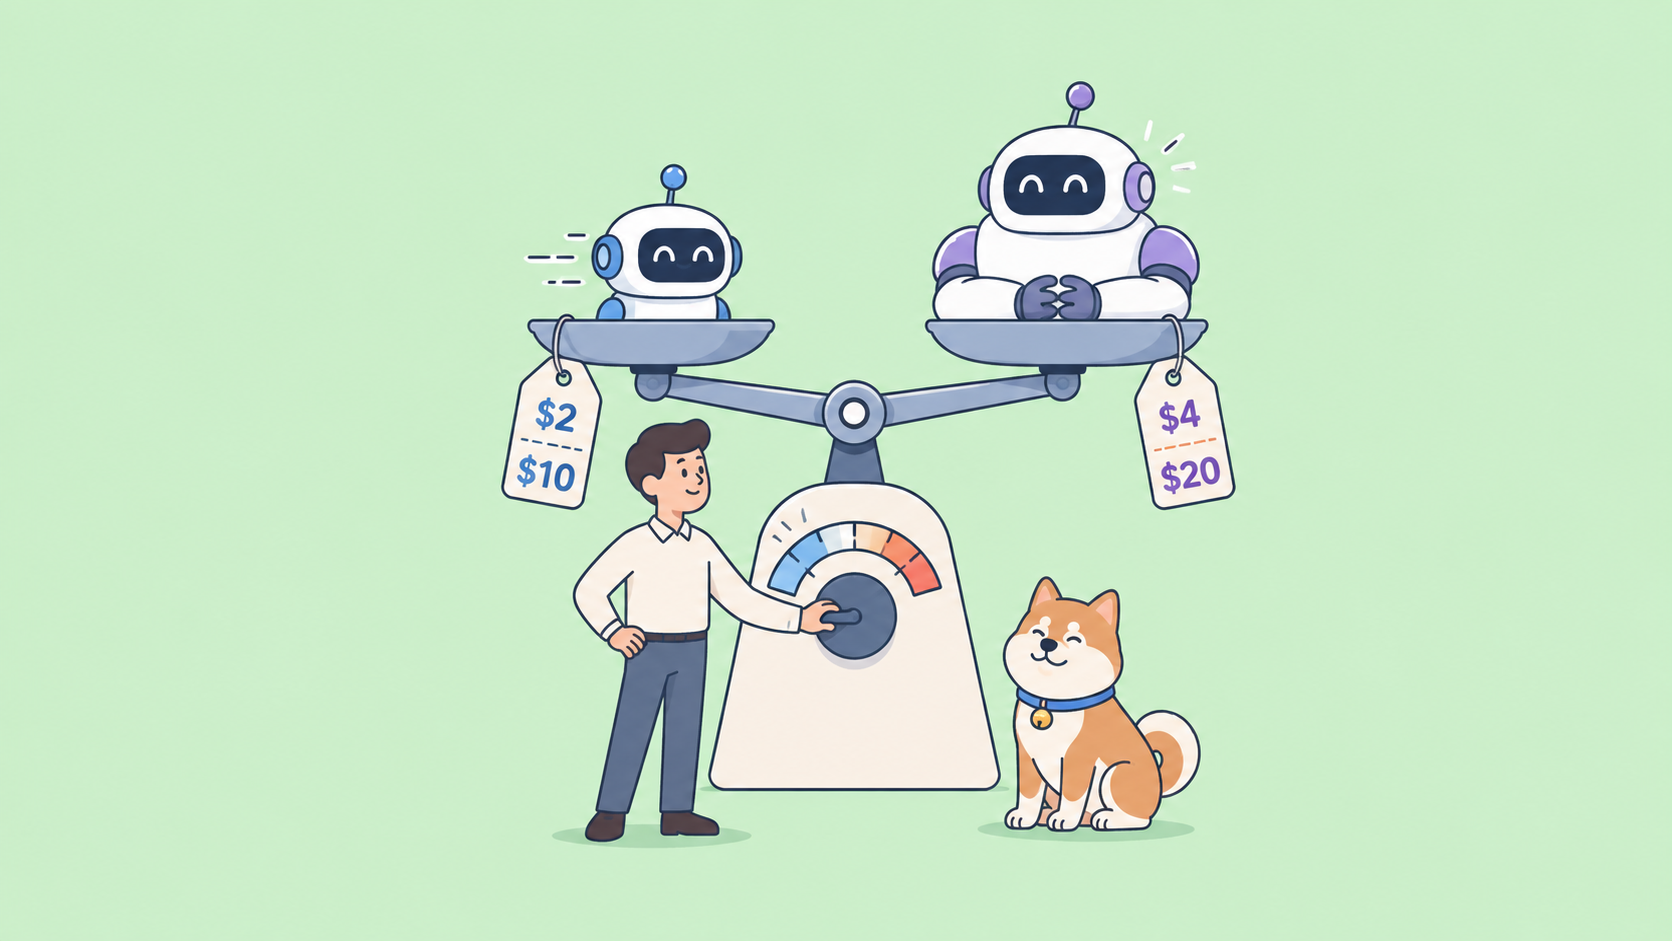
O Claude Sonnet 5.5 custa $2/$10 por milhão de tokens de entrada/saída, metade dos $4/$20 do Claude Opus 5.5. Na tabela de lançamento da Anthropic, ele fica a poucos pontos do Opus 5.5 na maioria das linhas e o supera no Terminal-Bench 4.0 (70,6% vs 66,4%), embora a Anthropic diga que o Opus 5.5 “continua claramente mais forte em trabalhos complexos e abertos.” O veredito: direcione trabalhos bem definidos, de alto volume e subagentes para o Sonnet 5.5 com esforço baixo a alto. Pague pelo Opus 5.5 em tarefas longas e abertas, ou onde você levaria o Sonnet para xhigh ou max, porque o Opus em medium ou high frequentemente pontua mais alto por um custo similar ou menor.
Para cada modelo individualmente, veja o que é Claude Sonnet 5.5 e o que é Claude Opus 5.5. A última seção mostra como testar ambos com seus próprios prompts no Apidog.
Especificações e preço lado a lado
| Sonnet 5.5 | Opus 5.5 | |
|---|---|---|
| ID do modelo da API | claude-sonnet-5-5 |
claude-opus-5-5 |
| Entrada / saída, por 1M de tokens | $2 / $10 | $4 / $20 |
| Escrita de cache (5 min) | $2.50 | $5 |
| Leitura de cache | $0.20 | $0.20 |
| Modo rápido | Não disponível | $8 / $40 |
| Esforço padrão na API | high |
medium |
| Pensamento | Adaptativo por padrão, ou between_tools |
Adaptativo, sempre ligado |
| Contexto / saída máxima | 1M / 128K | 1M / 128K |
| Classe de latência | Rápida | Moderada |
Três linhas são as mais importantes:
- As leituras de cache custam o mesmo, então em loops de agente com uso intenso de cache a diferença está principalmente na saída e nas escritas de cache. O preço do Claude Sonnet 5.5 faz os cálculos. Nenhum dos modelos cobra um prêmio por contexto longo.
- O esforço padrão difere. Um teste com configurações padrão compara o Sonnet em
highcontra o Opus emmedium, a combinação onde o Opus tende a vencer. - O modo rápido é exclusivo do Opus (docs). A Anthropic afirma que o Sonnet 5.5 gera saída 30%+ mais rápido que o Sonnet 5.
Benchmarks: próximos na tabela de lançamento, mais distantes no cartão do sistema
As linhas um a oito são da tabela de lançamento da Anthropic; o restante vem do cartão do sistema. A Cognition executou o FrontierCode, a Cursor o CursorBench, a Zapier o AutomationBench e a Artificial Analysis (AA) o GDPval-AA e o AA-Briefcase; a Anthropic executou os outros. O Sonnet está no esforço máximo, a menos que seja notado.
| Benchmark | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 66.4% (xhigh) |
| FrontierCode 1.1 Main | 46.2% max, 52.1% xhigh | 54.4% |
| CursorBench 4.0 | 55.5% | 57.8% |
| GDPval-AA v2.1 (Elo) | 1844 | 1846 |
| AA-Briefcase v1.1 (Elo) | 1811 | 1822 |
| HLE, com ferramentas | 64.5% | 67.7% |
| OSWorld 2.1, parcial | 80.1% | 81.8% |
| Cartografia, sem ferramentas | 61.6% | 64.4% |
| SWE-Bench Pro | 81.3 | 89.9 |
| SWE-Bench Multimodal | 54.3 | 61.4 |
| HLE, sem ferramentas | 56.9 | 64.4 |
| OSWorld 2.1, aprovação rigorosa | 43.5% | 48.7% |
| ProgramBench, contexto longo | 79.7% | 91.2% |
| Terminal-Bench-Science 0.1 | 59.9% | 58.7% |
| AutomationBench | 44.7 | 42.5 |
| HealthBench Professional | 69.2 | 65.6 |
A tabela de lançamento é a mais lisonjeira: fora do Terminal-Bench, o Opus lidera suas linhas de porcentagem por 1,7 a 3,2 pontos, contando o Sonnet com pontuação FrontierCode xhigh. Cinco linhas do cartão do sistema ampliam a diferença para 5,2 a 11,5 pontos: SWE-Bench Pro, SWE-Bench Multimodal, HLE sem ferramentas, OSWorld rigoroso e ProgramBench de contexto longo. Trabalhos longos, não assistidos e de tarefas completas são onde o Opus se mantém à frente.
Leia a vitória do Terminal-Bench 4.0 com cuidado: a seção 8.5 do cartão do sistema diz que o fallback de segurança afetou 10% dos testes do Opus contra 1,5% dos do Sonnet, e a própria execução da AA pontuou o Sonnet 5.5 em 63,6%. Detalhes em Benchmarks do Claude Sonnet 5.5.
O esforço decide o confronto
A tabela de lançamento compara cada modelo em sua melhor configuração. Sua conta não. A página de lançamento da Anthropic plota cada nível de esforço com o custo por tentativa ou tarefa:
| Benchmark, modelo | Low | Medium | High | Xhigh | Max |
|---|---|---|---|---|---|
| Terminal-Bench, Sonnet | 20.0% ($0.76) | 28.8% ($0.83) | 43.0% ($1.94) | 61.5% ($5.30) | 70.6% ($12.54) |
| Terminal-Bench, Opus | 38.5% ($1.29) | 57.6% ($2.94) | 64.2% ($3.88) | 66.4% ($7.35) | 64.8% ($11.24) |
| CursorBench, Sonnet | 35.8% ($0.50) | 39.2% ($0.70) | 47.8% ($1.67) | 53.1% ($3.88) | 55.5% ($9.67) |
| CursorBench, Opus | 43.7% ($1.17) | 52.5% ($2.91) | 56.0% ($3.97) | 56.0% ($6.98) | 57.8% ($13.43) |
| FrontierCode, Sonnet | 29.3% ($0.19) | 36.5% ($0.24) | 49.4% ($0.42) | 52.1% ($1.59) | 46.2% ($20.78) |
| FrontierCode, Opus | 47.3% ($0.40) | 54.6% ($0.80) | 54.0% ($1.09) | 51.4% ($2.25) | 54.4% ($6.19) |
| AA-Briefcase, Sonnet | 1264 ($0.87) | 1461 ($1.64) | 1634 ($3.95) | 1746 ($9.63) | 1811 ($29.19) |
| AA-Briefcase, Opus | 1285 ($1.15) | 1642 ($4.40) | 1705 ($6.27) | 1780 ($12.27) | 1822 ($21.05) |
O que isso mostra:
- O Opus em
mediumfrequentemente supera o Sonnet emhigh. Terminal-Bench 4.0: O Opus pontua 57,6% por $2,94 por tentativa, o Sonnet 43,0% por $1,94. - O Opus abaixo do
maxpode superar o melhor do Sonnet por menos. CursorBench: Opus emhigh(56,0%, $3,97) vs Sonnet emmax(55,5%, $9,67). FrontierCode: Opus emmedium(54,6%, $0,80) vs o melhor do Sonnet (52,1%, $1,59). - O Sonnet em
maxpode custar mais que o Opus emmax: $29,19 vs $21,05 no AA-Briefcase, por uma pontuação mais baixa. No FrontierCode, a pontuação máxima do Sonnet caiu abaixo de sua pontuação xhigh porque ele distribuiu subagentes de revisão, segundo a nota de rodapé da Anthropic. - O Sonnet domina a parte inferior da curva. Sua configuração
lowsupera o ponto mais barato do Opus em todos os gráficos.
Metade do preço por token não significa metade do custo por tarefa: o Sonnet gasta mais tokens à medida que o esforço aumenta. Dados da AA, conforme relatado por OfficeChai, colocam o Sonnet 5.5 em cerca de 193.000 tokens de saída por tarefa de índice no max, aproximadamente 60% a mais que o Opus 5.5.
Esse é o principal debate no tópico do Hacker News: muitos comentaristas interpretam os gráficos como indicando que o Opus em um esforço menor se iguala ou supera o Sonnet em high ou xhigh, deixando o nicho do Sonnet para esforços low ou medium e como um subagente sob um orquestrador Opus.
O guia de prompting da Anthropic diz que o esforço do Sonnet 5.5 foi recalibrado: comece em high (medium para codificação agêntica bem especificada) e guarde xhigh e max para ganhos medidos. Mudar o esforço de nível superior entre requisições invalida o cache do prompt, então defina-o por carga de trabalho (guia da API).
Diferenças de segurança e comportamento
Os resultados de injeção de prompt são divididos. No benchmark de injeção de prompt indireta da Gray Swan, a taxa de sucesso de ataque do Sonnet 5.5 é de 3,4% em 15 tentativas (Sonnet 5: 6,7%): menos resistente que o Opus 5.5, mais que todos os modelos não-Claude testados, mais fraco no uso de computador com GUI (12,5%). Contra os atacantes adaptativos da Shade, o Sonnet supera o Opus em codificação (3,01% vs 54,61% sem salvaguardas, 2,63% vs 11,13% com sondas ativadas) e empata no uso de computador (0,07%); no uso de navegador, é o primeiro modelo avaliado pela Anthropic sem ataques bem-sucedidos. Veja Opus 5.5 e injeção de prompt.
Ambos os modelos possuem salvaguardas cibernéticas; o Sonnet 5.5 é o primeiro Sonnet a tê-las. Tarefas cibernéticas de maior risco sinalizadas retornam ao Sonnet 5, automaticamente nos aplicativos da Anthropic e na API apenas se você optar por isso (fallbacks: "default", beta). O cartão do sistema alerta para mais recusas mesmo em trabalhos de segurança benignos.
O cartão do sistema também considera o Sonnet 5.5 mais honesto sob pressão do que o Opus 5.5, mas mais propenso à alucinação.
Misturando Sonnet 5.5 e Opus 5.5 em um sistema
Uma forma de ter ambos: o Opus planeja, o Sonnet executa. Três mecânicas importam.
Os blocos de pensamento não se cruzam. O Sonnet 5.5 descarta os blocos de pensamento do Opus 5 e Opus 5.5 (não faturados; a requisição ainda retorna 200), e os blocos estão vinculados ao modelo, conversação e conta. Troque de modelo no meio da conversação e o raciocínio se perde, então passe o estado via texto: o Opus escreve o plano como uma mensagem, o Sonnet começa a partir dela (guia de migração).
A ferramenta de consultoria aceita o Opus 5.5 como consultor para um executor Sonnet 5.5; o conselho retorna criptografado como advisor_redacted_result.
O Claude Code tem opusplan: Opus no modo de planejamento, Sonnet para execução. O alias sonnet significa Sonnet 5.5 apenas na API da Anthropic (v2.1.284 ou posterior), então no Bedrock, Google Cloud e Foundry, opusplan executa em um Sonnet mais antigo. Veja Claude Sonnet 5.5 no Claude Code.
Onde o GPT-6 Sol se encaixa
O GPT-6 Sol compartilha o preço de tabela de $2/$10 do Sonnet 5.5, com leituras em cache de $0,20 (90% de desconto) e uma janela de contexto de 872k. A tabela da Anthropic atribui quatro células ao Sol: FrontierCode 49,3%, GDPval-AA 1487, AA-Briefcase 1483 e Cartografia 53,6% sem ferramentas. Uma nota de rodapé diz que a OpenAI corrigiu recentemente um bug de compreensão de imagem do Sol que as pontuações da AA e Surge AI podem ainda não refletir.
O custo por tarefa varia por benchmark. No AA-Briefcase em max, o Sol custa $2,67 por tarefa contra $29,19 do Sonnet, pontuando 1483 contra 1811. No FrontierCode, o Sonnet em high iguala o melhor do Sol (49,4% vs 49,3%) por $0,42 contra $2,07. Veja GPT-6 Sol vs Claude Opus 5.5 e o que é GPT-6 Sol.
Qual modelo para qual carga de trabalho
| Carga de trabalho | Modelo e esforço |
|---|---|
| Chat de alto volume, classificação, extração | Sonnet 5.5, low ou medium |
| Correções de bugs bem definidas, mudanças do tamanho de PR | Sonnet 5.5, medium ou high |
| Subagentes executando um plano Opus | Sonnet 5.5, medium ou high |
| Trabalho agêntico longo e aberto | Opus 5.5, medium depois high |
Qualquer coisa que precise do Sonnet em xhigh ou max |
Opus 5.5, medium ou high |
| Raciocínio de base de código com contexto longo | Opus 5.5, medium ou superior |
| Agentes lendo conteúdo não confiável | Ambos; teste seus próprios casos de injeção |
Teste ambos com seu próprio tráfego
Cada gráfico acima veio da estrutura de outra pessoa, não de seus prompts, ferramentas ou mix de tokens. Comece com a combinação que os dados indicam:
ask() {
  curl -s https://api.anthropic.com/v1/messages \
    -H "x-api-key: $ANTHROPIC_API_KEY" \
    -H "anthropic-version: 2023-06-01" \
    -H "content-type: application/json" \
    -d '{"model":"'"$1"'","max_tokens":16000,
         "output_config":{"effort":"'"$2"'"},
         "messages":[{"role":"user","content":"Review this diff and list each bug as JSON: ..."}]}' \
  | jq '{model, stop_reason, usage}'
}
ask claude-sonnet-5-5 high
ask claude-opus-5-5 medium
No Apidog, torne-o repetível: uma requisição para https://api.anthropic.com/v1/messages, ANTHROPIC_API_KEY como variável de ambiente, e {{model}} e {{effort}} no corpo. Duplique-o para cada combinação e adicione um pós-processador para que cada execução verifique as mesmas coisas:
const body = pm.response.json();
pm.test("finished cleanly", () => {
  pm.expect(body.stop_reason).to.not.be.oneOf(["max_tokens", "refusal"]);
});
pm.test("stays inside the token budget", () => {
  pm.expect(body.usage.output_tokens).to.be.below(8000);
});
Execute cada par de 10 a 20 vezes e compare o uso, tempo de resposta e taxa de aprovação; tokens vezes o preço de tabela é o seu custo real por tarefa. Mais em como testar aplicações LLM.
Perguntas Frequentes
O Claude Sonnet 5.5 é melhor que o Opus 5.5? Não na maioria das linhas. O Opus 5.5 lidera a tabela de lançamento, exceto no Terminal-Bench 4.0 e em um quase-empate no GDPval-AA. O confronto da geração anterior: Claude Opus 5 vs Sonnet 5.
O Sonnet 5.5 custa metade do Opus 5.5? Por token, sim. Por tarefa, depende do esforço: no max, o Sonnet custou mais no AA-Briefcase ($29,19 vs $21,05).
Posso trocar de modelo no meio da conversa? Sim, mas o Sonnet 5.5 descarta os blocos de pensamento do Opus 5.5, então passe o estado como texto.
Sonnet 5.5 ou GPT-6 Sol por $2/$10? O Sonnet lidera todas as quatro linhas compartilhadas em sua melhor configuração; o Sol pode ser muito mais barato por tarefa. Teste ambos.
Próximo passo
Execute seus dois prompts mais caros com o Sonnet 5.5 em high e o Opus 5.5 em medium, e compare a taxa de aprovação e o custo por tarefa antes de mudar uma regra de roteamento. Para manter as requisições, asserções e resultados em um único projeto, baixe o Apidog.