
O Claude Sonnet 5.5 custa US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída na API do Claude, o mesmo que o Sonnet 5. As leituras de cache custam US$ 0,20 por milhão, a API Batch reduz ambas as taxas para US$ 1 e US$ 5, a janela de contexto completa de 1M é cobrada pela taxa padrão, e o modo rápido não é oferecido. O aumento planejado do Sonnet 5 para 1º de setembro para US$ 3/US$ 15 foi cancelado, então US$ 2/US$ 10 é agora o preço padrão.
Este guia lista cada item de preço do Claude Sonnet 5.5, apresenta três exemplos de custo com a aritmética mostrada e explica por que o esforço afeta sua conta mais do que a taxa por token. Novo no modelo? Comece com o que é o Claude Sonnet 5.5, ou leia como usar o Claude Sonnet 5.5 gratuitamente. Para verificar os números em relação ao seu próprio tráfego, envie a solicitação do Apidog e leia o bloco usage em cada resposta.
Tabela de preços da API Claude Sonnet 5.5
Preços por milhão de tokens (MTok), da documentação de preços da Anthropic:
| Item | Preço por MTok |
|---|---|
| Entrada | US$ 2,00 |
| Escrita de cache de 5 minutos | US$ 2,50 |
| Escrita de cache de 1 hora | US$ 4,00 |
| Leitura de cache | US$ 0,20 |
| Saída | US$ 10,00 |
| Entrada em lote | US$ 1,00 |
| Saída em lote | US$ 5,00 |
Três detalhes mudam o que você paga:
- Inferência apenas nos EUA.
inference_geo: "us"custa 1,1x em cada categoria de token na API do Claude e na Plataforma Claude na AWS (entrada de US$ 2,20, saída de US$ 11, leituras de cache de US$ 0,22). A implantação da Zona de Dados dos EUA da Foundry tem o mesmo 1,1x; Bedrock e Google Cloud precificam separadamente. - Sem prêmio para contexto longo. Uma solicitação de 900 mil tokens custa o mesmo por token que uma de 9 mil tokens.
- Mesmo tokenizador do Sonnet 5. Suas contagens de tokens são transferidas sem alterações.
Como o Sonnet 5.5 se compara em preço de tabela
| Modelo | Entrada | Saída | Observações |
|---|---|---|---|
| Claude Sonnet 5.5 | US$ 2 | US$ 10 | Leitura de cache US$ 0,20; contexto de 1M; sem modo rápido |
| Claude Sonnet 5 | US$ 2 | US$ 10 | Leitura de cache US$ 0,20; aumento de US$ 3/US$ 15 cancelado |
| Claude Opus 5.5 | US$ 4 | US$ 20 | Leitura de cache US$ 0,20; modo rápido US$ 8/US$ 40 |
| Claude Haiku 4.5 | US$ 1 | US$ 5 | contexto de 200 mil |
| GPT-6 Sol | US$ 2 | US$ 10 | 90% de desconto na entrada em cache; contexto de 872 mil |
| GPT-6 Luna | US$ 0,10 | US$ 0,50 | contexto de 1M |
O Sonnet 5.5 custa metade do Opus 5.5 em entrada, saída e escritas de cache. Ele compartilha o preço de tabela exato de US$ 2/US$ 10 com o GPT-6 Sol, então a escolha entre os dois se resume aos resultados por tarefa. Para o histórico, veja preços do Claude Sonnet 5, a guerra de preços de setembro de 2026 e preços do GPT-6 Sol.
Exemplos práticos: o custo de solicitações reais
A fórmula para cada linha: tokens ÷ 1.000.000 × preço por MTok. Precifique cada item, depois some.
Exemplo 1: uma solicitação estilo chat
3.000 tokens de entrada, 800 tokens de saída, sem cache.
- Entrada: 3.000 ÷ 1.000.000 × US$ 2 = US$ 0,006
- Saída: 800 ÷ 1.000.000 × US$ 10 = US$ 0,008
- Total: US$ 0,006 + US$ 0,008 = US$ 0,014
Mil dessas custam US$ 14. A saída representa 21% dos tokens, mas 57% da conta, então o comprimento da saída importa mais do que o comprimento do prompt.
Exemplo 2: um agente relendo um prefixo de 50.000 tokens
Um loop de agente envia o mesmo prefixo de 50.000 tokens (prompt do sistema, ferramentas, contexto do repositório) em 20 chamadas. Apenas o prefixo é precificado aqui.
Sem cache: 20 × 50.000 = 1.000.000 tokens; 1.000.000 ÷ 1.000.000 × US$ 2 = US$ 2,00
Em cache, com uma escrita de 5 minutos:
- A chamada 1 escreve o cache: 50.000 ÷ 1.000.000 × US$ 2,50 = US$ 0,125
- As chamadas 2 a 20 o leem: 19 × 50.000 = 950.000 tokens; 950.000 ÷ 1.000.000 × US$ 0,20 = US$ 0,19
- Total: US$ 0,125 + US$ 0,19 = US$ 0,315
Isso economiza US$ 1,685, cerca de 84%. A escrita de 5 minutos compensa apenas enquanto as chamadas ocorrem dentro da janela; para loops mais lentos, uma escrita de 1 hora custa 50.000 ÷ 1.000.000 × US$ 4 = US$ 0,20, então o total é US$ 0,20 + US$ 0,19 = US$ 0,39, ainda cerca de 80% abaixo do custo sem cache. O mesmo raciocínio é aplicado para o Opus em nossa matemática de custo de cache de prompt; a taxa de leitura de US$ 0,20 é idêntica.
Exemplo 3: um trabalho em lote de 10.000 solicitações
Mesmo formato do Exemplo 1, enviado através da API Batch.
- Entrada: 10.000 × 3.000 = 30.000.000 tokens; 30 × US$ 1 = US$ 30
- Saída: 10.000 × 800 = 8.000.000 tokens; 8 × US$ 5 = US$ 40
- Total em lote: US$ 70, contra 30 × US$ 2 + 8 × US$ 10 = US$ 140 nas taxas padrão
O Batch também eleva o limite de saída de 128 mil para 300 mil tokens com a beta output-300k-2026-03-24.
Custo por tarefa, não por token
O cartão de tarifas informa quanto custa um token, não quantos tokens sua tarefa consome. Esse segundo número varia muito mais com o esforço do que qualquer diferença de taxa entre os modelos.
A Anthropic afirma que, em seus testes, o Sonnet 5.5 "custa até 30% menos por tarefa do que seu predecessor". O post de lançamento também mostra o custo em cada nível de esforço. As execuções do Terminal-Bench 4.0 são da própria Anthropic, o FrontierCode foi executado pela Cognition, e os custos de índice vêm da Artificial Analysis:
| Esforço | Terminal-Bench 4.0 (pontuação, US$/tentativa) | FrontierCode v1.1 (pontuação, US$/tarefa) | Índice AA (pontuação, custo para executar) |
|---|---|---|---|
| baixo | 20,0%, US$ 0,76 | 29,3%, US$ 0,19 | 35,8, US$ 544 |
| médio | 28,8%, US$ 0,83 | 36,5%, US$ 0,24 | 40,7, US$ 701 |
| alto | 43,0%, US$ 1,94 | 49,4%, US$ 0,42 | 46,7, US$ 1.176 |
| muito alto | 61,5%, US$ 5,30 | 52,1%, US$ 1,59 | 51,9, US$ 2.738 |
| máximo | 70,6%, US$ 12,54 | 46,2%, US$ 20,78 | 56,0, US$ 8.977 |
O que se destaca:
- O máximo custa cerca de 6,5x o alto no Terminal-Bench (US$ 12,54 ÷ US$ 1,94 = 6,46). O índice da Artificial Analysis custou cerca de 16,5x mais para ser executado no máximo do que no baixo (US$ 8.977 ÷ US$ 544).
- Mais esforço nem sempre é melhor. O FrontierCode cai de 52,1% em muito alto para 46,2% em máximo, enquanto o custo por tarefa aumenta 13x (US$ 20,78 ÷ US$ 1,59). A nota de rodapé da Anthropic diz que, no máximo, o modelo executava com mais frequência uma habilidade de revisão que distribuía subagentes, o que causava tempo limite ou edições fora do escopo nos casos examinados pela Cognition.
- Opus com menor esforço compete. O Opus 5.5 em médio obteve 57,6% no Terminal-Bench por US$ 2,94, contra 43,0% do Sonnet 5.5 em alto por US$ 1,94. Nossa comparação Sonnet 5.5 vs Opus 5.5 explora essa troca.
A verbosidade no máximo é a outra armadilha. A análise da OfficeChai dos dados da Artificial Analysis coloca o Sonnet 5.5 em cerca de 193.000 tokens de saída por tarefa de índice no máximo, com um custo por tarefa cerca de 50% acima do Sonnet 5. Simon Willison relatou no Hacker News que uma execução de esforço máximo consumiu 128.000 tokens de pensamento e esgotou-se antes de produzir a resposta.
Seis alavancas que reduzem a conta
- Defina o esforço intencionalmente. A API padrão é
high; o Claude Code e os aplicativos Claude padrão sãomedium. O guia de prompt da Anthropic sugeremediumoulowpara chat exhighoumaxapenas para ganhos de qualidade medidos. Não transfira as configurações do Sonnet 5; a escala foi recalibrada. - Use
between_toolsonde você tinha o pensamento desativado.thinking: {"type": "disabled"}agora retorna um erro 400;{"type": "between_tools"}o substitui emlow,mediumehigh. - Armazene em cache tudo que for reutilizado. O prompt mínimo armazenável em cache é de 512 tokens (1.024 no Sonnet 5). Alterar o
effortde nível superior entre as solicitações invalida o cache, então mantenha-o estável. - Agrupe o que pode esperar. Metade do preço na entrada e na saída.
- Mantenha
max_tokenshonesto. O guia da Anthropic tratastop_reason: "max_tokens"como uma resposta falha, então uma resposta truncada é um gasto sem nada a entregar. - Corte o trabalho não solicitado. O Sonnet 5.5 adiciona testes, documentos e arquivos que você não pediu, e inicia rodadas extras de revisão em
xhighemax. O parágrafo de prompt de sistema sugerido pela Anthropic reduziu o custo da sessão em cerca de um terço nomaxsem alteração na qualidade.
Onde mais você paga pelo Sonnet 5.5
- Planos Claude (claude.com/pricing): O Gratuito é US$ 0 e inclui o Sonnet no chat, sem Claude Code. O Pro custa US$ 17/mês cobrado anualmente ou US$ 20 mensalmente. O Max começa em US$ 100/mês. As vagas para equipes custam US$ 20/US$ 25 (padrão) ou US$ 100/US$ 125 (premium), anuais/mensais. Nenhum deles inclui acesso à API.
- GitHub Copilot: Pro (US$ 10/mês), Pro+, Max, Business e Enterprise, cobrado de acordo com a lista de preços do provedor. O Copilot Pro inclui 1.500 créditos de IA por mês a US$ 0,01 cada, cerca de US$ 15 em tokens, ou aproximadamente 1.070 solicitações do Exemplo 1 (US$ 15 ÷ US$ 0,014). O Copilot Gratuito e Estudante não podem selecioná-lo.
- Cursor: as mesmas taxas do pool de Outros Modelos (Pro, Pro Plus e Ultra), mais 10% para endpoints apenas nos EUA (US$ 2,20/US$ 11).
- OpenRouter: US$ 2/US$ 10, ou US$ 1/US$ 5 na variante
:batch. Nenhuma variante:free. - Vercel AI Gateway: US$ 2/US$ 10 com leituras de cache de US$ 0,20. O crédito gratuito de US$ 5 não cobre o Sonnet 5.5.
- Bedrock, Google Cloud, Foundry: cada página de preços da nuvem. O Bedrock suporta apenas o nível Padrão, sem Batch.
Procurando por créditos em vez disso? Veja existe uma API gratuita do Claude Sonnet 5.5.
Rastreie o custo por solicitação no Apidog
Cada resposta de Mensagens contém um objeto usage com input_tokens, output_tokens e contagens de cache. Isso é suficiente para precificar qualquer chamada no Apidog:
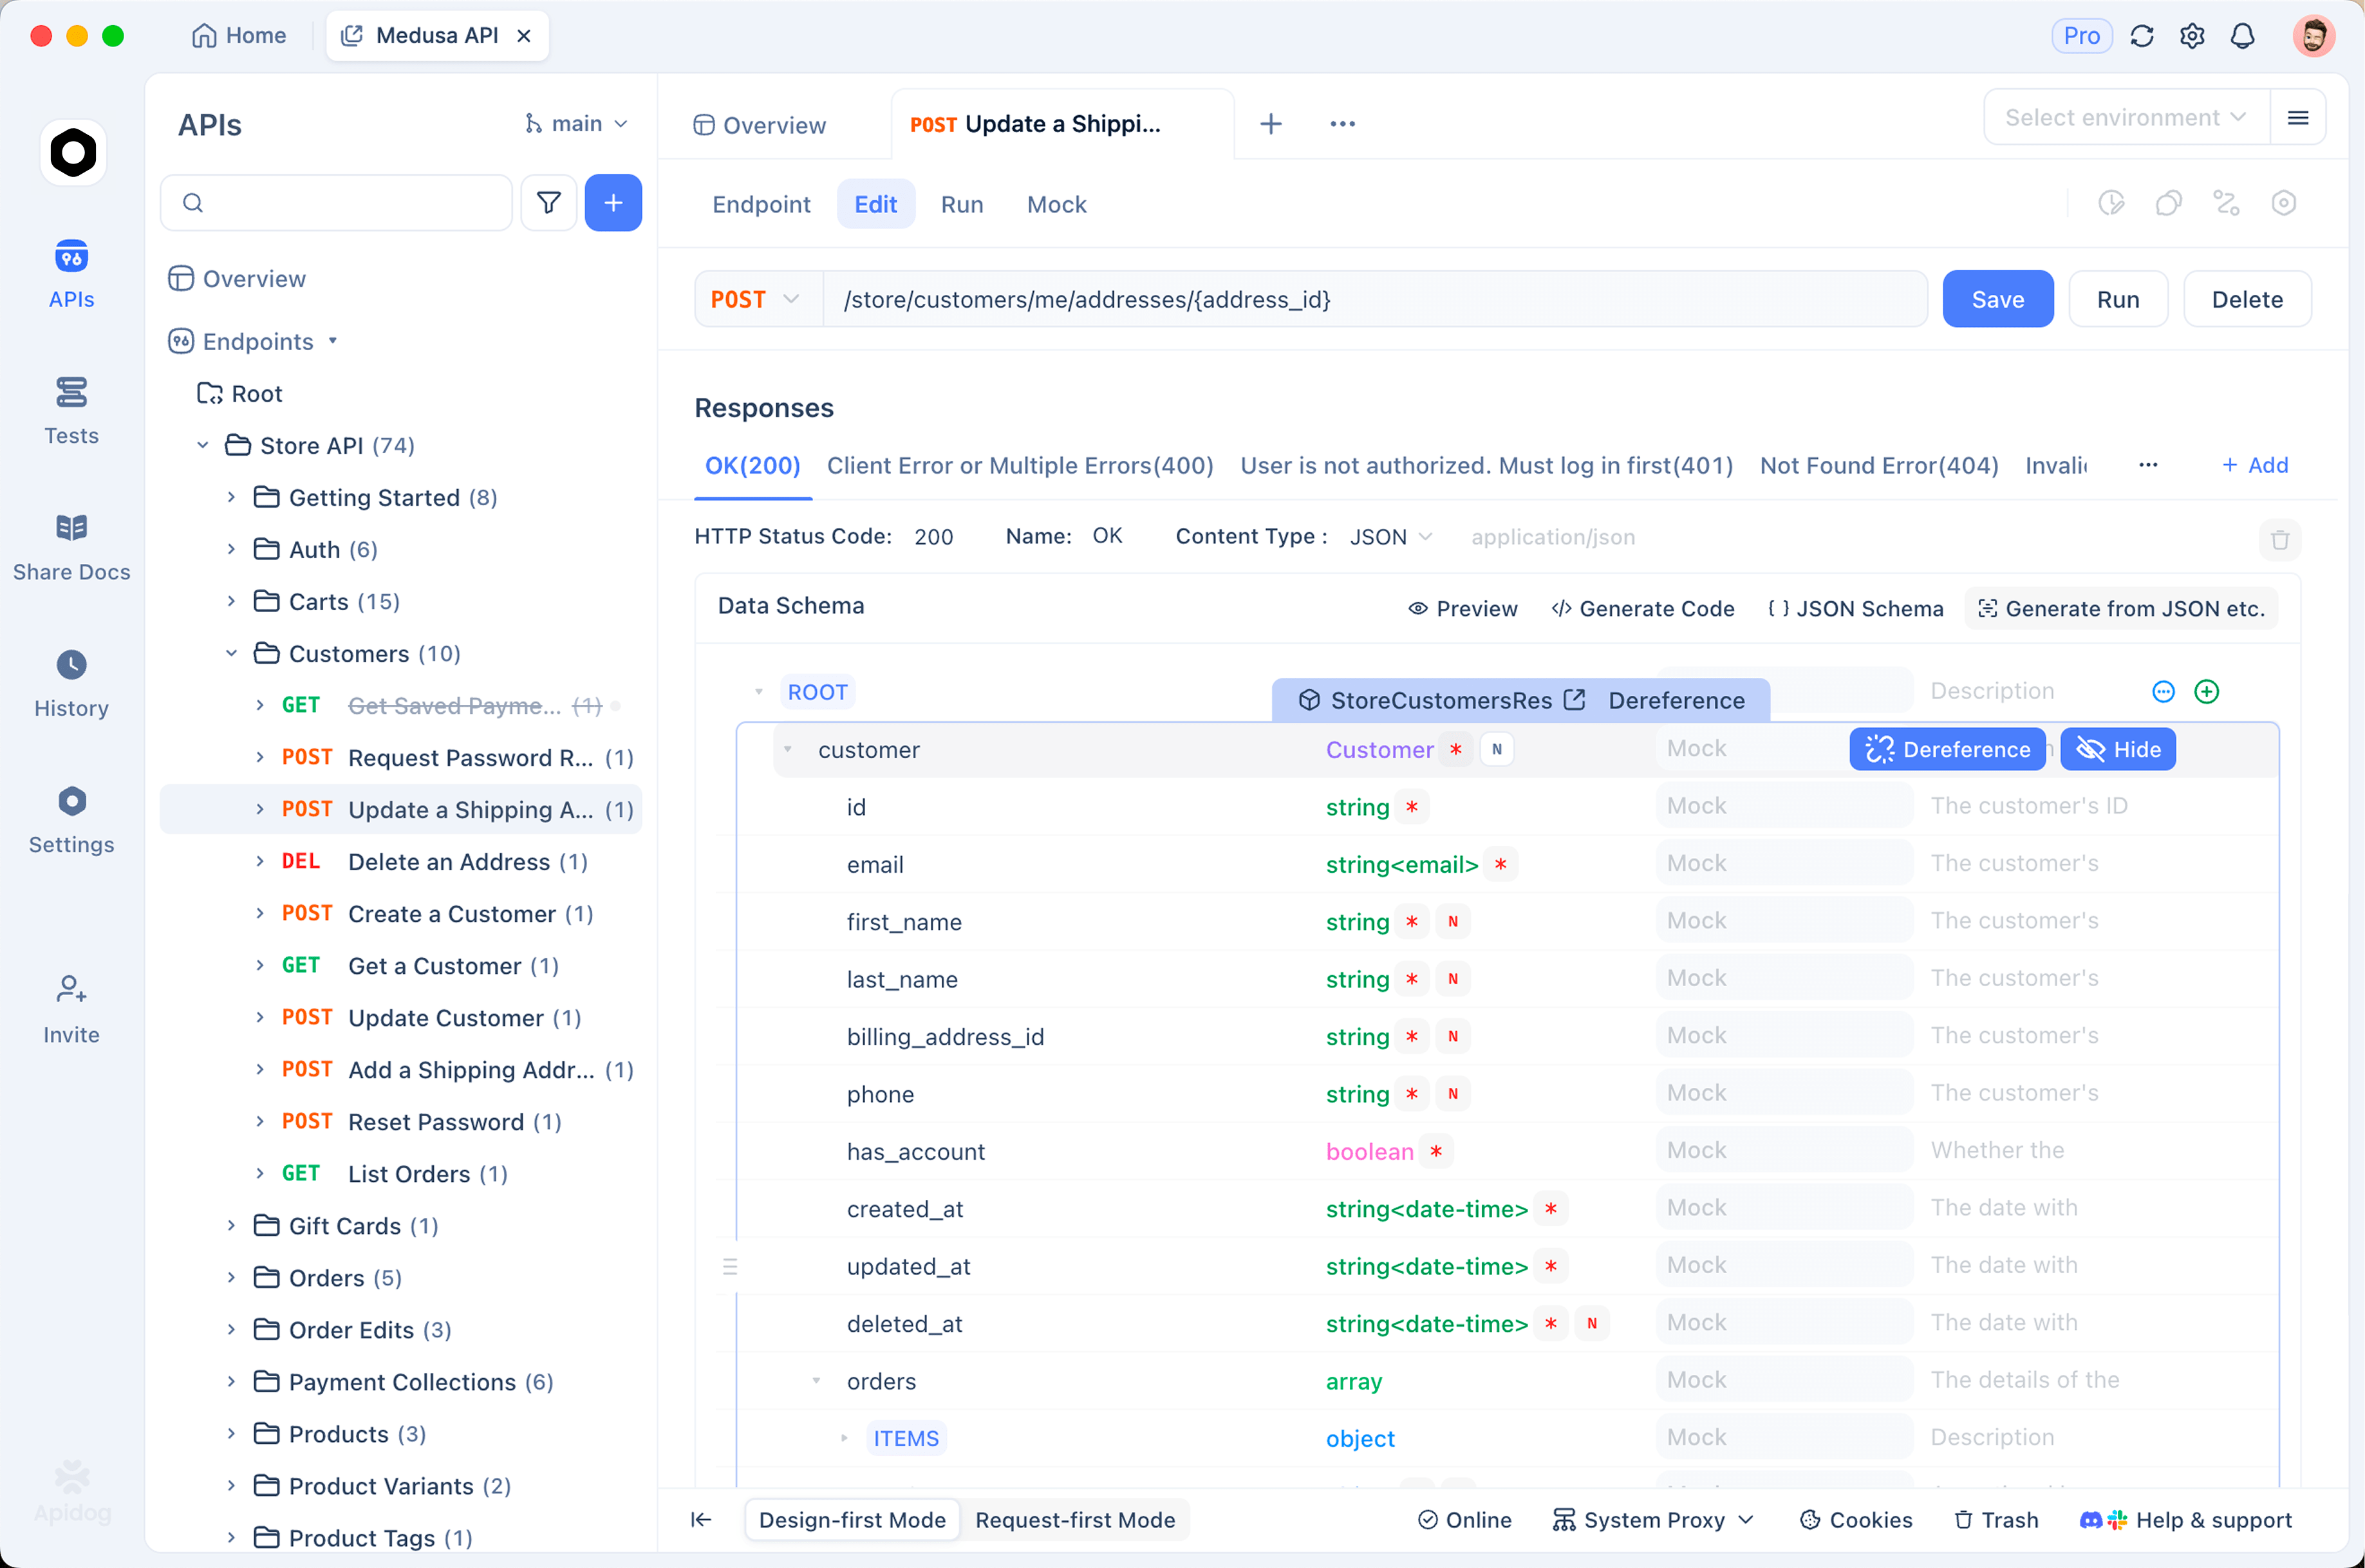
- Armazene sua chave como uma variável de ambiente
ANTHROPIC_API_KEY. - Salve esta solicitação uma vez por nível de esforço (
low,medium,high) com o mesmo prompt:
curl https://api.anthropic.com/v1/messages \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{
    "model": "claude-sonnet-5-5",
    "max_tokens": 4000,
    "thinking": {"type": "between_tools"},
    "output_config": {"effort": "medium"},
    "messages": [{"role": "user", "content": "Classify this support ticket: ..."}]
  }'
- Adicione um pós-processador que precifica a chamada e falha em caso de truncamento:
const body = pm.response.json();
const u = body.usage;
const cost = (u.input_tokens * 2 + u.output_tokens * 10) / 1e6;
pm.environment.set("last_call_usd", cost.toFixed(5));
pm.test("not truncated", () => pm.expect(body.stop_reason).to.not.eql("max_tokens"));
- Execute os três e compare
usage.output_tokense o custo lado a lado. Se você usar cache, adicione as contagens de cache às suas próprias taxas.
O passo a passo completo da solicitação está em como usar a API Claude Sonnet 5.5.
FAQ
- Quanto custa o Claude Sonnet 5.5 por milhão de tokens? US$ 2 de entrada e US$ 10 de saída na API do Claude. As leituras de cache custam US$ 0,20; a API Batch cobra US$ 1 e US$ 5.
- O Sonnet 5.5 é mais caro que o Sonnet 5? Não. O preço por token é idêntico, e a Anthropic diz que o Sonnet 5.5 custa até 30% menos por tarefa em seus testes.
- Existe uma sobretaxa acima de 200 mil tokens? Não. A janela completa de 1M é cobrada pela taxa padrão.
- O Sonnet 5.5 tem modo rápido? Não. O modo rápido está disponível apenas no Opus 5.5, Opus 5 e Opus 4.8.
- O Claude Sonnet 5.5 é gratuito? No aplicativo de chat Claude, sim: qualquer pessoa pode conversar com ele no plano Gratuito. A API funciona com créditos pré-pagos; o guia da API gratuita aborda os programas de crédito.
Próximo passo: precifique sua própria carga de trabalho
Pegue suas três formas de solicitação mais comuns, execute cada uma em dois níveis de esforço e multiplique os números de usage pela tabela acima. Você verá rapidamente se o medium atende ao seu padrão de qualidade ou se o high justifica seus tokens extras. Baixe o Apidog para manter essas solicitações e o script de custo lado a lado.