
Para escolher entre Claude Fable 5.2 vs Opus 5.5, comece com o Opus 5.5 para codificação do dia a dia e trabalhos com conhecimento. Experimente o Fable 5.2 quando raciocínios difíceis, migrações ambíguas ou projetos de agentes de longa duração superarem o seu patamar com o Opus. Compare as configurações de esforço e o custo por resultado aceito antes de migrar toda a sua carga de trabalho.
Essa recomendação segue o anúncio do Fable 5.2 da Anthropic, verificado em 10 de novembro de 2026. Esta é uma comparação baseada em fontes; não executamos um benchmark independente frente a frente. A nossa comparação anterior entre Opus 5 e Fable 5 cobre a geração anterior. Os preços, padrões e evidências abaixo se aplicam a estas versões mais recentes.
Claude Fable 5.2 vs Opus 5.5 em resumo
| Ponto de decisão | Claude Fable 5.2 | Claude Opus 5.5 |
|---|---|---|
| Papel inicial | Raciocínio exigente e trabalho de agentes de longa duração | Padrão para a maioria das cargas de trabalho |
| ID do modelo na API do Claude | claude-fable-5-2 |
claude-opus-5-5 |
| Entrada padrão, por milhão de tokens | US$ 8 | US$ 4 |
| Saída padrão, por milhão de tokens | US$ 40 | US$ 20 |
| Esforço padrão da API | High | Medium |
| Janela de contexto | 1M de tokens | 1M de tokens |
| Saída máxima | 128K de tokens | 128K de tokens |
| Rótulo de latência comparativa | Moderada | Moderada |
Fonte: a visão geral atual dos modelos Claude. Ambos os modelos aceitam texto e imagens, produzem texto, suportam ferramentas e usam pensamento adaptativo sempre ativo. Portanto, uma janela de contexto maior não os diferencia. O que diferencia é a capacidade de concluir a sua tarefa específica.
Os preços padrão de tokens do Fable são o dobro dos do Opus. Isso torna o Opus o ponto de partida sensato quando ambos os modelos atendem aos seus critérios de aceitação com volume de tokens semelhante. Isso não estabelece qual deles gera a conta menor quando a profundidade do raciocínio, as novas tentativas e as chamadas de ferramentas diferem.
Quais tarefas de codificação justificam a mudança para o Fable 5.2?
Use o Opus para alterações delimitadas com verificações claras. Teste o Fable quando o agente precisar descobrir o problema, coordenar várias alterações dependentes ou se recuperar de uma abordagem que está falhando. Estas são recomendações de carga de trabalho inferidas do posicionamento e dos resultados da Anthropic, e não garantias medidas para o seu repositório.
| Sua tarefa | Escolha inicial | Evidência que justificaria a escalada |
|---|---|---|
| Adicionar um endpoint documentado | Opus 5.5 | Falhas repetidas de contrato ou de integração |
| Atualizar testes após uma pequena refatoração | Opus 5.5 | O agente não consegue identificar a invariante alterada |
| Depurar uma falha intermitente entre serviços | Opus, depois Fable | O Opus repete correções sem testar causas concorrentes |
| Migrar um serviço com dependências pouco claras | Comparar ambos | O Fable conclui mais alterações aceitas dentro do orçamento |
| Coordenar um projeto técnico de longa duração | Testar o Fable | Um planejamento melhor sobrevive à execução e à revisão |
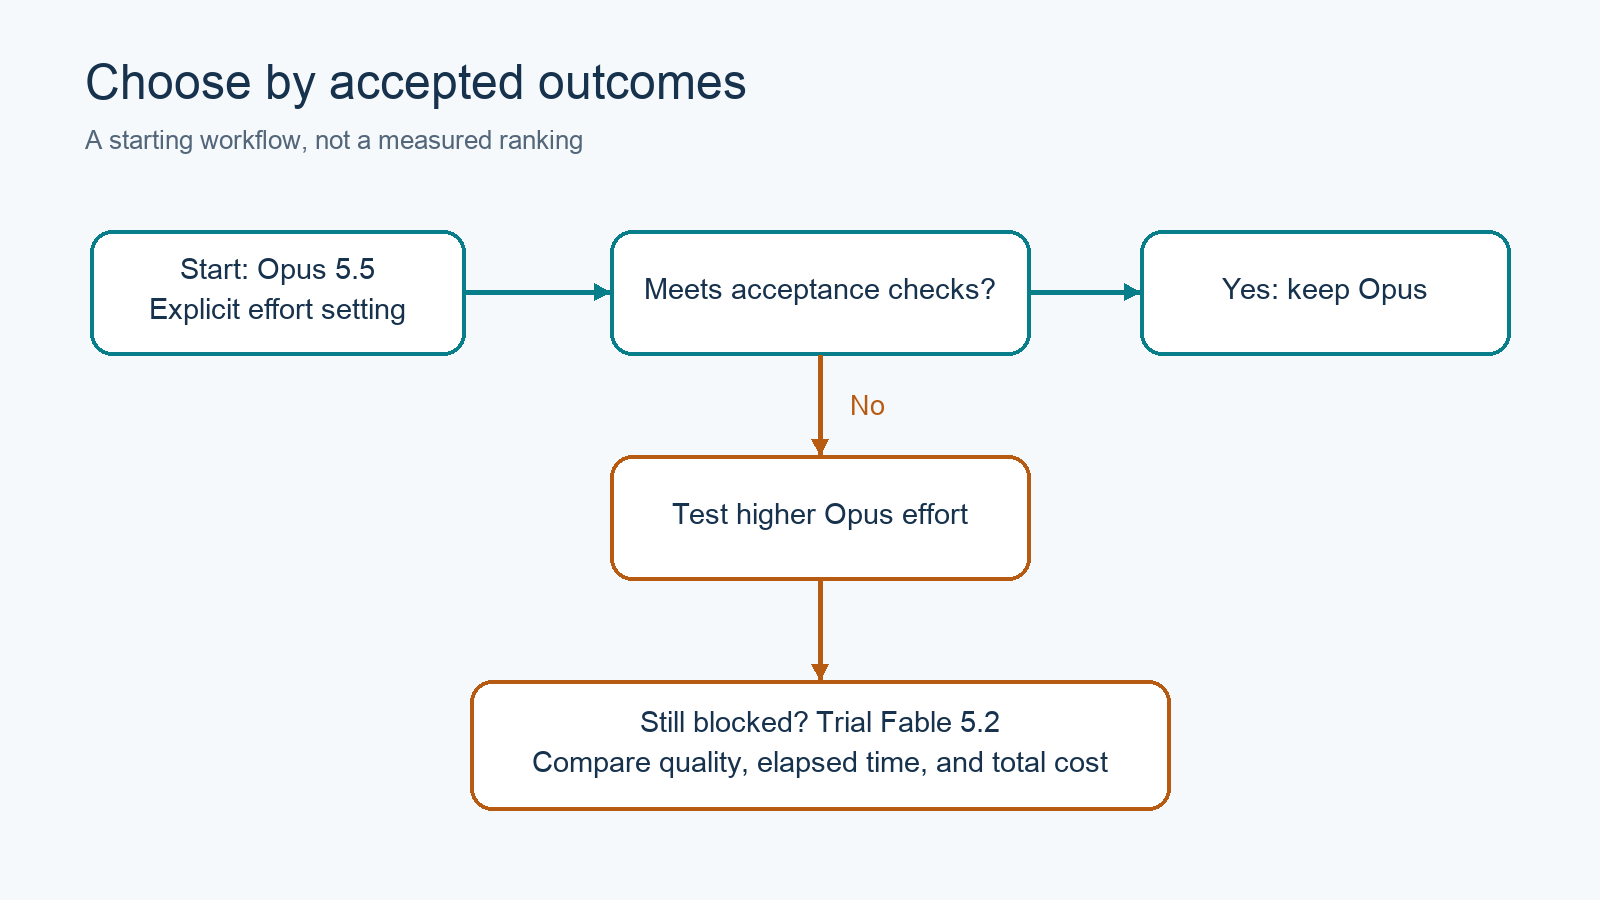
Escalada seletiva: mantenha as tarefas rotineiras no seu modelo de base e envie o trabalho difícil para o modelo que passa nas suas verificações.
Considere um webhook de pagamento que processa intermitentemente um evento duas vezes. Se a correção necessária já está especificada, o Opus tem uma tarefa de codificação delimitada. Se o agente precisa reconstruir a concorrência entre novas tentativas, armazenamento e serviços downstream, a investigação é um candidato mais forte para um teste com o Fable.
Forneça a qualquer um dos modelos as mesmas evidências do incidente e as mesmas restrições. Um modelo mais caro não compensa logs ausentes, dependências inacessíveis ou um teste de aceitação que recompensa o comportamento errado.
O que mostram os benchmarks da Anthropic?
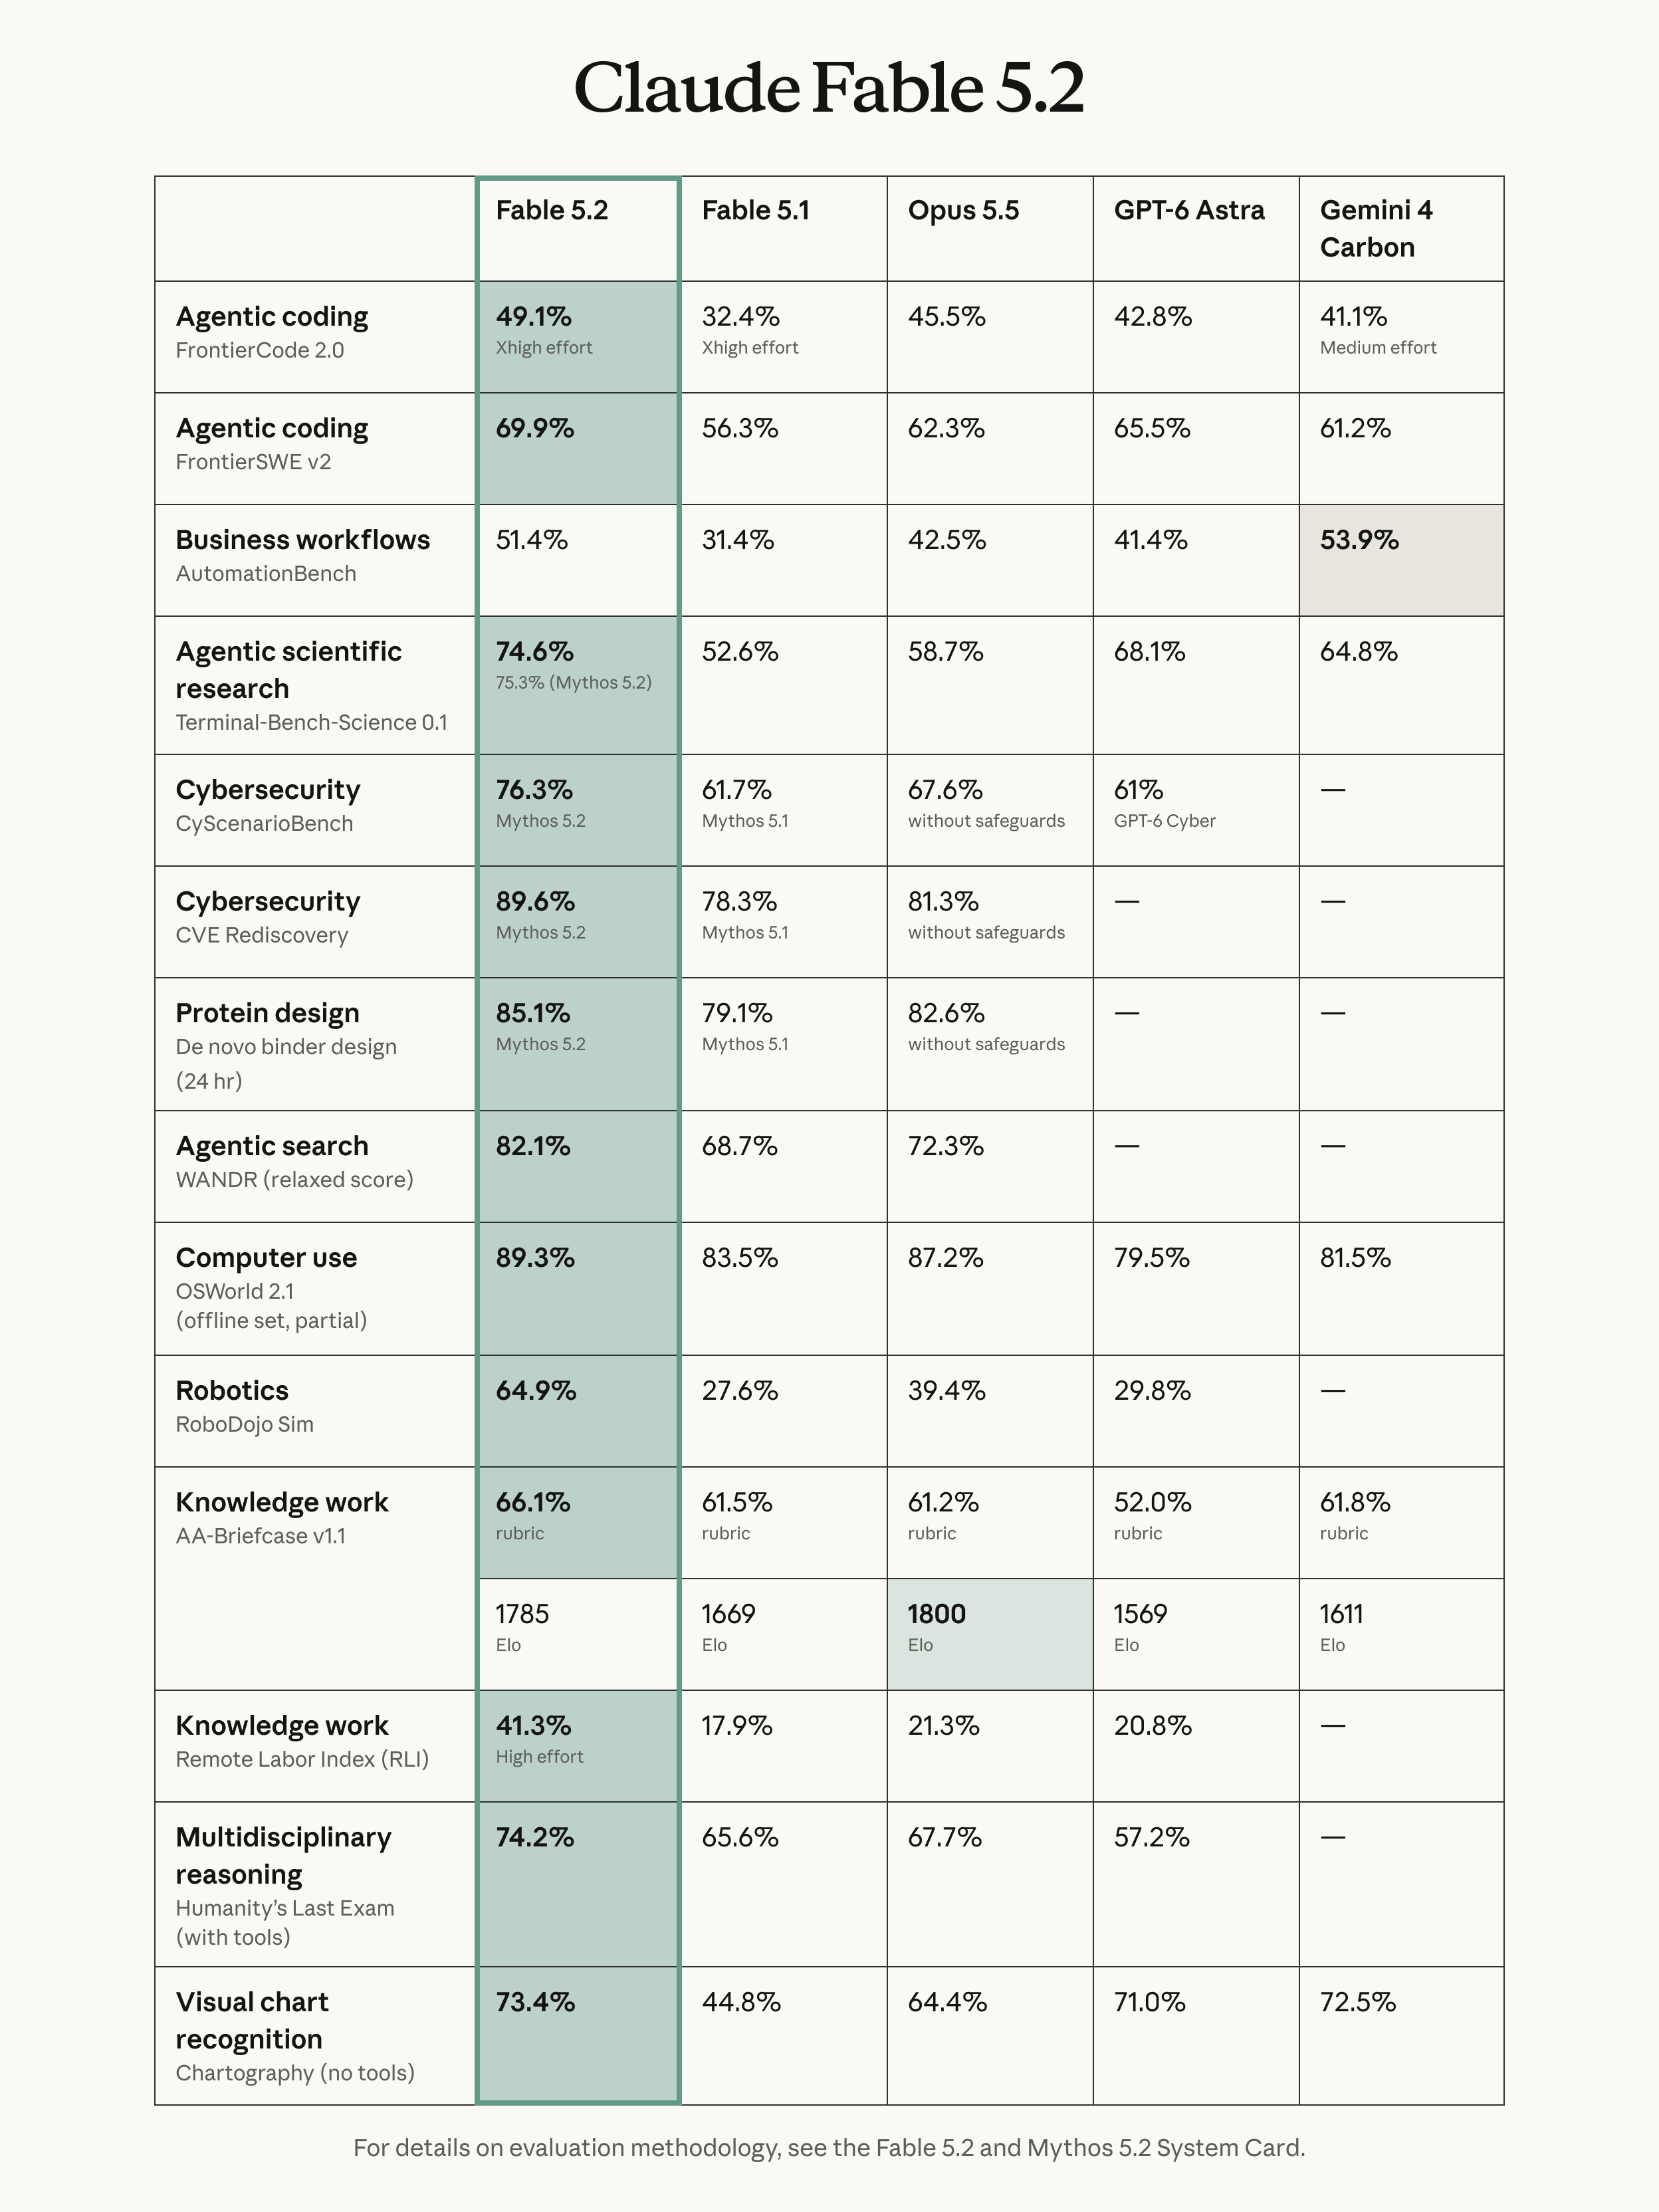
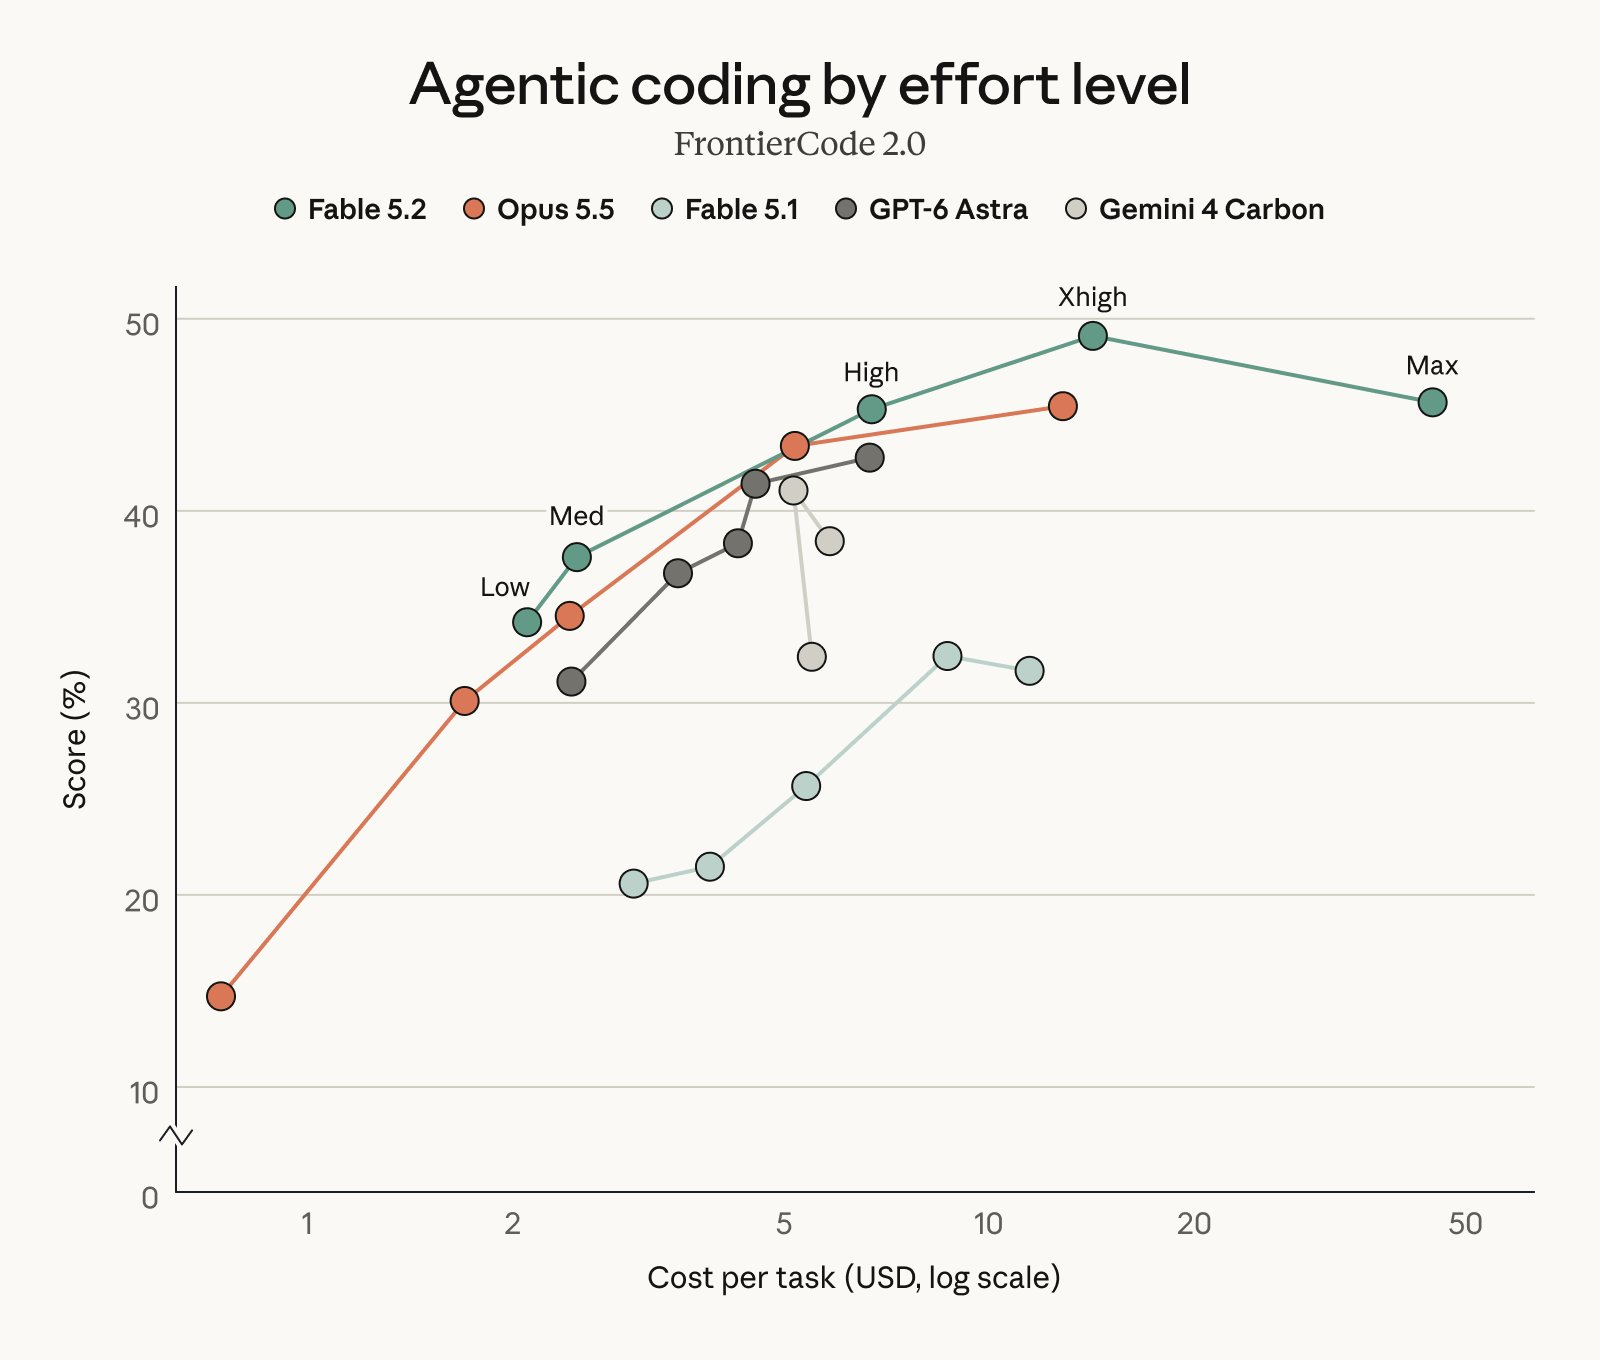
A Anthropic relata pontuações mais altas para o Fable 5.2 em várias avaliações de codificação e raciocínio. O sinal prático mais forte é o resultado de esforço versus custo: o Fable em High quase iguala o Opus em Max no FrontierCode 2.0 com cerca de metade do custo por tarefa nos testes iniciais da Anthropic.
| Avaliação relatada pelo fornecedor | Fable 5.2 | Opus 5.5 |
|---|---|---|
| FrontierCode 2.0, codificação agêntica | 49,1% em Xhigh | 45,5% |
| FrontierSWE v2, codificação agêntica | 69,9% | 62,3% |
| WANDR, busca agêntica, pontuação relaxada | 82,1% | 72,3% |
| OSWorld 2.1, conjunto offline parcial | 89,3% | 87,2% |
Esses números vêm do anúncio, que afirma que as pontuações usam o maior esforço disponível, salvo indicação em contrário. Eles descrevem as condições de avaliação da Anthropic, não as configurações padrão nem uma taxa de aprovação esperada nos seus tickets.
A comparação de custos é ainda mais restrita. O Fable em High pontua 45,3%, contra os 45,5% da melhor pontuação do Opus. Isso apoia o teste da configuração mais barata para aquela avaliação. Não significa que todo fluxo de trabalho do Fable custe metade do preço do Opus.
Evite transformar uma porcentagem de benchmark em uma previsão de produtividade. Uma pontuação de codificação não mede a sua fila de revisão, o risco de implantação ou o tempo gasto para consertar uma migração incorreta. Além disso, mantenha os resultados de segurança cibernética e biologia exclusivos do Mythos fora do histórico do Fable: o anúncio identifica um modelo subjacente compartilhado, mas salvaguardas e acessos diferentes.
As configurações de esforço mudam a comparação
Defina o esforço explicitamente ao comparar modelos. Os padrões da API são High para o Fable 5.2 e Medium para o Opus 5.5. O anúncio da Anthropic descreve separadamente o Medium como o padrão nos apps Claude e no Claude Code. Registre o produto e a configuração, em vez de assumir que um único padrão vale em todos os lugares.
A documentação de esforço define low, medium, high, xhigh e max para ambos os modelos. O esforço influencia o texto da resposta, os argumentos das ferramentas e o pensamento. É um sinal comportamental, não um limite rígido de gastos.
Comece com a sua configuração funcional do Opus. Se ela não for suficiente, compare um esforço maior do Opus com o Fable em Medium ou High. Reserve os testes em Xhigh e Max para tarefas em que o raciocínio adicional tenha um benefício plausível e você possa tolerar o gasto.
Uma comparação de esforço igual responde a uma pergunta: como esses modelos se comportam sob a mesma configuração nomeada? Uma comparação com custo equivalente responde a outra: qual configuração produz o resultado aceitável mais forte para o seu orçamento? Nenhuma substitui a outra.
Latência: meça a tarefa inteira
Ambos os modelos têm o rótulo de latência comparativa Moderada na visão geral da Anthropic. Não existe um vencedor universal a partir desse rótulo. Meça o tempo até um resultado revisado, incluindo ferramentas e novas tentativas, em vez de tratar a velocidade de saída como a velocidade do seu fluxo de desenvolvimento completo.
A Anthropic afirma que o Fable 5.2 gera saída até 30% mais rápido que o Fable 5.1. Essa comparação é com o seu antecessor, não com o Opus 5.5. O seu modo rápido opcional oferece até 2,5 vezes a velocidade de geração de tokens — novamente, uma alegação do fornecedor, e não uma redução medida na duração da sua tarefa.
Uma tarefa dominada por compilação ou por um banco de dados lento não acelerará na proporção da geração de tokens mais rápida. Por outro lado, um agente que evita duas abordagens fracassadas pode terminar antes enquanto gera tokens mais lentamente. Acompanhe esses fatores separadamente antes de pagar um prêmio por velocidade.
Compare o custo por resultado aceito
Use o gasto total do fluxo de trabalho dividido pelos resultados aceitos como sua métrica de decisão. Os preços dos tokens determinam a taxa, mas o volume de tokens, o cache, as tentativas fracassadas, as ferramentas e a revisão determinam o que você compra. A aritmética a seguir é ilustrativa, não uma medição do comportamento de nenhum dos modelos.
Suponha que uma requisição consuma 100.000 tokens de entrada sem cache e 10.000 tokens de saída, com roteamento global padrão e sem cobranças adicionais de ferramentas:
| Configuração | Custo de entrada | Custo de saída | Total |
|---|---|---|---|
| Opus 5.5 padrão | US$ 0,40 | US$ 0,20 | US$ 0,60 |
| Fable 5.2 padrão | US$ 0,80 | US$ 0,40 | US$ 1,20 |
| Opus 5.5 rápido | US$ 0,80 | US$ 0,40 | US$ 1,20 |
| Fable 5.2 rápido | US$ 1,60 | US$ 0,80 | US$ 2,40 |
Os preços foram verificados na documentação de preços da Anthropic em 10 de novembro de 2026. As franquias das assinaturas são separadas desses preços da API. Provedores de nuvem, cache, opções de residência de dados e outros recursos podem alterar a conta.
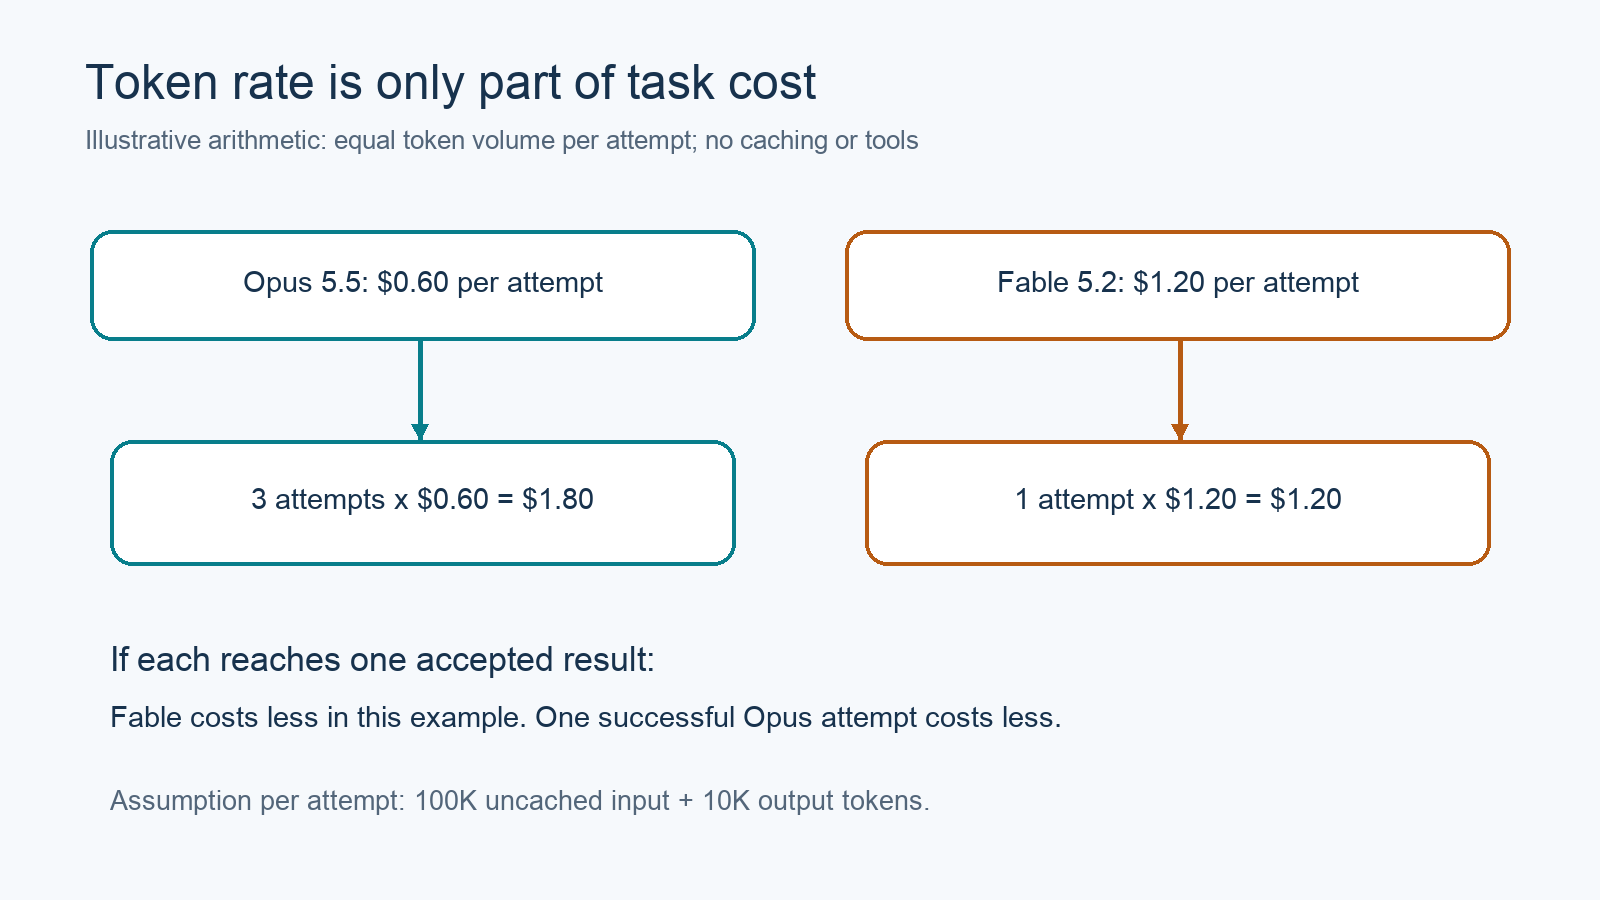
Compare todas as tentativas necessárias para obter um resultado bem-sucedido, incluindo novas tentativas e revisão.
Neste exemplo simplificado, três tentativas do Opus com volume idêntico custam US$ 1,80; uma tentativa do Fable custa US$ 1,20. Isso torna o Fable mais barato apenas se ele chegar ao resultado aceito em uma única tentativa. Uma tentativa bem-sucedida do Opus continua mais barata. Novas tentativas reais frequentemente consomem volumes diferentes, então use o uso registrado em vez de multiplicar uma média estimada.
Mantenha o tempo de revisão de engenharia ao lado do gasto com a API. Um patch que passa nos testes mas exige correção substancial não superou a mesma régua que um patch pronto para revisão.
Deixe seu agente de codificação verificar a API com a Apidog CLI
Use a Apidog CLI para que seu agente de codificação crie e execute verificações repetíveis de API. Essas verificações podem revelar regressões de requisição ou resposta quando você trocar de modelo. Elas não estabelecem se as alterações de repositório de um agente estão corretas; mantenha os testes de repositório e a revisão humana junto delas.
Configure a CLI e depois deixe seu agente ler o guia oficial de instalação:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
Dê ao Claude Code ou ao seu agente preferido este prompt:
Read https://apidog.com/apidog-cli-installation-guide.md.
In project <PROJECT_ID>, create a test case for our Claude Messages
request. Compare claude-opus-5-5 and claude-fable-5-2 using the same
prompt and explicit medium effort. Keep API credentials in private
variables. Assert the expected status and response structure, record
usage and elapsed time, and summarize failures. Don't claim these
checks measure coding quality. Validate every write payload first.
O agente verifica o schema, escolhe uma categoria válida de caso de teste, cria o case.json e depois executa comandos como estes. As flags foram verificadas na ajuda da CLI 2.2.12 instalada:
apidog test-case category --project <PROJECT_ID>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <PROJECT_ID> --file case.json
apidog run --test-case <CASE_ID> --project <PROJECT_ID> \
  -e <ENVIRONMENT_ID> -r cli,json
Substitua os placeholders pelos recursos do seu projeto. Este é um modelo de fluxo de trabalho, não uma comparação de modelos executada. Consulte o guia da Apidog CLI no Claude Code ou o guia de integração com o Codex para a configuração do agente.
Perguntas frequentes
O Fable 5.2 é melhor que o Opus 5.5 para toda codificação?
Não. A Anthropic recomenda o Opus 5.5 para a maioria das tarefas de codificação e conhecimento. O Fable vale a pena testar quando o trabalho difícil supera esse patamar. Suas pontuações de benchmark mais altas relatadas pelo fornecedor não garantem um resultado melhor em toda tarefa.
O Fable 5.2 custa o dobro?
Seus preços padrão de tokens de entrada e saída são o dobro dos do Opus 5.5. O custo total da tarefa pode diferir, porque configurações diferentes consomem quantidades diferentes de tokens e exigem números diferentes de tentativas.
Devo sempre usar o esforço máximo?
Não. Compare as configurações contra suas verificações de aceitação e seu orçamento. Um esforço maior permite mais gasto de tokens; não garante uma melhoria útil para uma tarefa delimitada.
O Fable 5.2 é mais rápido que o Opus 5.5?
As fontes revisadas aqui não estabelecem um vencedor universal de latência frente a frente. Ambos têm o rótulo de latência Moderada. Meça o seu fluxo de trabalho real e trate o modo rápido como uma configuração separada.
A Apidog pode decidir qual modelo escreve código melhor?
A Apidog CLI pode ajudar seu agente a executar verificações de API e coletar evidências de resposta. A qualidade do código ainda precisa de testes de repositório e revisão. Use esses resultados aceitos para decidir qual modelo e configuração de esforço justificam seu custo.